翻訳者ノート
こんにちは!コンテンツチームの古川です。
SAP のデータを外に出す話は、現場だと「どこから手を付ければいいのか」から詰まりがちです。ODP なのか SLT なのか、オンプレミスのファイアウォールをどう越えるのか、ACDOCA や MANDT、先頭ゼロのキーをどう扱うのか — 決めることが多すぎて、分析を始める前に力尽きるパターンも多いのではないでしょうか。この記事は、その「決めること」を計画・接続方式・スキーマ設計・ガバナンス・検証の順に並べ直したものです。取り込みモードの比較表だけでも、社内で方式を決める材料になると思います。 |
 基幹システムである SAP からデータを抽出しようとしたことがある方なら、それが決して簡単な作業ではないとご存知でしょう。それでも、リアルタイム分析を回したい、AI 活用の土台を整えたいとなれば、SAP の業務データを Snowflake につなぐ工程は避けて通れません。
この記事では、SAP から Snowflake へのパイプラインを構築・自動化・拡張する方法を具体的に解説します。連携を手作業でこなしている場合でも、CData Sync で SAP 接続を簡素化している場合でも、考え方は同じです。
ここで紹介するやり方をたどれば、チーム全体でデータを安全に移し、ガバナンスを保ったまま、よくある落とし穴を避けられます。
SAP と Snowflake、それぞれ何が得意?
SAP は財務・調達・販売・人事といった業務トランザクションを正確に記録することに強いシステムです。一方の Snowflake は、そのデータを大量に、かつ他のデータと掛け合わせて分析することに強みがあります。両者の役割は重なりません。だからこそつなぐ価値が生まれます。
データを動かし始める前に、扱う対象を正確に把握しておきましょう。まずは SAP と Snowflake、それぞれの主要な機能を整理します。
SAP は、財務・調達・販売・人事などのビジネスに不可欠なデータを、緊密に統合されたデータベースに整理するエンタープライズリソースプランニング(ERP)プラットフォームです。
Snowflake は、スケーラブルな分析とクロスクラウドのデータ共有のために作られたクラウドデータウェアハウスです。AWS・Azure・Google Cloud を横断する「AI データクラウド」として位置付けられています。
なぜ SAP と Snowflake をつなぐ?
では、なぜこの 2 つを連携させるのでしょうか。高度な分析、リアルタイムダッシュボード、AI 活用の取り組みを進めるうえで鍵になるのは、SAP に蓄積されたトランザクションデータです。
SAP のデータはそれ自体でも十分に価値があります。ただ、気象パターンや IoT センサー、外部の物流データと Snowflake 上で掛け合わせると、引き出せるものが一段変わります。
在庫台帳だけでサプライチェーンの遅延を読もうとしても、ほぼ手に負えません。ここに Snowflake 上の世界の気象データを重ねると、予測の精度は目に見えて変わり、打ち手を早く動かせるようになります。
この連携が効いてくるのは、データ民主化の面でもあります。ゼロコピー共有(Snowflake のセキュアデータ共有)を使えば、複雑な SAP の構造を知らないビジネスユーザーでも、必要なインサイトに安全にたどり着けます。
SAP から Snowflake への移行はどう計画する?
複雑な SAP 環境から Snowflake へデータを移行するには、段階的でビジネス主導の計画が欠かせません。SAP HANA、SAP Business One、SAP ByDesign、SAP Hybris を扱う各チームは、それぞれ違う抽出上の課題にぶつかります。計画の段階から、モジュールごとの違いを織り込んでおきましょう。
ここを飛ばすと、SAP 独自のデータ構造や膨大なデータ量に足を取られて、分析に入る前に時間を使い切ってしまいます。他社がこの計画段階をどう乗り切ったのかを知りたい方は、大手企業が SAP データ統合の課題をどう解決したかも合わせて読んでみてください。
進め方は、業務ドメインの優先順位で組み立てます。
フェーズ 1:基盤を作ります。SAP モジュールの棚卸しをして、最も重要なドメインから着手します。通常は財務(FI・CO)、販売(SD)、資材管理(MM)といった業務の中核から始めるのが無理のない順番です。
その後のフェーズ:点と点をつなぎます。中核のデータが整ったら、エンドツーエンドの業務プロセスをモデリングしていきます。例えば「オーダー・トゥ・キャッシュ(O2C)」、つまり最初の販売注文から請求・売掛金までを追う流れです。購買要求から支払いまでを追う「プロキュア・トゥ・ペイ(P2P)」も、同じように設計します。
ここまで来ると、パイプラインが実際に回ることを示せますし、測定できて監査にも耐える価値を業務側に返せます。
計画段階で押さえておきたいのは、次の3点です。
業務に不可欠なテーブルを洗い出す:ACDOCA(S/4HANA ユニバーサルジャーナル用)や BKPF・BSEG(ECC 財務文書用)といった、大規模で土台になるトランザクションテーブルをマッピングします。
パイロットユースケースを決める:ROI が見えるパイロットに絞ります。正確性を示せて、かつ本格展開の前にボトルネックやプロセスの抜けを見つけられるものを選びましょう。
並行実行で監査可能性を確保する:照合ダッシュボードと並行実行をどこまでやるか決めます。既存の SAP レポート(BW など)を Snowflake と一時的に並走させておくと、移行がなだらかになり、業務側の信頼も積み上がります。
SAP の接続方式と取り込みモードはどう選ぶ?
選び方は、必要なレイテンシとコンピューティング予算の2軸で決まります。夜間レポートで足りるならバッチロード、業務ダッシュボードならニアリアルタイムの CDC、1秒未満が要るならストリーミングです。
SAP からのデータ抽出は、かなり複雑になります。データ量、レイテンシ要件、インフラの条件を先に整理して、技術チームが最も効率的で安全な構成を自分たちで選べる状態にしておきましょう。
まずは接続方式を見ていきましょう。SAP からデータを抽出する方法は、主に次の5つです。
ODP(Operational Data Provisioning)
SLT(SAP Landscape Transformation)
OData
ダイレクト CDC エージェント
SAP の新しいクラウド接続ソリューション
カスタムコーディングなしで SAP 抽出の複雑さを引き受けてくれるコネクタを探しているなら、CData Sync が選択肢になります。認定済みコネクタによるSAP から Snowflake へのダイレクト接続を提供します。CDC の組み込みサポート、自動スケジューリング、企業ファイアウォールの内側で動くオンプレミスエージェントも標準で付いています。実機で設定を進めるとつまずきやすい箇所もいくつかあるので、着手前にSAP 連携でつまずく5つのポイントと解決法に目を通しておくと手戻りが減ります。
取り込みモード5種類はどう違う?
取り込み方法の選び方は、どれだけ速くデータが必要かと、コンピューティング予算のバランス次第です。次の比較表で、チームの目標に近いものを探してみてください。
取り込みモード | ユースケース | レイテンシ | 中核技術 | 主なコスト要因 |
バッチロード | 過去のデータの補完、大規模なレガシーシステムの移行、夜間レポート | 数時間~数日 | COPY INTO、クラウドストレージ(S3/Azure Blob)、ODP | 最も低コスト。バルク処理を効率的に活用 |
Snowpipe / CDC | ニアリアルタイム分析、日次運用ダッシュボード | 60秒未満 | Snowpipe、ログベースのCDC、SAP SLT | 中程度。継続的でサーバーレスなコンピューティングを活用 |
ストリーミング | 1秒未満の不正検知、ライブ IoT モニタリング、即時イベントトリガー | 1秒未満 | Snowpipe Streaming、Kafka | コストが最も高い。「常時稼働」のインフラが必要 |
ハイブリッド(バッチ + CDC) | 完全な移行と継続的なリアルタイム分析の併用 | ニアリアルタイム | COPY INTO + Snowpipe / CDC | コストバランスが取れている。履歴データを一括処理しつつ、リアルタイムデータを常に最新の状態に保つ |
ゼロコピー共有 | データ複製なしでの AI モデリング・クロスプラットフォームでの全社的な可視化 | リアルタイム | SAP BDC Connect、Snowflake データ共有 | オーバーヘッドが低く、冗長なストレージコストを排除 |
オンプレミスの SAP はどう守る?
SAP システムがオンプレミスにある場合は、社内ファイアウォールの内側にエージェントを置きます。内部システムをインターネットに晒さずに、安全にデータを取り出せます。CData Sync にはこの構成に対応したオンプレミスエージェントが組み込まれているので、ファイアウォールの内側から安全にデータを転送できます。AWS 上で通信経路そのものをインターネットから切り離したい場合の具体的な設定は、AWS PrivateLink 経由で Snowflake に接続する手順で解説しています。
なお、BDC のゼロコピー共有は現状 SAP → Snowflake 方向が実用段階にあり、Snowflake → BDC への Share-back は検証段階です。双方向運用を急がず、当面はこの非対称性を前提にハイブリッド構成で進めるのが無難です。設定でつまずきやすい点は、先述のSAP 連携でつまずく5つのポイントと解決法も参考にしてください。
Snowflake 側は、動的データマスキングとロールベースアクセス制御(RBAC)で守ります。機密フィールドがクラウドに届いた瞬間から保護がかかる状態にしておきましょう。
Snowflake のスキーマはどう設計する?
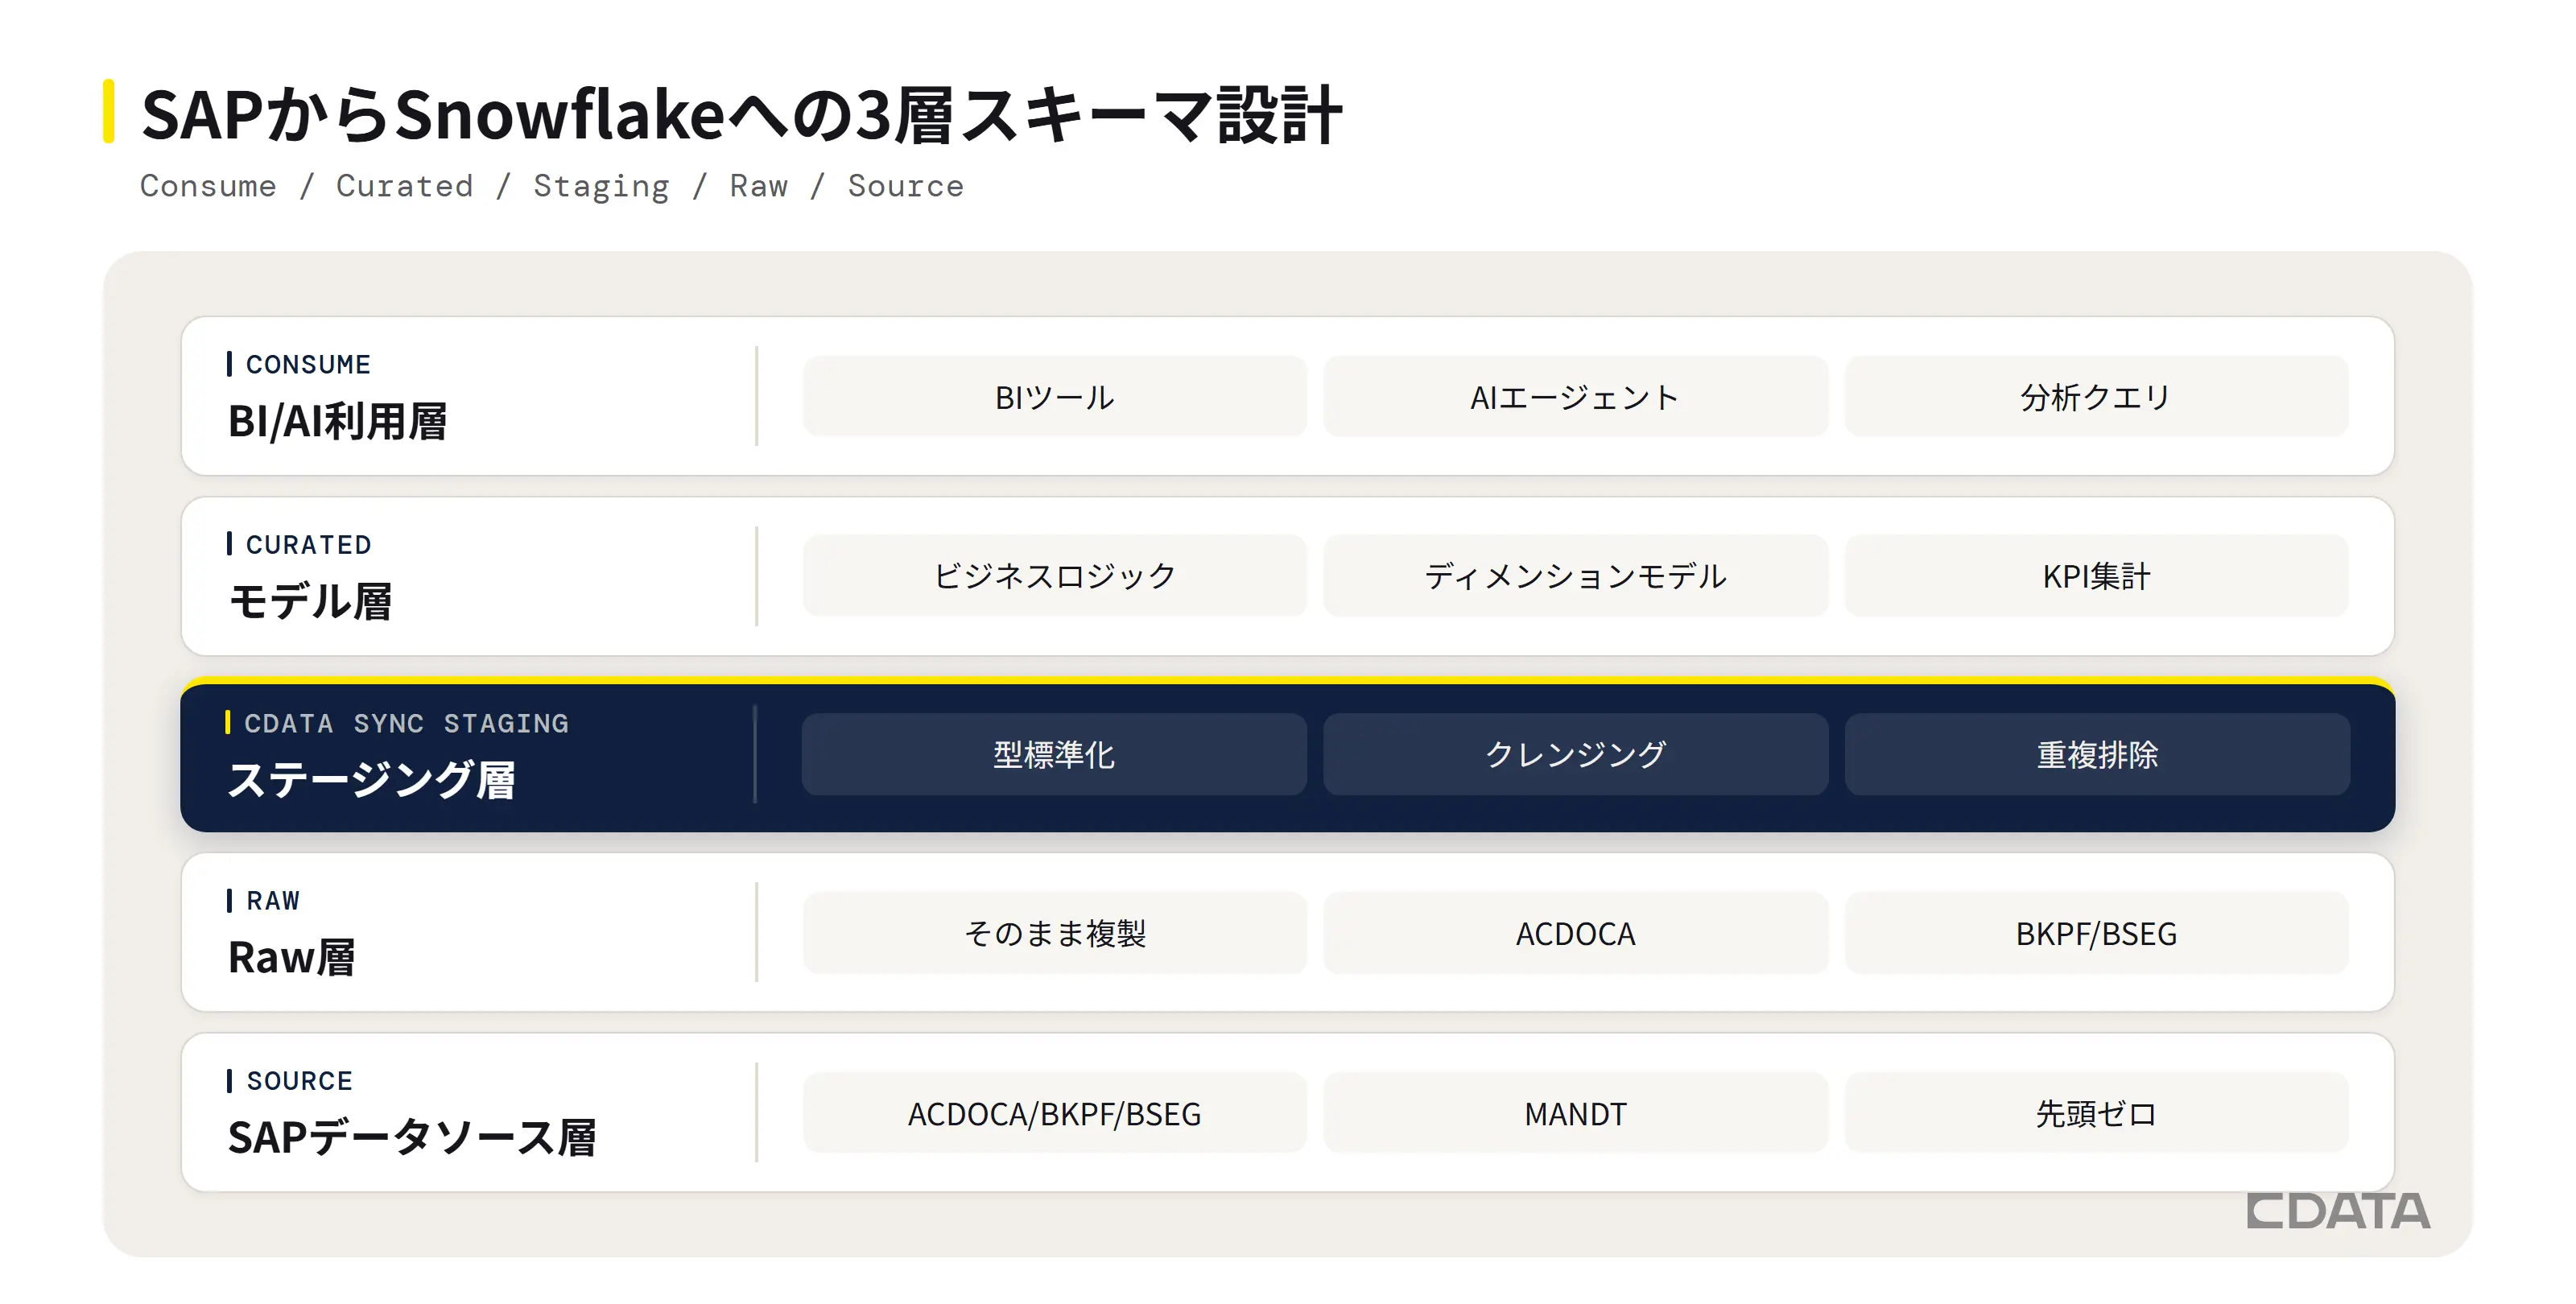
複雑な SAP データを Snowflake に移す際、すべてのテーブルを1つのスキーマに放り込むと、あとで手が付けられなくなります。SAP のビジネスロジックを保ったまま、壊れにくく監査もできるデータモデルにしたいところです。そのためには、段階を分けた設計が必要です。
定番は、データフローを厳格な 3 層スキーマに分けるやり方です。情報がビジネスユーザーに届く前に、保護・標準化・モデル化を順番に通します。3 層それぞれの役割は次のとおりです。
Raw(生データ):この層は不変です。SAP から出てきたままの状態で格納し、データソース側の属性を一切変えずに保持します。
ステージング(Staging):ここでデータをクレンジングし、データ型を標準化します。
キュレーション/モデル:ビジネスロジックを適用し、ディメンションを揃えて、下流の分析にすぐ使えるセマンティックモデルを作ります。
Raw 層では、MANDT(クライアント分離)、先頭ゼロを含むキー、通貨コード、取り消し・消込イベントといった SAP 固有の重要なフィールドを洗い出し、そのまま維持してください。
設計時のポイントは、次の3点です。
先頭ゼロの処理とキー形式は、パイプラインの早い段階で標準化します。
通貨換算ルールと計量単位係数は、管理された共有資産として定義しておきましょう。
可能ならゼロコピー共有を使います。冗長なストレージが不要になるためコストが下がり、データリネージも追いやすくなります。
ETL パイプラインはどう組んで自動化する?
パイプラインを設計するとき、最初に決めるのはデータ変換をどこで行うかです。選択肢は2つです。ロードする前にターゲットシステムの外で変換する ETL か、生データをそのまま Snowflake に取り込んでから変換する ELT です。
Snowflake では、ELT ファーストのアプローチが推奨されます。SAP の生データを抽出して Snowflake に直接ロードし、変換は dbt・Snowpark・標準 SQL といったウェアハウス内のツールに任せます。生データを先に置いてから中で変換する形のほうが、いまのチームには扱いやすいでしょう。
効果的にスケールさせるには、変換モデルとテストをソフトウェアコードと同じようにバージョン管理し、自動化と CI/CD を組み合わせます。監視、スケジューリング、エラー処理まで自動化しておけば、人が張り付かなくてもパイプラインは予測どおりに動きます。
ELT ワークフローの手順は、次の4ステップです。
SAP からの抽出:選択した接続方法(例:ODP、CDC エージェント)を使用してデータを取得します
Snowflake への生データのロード:履歴データのロードにはバッチコピーを、ニアリアルタイムの取り込みには Snowpipe/Snowpipe Streaming を使用してデータを転送します
変換:Snowflake の膨大な演算能力を活用し、生データをステージング層およびキュレーション層へと処理します
出力の検証:ビジネス利用可能なデータセットを生成し、財務上の合計値と照合して正確性を確保します
ガバナンスとセキュリティはどう担保する?
Snowflake 側の RBAC と動的データマスキングで「誰が何を見られるか」を制御し、監査ログでデータの経路を追跡できる状態にしておくのが基本形です。SAP を離れた瞬間から保護がかかっていることが条件になります。
Snowflake で機密性の高い SAP データを扱うなら、厳格な監視が欠かせません。データセキュリティ、アクセス制御、コンプライアンス基準を連携パイプライン全体で徹底できるよう、部門横断で体制を整えておきましょう。
ガバナンスと可観測性が効いていれば、SAP を出たデータがビジネスダッシュボードに届くまでの全区間を、監視下・保護下に置いたまま運べます。
ここで押さえておきたいガバナンス・セキュリティ・可観測性の機能は、次の5つです。
ロールベースアクセス制御(RBAC)および監査ログ:最小権限のアクセスを実装し、クエリ・ログイン・変更といったユーザー操作をすべて記録します。SAP 側の元テーブルから最終的なダッシュボードまでのデータ系譜と監査証跡が残るので、コンプライアンス監査のときにすぐ証拠を出せます。
動的データマスキング:クエリを実行するユーザーに応じて、機密属性(PII、PCI、人事データなど)をその場で自動的に隠します。テーブルを複製しなくても、GDPR や SOX への準拠を保てます。
ゼロコピー共有:物理的なデータ移動なしに全社へ安全なアクセスを開けるので、ガバナンスを一元化できます。信頼できる唯一のデータ(Single Source of Truth)を保ったまま、冗長なストレージコストも削れます。
暗号化とメタデータ:保存中および転送中のデータを保護すると同時に、継続的なメタデータの伝播を徹底します。
データ可観測性を先回りで効かせる:パイプラインを常時監視し、異常が経営陣向けダッシュボードに届く前に捕まえます。自動チェックに入れておきたい項目は次のとおりです。
パイプラインの検証と監視はどうやる?
データの問題を未然に防ぎ、利用の拡大に耐えるパイプラインにするには、テスト・チューニング・拡張を体系的に回すことが必要です。
テストの進め方:
パフォーマンスのチューニング:
SAP のような大量データを流す前提でさらに詰めたい場合は、Snowflake 連携を高速化する最適化ポイントで具体的な設定値まで解説していますので参考にしてください。
監視と段階的な拡張:
連携したデータを AI にどう活かす?
データを安全に連携できたら、次は AI を使った分析です。小さく導入したところから、部門をまたいで使える分析基盤へと広げていけます。
まずはインパクトの大きいシナリオから着手します。初期段階では、決算プロセスの改善やサプライチェーン業務の最適化のように、測定できて監査にも耐えるユースケースに絞りましょう。
AI 向けの準備として押さえておきたいのは、次の3点です。
ネイティブの AI 機能を活用する:Snowflake のアナリティクス、Snowpark ML、自然言語インターフェースを使えば、データを動かさずにその場で予測モデルを構築・展開できます。Cortex AI を使った実装イメージは、CData と Cortex AI で Snowflake の AI ワークロードを実現する方法で確認できます。SAP 側の Joule エージェントと Cortex AI を組み合わせれば、業務システムと分析基盤をまたいだエージェント連携も視野に入ります。
内部データと外部データを組み合わせる:気象データ、IoT センサー、外部の物流フィードといったデータソースを SAP データに掛け合わせて、新しい予測インサイトを引き出します。小売の需要予測、製造の稼働最適化、金融のリスクモデリング、ヘルスケアの需給調整など、業種ごとに掛け合わせるデータは変わってきます。
データアクセスを民主化する:ガバナンスとセキュリティを保ったまま、ビジネスユーザーがセルフサービスツールでインサイトを探せるようにします。SAP BDC Connect を使えば、ユーザーが SAP の中で作業しなくてもデータを共有できます。SAP Analytics Cloud(SAC)を使っているチームも、Snowflake に直接つないでクラウドベースのレポート作成や可視化ができます。追加のミドルウェアなしで、レプリケートしたデータの使い道を広げられます。
拡張は段階的に進めます。まずは対象を絞ったパイロットで価値を示し、そのあとチーム間で使い回せるモジュール式のデータマートや共有データ製品を積み上げていきましょう。
よくある質問
SAP と Snowflake のデータ連携における一般的な取り込みモードにはどのようなものがありますか?
一般的なアプローチとしては、大規模データセット向けのバッチロード、ニアリアルタイムの更新のための変更データキャプチャ(CDC)、および継続的なデータ取り込みのための Snowpipe または Snowpipe Streaming があります。
レプリケーション中に SAP データのセマンティクスを維持するにはどうすればよいですか?
MANDT などの主要な SAP フィールドを保持し、先頭ゼロの形式を維持し、取り消しや消込イベントを保持することで、ビジネスロジックと監査履歴が損なわれないようにします。
ETL ではなく、Snowflake 内部で ELT 変換を行う理由は何ですか?
ELT では、Snowflake のスケーラブルなコンピューティング機能を活用してロード後にデータを変換するため、パイプラインが簡素化され、大規模な SAP データセットのパフォーマンスが向上します。
SAP から Snowflake へのパイプラインにおいて、どのようなセキュリティ対策が重要ですか?
ロールベースアクセス制御を採用し、認証情報を定期的に更新し、監査ログを有効化し、データアクセスを継続的に監視することで、安全なデータ連携を維持します。
スキーマの変更やデータの異常は、どのように効果的に対処できますか?
自動検証チェックを実装し、スキーマのドリフトを監視するとともに、ダッシュボードやアラートを活用して異常を迅速に検知・解決します。
SAP 以外のシステムと Snowflake を連携する場合も、同じ取り込みモードの考え方が使えますか?
はい。バッチ/CDC/ストリーミングの選び方はデータソースに依存しない考え方なので、CData Sync の350以上のコネクタを使えば SAP 以外のシステムでも同様に対応できます。
数ヶ月の開発なしで SAP 連携を動かす
信頼性の高い SAP から Snowflake へのパイプラインを作るのに、数ヶ月ものカスタム開発は必要ありません。CData Sync は、ネイティブ CDC サポート、自動スケジュール機能、安全なオンプレミスエージェント展開を備えた350以上のコネクタを提供します。
CData Sync を使えば、チーム全体で生の SAP データから本番の分析データへと、より早くたどり着けます。実際に、製造業の企業では、SAP ERP データを生データ粒度でクラウド分析基盤に複製し、経営層から現場まで同じデータを見て意思決定できる体制を構築しています。詳しくは製造業の導入事例をご覧ください。今すぐ無料トライアルを始めましょう!
※本記事はCData US ブログSAP to Snowflake Integration Guide 2026: Best Practices for Modern Data Teams の翻訳です。
数ヶ月の開発なしで SAP 連携を始める
SAP の抽出方式やファイアウォール対応を自前で作ると、分析に入る前に数ヶ月が消えます。CData Sync なら認定済み SAP コネクタとネイティブ CDC、オンプレミスエージェントが標準で揃っています。


