



Embulk を使用して Alchemy のデータをデータベースにロードする方法
Embulk はオープンソースのバルクデータローダーです。CData API Driver for JDBC と組み合わせることで、Alchemy から任意の同期先にデータを簡単にロードできます。この記事では、CData API Driver for JDBC をEmbulk で使用してAlchemy のデータをMySQL データベースにロードする方法を解説します。
CData JDBC Driver は、最適化されたデータ処理機能を内蔵しており、リアルタイムのAlchemy のデータに対して比類のないパフォーマンスを発揮します。Alchemy に対して複雑なSQL クエリを発行すると、ドライバーはフィルタや集計などのサポートされているSQL 操作を直接Alchemy にプッシュし、サポートされていない操作(SQL 関数やJOIN 操作など)は組み込みのSQL エンジンを使用してクライアント側で処理します。
Alchemy への JDBC 接続を設定
Embulk でバルクロードジョブを作成する前に、JDBC Driver のJAR ファイルのインストール場所(通常はC:\Program Files\CData\CData API Driver for JDBC\lib)を確認しておきます。
Embulk はJDBC 接続をサポートしているため、Alchemy に簡単に接続してSQL クエリを実行できます。バルクロードジョブを作成する前に、Alchemy への認証用のJDBC URL を作成します。
まず、Profile 接続プロパティをディスク上の Alchemy プロファイルの場所に設定します(例:C:\profiles\Alchemy.apip)。次に、ProfileSettings 接続プロパティを Alchemy の接続文字列に設定します(以下を参照)。
Alchemy API プロファイル設定
Alchemy では API キー認証を使用します。API キーはリクエスト URL のパスに含めて送信されます。API キーは以下の手順で取得できます。
- https://dashboard.alchemy.com で Alchemy アカウントにサインインします。
- 既存のアプリを開くか、新しいアプリを作成します。
- 「API Key」ダイアログから、アプリの API キーをコピーします。
API キーを取得したら、以下の接続プロパティを設定します。
- AuthScheme:APIKey に設定します。
- Network:(オプション)NFT API リクエストの対象となるブロックチェーンネットワークのスラッグです(例:eth-mainnet、base-mainnet、polygon-mainnet)。デフォルトは eth-mainnet です。
ProfileSettings 接続プロパティには、以下を設定します。
- APIKey:Alchemy アプリの API キーに設定します。
組み込みの接続文字列デザイナー
JDBC URL の作成には、Alchemy JDBC Driver に組み込まれている接続文字列デザイナーを使用できます。JAR ファイルをダブルクリックするか、コマンドラインからJAR ファイルを実行します。
java -jar cdata.jdbc.api.jar
接続プロパティを入力し、接続文字列をクリップボードにコピーします。
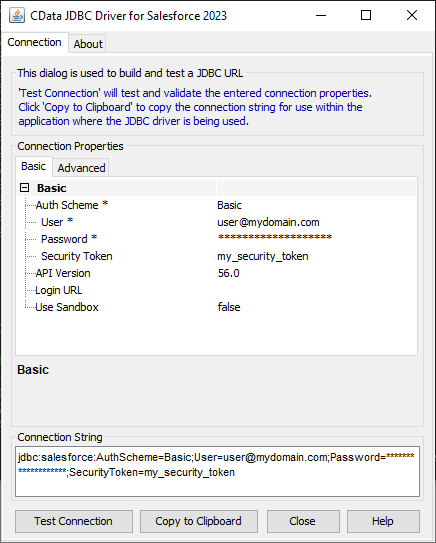
以下は、Alchemy への一般的なJDBC 接続文字列です。
jdbc:api:Profile=C:\profiles\Alchemy.apip;AuthScheme=APIKey;Network=eth-mainnet;ProfileSettings='APIKey=your_api_key';
Embulk で Alchemy ののデータをロード
CData JDBC Driver をインストールしてJDBC 接続文字列を作成したら、必要なEmbulk プラグインをインストールします。
Embulk の入力・出力プラグインをインストール
- Embulk にJDBC 入力プラグインをインストールします。
https://github.com/embulk/embulk-input-jdbc/tree/master/embulk-input-jdbc - この記事では、同期先データベースとしてMySQL を使用します。出力プラグインを使用して、SQL Server、PostgreSQL、またはGoogle BigQuery を同期先として選択することもできます。
https://github.com/embulk/embulk-output-jdbc/tree/master/embulk-output-mysqlembulk gem install embulk-output-mysql
embulk gem install embulk-input-jdbc
入力プラグインと出力プラグインをインストールしたら、Embulk を使用してAlchemy のデータをMySQL にロードする準備が整いました。
Alchemy ののデータをロードするジョブを作成
まず、Embulk で設定ファイルを作成します。ファイル名はapi-mysql.yml のようにします。
- 入力プラグインのオプションには、CData API Driver for JDBC、ドライバーJAR ファイルへのパス、ドライバークラス(例:cdata.jdbc.api.APIDriver)、および上記のJDBC URL を指定します。
- 出力プラグインのオプションには、MySQL データベースの値と認証情報を指定します。
設定ファイルのサンプル(api-mysql.yml)
in:
	type: jdbc
	driver_path: C:\Program Files\CData\CData API Driver for JDBC 20xx\lib\cdata.jdbc.api.jar
	driver_class: cdata.jdbc.api.APIDriver
	url: jdbc:api:Profile=C:\profiles\Alchemy.apip;AuthScheme=APIKey;Network=eth-mainnet;ProfileSettings='APIKey=your_api_key';
	table: "ContractsForOwner"
out:
	type: mysql
	host: localhost
	database: DatabaseName
	user: UserId
	password: UserPassword
	table: "ContractsForOwner"
	mode: insert
ファイルを作成したら、Embulk ジョブを実行します。
embulk run api-mysql.yml
Embulk ジョブを実行すると、MySQL テーブルにAlchemy のデータが格納されます。
フィルタリングした Alchemy ののデータをロード
テーブルから直接データをロードするだけでなく、カスタムSQL クエリを使用してロードするデータをより詳細に制御できます。また、クエリフィールドのSQL WHERE 句で最終更新カラムを設定することで、増分ロードを実行することもできます。
in:
	type: jdbc
	driver_path: C:\Program Files\CData\CData API Driver for JDBC 20xx\lib\cdata.jdbc.api.jar
	driver_class: cdata.jdbc.api.APIDriver
	url: jdbc:api:Profile=C:\profiles\Alchemy.apip;AuthScheme=APIKey;Network=eth-mainnet;ProfileSettings='APIKey=your_api_key';
	query: "SELECT Address, Name FROM ContractsForOwner WHERE [RecordId] = 1"
out:
	type: mysql
	host: localhost
	database: DatabaseName
	user: UserId
	password: UserPassword
	table: "ContractsForOwner"
	mode: insert
詳細情報と無料トライアル
CData API Driver for JDBC をコネクタとして使用することで、Embulk のデータロードジョブにAlchemy のデータを統合できます。また、200 を超えるエンタープライズデータソース向けドライバーにより、あらゆるエンタープライズSaaS、ビッグデータ、NoSQL ソースも統合できます。30日間の無料トライアルをダウンロードして、今すぐお試しください。