

ビジネスを学習し続けるコンテキスト
答えた質問も、加えた修正も、整えた定義も。そのすべてが AI に蓄積されるコンテキストとなり、回答は回を重ねるごとに賢くなっていきます。


エージェントに、アクセスだけでなく理解を
エージェントを自社システムに接続するだけなら簡単です。AI の取り組みを成功に導く鍵は、エージェントが自社のデータ、システム、そしてビジネスを理解しているかどうかにあります。
4 種類のコンテキストを、1 つのグラフに
4 種類のコンテキストを、あらゆるモデルから利用できる 1 つのグラフに統合します。どのモデルがリクエストを処理しても、すべてのエージェントが同じ理解に基づいて回答できます。
コンテキストを 1 か所に統合
構造化・非構造化のソースにまたがる 4 種類のコンテキストを 1 か所に集約し、エージェントが知っておくべき情報の全体像を提供します。
システムコンテキスト
あらゆるシステムのスキーマ、オブジェクト、関係性。扱いの難しいシステムも含め、コネクタを通じて初日から把握できます。
データモデル
複数のソースにまたがって整備されたリアルタイムのデータセット、結合、集計、データリネージ。一度モデル化すれば、データを複製することなく、リアルタイムのデータ上で仮想化されます。
セマンティック定義
既存のセマンティックモデルをインポートするほか、AI のガイドに沿って正式な指標定義やビジネス用語を作成することもできます。
社内のナレッジ
専門家の判断やチームのノウハウ。ドキュメントから取り込んだ内容や、エージェントとの作業を通じて蓄積された内容は、レビューと一度の承認を経て、全社で共有されるコンテキストになります。
編集可能なオープンフォーマット
コンテキストは正規化された形式で保存されます。コンセプトごとに 1 つの Markdown ファイルがあり、そこにスキーマ、結合、ビジネスロジックがまとめられています。
レビュー可能な差分
定義の変更は差分として管理されます。エージェントが新しい定義で回答を始める前に、データオーナーがコードレビューと同じ要領で承認します。
ポータブルなナレッジ
Markdown と YAML で構成されているため、ルーティング先にどのモデルを選んでもコンテキストを利用できます。
人が読める形式
アナリストが読むファイルを、モデルもそのまま参照します。変換を挟まないため、途中で意味が取り違えられる心配もありません。
的確な取得
説明を並べただけのフラットなリストではなく、エージェントがたどれるグラフ構造です。ディレクトリ上の位置と型付きリンクがエッジとなり、エンジンもエージェントもこのエッジをたどって情報を取得します。
エージェントがコンテキストを取得する仕組み
エージェントは一致したコンセプトを起点にグラフをたどり、質問に必要な情報だけを取り出します。そのため、回答の的確さを保ちながら、コンテキストウィンドウも小さく抑えられます。
{
  "matched": {
    "path": "virtual_schemas/revenue/metrics/arr.md",
    "content": "... formula, filter, source ..."
  },
  "related": [
    { "path": "virtual_schemas/revenue/tables/opportunities.md", "relation": "derived_from" },
    { "path": "virtual_schemas/revenue/tables/invoices.md", "relation": "joined_with" },
    { "path": "global/glossary/revenue_terms.md", "relation": "parent_concept" }
  ]
}
エージェントまたは AI ツールが search_context を呼び出す
search_context は、CData Connect AI が MCP を介してあらゆるエージェントや AI ツールに提供するツールです。指標の定義、ビジネスルール、テーブル間の関係性が格納されたコンテキストエンジンを検索し、プロンプトに一致するコンセプトと、それぞれから伸びるリンクを返します。返すのはこれだけなので、最初のレスポンスはコンパクトに収まります。
エージェントが一致したコンセプトを受け取る
コンテキストエンジンは、プロンプトに最も一致するものとして arr.md を返します。ほとんどの質問は、このコンセプトだけで回答できます。
コンセプトのつながりと、その理由を把握
related 配列には、リンク先の各コンセプトと関係の種類が示されます。トークンを費やしてまでリンクをたどるべきかどうかを、エージェントが推測する必要はありません。
必要なときだけ、さらに深く探索
「当社の ARR は?」という質問には、一致したコンセプトだけで回答できます。「ARR が Salesforce の数値と一致しないのはなぜ?」という質問では、joined_with エッジをたどって invoices.md を参照し、数値を突き合わせます。バンドル全体をスキャンするのではなく、1 ホップ追加するだけで済みます。
質問される前から、答えを学んでいく
結果まで見届けるからこそ、エンジンは定義を注入するだけにとどまりません。ループの両輪が互いを補い合い、コンテキストは絶えず改善されていきます。
会話からのシグナル
たとえば、ユーザーが ARR を尋ね、意図と違う切り口の結果が返ってきたので修正したとします。Connect AI はその意図を最終的にうまくいったクエリとひも付け、対応するコンセプトファイルを更新します。
クエリマイニング
利用頻度の高いテーブル、頻出する結合パス、定番のフィルターが時間とともに浮かび上がります。実際の利用状況から得たシグナルでコンセプトファイルを充実させ、取得の精度を高めます。
接続されたナレッジソース
Wiki、カタログ、ドキュメントは、新しいコンセプトファイルとしてバンドルに取り込まれます。さらに、指定した Slack や Teams のチャンネルを監視するエージェントが、定義やスキーマに関する議論をマージ候補として検出し、記録に残らなかった意思決定も拾い上げます。
AI による見直しと整理
Connect AI はバンドル全体を定期的にセルフレビューします。矛盾や重複、欠落を洗い出して整理・再構成することで、ソースが変化してもモデルの一貫性を保ちます。
ヒューマンインザループ
同じ指標に 2 つの定義がある、オーナー不在のまま名前が変わった項目があるなど、エンジンだけでは解決できない問題があれば、適切な担当者に確認し、その回答を取り込みます。
一度の修正が、すべてに行き渡る
一度修正すれば、それ以降はすべてのエージェントが正しく対応します。誰かが教え直さなくても、エージェントはリクエストを重ねるごとに精度を高めていきます。
すべてのリクエストから学習
会話から語彙や修正内容を取り込みます。意図と違う切り口の結果をユーザーが修正すると、ループがその意図をうまくいったクエリとひも付けます。
繰り返し使われる結合やフィルター、よく使われるテーブルが時間とともに浮かび上がり、取得の精度を高めるヒントや同義語になります。
成功したツール呼び出しのパターンを記録します。エージェントはうまくいく方法を毎回探し直すことなく、そのまま繰り返せます。
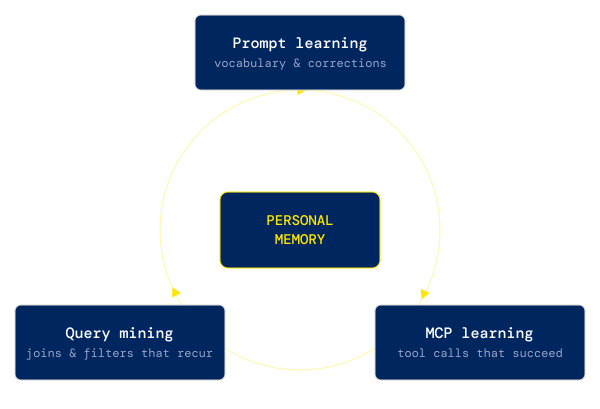
個人のメモリを、社内のナレッジへ
複数のユーザーが同じ事実をそれぞれ記録すると、その内容は自動的に社内の共有ナレッジへと昇格します。
昇格したナレッジがそのまま公開されることはなく、ガバナンスの下で管理されます。何を共有するかは、オーナーが決められます。
サポート部門で一度行った修正が、財務のエージェントの改善にもつながります。グラフを利用するチームが増えるほど、その価値は高まります。
それぞれ独立して記録
チェック
レビュー・承認
ナレッジ
継承
次回から、すべてのエージェントが継承
昇格したナレッジはコンテキストグラフに反映され、次のリクエストからはどのエージェントにも適用されます。しかも、回答は常にリアルタイムのデータに基づいてグラウンディングされます。
グラフは特定のモデルの内部ではなく、ゲートウェイに保持されます。モデルを切り替えても、エージェントが学習した内容はそのまま引き継がれます。
 Claude 上
 GPT 上
 Gemini 上
決め手はコンテキストレイヤー
CData Labs による 2 つの調査が導いた結論は 1 つ。精度とコストを左右するのはモデルではなく、AI と自社システムをつなぐレイヤーです。
98.5%
Connect AI 経由の正答率
この差を生むのがコンテキストエンジンです。Connect AI は、リクエストがモデルに届く前に、そのすべてを自社のスキーマとビジネスコンテキストに基づいてグラウンディングします。 CData Software による社内テストに基づく結果です(2025年第4四半期)。第三者機関による独立した検証は行われていません。実際の精度差はプラットフォームおよび MCP アプローチによって異なり、テストは本番環境のアカウント構成を模した、既知のデータセットを含むサンドボックスアカウントを使用して実施されました。結果は実運用環境でのパフォーマンスを代表するものではなく、結果は変動する可能性があります。各組織は、購入または導入の意思決定を行う前に、独自に検証を実施する必要があります。プラットフォーム間の平均精度は 75% 前後の幅があり、結果は MCP アプローチによって異なります。
レポートを入手する
178×
同じ正解を得るためのコスト差
コンテキストが精度を担保するため、安価なモデルでも正しい回答を返せます。つまり、モデルはコストだけを基準に選べるようになります。 CData Software による社内テストに基づく結果です(2026年第3四半期)。第三者機関による独立した検証は行われていません。実際のコスト差はモデルによって異なり、テストは本番環境のアカウント構成を模した、既知のデータセットを含むサンドボックスアカウントを使用して実施されました。結果は実運用環境でのパフォーマンスを代表するものではなく、結果は変動する可能性があります。各組織は、購入または導入の意思決定を行う前に、独自に検証を実施する必要があります。
レポートを入手する
データベース管理者、TCWGlobal

すべてのエージェントと人に、正しい答えを導くコンテキストを
信頼性の高いエージェント、安定した高い精度、そしてトークン消費の削減。そのすべてを、あらゆる LLM、MCP、セマンティックプロバイダー、データプラットフォームで活かせます。