



Pentaho Data Integration でBugHerd のデータを連携
CData API Driver for JDBC を使用すると、データパイプラインからリアルタイムデータにアクセスできます。Pentaho Data Integration は、ETL(Extraction, Transformation, and Loading)エンジンであり、データをクレンジングし、アクセス可能な統一フォーマットでデータを格納します。この記事では、BugHerd のデータ に JDBC データソースとして接続し、Pentaho Data Integration で BugHerd のデータ をベースにしたジョブやトランスフォーメーションを構築する方法を説明します。
BugHerd への接続を設定
まず、Profile 接続プロパティをディスク上の BugHerd プロファイルの場所に設定します(例:C:\profiles\BugHerd.apip)。次に、ProfileSettings 接続プロパティを BugHerd の接続文字列に設定します(以下を参照)。
BugHerd API プロファイル設定
BugHerd では、API キーをユーザー名とする HTTP Basic 認証を使用します。API キーは以下の手順で取得できます。
- https://www.bugherd.com で BugHerd アカウントにサインインします。
- 「Settings」>「General Settings」に移動します。
- 「API Key」セクションで、生成されたキーをコピーします。
API キーを取得したら、以下の接続プロパティを設定します。
- AuthScheme:APIKey に設定します。
ProfileSettings 接続プロパティには、以下を設定します。
- APIKey:BugHerd の API キーに設定します。ドライバーはこのキーを Basic 認証のユーザー名として使用し、BugHerd の仕様に従ってパスワードを内部的に固定値 'x' に設定します。
組み込みの接続文字列デザイナー
JDBC URL の構築を支援するには、BugHerd JDBC Driver に組み込まれている接続文字列デザイナーを使用してください。JAR ファイルをダブルクリックするか、コマンドラインから JAR ファイルを実行します。
java -jar cdata.jdbc.api.jar
接続プロパティを設定し、接続文字列をクリップボードにコピーします。
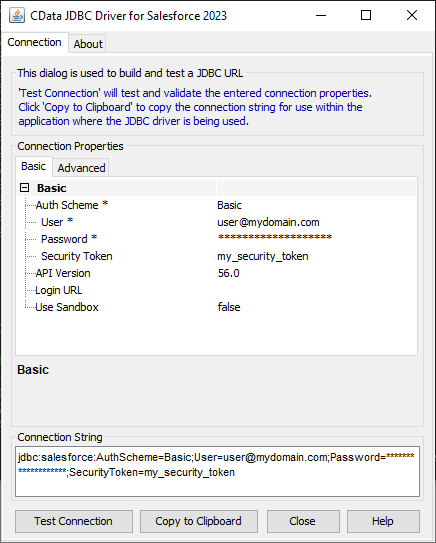
JDBC URL を設定する際には、Max Rows 接続プロパティの設定も検討してください。これにより返される行数が制限され、レポートやビジュアライゼーションの設計時にパフォーマンスを向上させることができます。
一般的な JDBC URL は次のようになります:
jdbc:api:Profile=C:\profiles\BugHerd.apip;AuthScheme=APIKey;ProfileSettings='APIKey=your_api_key';接続文字列を保存して、Pentaho Data Integration で使用します。
Pentaho DI から BugHerd に接続
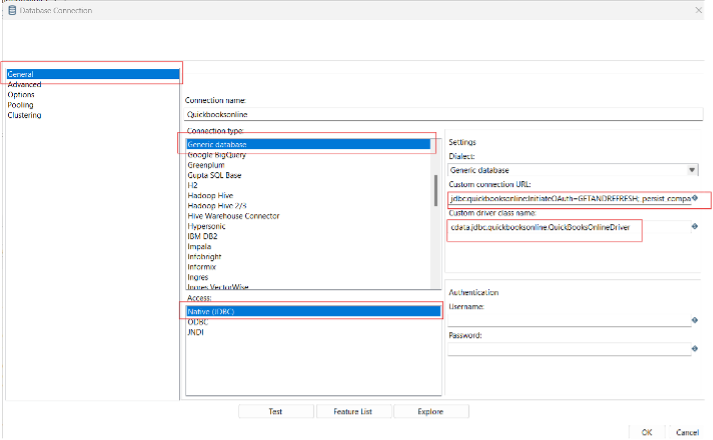
Pentaho Data Integration を開き、「Database Connection」を選択して CData API Driver for JDBC への接続を設定します。
- 「General」をクリックします。
- Connection name を設定します(例:BugHerd Connection)。
- Connection type を「Generic database」に設定します。
- Access を「Native (JDBC)」に設定します。
- Custom connection URL に BugHerd の接続文字列を設定します(例:
)。jdbc:api:Profile=C:\profiles\BugHerd.apip;AuthScheme=APIKey;ProfileSettings='APIKey=your_api_key'; - Custom driver class name を「cdata.jdbc.api.APIDriver」に設定します。
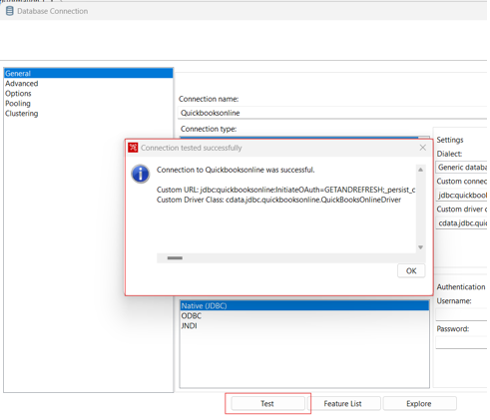
- 接続をテストし、「OK」をクリックして保存します。
BugHerd のデータパイプラインを作成
CData JDBC Driver を使用して BugHerd への接続が設定されたら、新しいトランスフォーメーションまたはジョブを作成する準備が整いました。
- 「File」>>「New」>>「Transformation/job」をクリックします。
- 「Table input」オブジェクトをワークフローパネルにドラッグし、BugHerd 接続を選択します。
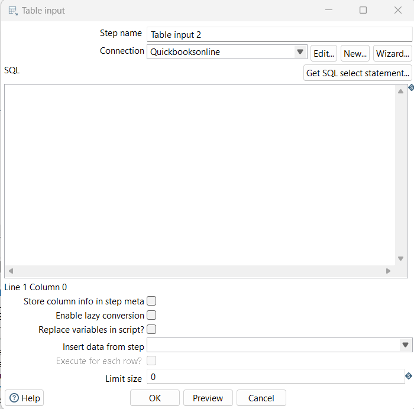
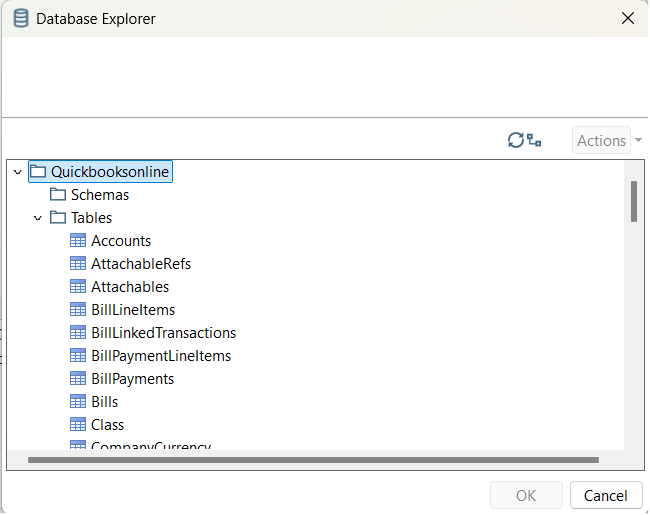
- 「Get SQL select statement」をクリックし、Database Explorer を使用して利用可能なテーブルとビューを表示します。
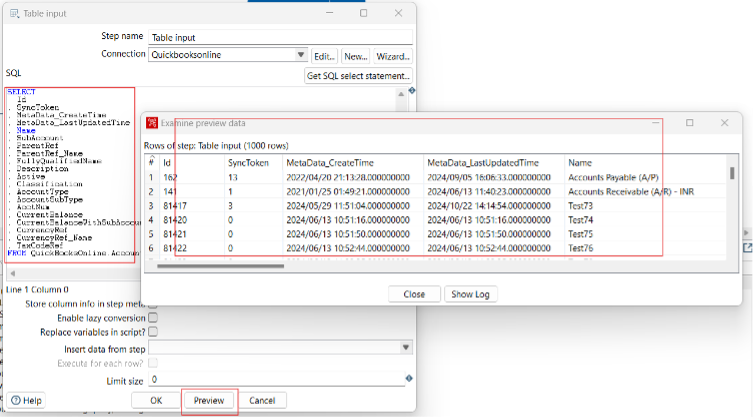
- テーブルを選択し、必要に応じてデータをプレビューして確認します。
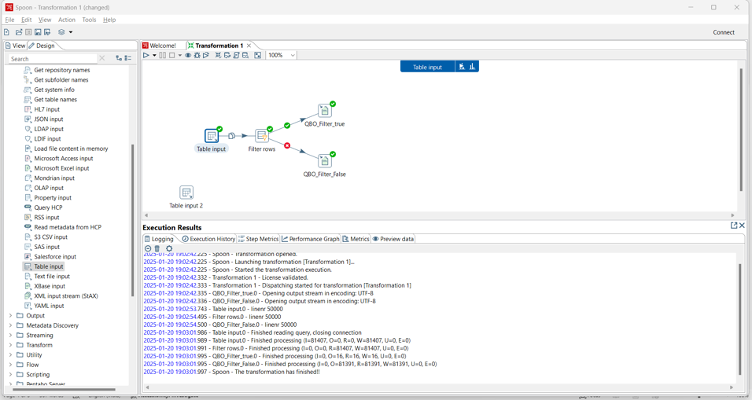
ここから、適切な同期先を選択し、レプリケーション中にデータを変更、フィルタリング、その他の処理を行うトランスフォーメーションを追加することで、トランスフォーメーションまたはジョブを続行できます。
無料トライアルと詳細情報
CData API Driver for JDBC の 30日間無料トライアルをダウンロードして、Pentaho Data Integration で BugHerd のデータ のリアルタイムデータを今すぐ活用しましょう。