



Google Cloud Data Fusion でCanny のデータを扱う方法:CData JDBC Driver

Google Cloud Data Fusion は、ノーコードでデータ連携の設定が可能な言わば GCP の ETL ツール(サービス)です。たくさんのコネクタや変換・分析機能がデフォルトで用意されているため、さまざまなデータソースを色々な組み合わせで扱うことが可能なようです。 また JDBC を扱うこともできるため、この記事では、CData JDBC Driver for Canny のデータ を使って、Canny のデータ データをCloud Data Fusion でGoogle BigQuery にノーコードでパイプラインします。
Cloud Data Fusion の準備
まずはCloud Data Fusion のインスタンスを作成します。
- Data Fusion のトップ画面にある「CREATE INSTANCE」からインスタンスを作成します。
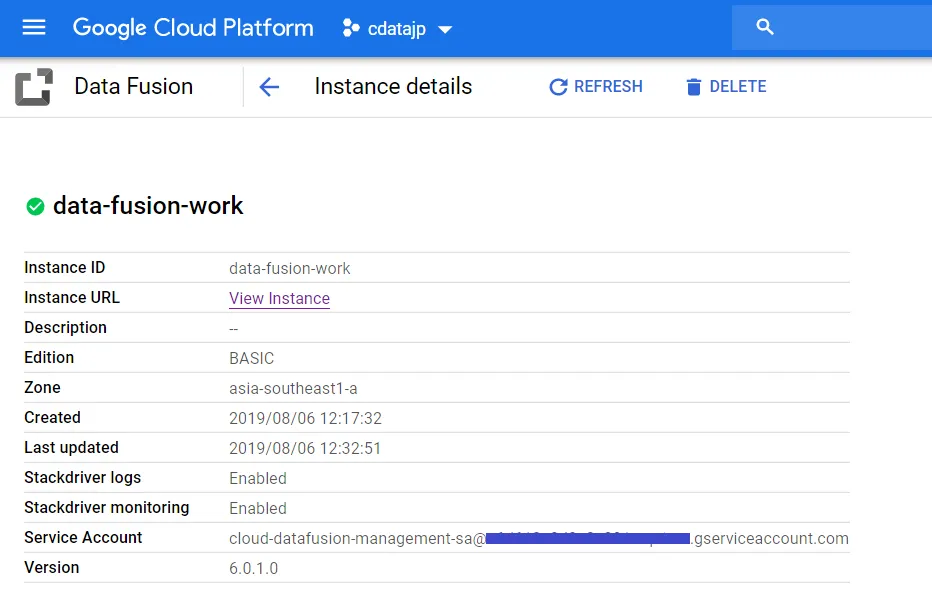
- 作成されたインスタンス名を先ほどの画面でクリックすると以下の画面に遷移しますので、画面下部にある Service Account をコピーします。
- 画面上部にある追加からメンバーを追加します。メンバー名は先ほどコピーした「Service Account」に合わせてください。 役割は BiqQuery へもアクセスしますので、「BigQuery 管理者」、「Cloud Data Fusion 管理者」、「Cloud Data Fusion API サービス エージェント」を付与します。
CData JDBC Driver for API のアップロード
ここからは実際に、Data Fusion の設定をしていきます。 まずは JDBC Driver をアップロードを行います。
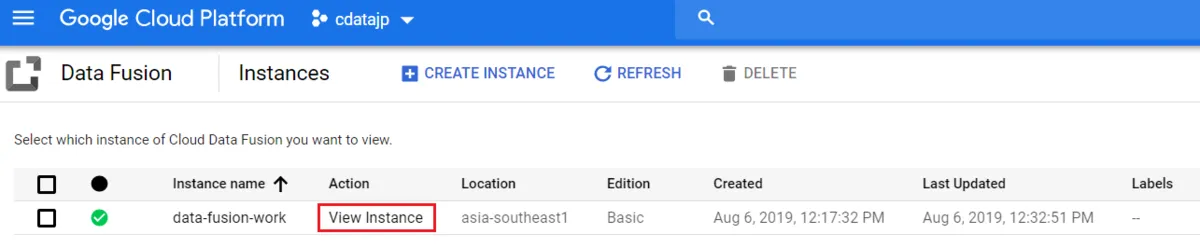
- 「View Instance」をクリックして、Data Fusion の Control Center を開きます。
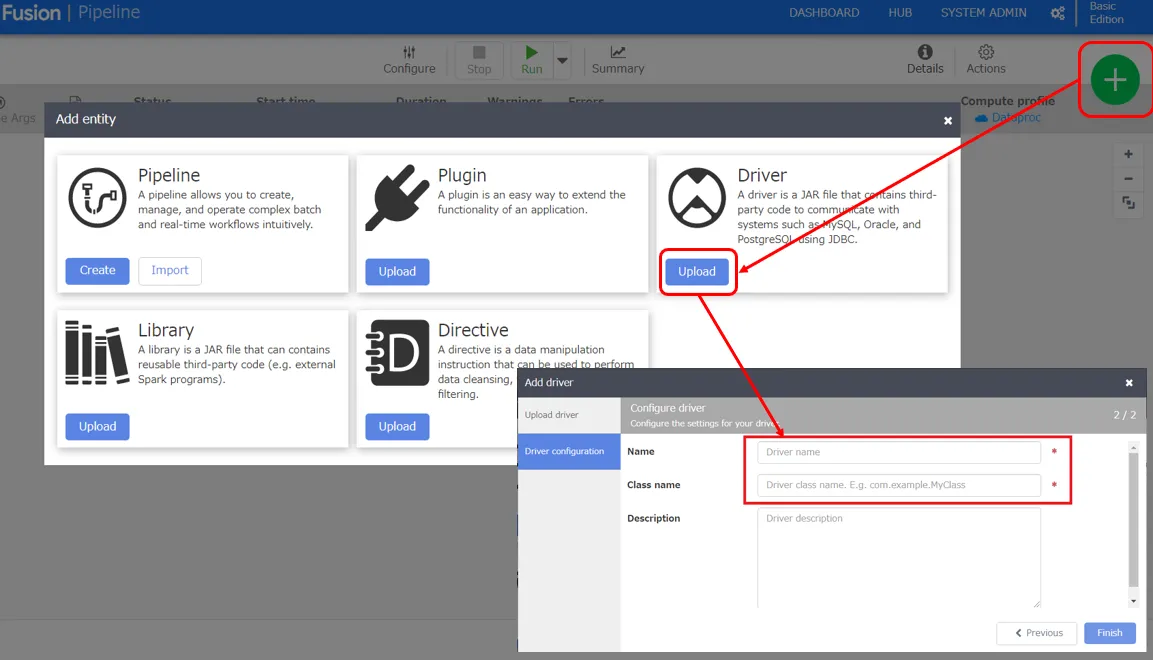
- Control Center が表示されたら、「+」ボタンをクリックして JDBC Driver をアップロードしていきます。
- Name:アップロードしたドライバーに設定する名前
- Class name:cdata.jdbc.api.APIDriver
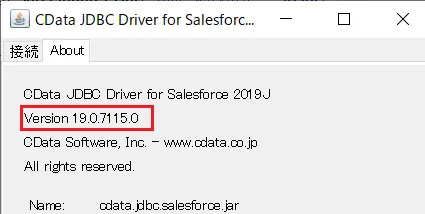
- アップロードする際の注意点として、Driver のファイル名を name-version の形式に変更してアップロードする必要があります。 なお、jarファイルをダブルクリックした際に表示されているバージョンをもとに「api-connector-java-19.0.7115.0.jar」に変更しました。
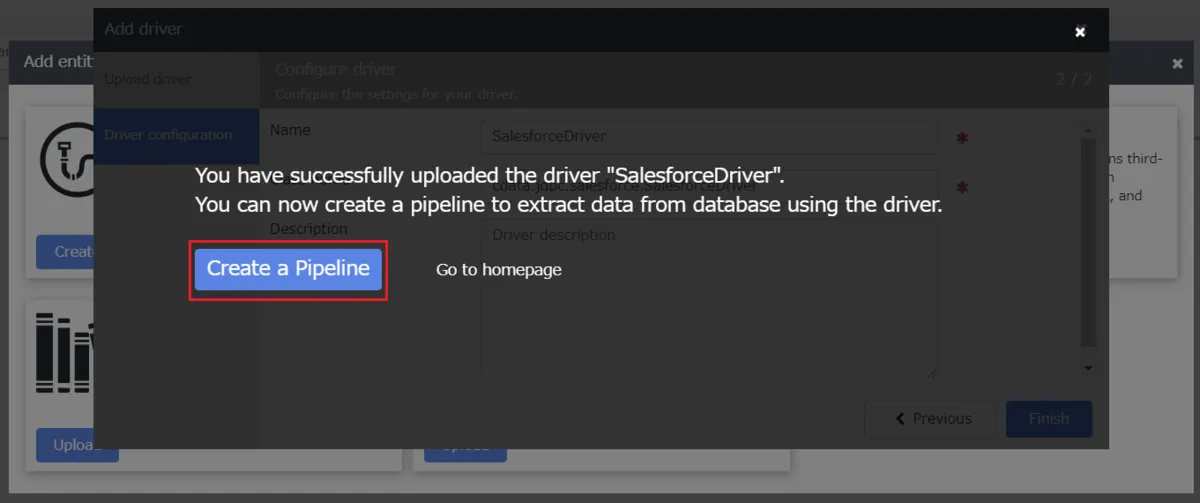
- アップロードが成功するとこのような画面が表示されるので、「Create a Pipeline」をクリックします。
Canny からGoogle BigQuery へのパイプラインの作成
Data Fusion のパイプライン作成
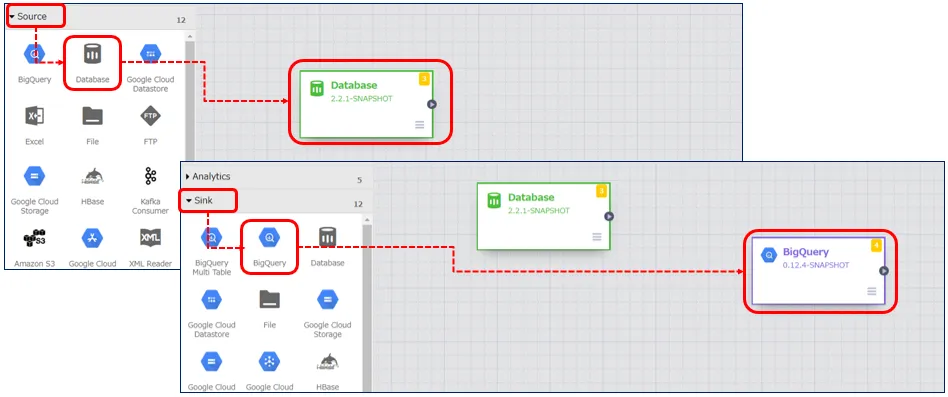
インプット元はサイドメニューの「Source」から選択します。今回は先ほどアップロードした Canny のデータ の JDBC Driver を使用するため、「DataBase」を選択します。 アウトプット先は同じくサイドメニューより「Sink」→「BigQuery」を選択します。
「DataBase」の設定
「DataBase」のアイコンにカーソルを持ってくるとプロパティというボタンが表示されるのでクリックし、下記内容を設定します。
- Label:API
- Reference Name:API
- Plugin Name:API Driver(Driver をアップロードした際の名前)
- Plugin Type:jdbc
- Connection String:API へ接続する際の JDBC URL
- Import Query:インプットしたいデータを抽出するクエリ
まず、Profile 接続プロパティをディスク上の Canny プロファイルの場所に設定します(例:C:\profiles\Canny.apip)。次に、ProfileSettings 接続プロパティを Canny の接続文字列に設定します(以下を参照)。
Canny API プロファイル設定
Canny では、シークレット API キーで API へのアクセスを制御します。API キーは、Canny API エンドポイントへのすべての HTTP POST リクエストで、'apiKey' という名前の JSON ボディパラメータとして送信されます。
Canny API で認証するには、会社単位のシークレット API キーが必要です。このキーは、Canny アカウントの「Settings」>「API」で確認できます。
以下の接続プロパティを設定すると、接続できるようになります。
- AuthScheme:APIKey に設定します。
- APIKey:Canny ダッシュボードの「Settings」>「API」ページで確認できる、会社単位のシークレット API キーに設定します。
Connection String は以下の形式です。
jdbc:api:Profile=C:\profiles\Canny.apip;ProfileSettings='APIKey=your-canny-api-key';
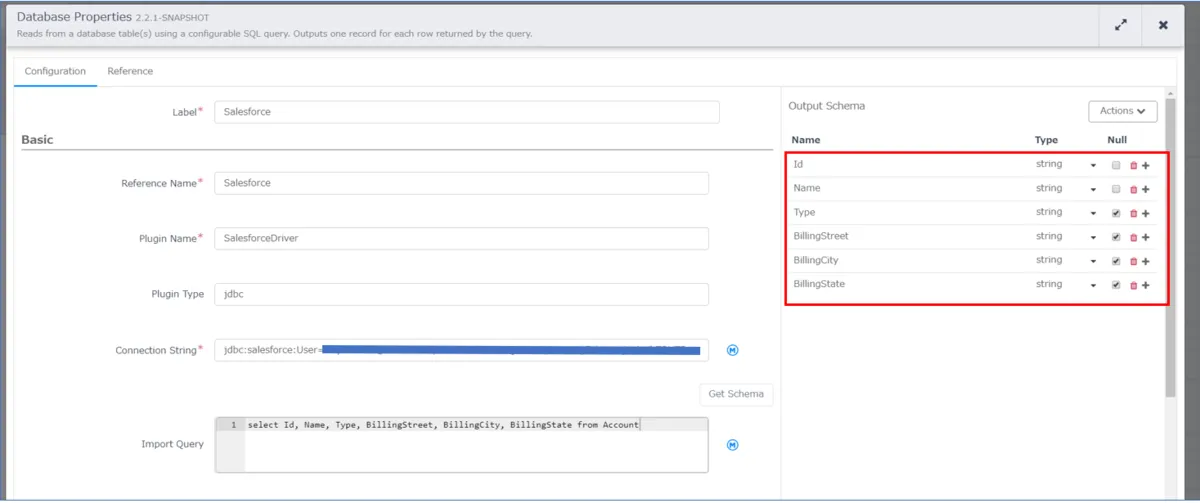
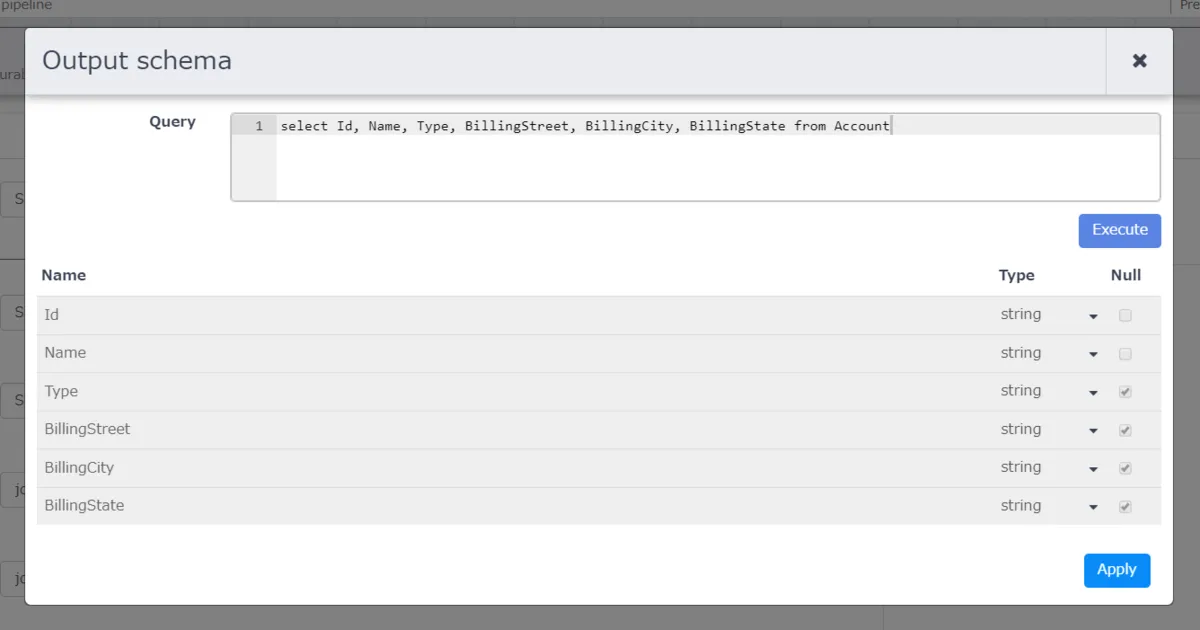
上のキャプチャの赤枠は、Salesforce から BigQuery へアウトプットするデータの定義となります。 こちらは「Import Query」のすぐ右上にある「Get Schema」をクリックすると下の画面が表示されますので、「Import Query」で入力したクエリを実行し、カラムを定義します。
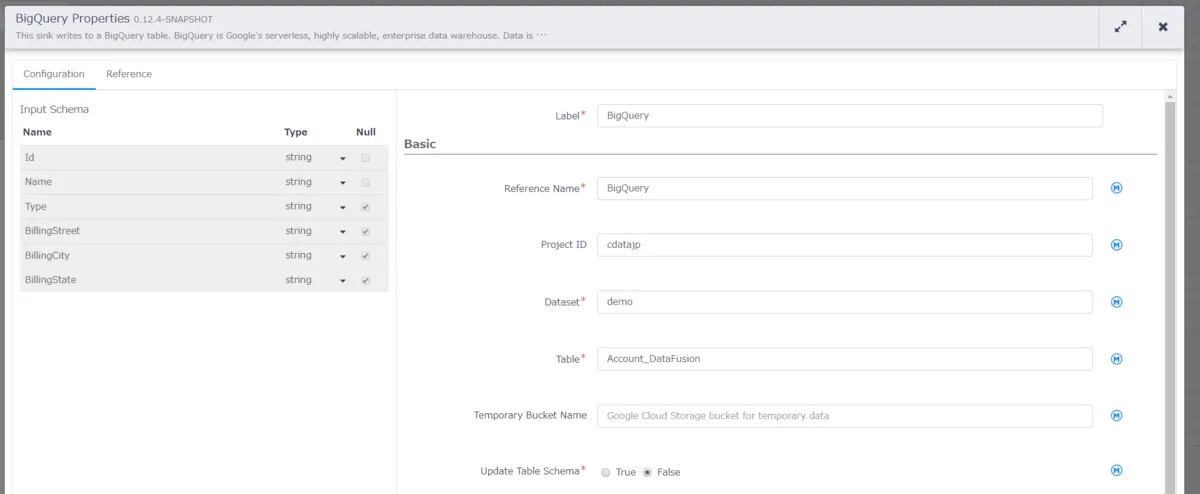
「BigQuery」の設定
こちらも同様に BigQuery のプロパティから下記内容を設定します。
- Label:BigQuery
- Reference Name:BigQuery
- Project ID:使用するProject ID
- DataSet:使用するDataSet
- Table:使用するテーブル名、例:Account_DataFusion
作成したCanny のデータ からBigQuery のパイプラインの実行
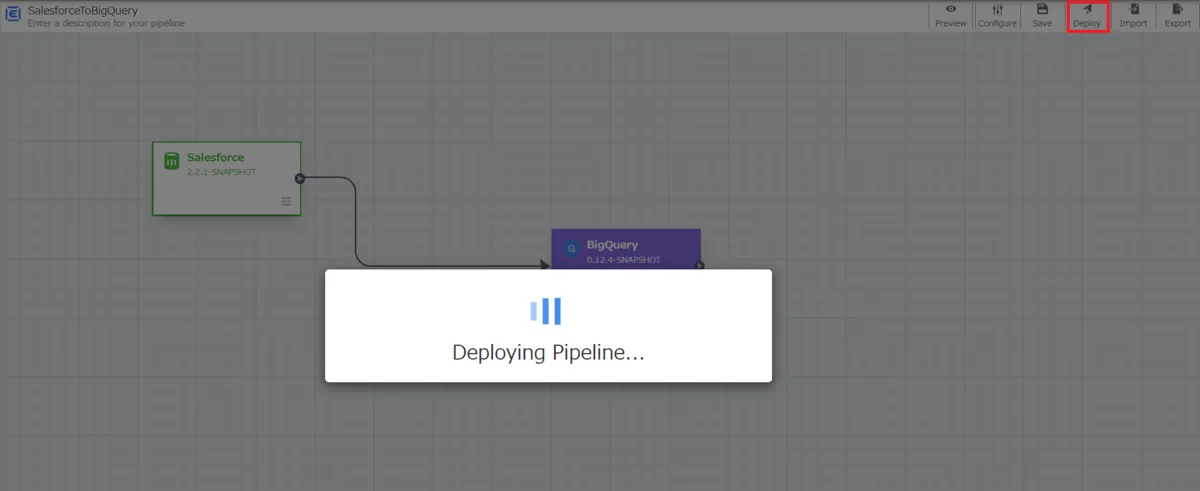
まずは作成したパイプラインをデプロイします。赤枠の「Deploy」ボタンをクリックしてデプロイを行います。
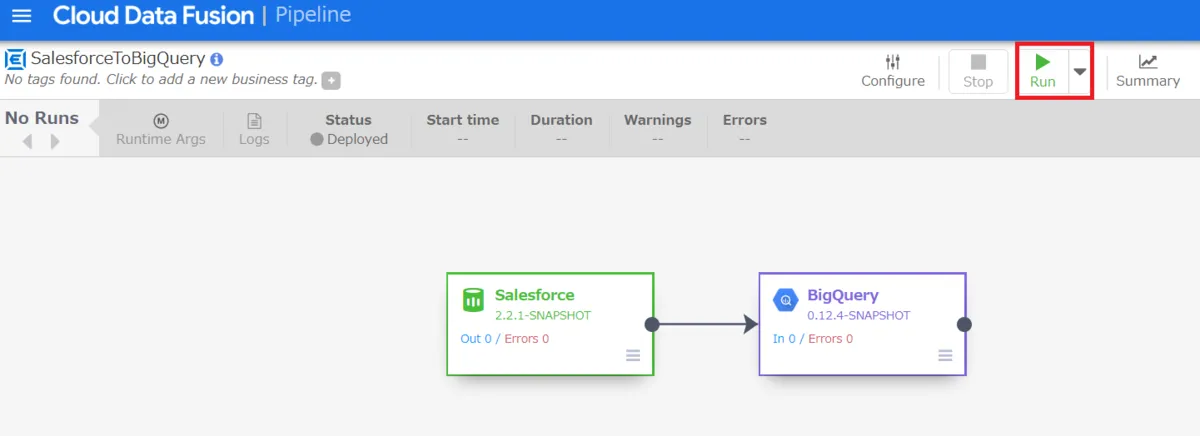
デプロイ完了後、Runボタンが表示されますので、クリックします。
このようにCData JDBC ドライバをアップロードすることで、簡単にGoogle Cloud Data Fusion でCanny のデータ データをノーコードで連携し、BigQuery などへのパイプラインを作成することができます。
是非、CData JDBC Driver for API 30日の無償評価版 をダウンロードして、お試しください。