



Apache Spark でClaude Compliance のデータをSQL で操作する方法

Apache Spark は大規模データ処理のための高速エンジンです。CData JDBC Driver for ClaudeCompliance と組み合わせると、Spark はリアルタイムでClaude Compliance のデータに連携して処理ができます。本記事では、Spark シェルに接続してClaude Compliance をクエリする方法について解説します。
CData JDBC Driver は、最適化されたデータ処理がドライバーに組み込まれているため、リアルタイムClaude Compliance と対話するための高いパフォーマンスを提供します。Claude Compliance に複雑なSQL クエリを発行すると、ドライバーはフィルタや集計など、サポートされているSQL操作を直接Claude Compliance にプッシュし、組込みSQL エンジンを使用してサポートされていない操作(SQL 関数やJOIN 操作)をクライアント側で処理します。組み込みの動的メタデータクエリを使用すると、ネイティブデータ型を使用してClaude Compliance を操作して分析できます。
CData JDBC Driver for ClaudeCompliance をインストール
まずは、本記事右側のサイドバーからClaudeCompliance JDBC Driver の無償トライアルをダウンロード・インストールしてください。30日間無償で、製品版の全機能が使用できます。
Spark Shell を起動してClaude Compliance のデータに接続
- ターミナルを開き、Spark shell でCData JDBC Driver for ClaudeCompliance JAR file をjars パラメータに設定します:
$ spark-shell --jars /CData/CData JDBC Driver for ClaudeCompliance/lib/cdata.jdbc.claudecompliance.jar - Shell でJDBC URL を使ってClaude Compliance に接続し、SQL Context load() function でテーブルを読み込みます。
ドライバーは Compliance Access Key を使用して Claude Compliance に接続します(サポートされている認証方式はこれのみです)。以下の接続プロパティを設定します。
- APIKey:作成した Compliance Access Key。
Compliance Access Key の作成
- 組織で Compliance API を有効にします。
- Primary Owner または Organization Owner として claude.ai にサインインし、Organization settings > API > Keys を開きます。
- Create Key を選択し、連携に必要なスコープのみを割り当てます。
- read:compliance_activities:Activities および各種アクティビティビュー用。
- read:compliance_org_data:組織、ロール、グループ、設定用。
- read:compliance_user_data:ユーザー、チャット、ファイル、プロジェクト、ダウンロード用。
- delete:compliance_user_data:明示的な Delete ストアドプロシージャ用。
- キーを作成し、表示されたらすぐにコピーします。キーは sk-ant-api01- で始まり、一度しか表示されません。
必要に応じて OrganizationUUID を設定すると、組織スコープのビュー(OrganizationUsers や ComplianceRoles など)を、リンクされた特定の 1 組織に限定できます。空欄の場合、これらのビューはデフォルトで最初に利用可能な組織を対象とし、リンクされたすべての組織のデータは含まれません。
組み込みの接続文字列デザイナー
JDBC 接続文字列URL の作成には、Claude Compliance JDBC Driver にビルトインされたデザイナを使用できます。JAR ファイルをダブルクリックするか、コマンドラインでJAR ファイルを実行するとデザイナが開きます。
java -jar cdata.jdbc.claudecompliance.jar接続プロパティを入力し、接続文字列をクリップボードにコピーします。
scala> val claudecompliance_df = spark.sqlContext.read.format("jdbc").option("url", "jdbc:claudecompliance:APIKey=your_compliance_access_key;").option("dbtable","Projects").option("driver","cdata.jdbc.claudecompliance.ClaudeComplianceDriver").load() - 接続が完了し、データがロードされたら、テーブルスキーマが表示されます。
Claude Compliance をテンポラリーテーブルとして登録します:
scala> claudecompliance_df.registerTable("projects")-
データに対して、次のようなカスタムSQL クエリを実行します。
scala> claudecompliance_df.sqlContext.sql("SELECT Id, Name FROM Projects WHERE OrganizationUuid = abcdef01-2345-6789-abcd-ef0123456789").collect.foreach(println)コンソールで、次のようなClaude Compliance のデータを取得できました!これでClaude Compliance との連携は完了です。
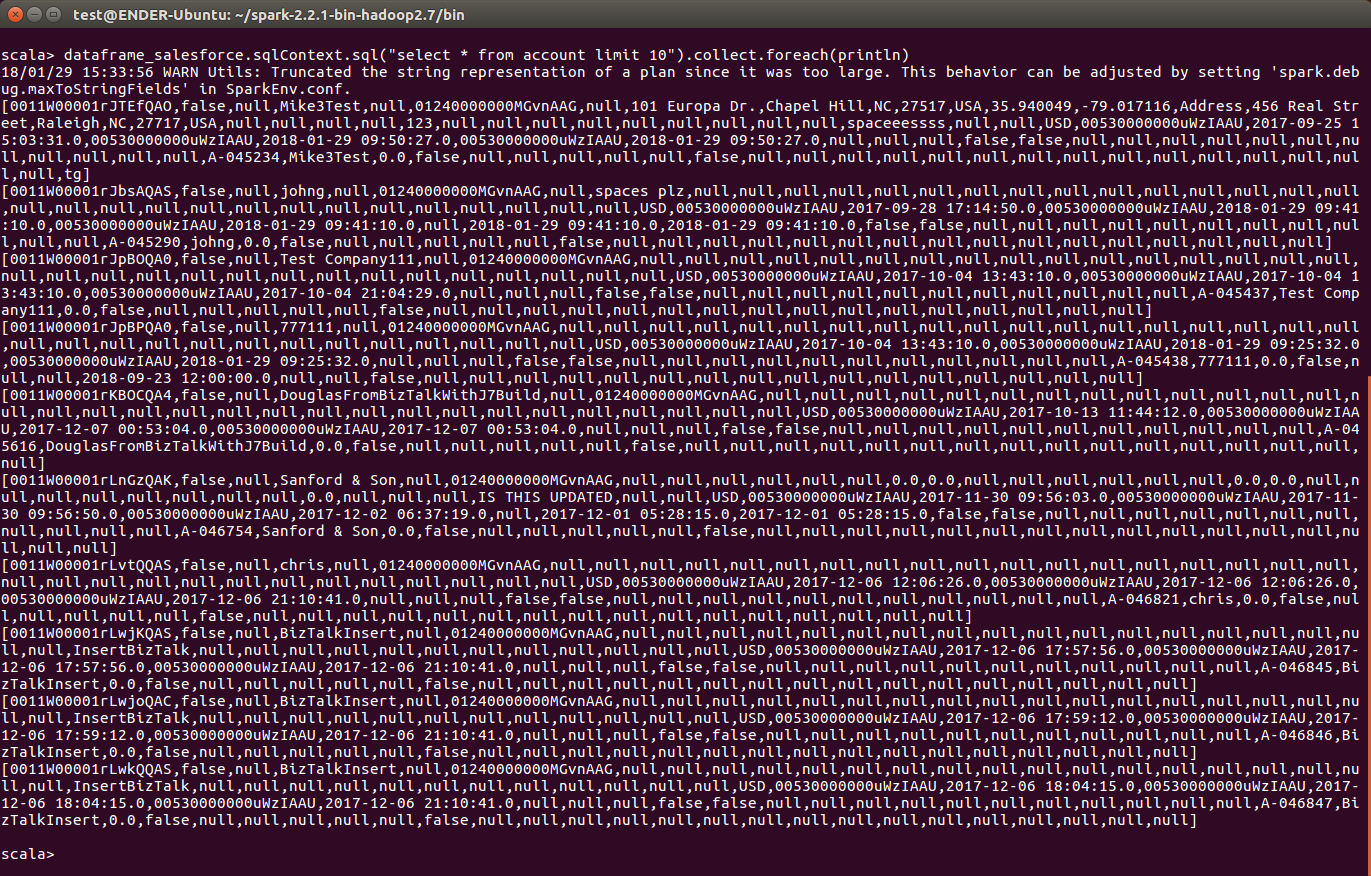
CData JDBC Driver for ClaudeCompliance をApache Spark で使って、Claude Compliance に対して、複雑かつハイパフォーマンスなクエリを実行できます。30日の無償評価版 をダウンロードしてぜひお試しください。
Apache Spark の設定
はじめる準備はできましたか?
Claude Compliance Driver の無料トライアルをダウンロードしてお試しください:
ダウンロード