



Databricks(AWS)でEgnyte のデータを処理・分析
Databricks は、Apache Spark を通じたデータ処理機能を提供するクラウドベースのサービスです。CData JDBC Driver と組み合わせることで、Databricks を使用してリアルタイムEgnyte のデータに対してデータエンジニアリングとデータサイエンスを実行できます。この記事では、AWS でCData JDBC Driver をホストし、Databricks でリアルタイムEgnyte のデータに接続して処理する方法を説明します。
最適化されたデータ処理が組み込まれたCData JDBC Driver は、リアルタイムEgnyte のデータを扱う上で比類のないパフォーマンスを提供します。Egnyte に複雑なSQL クエリを発行すると、ドライバーはフィルタや集計などのサポートされているSQL 操作をEgnyte に直接プッシュし、サポートされていない操作(主にSQL 関数やJOIN 操作)は組み込みSQL エンジンを利用してクライアント側で処理します。組み込みの動的メタデータクエリを使用すると、ネイティブデータ型を使ってEgnyte のデータを操作・分析できます。
CData JDBC Driver をDatabricks にインストール
Databricks でリアルタイムEgnyte のデータを操作するには、Databricks クラスターにドライバーをインストールします。
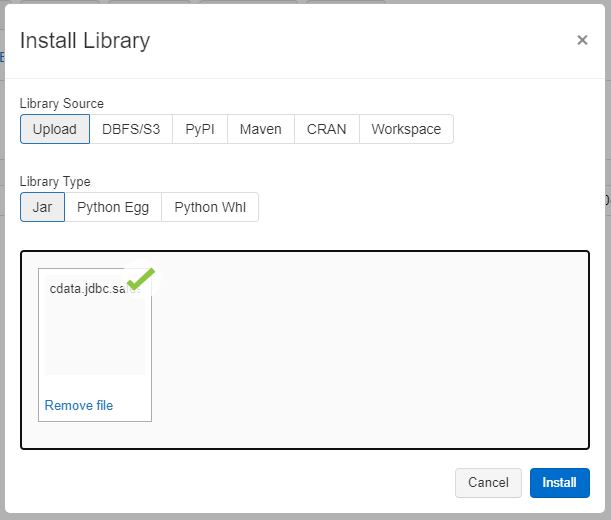
- Databricks の管理画面に移動し、対象のクラスターを選択します。
- Libraries タブで「Install New」をクリックします。
- Library Source として「Upload」を選択し、Library Type として「Jar」を選択します。
- インストール場所(通常はC:\Program Files\CData[product_name]\lib)からJDBC JAR ファイル(cdata.jdbc.api.jar)をアップロードします。
ノートブックでEgnyte のデータにアクセス:Python
JAR ファイルをインストールしたら、Databricks でリアルタイムEgnyte のデータを操作する準備が整いました。ワークスペースに新しいノートブックを作成します。ノートブックに名前を付け、言語としてPython を選択し(Scala も利用可能)、JDBC ドライバーをインストールしたクラスターを選択します。ノートブックが起動したら、接続を設定し、Egnyte をクエリして、基本的なレポートを作成できます。
Egnyte への接続を設定
JDBC Driver クラスを参照し、JDBC URL で使用する接続文字列を構築してEgnyte に接続します。また、JDBC URL でRTK プロパティを設定する必要があります(Beta ドライバーを使用している場合を除く)。このプロパティの設定方法については、インストールに含まれるライセンスファイルを参照してください。
ステップ1:接続情報
driver = "cdata.jdbc.api.APIDriver"
url = "jdbc:api:RTK=5246...;Profile=C:\profiles\Egnyte.apip;Authscheme=OAuth;OAuthClientId=your_client_id;OAuthClientSecret=your_client_secret;CallbackUrl=your_callback_url;"
組み込みの接続文字列デザイナー
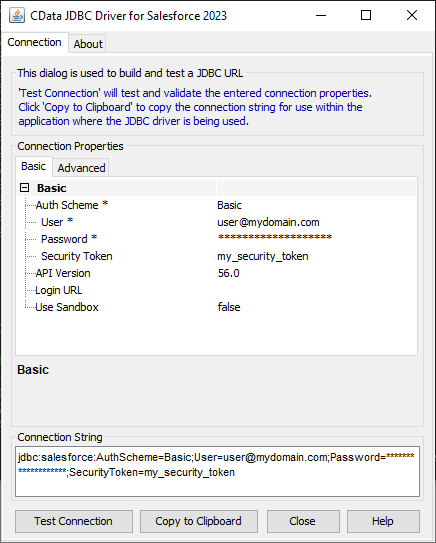
JDBC URL の作成をサポートするために、Egnyte JDBC Driver に組み込まれている接続文字列デザイナーが使用できます。JAR ファイルをダブルクリックするか、コマンドラインからJAR ファイルを実行します。
java -jar cdata.jdbc.api.jar
接続プロパティを入力し、接続文字列をクリップボードにコピーします。
まず、Profile 接続プロパティをディスク上の Egnyte プロファイルの場所に設定します(例:C:\profiles\Egnyte.apip)。次に、ProfileSettings 接続プロパティを Egnyte の接続文字列に設定します(以下を参照)。
Egnyte API プロファイル設定
Egnyte で開発者アカウントを登録し、OAuth アプリケーションを作成して Client ID と Secret を取得します。ドメインは Egnyte の URL から抽出されます。
Egnyte のデータをロード
接続を設定したら、CData JDBC Driver と接続情報を使用して、Egnyte のデータをDataFrame としてロードできます。
ステップ2:データの読み取り
remote_table = spark.read.format ( "jdbc" ) \
	.option ( "driver" , driver) \
	.option ( "url" , url) \
	.option ( "dbtable" , "Bookmarks") \
	.load ()
Egnyte のデータを表示
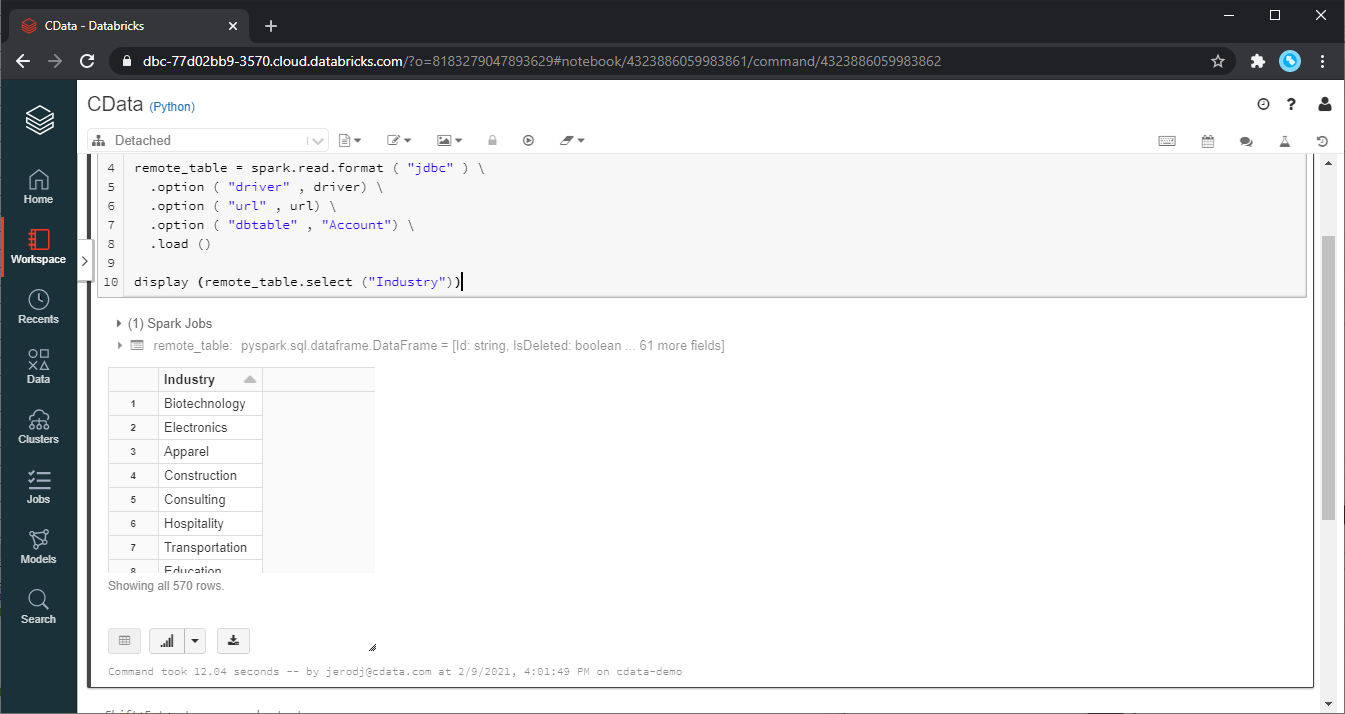
ロードしたEgnyte のデータをdisplay 関数を呼び出して確認します。
ステップ3:結果の確認
display (remote_table.select ("Id"))
Databricks でEgnyte のデータを分析
Databricks SparkSQL でデータを処理するには、ロードしたデータをTemp View として登録します。
ステップ4:ビューまたはテーブルを作成
remote_table.createOrReplaceTempView ( "SAMPLE_VIEW" )
Temp View を作成したら、SparkSQL を使用してEgnyte のデータをレポート、ビジュアライゼーション、分析用に取得できます。
% sql

SELECT Id, Path FROM SAMPLE_VIEW ORDER BY Path DESC LIMIT 5
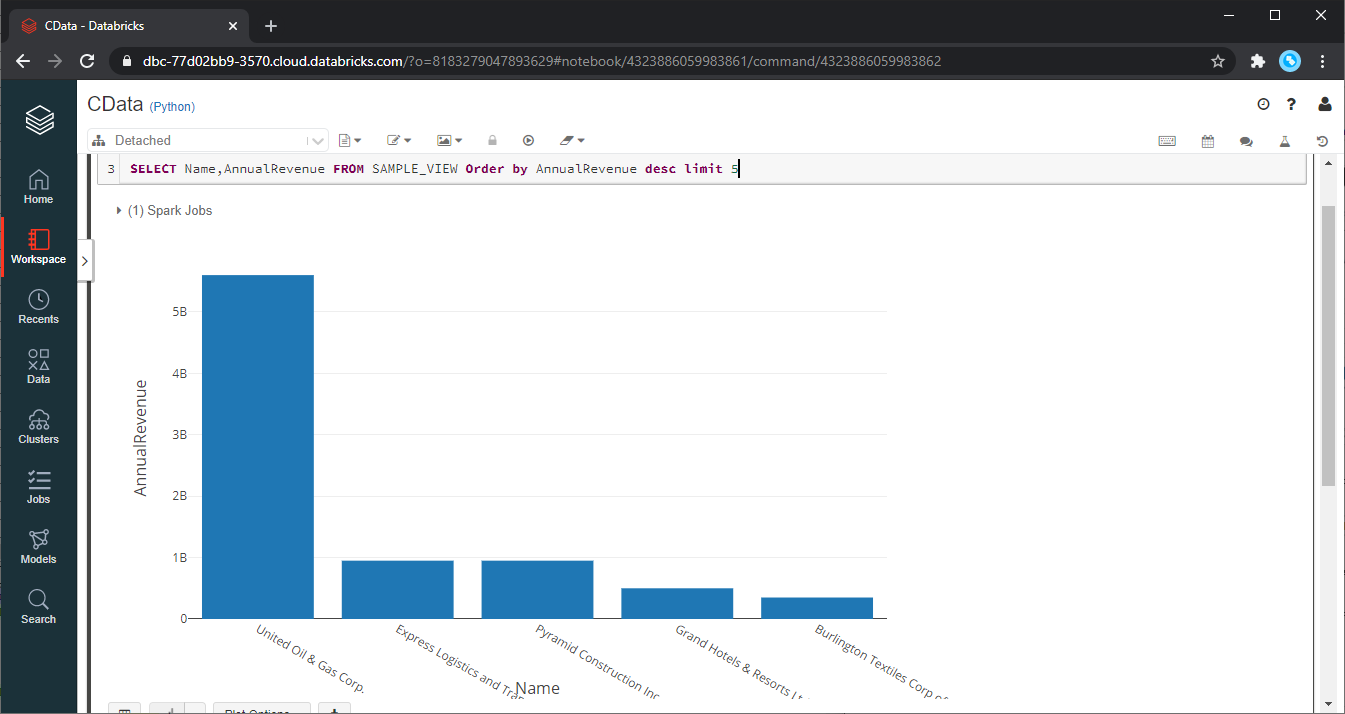
Egnyte からのデータは、対象のノートブックでのみ利用可能です。他のユーザーと共有したい場合は、テーブルとして保存します。
remote_table.write.format ( "parquet" ) .saveAsTable ( "SAMPLE_TABLE" )
CData API Driver for JDBC の30日間無償トライアルをダウンロードして、Databricks でリアルタイムEgnyte のデータの操作をはじめましょう。ご不明な点があれば、サポートチームにお問い合わせください。