Apache Airflow で Gumroad データを連携
Apache Airflow は、データエンジニアリングワークフローの作成、スケジューリング、モニタリングをサポートするツールです。 CData API Driver for JDBC と組み合わせることで、Airflow からリアルタイムの Gumroad のデータ を扱うことができます。 この記事では、Apache Airflow インスタンスから Gumroad のデータ に接続してクエリを実行し、結果を CSV ファイルに保存する方法を説明します。
CData JDBC ドライバーは、最適化されたデータ処理機能を組み込んでおり、 リアルタイムの Gumroad のデータ を扱う際に比類のないパフォーマンスを発揮します。複雑な SQL クエリを Gumroad に発行すると、 ドライバーはフィルタや集計などのサポートされている SQL 操作を直接 Gumroad にプッシュし、 サポートされていない操作(主に SQL 関数や JOIN 操作)は組み込みの SQL エンジンを使用してクライアント側で処理します。 また、組み込みの動的メタデータクエリ機能により、ネイティブのデータ型を使用して Gumroad のデータ の操作・分析が可能です。
Gumroad への接続を設定
組み込みの接続文字列デザイナー
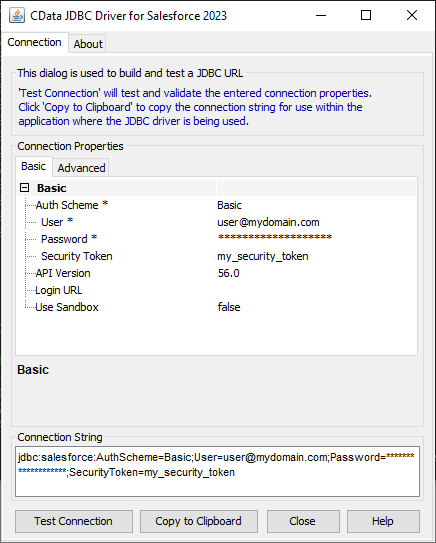
JDBC URL の構築には、Gumroad JDBC Driver に組み込まれている接続文字列デザイナーを使用できます。JAR ファイルをダブルクリックするか、コマンドラインから JAR ファイルを実行してください。
java -jar cdata.jdbc.api.jar
接続プロパティを入力し、接続文字列をクリップボードにコピーします。
OAuth 認証の設定
Gumroad への認証では、OAuth 2.0 標準を使って自分自身のデータに接続する場合はもちろん、他のユーザーが各自のデータに接続できるようにする場合にも利用できます。これが推奨される認証方式です。
まず、Gumroad に OAuth アプリケーションを登録する必要があります。https://app.gumroad.com/settings/advanced の Gumroad アカウント設定にアクセスし、Applications セクションに移動して OAuth アプリケーションを作成できます。
以下の接続プロパティを設定して接続を確立してください:
- AuthScheme:OAuth に設定します。
- InitiateOAuth:GETANDREFRESH に設定します。CData API Profile for Gumroad が OAuth プロセスを自動的に進め、アクセストークンを取得します。
- OAuthClientID:アプリ設定で指定された client_id に設定します。
- OAuthClientSecret:アプリ設定で指定された client_secret に設定します。
- CallbackURL:アプリ設定で指定したリダイレクト URI に設定します。
接続文字列の例
Profile=C:\profiles\Gumroad.apip;AuthScheme=OAuth;InitiateOAuth=GETANDREFRESH;OAuthClientId=your_client_id;OAuthClientSecret=your_client_secret;CallbackUrl=your_callback_url;
クラスター環境やクラウドで JDBC ドライバーをホストする場合は、ライセンス(製品版またはトライアル版)とランタイムキー(RTK)が必要です。ライセンス(またはトライアル)の取得については、弊社営業チームにお問い合わせください。
以下は、JDBC 接続に必要な主なプロパティです。
| プロパティ | 値 |
|---|---|
| データベース接続 URL | jdbc:api:RTK=5246...;Profile=C:\profiles\Gumroad.apip;AuthScheme=OAuth;InitiateOAuth=GETANDREFRESH;OAuthClientId=your_client_id;OAuthClientSecret=your_client_secret;CallbackUrl=your_callback_url; |
| データベースドライバークラス名 | cdata.jdbc.api.APIDriver |
Airflow で JDBC 接続を設定
- Apache Airflow インスタンスにログインします。
- Airflow インスタンスのナビゲーションバーで、Admin にカーソルを合わせ、Connections をクリックします。
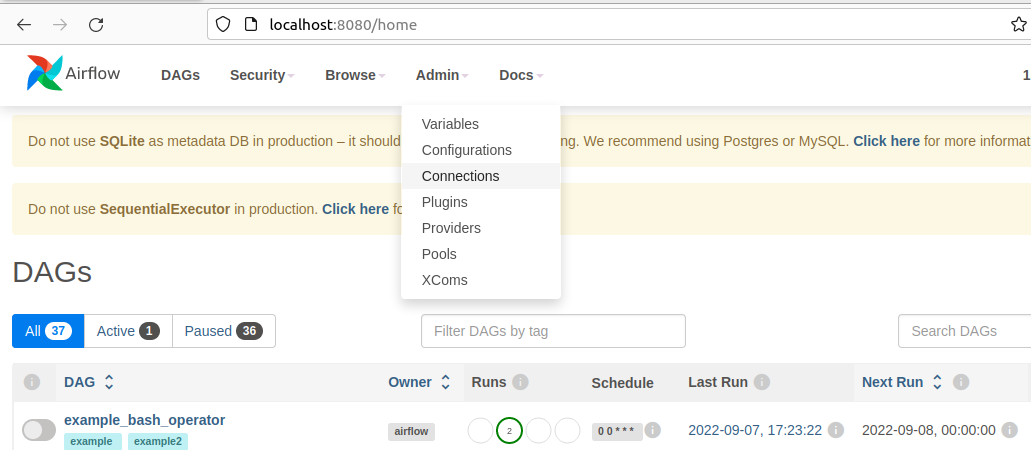
- 次の画面で + ボタンをクリックして、新しい接続を作成します。
- Add Connection フォームで、必要な接続プロパティを入力します:
- Connection Id:接続の名前を入力します(例:api_jdbc)
- Connection Type:JDBC Connection
- Connection URL:上記の JDBC 接続 URL(例:jdbc:api:RTK=5246...;Profile=C:\profiles\Gumroad.apip;AuthScheme=OAuth;InitiateOAuth=GETANDREFRESH;OAuthClientId=your_client_id;OAuthClientSecret=your_client_secret;CallbackUrl=your_callback_url;)
- Driver Class:cdata.jdbc.api.APIDriver
- Driver Path:PATH/TO/cdata.jdbc.api.jar
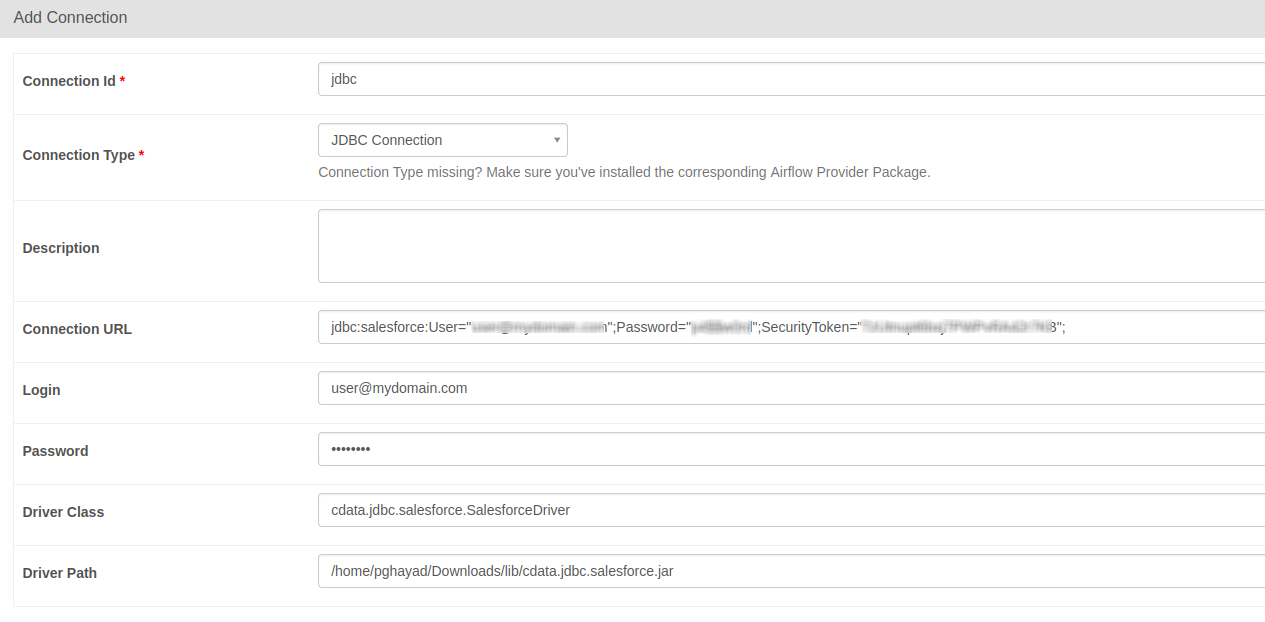
- フォーム下部の Test ボタンをクリックして、新しい接続をテストします。
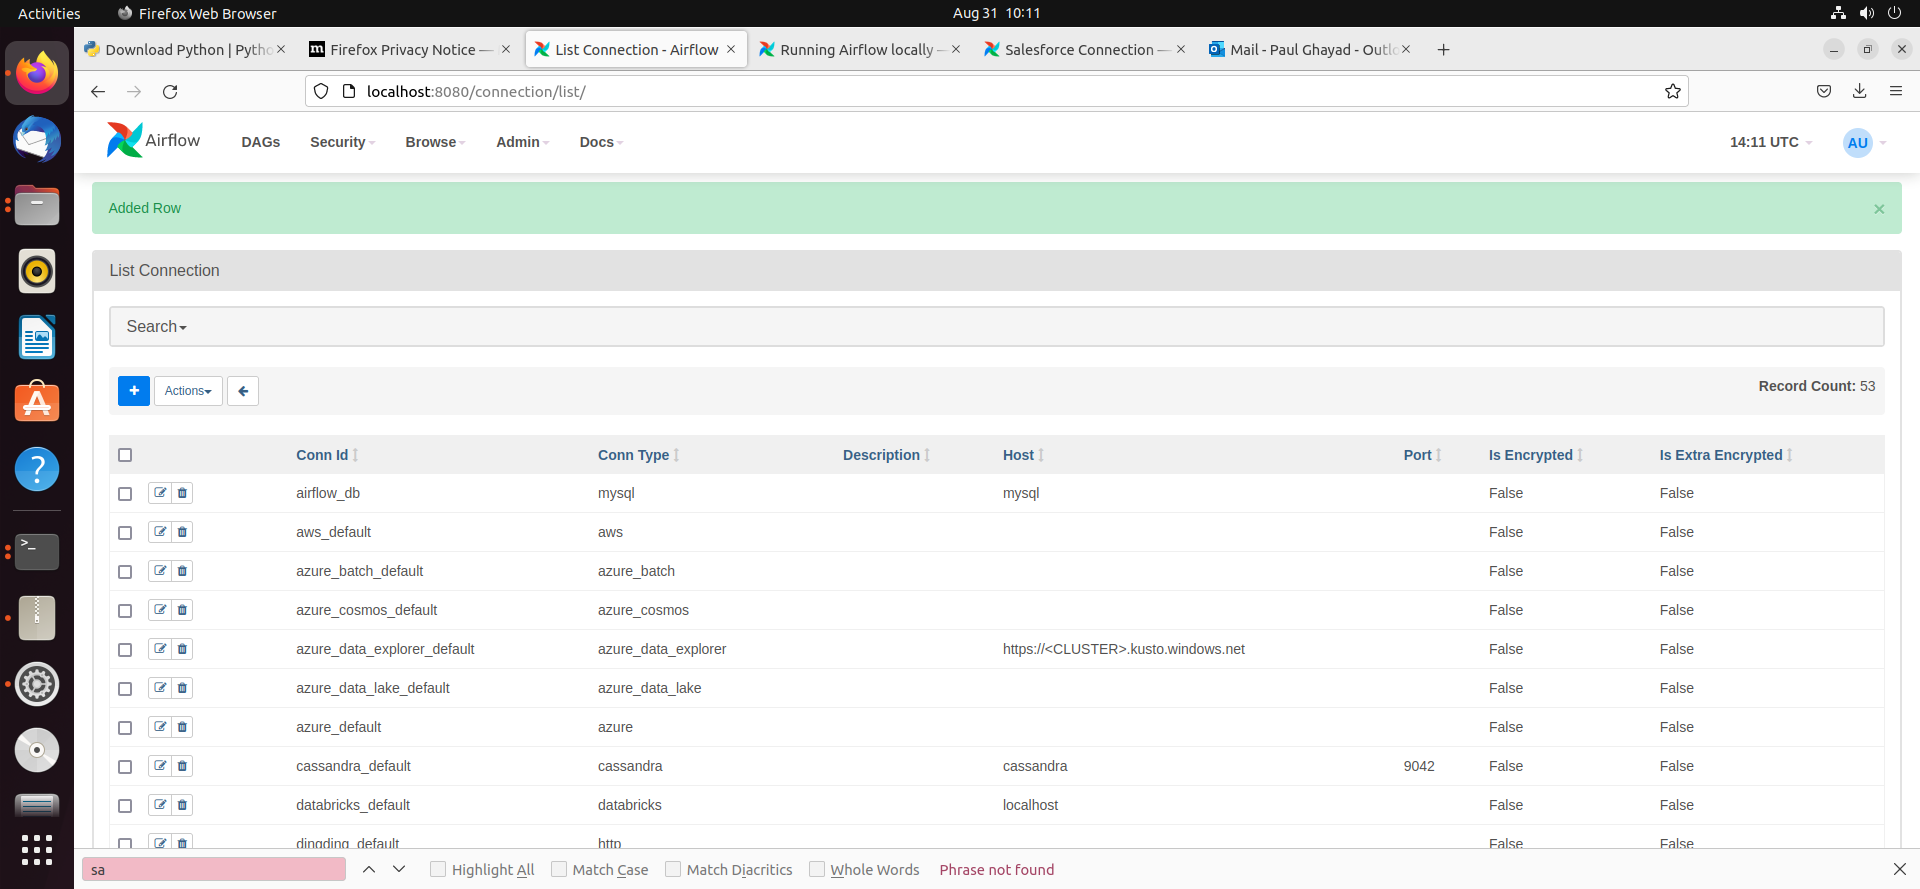
- 新しい接続を保存すると、次の画面で接続リストに新しい行が追加されたことを示す緑色のバナーが表示されます。
DAG の作成
Airflow の DAG は、ワークフローのプロセスを保存し、トリガーすることでワークフローを実行できるエンティティです。 ここでのワークフローは、Gumroad のデータ に対して SQL クエリを実行し、結果を CSV ファイルに保存するというシンプルなものです。
- まず、ホームディレクトリに「airflow」フォルダがあるはずです。その中に「dags」という新しいディレクトリを作成します。 ここに Python ファイルを保存すると、UI 上で Airflow DAG として表示されます。
- 次に、新しい Python ファイルを作成し、gumroad_hook.py という名前を付けます。このファイルに以下のコードを挿入してください:
import time from datetime import datetime from airflow.decorators import dag, task from airflow.providers.jdbc.hooks.jdbc import JdbcHook import pandas as pd # DAG を宣言 @dag(dag_id="gumroad_hook", schedule_interval="0 10 * * *", start_date=datetime(2022,2,15), catchup=False, tags=['load_csv']) # DAG 関数を定義 def extract_and_load(): # タスクを定義 @task() def jdbc_extract(): try: hook = JdbcHook(jdbc_conn_id="jdbc") sql = """ select * from Account """ df = hook.get_pandas_df(sql) df.to_csv("/{some_file_path}/{name_of_csv}.csv",header=False, index=False, quoting=1) # print(df.head()) print(df) tbl_dict = df.to_dict('dict') return tbl_dict except Exception as e: print("Data extract error: " + str(e)) jdbc_extract() sf_extract_and_load = extract_and_load() - このファイルを保存し、Airflow インスタンスを更新します。DAG のリストに「gumroad_hook」という新しい DAG が表示されるはずです。

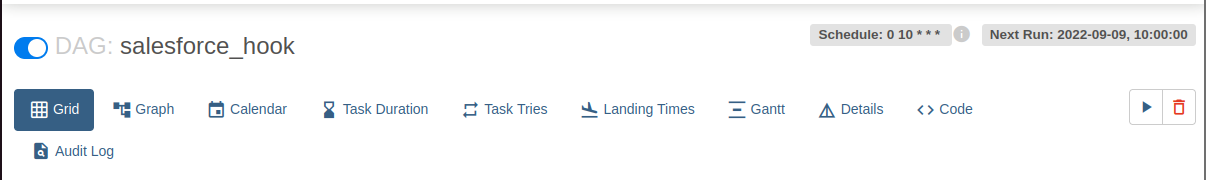
- この DAG をクリックし、次の画面で一時停止スイッチをクリックして青色にオンにします。次に、トリガー(再生)ボタンをクリックして DAG を実行します。これにより、gumroad_hook.py ファイル内の SQL クエリが実行され、コード内で指定したファイルパスに CSV として結果がエクスポートされます。
- 新しい DAG をトリガーした後、Downloads フォルダ(または Python スクリプト内で指定した場所)を確認すると、CSV ファイルが作成されていることがわかります。この例では account.csv です。
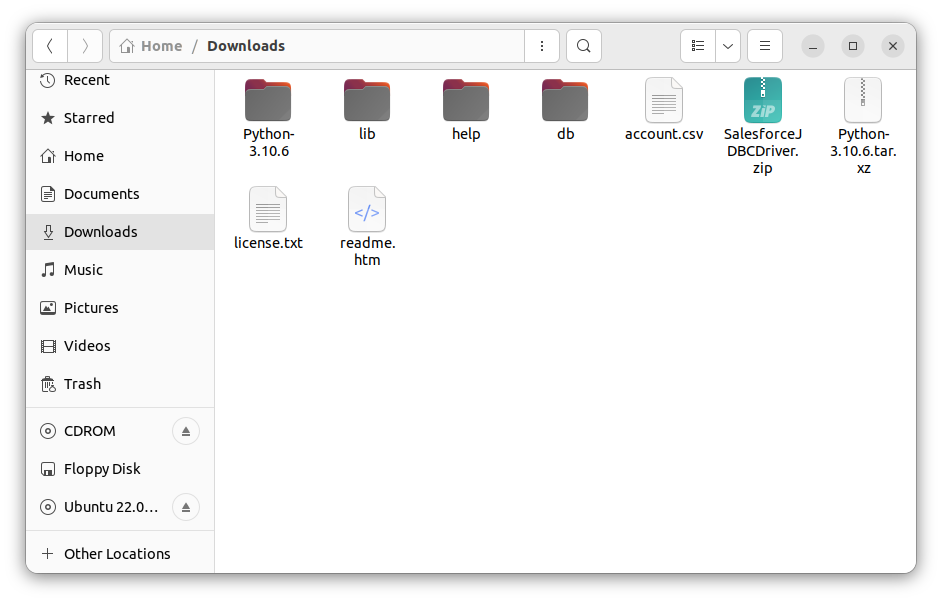
- CSV ファイルを開くと、Apache Airflow によって Gumroad のデータ が CSV 形式で利用可能になっていることを確認できます。