



Halo Service Desk のデータをApache Kafka トピックにストリーミング
Apache Kafka は、主にリアルタイムデータパイプラインやイベント駆動型アプリケーションの構築に使用されるオープンソースのストリーム処理プラットフォームです。CData API Driver for JDBCと組み合わせることで、Kafka はライブのHalo Service Desk のデータを扱うことができます。この記事では、Halo Service Desk データをApache Kafka トピックに接続、アクセス、ストリーミングする方法と、Confluent Control Center を起動してConfluent プラットフォームのKafka インフラストラクチャを使用して受信したHalo Service Desk のデータをユーザーが安全に管理および監視できるようにする方法について説明します。
CData JDBC Driver は最適化されたデータ処理機能を内蔵しており、ライブのHalo Service Desk のデータとのやり取りにおいて比類のないパフォーマンスを提供します。Halo Service Desk に複雑なSQL クエリを発行すると、ドライバーはフィルタや集計などのサポートされているSQL 操作を直接Halo Service Desk にプッシュし、サポートされていない操作(多くの場合SQL 関数やJOIN 操作)については組み込みのSQL エンジンを使用してクライアント側で処理します。組み込みの動的メタデータクエリにより、ネイティブのデータ型を使用してHalo Service Desk のデータを操作および分析できます。
前提条件
Apache Kafka トピックでHalo Service Desk のデータをストリーミングするためにCData JDBC Driver を接続する前に、クライアントのLinux ベースのシステムに以下をインストールおよび設定してください。
- Confluent Platform for Apache Kafka
- Confluent Hub CLI のインストール
- Confluent Platform 用のSelf-Managed Kafka JDBC Source Connector
Halo Service Desk のデータへの新しいJDBC 接続を定義
- Linux ベースのシステムにCData API Driver for JDBCをダウンロードします。
- 以下の手順に従って新しいディレクトリを作成し、すべてのドライバーの内容を展開します:
- Halo Service Desk という名前の新しいディレクトリを作成します。
mkdir API - ダウンロードしたドライバーファイル(.zip)をこの新しいディレクトリに移動します。
mv APIJDBCDriver.zip API/ - CData APIJDBCDriver の内容をこの新しいディレクトリに解凍します。
unzip APIJDBCDriver.zip
- Halo Service Desk という名前の新しいディレクトリを作成します。
- Halo Service Desk ディレクトリを開き、lib フォルダに移動します。
ls cd lib/ - CData API Driver for JDBC のlib フォルダの内容をKafka Connect JDBC のlib フォルダにコピーします。Kafka Connect JDBC フォルダの内容を確認し、cdata.jdbc.api.jar ファイルがlib フォルダに正常にコピーされたことを確認します。
cp -r /path/to/CData API Driver for JDBC/lib/* /usr/share/confluent-hub-components/confluentinc-kafka-connect-jdbc/lib/ cd /usr/share/confluent-hub-components/confluentinc-kafka-connect-jdbc/lib/ - 以下のコマンドを使用して、CData Halo Service Desk JDBC ドライバーのライセンスをインストールします。名前とメールアドレスを入力してください。
java -jar cdata.jdbc.api.jar -l - プロダクトキーまたは"TRIAL" を入力します(ライセンスの有効期限が切れた場合は、CData サポートチームまでお問い合わせください)。
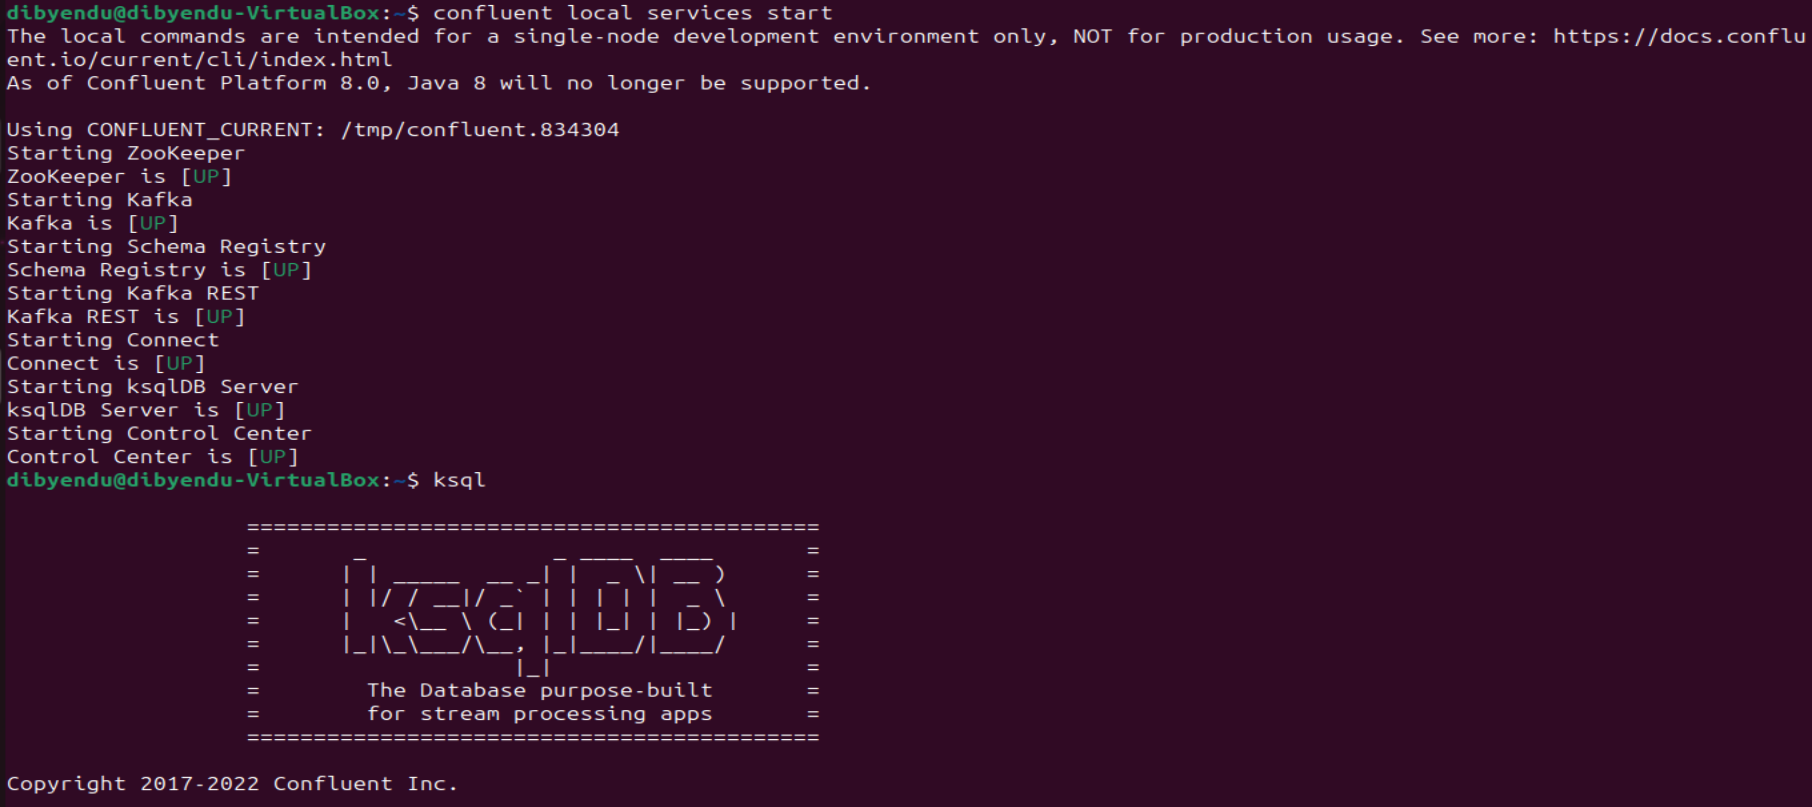
- 以下のコマンドを使用してConfluent ローカルサービスを起動します:
confluent local services startこれにより、Zookeeper、Kafka、Schema Registry、Kafka REST、Kafka CONNECT、ksqlDB、Control Center などのすべてのConfluent サービスが起動します。これで、CData JDBC Driver for Halo Service Desk を使用してKafka Connect Driver 経由でksqlDB のKafka トピックにメッセージをストリーミングする準備が整いました。
- POST HTTP API リクエストを使用してKafka トピックを手動で作成します:
 curl --location 'server_address:8083/connectors'
	--header 'Content-Type: application/json'
	--data '{
		"name": "jdbc_source_cdata_api_01",
		"config": {
			"connector.class": "io.confluent.connect.jdbc.JdbcSourceConnector",
			"connection.url": "jdbc:api:Profile=C:\profiles\HaloServiceDesk.apip;AuthScheme=APIKey;ProfileSettings='APIKey=your_api_key;Domain=yourcompany.haloservicedesk.com';",
		"topic.prefix": "api-01-",
		"mode": "bulk"
		}
	}'
HTTP POST 本文(上記)で使用されるフィールドについて説明します:
- connector.class: 使用するKafka Connect コネクタのJava クラスを指定します。
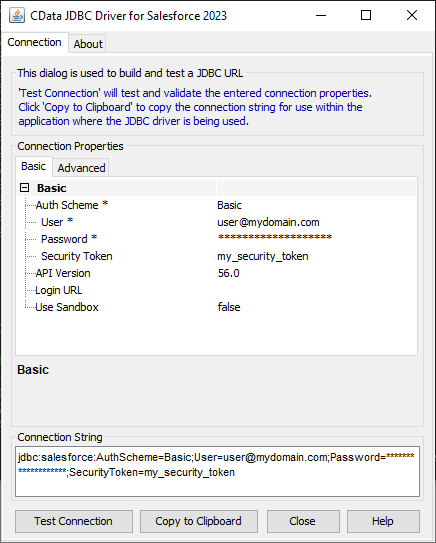
- connection.url: Halo Service Desk データに接続するためのJDBC 接続URL です。
組み込みの接続文字列デザイナー
JDBC URL の作成については、CData API Driver for JDBCに組み込まれた接続文字列デザイナーを使用してください。JAR ファイルをダブルクリックするか、コマンドラインからjar ファイルを実行します。
java -jar cdata.jdbc.api.jar接続プロパティを入力し、接続文字列をクリップボードにコピーします。
まず、Profile 接続プロパティをディスク上の HaloServiceDesk プロファイルの場所に設定します(例:C:\profiles\HaloServiceDesk.apip)。次に、ProfileSettings 接続プロパティを HaloServiceDesk の接続文字列に設定します(以下を参照)。
HaloServiceDesk API プロファイル設定
HaloServiceDesk では API キー認証を使用します。API キーは、HaloServiceDesk の「Administration」>「Integrations」>「Halo API」で確認・作成できます。
接続するには、以下の接続プロパティを設定します。
- AuthScheme:APIKey に設定します。
- APIKey:HaloServiceDesk アカウントの API キーに設定します。
- Domain:HaloServiceDesk インスタンスのホスト名に設定します(例:yourcompany.haloservicedesk.com)。
- topic.prefix: コネクタによって作成されるKafka トピックに追加されるプレフィックスです。「api-01-」に設定されています。
- mode: コネクタの動作モードを指定します。ここでは「bulk」に設定されており、コネクタがバルクデータ転送を実行するように設定されていることを示しています。
このリクエストにより、Halo Service Desk のすべてのテーブル/コンテンツがKafka トピックとして追加されます。
注意: リクエストをPOST するIP アドレス(サーバー)は、Linux ネットワークのIP アドレスです。
- ksqlDB を実行し、トピックを一覧表示します。以下のコマンドを使用します:
ksql
list topics;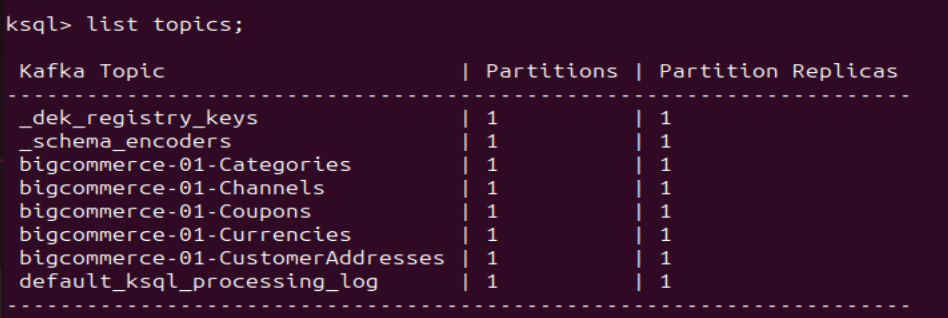
- トピック内のデータを表示するには、以下のSQL ステートメントを入力します:
PRINT topic FROM BEGINNING;
Confluent Control Center への接続
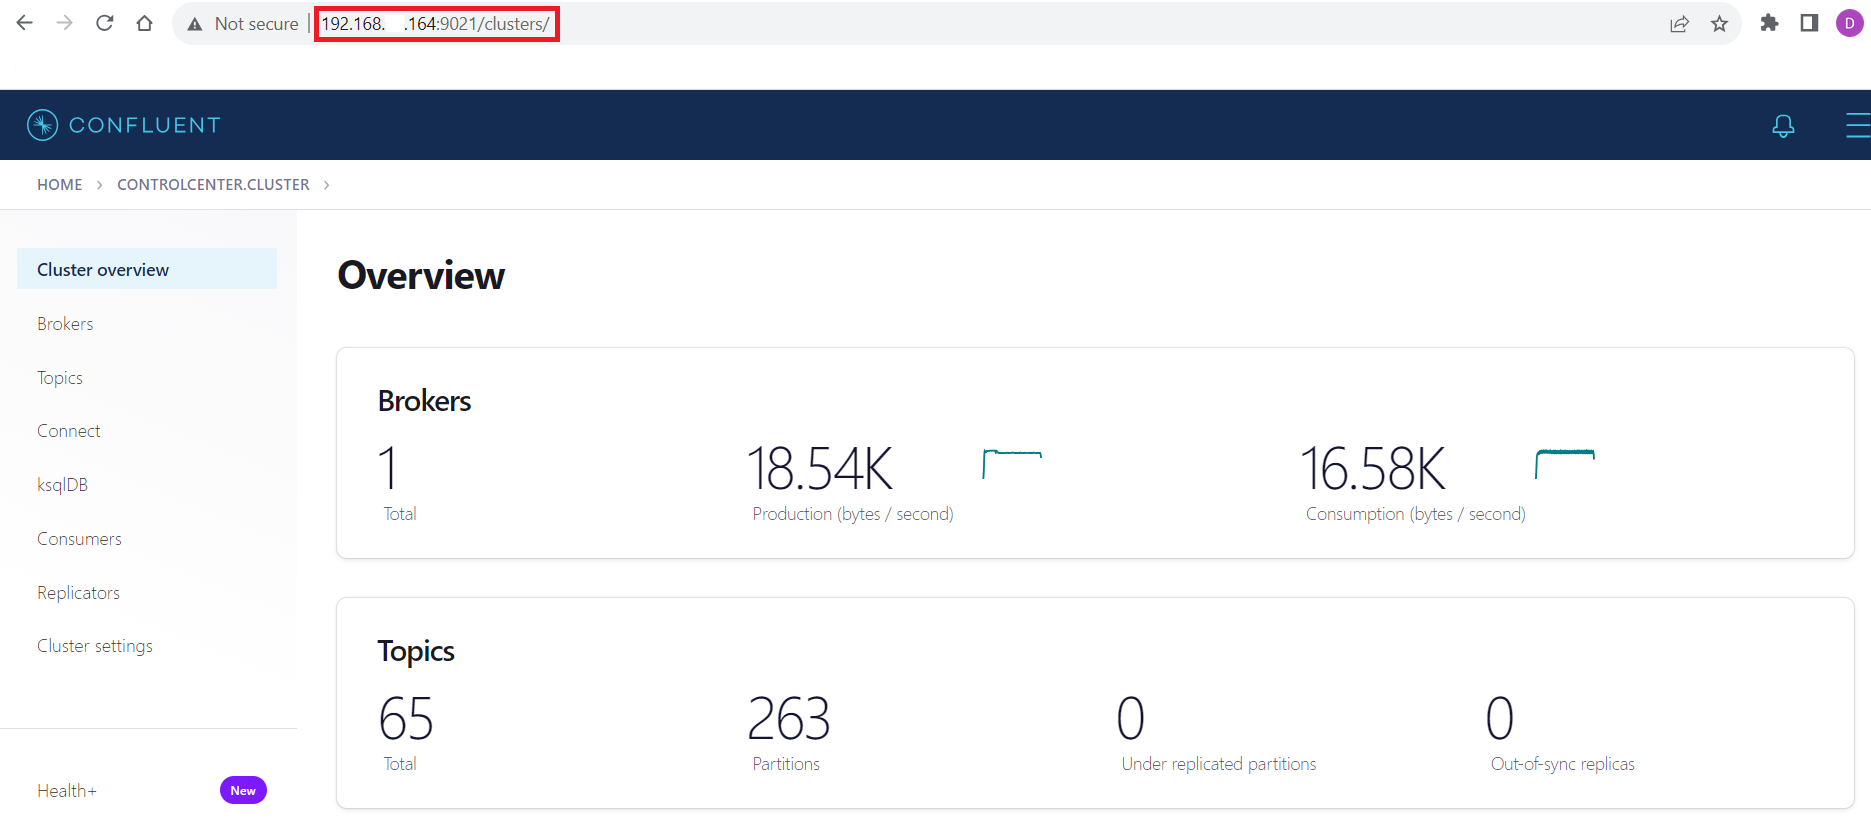
Confluent Control Center のユーザーインターフェースにアクセスするには、上記のセクションで説明した"confluent local services" を実行し、ローカルブラウザでhttp://<server address>:9021/clusters/ と入力してください。
おわりに
CData API Driver for JDBCの30日間無償トライアルをダウンロードして、Halo Service Desk データをApache Kafka にストリーミングしましょう。ご不明な点があれば、サポートチームまでお問い合わせください。