



LeadDesk のデータを IBM SPSS Modeler にシームレスにインポート
IBM SPSS Modeler は、組織がデータから価値あるインサイトを抽出できる強力なデータマイニング・予測分析プラットフォームです。CData API Driver for ODBC を介してLeadDesk のデータを SPSS Modeler に接続することで、高度なデータマイニング、予測モデリング、統計分析のためのリアルタイムアクセスを活用できます。
このガイドでは、IBM SPSS Modeler をLeadDesk のデータに接続し、シームレスなデータのインポート、準備、分析を行う手順を説明します。CData API Driver for ODBC を使用して、IBM SPSS Modeler でLeadDesk のデータの可能性を最大限に引き出し、実用的なインサイトを得ましょう。
概要
手順の概要は以下のとおりです:
- ODBC ドライバーの設定:CData API Driver for ODBC で必要な接続プロパティを入力し、LeadDesk のデータ への接続を設定します。
- SPSS Modeler での ODBC 接続のセットアップ:IBM SPSS Modeler で、設定済みの DSN を選択して ODBC 接続を確立します。
- データのインポートと処理:LeadDesk のデータ を SPSS Modeler にインポートし、データの確認、フィルタリング、変換、準備を行って、予測分析や統計モデリングに活用します。
CData ODBC Driver を使用した LeadDesk DSN の設定
まず、CData ODBC Driver を使用してシステムにLeadDesk のデータ用の DSN(データソース名)を設定します。こちらから全機能を備えた 30 日間の無料トライアルをダウンロードしてインストールしてください。
インストールが完了したら、ODBC データソースアドミニストレーターを起動します:
- Windows の場合:スタートメニューで ODBC データソースアドミニストレーター を検索してアプリケーションを開きます。
- Mac の場合:アプリケーションからユーティリティを開き、ODBC Manager を選択します。
- Linux の場合:コマンドラインから ODBC Data Source Administrator を起動するか、インストールされている場合は unixODBC を使用します。
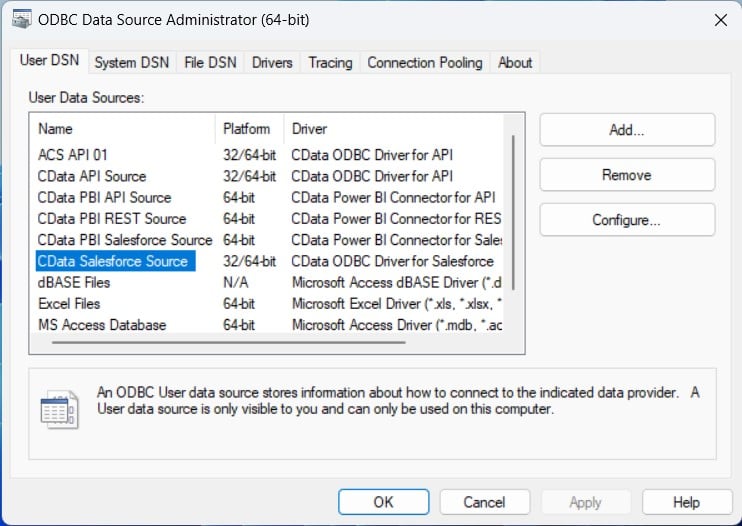
起動したら、CDataLeadDesk のデータSource をダブルクリックし、接続に必要な値を入力します:
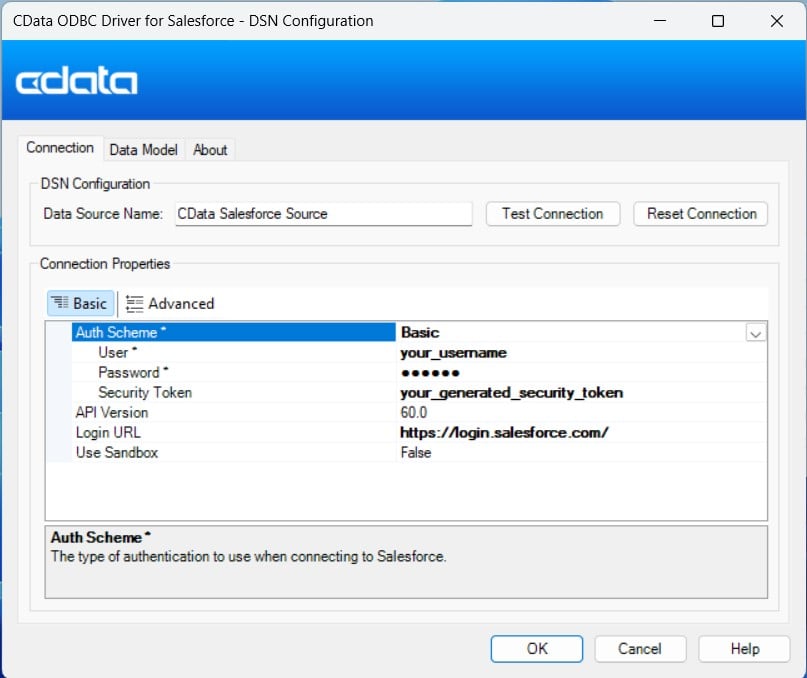
まず、Profile 接続プロパティをディスク上の LeadDesk プロファイルの場所に設定します(例:C:\profiles\LeadDesk.apip)。次に、ProfileSettings 接続プロパティを LeadDesk の接続文字列に設定します(以下を参照)。
LeadDesk API プロファイル設定
LeadDesk で「General Settings > API > Create」に移動して OAuth アプリケーションを登録し、Client ID と Client Secret を取得します。
IBM SPSS Modeler での ODBC 接続のセットアップ
DSN の設定が完了したら、IBM SPSS Modeler で接続を行います:
- IBM SPSS Modeler を起動し、ログインして新しいストリームを作成します。
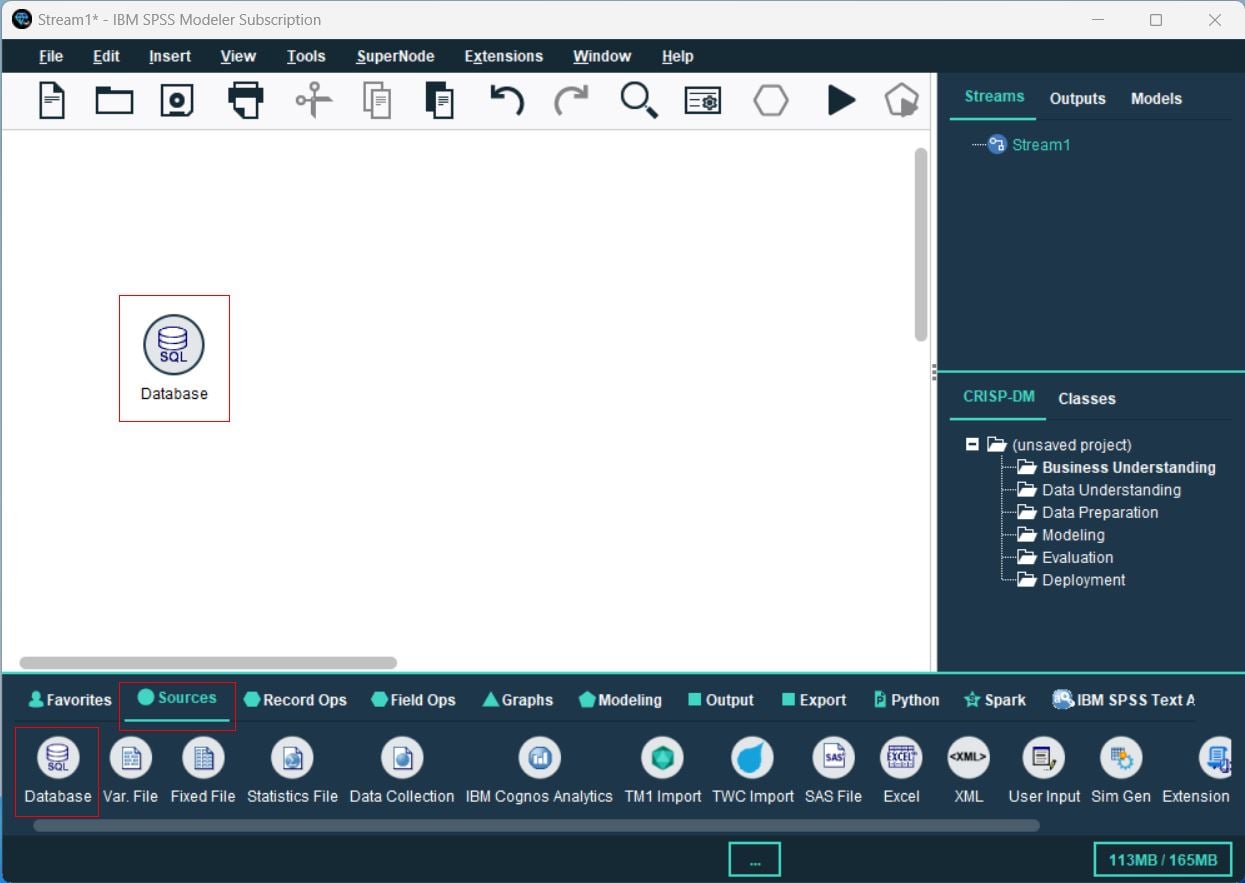
- Sources パレットから Database ノードを見つけ、キャンバスにドラッグします。
- Database ノードをダブルクリックして設定ダイアログを開きます。
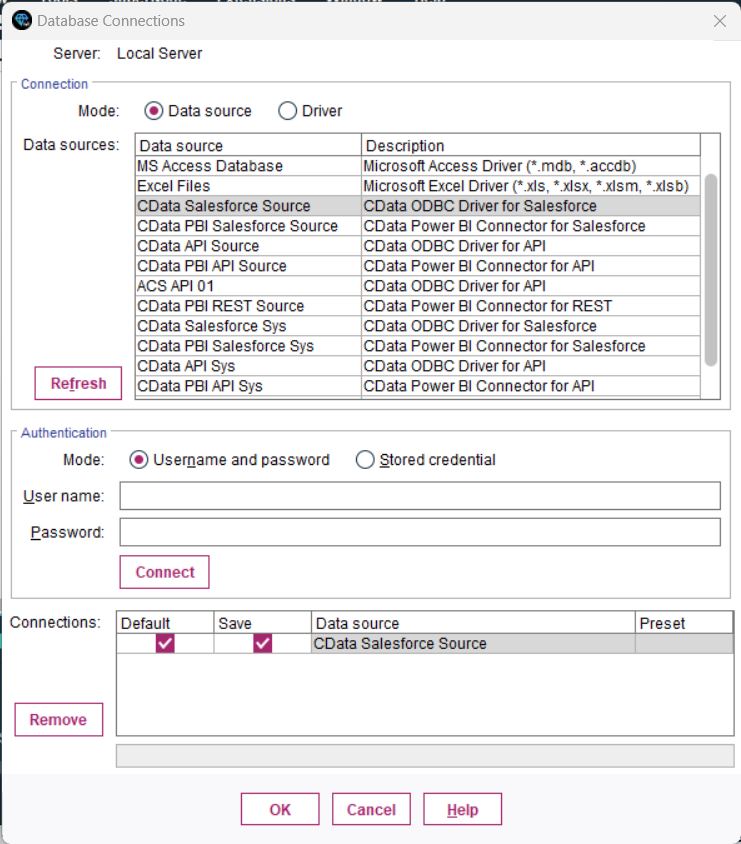
を選択し、設定済みの DSN を参照して選択し、OK をクリックします。 - Database ダイアログで、インポートしたいテーブルを参照して選択し、データをプレビューして、OK をクリックして確定します。
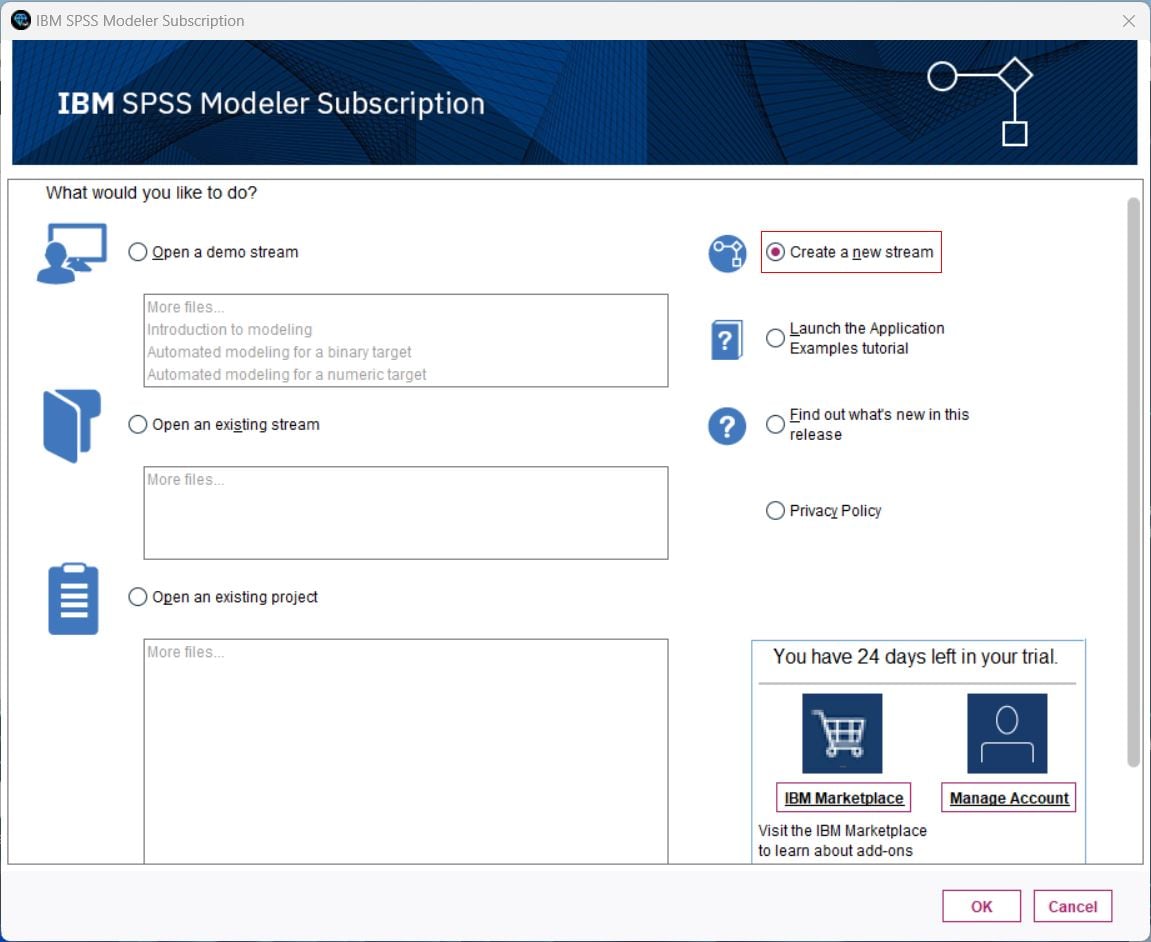
これで IBM SPSS Modeler でLeadDesk のデータを処理・分析する準備が整いました。
データ処理:フィルタ、カテゴリ、モデル
テーブルをインポートしたら、SPSS Modeler でLeadDesk のデータの絞り込み、フィルタリング、カテゴリ分け、モデリングを行えます:
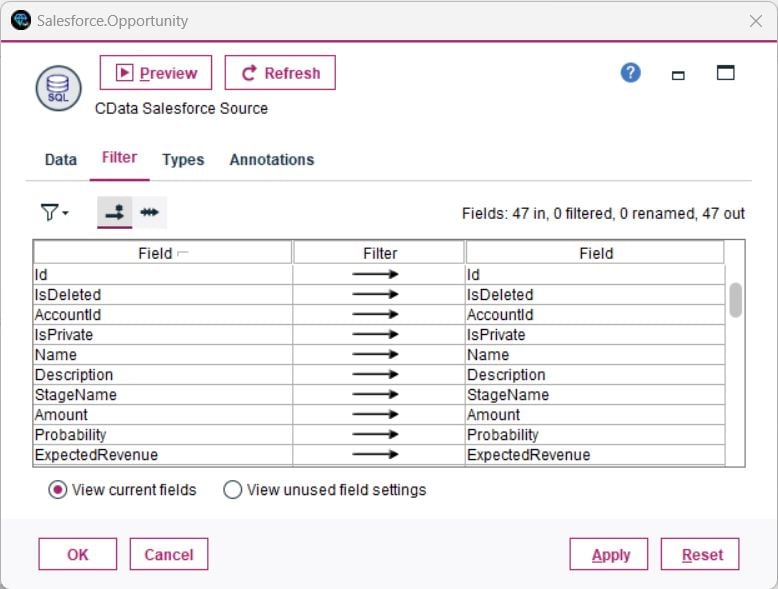
- フィルタリング:Database 接続をダブルクリックし、Filter セクションでフィールドを選択/解除して、関連するデータに絞り込みます。これにより処理速度とモデル精度が向上します。
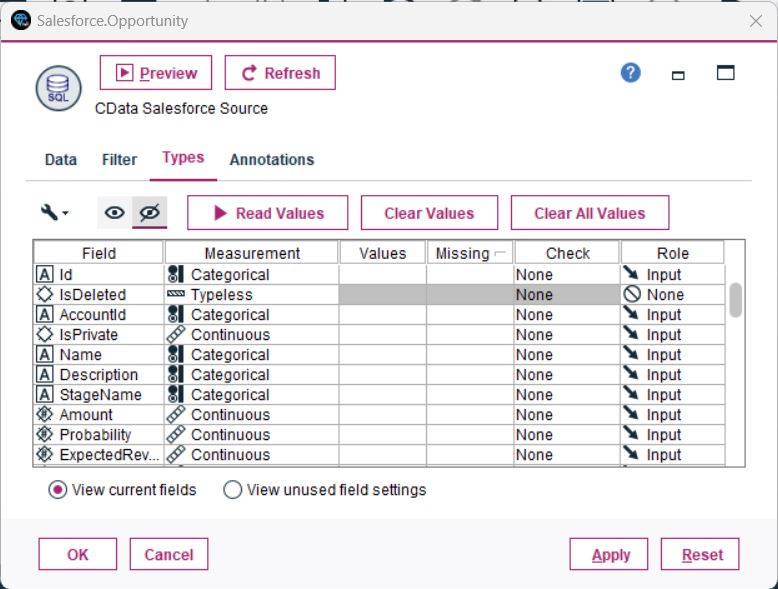
- データ型とロールの設定:Types セクションでフィールドをカテゴリ分けし、各データ型にロールを割り当てます。
- 基本的な分析の実行:Analysis ノードを Database ノードの隣にドラッグアンドドロップして接続し、Play ボタンをクリックしてストリームを実行しデータを分析します。
これで簡単な分析が完了し、SPSS Modeler がデータベースからのインサイトを処理・表示できるようになりました。
CData で LeadDesk データの可能性を引き出す
CData API Driver for ODBC を使用すれば、LeadDesk のデータ を IBM SPSS Modeler にシームレスに接続できます。今すぐ無料トライアルを開始して、リアルタイムデータの可能性を最大限に活用し、高度な分析と意思決定に役立てましょう。