



Apache Spark でPabblySubscriptions のデータをSQL で操作する方法

Apache Spark は大規模データ処理のための高速エンジンです。CData JDBC Driver for API と組み合わせると、Spark はリアルタイムでPabblySubscriptions のデータに連携して処理ができます。本記事では、Spark シェルに接続してPabblySubscriptions をクエリする方法について解説します。
CData JDBC Driver は、最適化されたデータ処理がドライバーに組み込まれているため、リアルタイムPabblySubscriptions と対話するための高いパフォーマンスを提供します。PabblySubscriptions に複雑なSQL クエリを発行すると、ドライバーはフィルタや集計など、サポートされているSQL操作を直接PabblySubscriptions にプッシュし、組込みSQL エンジンを使用してサポートされていない操作(SQL 関数やJOIN 操作)をクライアント側で処理します。組み込みの動的メタデータクエリを使用すると、ネイティブデータ型を使用してPabblySubscriptions を操作して分析できます。
CData JDBC Driver for API をインストール
まずは、本記事右側のサイドバーからAPI JDBC Driver の無償トライアルをダウンロード・インストールしてください。30日間無償で、製品版の全機能が使用できます。
Spark Shell を起動してPabblySubscriptions のデータに接続
- ターミナルを開き、Spark shell でCData JDBC Driver for API JAR file をjars パラメータに設定します:
$ spark-shell --jars /CData/CData JDBC Driver for API/lib/cdata.jdbc.api.jar - Shell でJDBC URL を使ってPabblySubscriptions に接続し、SQL Context load() function でテーブルを読み込みます。
まず、Profile 接続プロパティをディスク上の PabblySubscriptions プロファイルの場所に設定します(例:C:\profiles\PabblySubscriptions.apip)。次に、ProfileSettings 接続プロパティを PabblySubscriptions の接続文字列に設定します(以下を参照)。
PabblySubscriptions API プロファイル設定
Pabbly Subscriptions アカウントの Settings > API Settings > Regenerate API に移動し、API キーとシークレットキーを取得します。
組み込みの接続文字列デザイナー
JDBC 接続文字列URL の作成には、PabblySubscriptions JDBC Driver にビルトインされたデザイナを使用できます。JAR ファイルをダブルクリックするか、コマンドラインでJAR ファイルを実行するとデザイナが開きます。
java -jar cdata.jdbc.api.jar接続プロパティを入力し、接続文字列をクリップボードにコピーします。
scala> val api_df = spark.sqlContext.read.format("jdbc").option("url", "jdbc:api:Profile=C:\profiles\PabblySubscriptions.apip;ProfileSettings='User=your_api_key;Password=your_secret_key';").option("dbtable","CustomerInvoices").option("driver","cdata.jdbc.api.APIDriver").load() - 接続が完了し、データがロードされたら、テーブルスキーマが表示されます。
PabblySubscriptions をテンポラリーテーブルとして登録します:
scala> api_df.registerTable("customerinvoices")-
データに対して、次のようなカスタムSQL クエリを実行します。
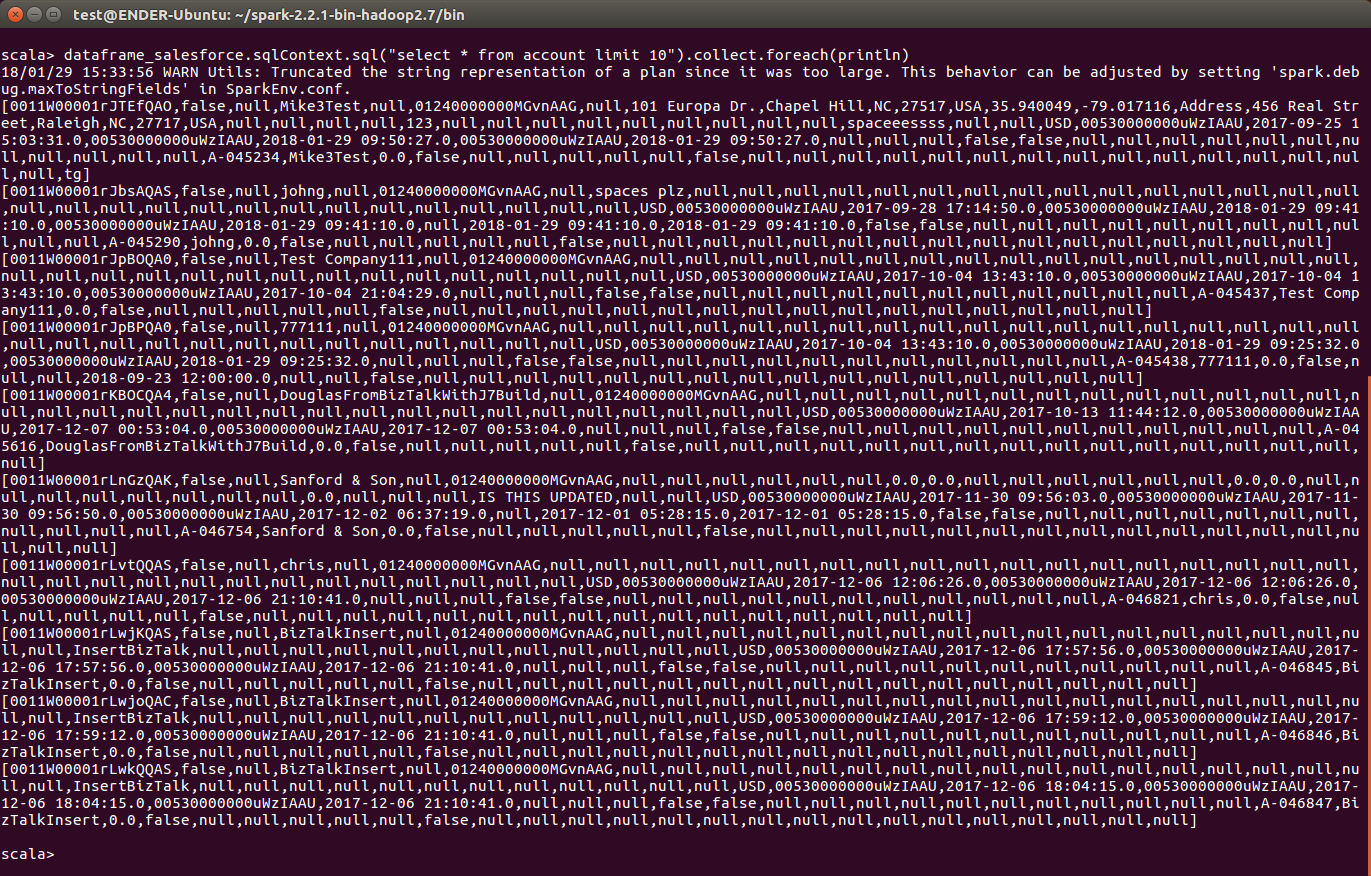
scala> api_df.sqlContext.sql("SELECT CustomerId, Id FROM CustomerInvoices WHERE Status = paid").collect.foreach(println)コンソールで、次のようなPabblySubscriptions のデータを取得できました!これでPabblySubscriptions との連携は完了です。
CData JDBC Driver for API をApache Spark で使って、PabblySubscriptions に対して、複雑かつハイパフォーマンスなクエリを実行できます。30日の無償評価版 をダウンロードしてぜひお試しください。