



HULFT Integrate で PagerDuty のデータ に接続
HULFT Integrate は、ドラッグ&ドロップのユーザーインターフェースでコーポレーションフロー、データ変換、処理を簡単に作成できる最新のデータ連携プラットフォームです。CData API Driver for JDBC と組み合わせることで、HULFT Integrate からリアルタイムの PagerDuty のデータ を扱うことができます。この記事では、PagerDuty への接続方法と、データを CSV ファイルに出力する手順をご紹介します。
CData JDBC ドライバーは、最適化されたデータ処理機能を備えており、リアルタイムの PagerDuty のデータ との連携において比類のないパフォーマンスを発揮します。PagerDuty に対して複雑な SQL クエリを発行すると、ドライバーはフィルタや集計などのサポートされている SQL 操作を直接 PagerDuty にプッシュし、サポートされていない操作(主に SQL 関数や JOIN 操作)は内蔵の SQL エンジンでクライアント側で処理します。また、動的なメタデータクエリ機能により、ネイティブなデータ型を使用して PagerDuty のデータ を操作・分析できます。
PagerDuty へのアクセスを有効化
HULFT Integrate プロジェクトから PagerDuty のデータ へのアクセスを有効にするには、以下の手順で設定します:
- CData JDBC Driver の JAR ファイル(およびライセンスファイルがある場合はそれも)、cdata.jdbc.api.jar(および cdata.jdbc.api.lic)を、Integrate Server の jdbc_adapter サブフォルダにコピーします
- HULFT Integrate Server を再起動し、HULFT Integrate Studio を起動します
PagerDuty のデータ にアクセスするプロジェクトの作成
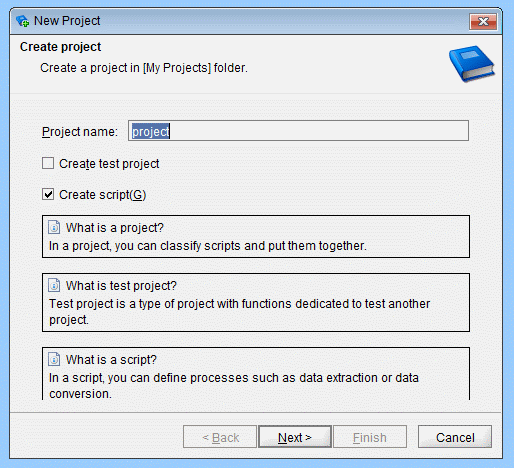
JAR ファイルをコピーしたら、PagerDuty のデータ にアクセスするプロジェクトを作成できます。まず、Integrate Studio を開いて新しいプロジェクトを作成しましょう。
- プロジェクト名を入力します
- 「スクリプトを作成」チェックボックスがオンになっていることを確認します
- 「次へ」をクリックします
- スクリプト名を入力します(例:APItoCSV)
プロジェクトを作成したら、PagerDuty のデータ を CSV ファイルにコピーするためのコンポーネントをスクリプトに追加します。
Execute Select SQL コンポーネントの設定
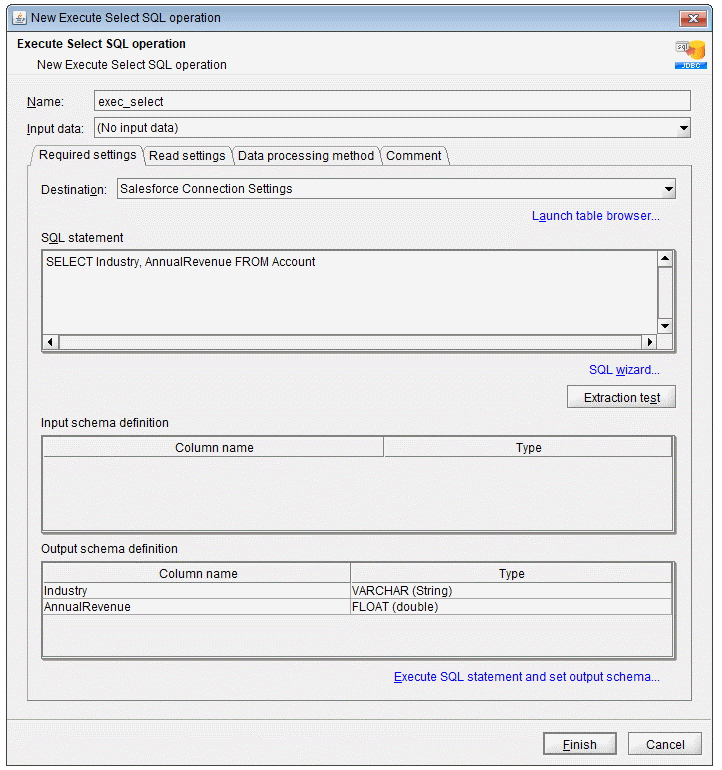
ツールパレット(Database -> JDBC)から「Execute Select SQL」コンポーネントをスクリプトワークスペースにドラッグします。
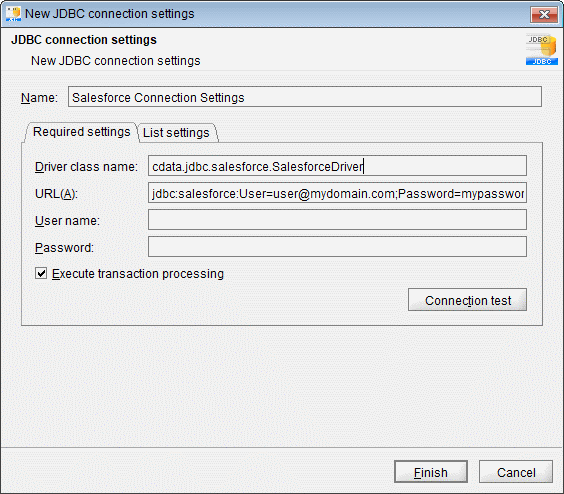
- 「必須設定」タブの接続先で、「追加」をクリックして PagerDuty 用の新しい接続を作成します。以下のプロパティを設定します:
- 名前:PagerDuty Connection Settings
- ドライバークラス名:cdata.jdbc.api.APIDriver
- URL:jdbc:api:Profile=C:\profiles\PagerDuty.apip;Authscheme=OAuth;OAuthClientId=your_client_id;OAuthClientSecret=your_client_secret;CallbackUrl=your_callback_url;
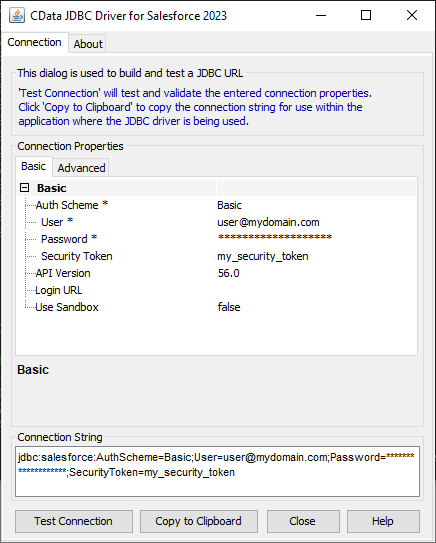
組み込みの接続文字列デザイナー
JDBC URL の構築には、PagerDuty JDBC Driver に組み込まれている接続文字列デザイナーをご利用ください。JAR ファイルをダブルクリックするか、コマンドラインから JAR ファイルを実行します。
java -jar cdata.jdbc.api.jar接続プロパティを入力し、接続文字列をクリップボードにコピーします。
まず、Profile 接続プロパティをディスク上の PagerDuty プロファイルの場所に設定します(例:C:\profiles\PagerDuty.apip)。次に、ProfileSettings 接続プロパティを PagerDuty の接続文字列に設定します(以下を参照)。
PagerDuty API プロファイル設定
PagerDuty の Developer Mode を介して OAuth アプリケーションを登録し、Client ID と Client Secret を取得します。コールバック URL は、アプリ設定で構成したリダイレクト URI と一致している必要があります。
- SQL ステートメントを記述します。例:
SELECT Id, Type FROM Addons
- 「抽出テスト」をクリックして、接続とクエリが正しく設定されていることを確認します
- 「SQL を実行して出力スキーマを設定」をクリックします
- 「完了」をクリックします
Write CSV File コンポーネントの設定
ツールパレット(File -> CSV)から「Write CSV File」コンポーネントをワークスペースにドラッグします。
- クエリ結果を書き込むファイルを設定します(例:Addons.csv)
- 「入力データ」を「Select SQL」コンポーネントに設定します
- SQL クエリで選択した各フィールドのカラムを追加します
- 「書き込み設定」タブで、「最初の行にカラム名を挿入する」チェックボックスをオンにします
- 「完了」をクリックします
PagerDuty フィールドを CSV カラムにマッピング
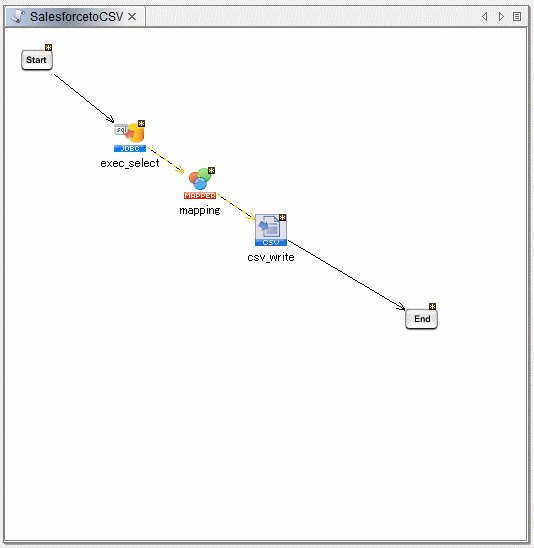
「Select」コンポーネントの各カラムを、「CSV」コンポーネントの対応するカラムにマッピングします。
スクリプトの完成
「Start」コンポーネントを「Select」コンポーネントに、「CSV」コンポーネントを「End」コンポーネントにドラッグして接続します。スクリプトをビルドして実行すると、PagerDuty のデータ が CSV ファイルに出力されます。
CData API Driver for JDBCの30日間の無償トライアルをダウンロードして、HULFT Integrate でリアルタイムの PagerDuty のデータ を活用してみてください。ご不明な点があれば、サポートチームまでお気軽にお問い合わせください。