



【ノーコード】複数のPerplexity アカウントのデータを簡単レプリケーション

CData Sync は、いろいろなシナリオのデータレプリケーション(同期)を行うことができるスタンドアロンのアプリケーションです。例えば、sandbox および本番インスタンスのデータをデータベースに同期することができます。CData Sync のウェブインターフェースは複数のPerplexity コネクションを簡単に管理できます。本記事では、複数のPerplexity アカウントを一つのデータベースに同期する方法を説明します。
レプリケーションの同期先を設定
CData Sync では、Perplexity のデータ を何台のデータベースにでも複製できます。データベースはクラウドおよびオンプレミスの双方に対応しています。レプリケーションの同期先の設定には、[接続]タブから行います。
- [同期先]タブを選択します。
- 同期先のアイコンをクリックします。本記事では、SQLite を使います。
- 必要な接続プロパティを入力します。Perplexity をSQLite に複製するには、データソースボックスにファイルパスを指定します。
- [接続のテスト]をクリックして、正しく接続できているかをテストします。
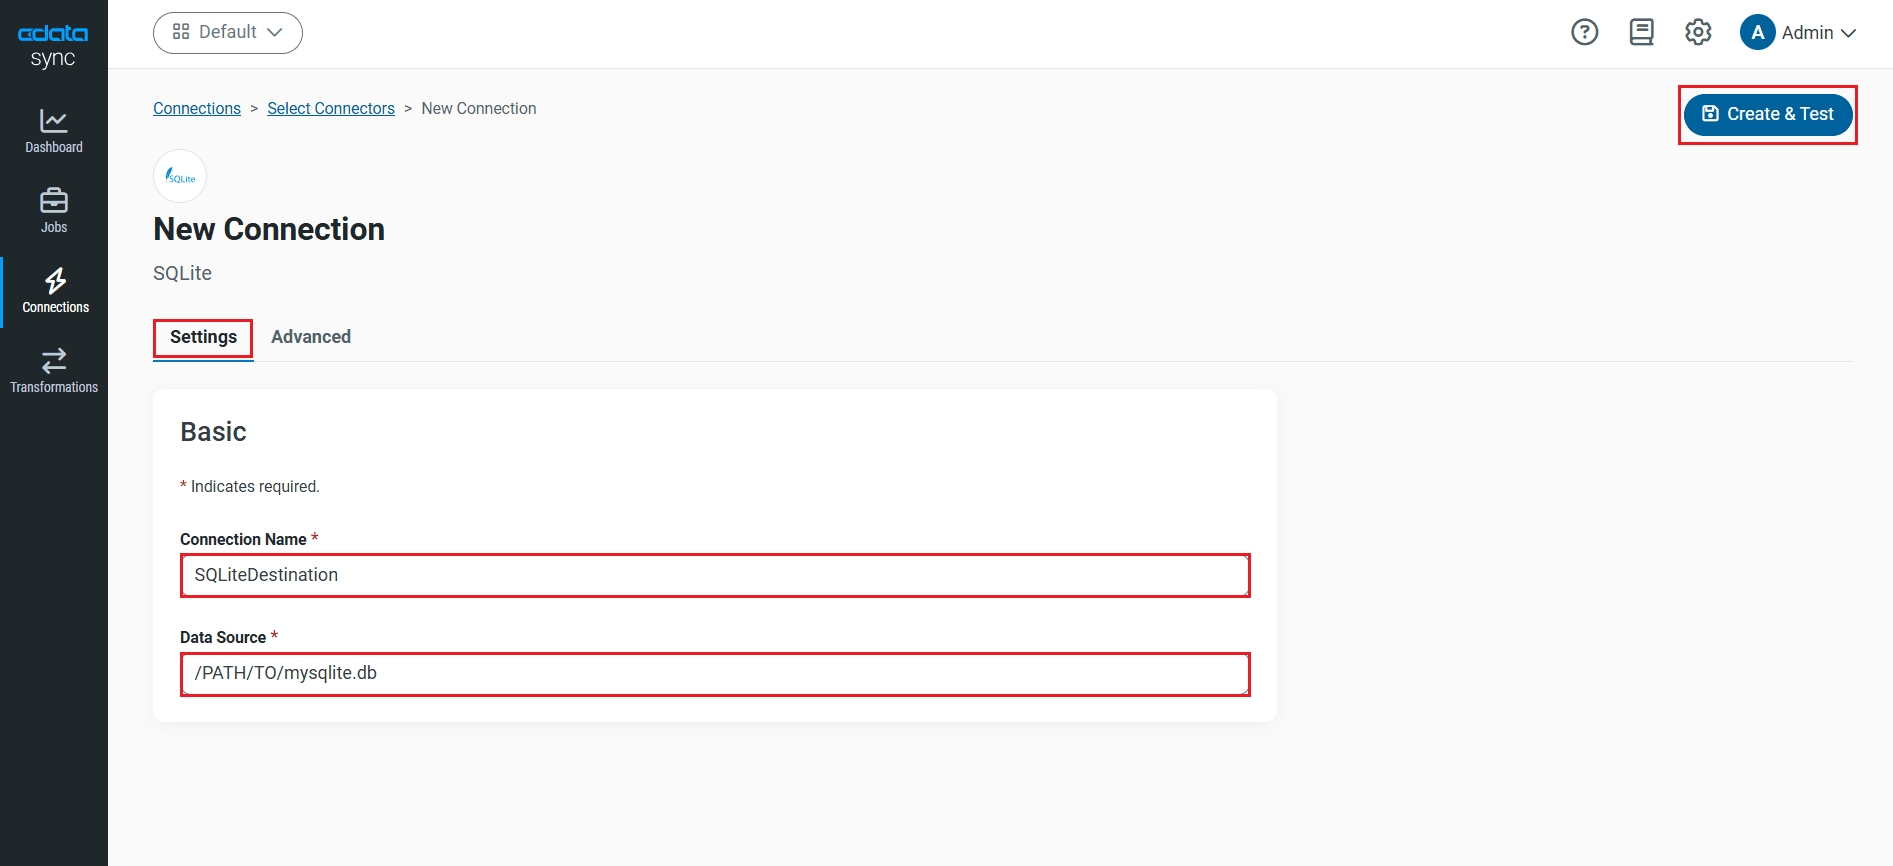
- [変更を保存]をクリックします。
Perplexity 接続の設定
データソース側にPerplexity を設定します。[接続]タブをクリックします。
- [接続の追加]セクションで[データソース]タブを選択します。
- Perplexity アイコンをデータソースとして選択します。プリインストールされたソースにPerplexity がない場合には、追加データソースとしてダウンロードします。
- 接続プロパティに入力をします。
Perplexity API ダッシュボード(https://www.perplexity.ai/settings/api)にアクセスし、API キーを生成します。
- [接続のテスト]をクリックして、正しく接続できているかをテストします。
- [変更を保存]をクリックします。
それぞれのPerplexity インスタンスのレプリケーションクエリの設定
Data Sync はレプリケーションをコントロールするSQL クエリを簡単なGUI 操作で設定できます。
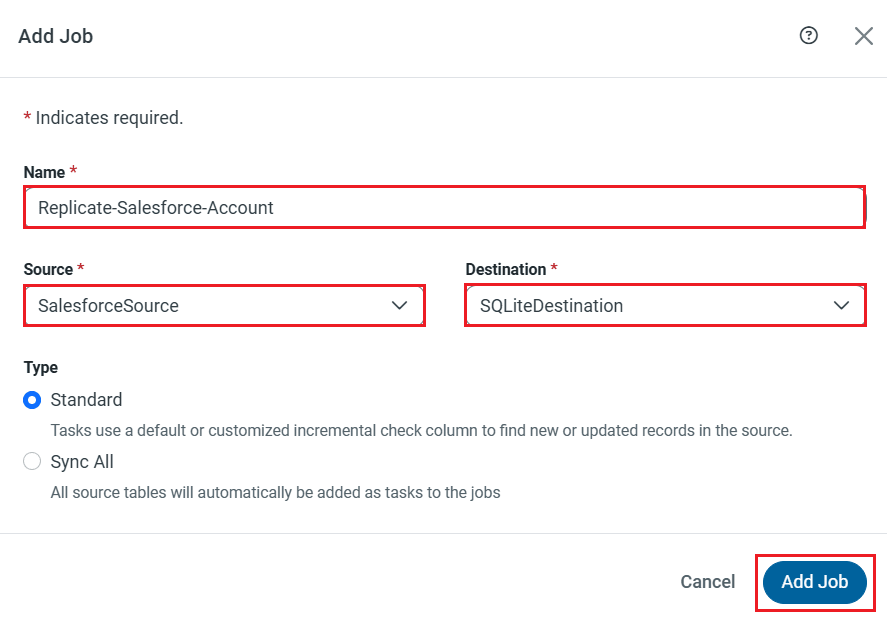
レプリケーションジョブ設定には、[ジョブ]タブに進み、[ジョブを追加]ボタンをクリックします。
次にデータソースおよび同期先をそれぞれドロップダウンから選択します。
テーブル全体をレプリケーションする
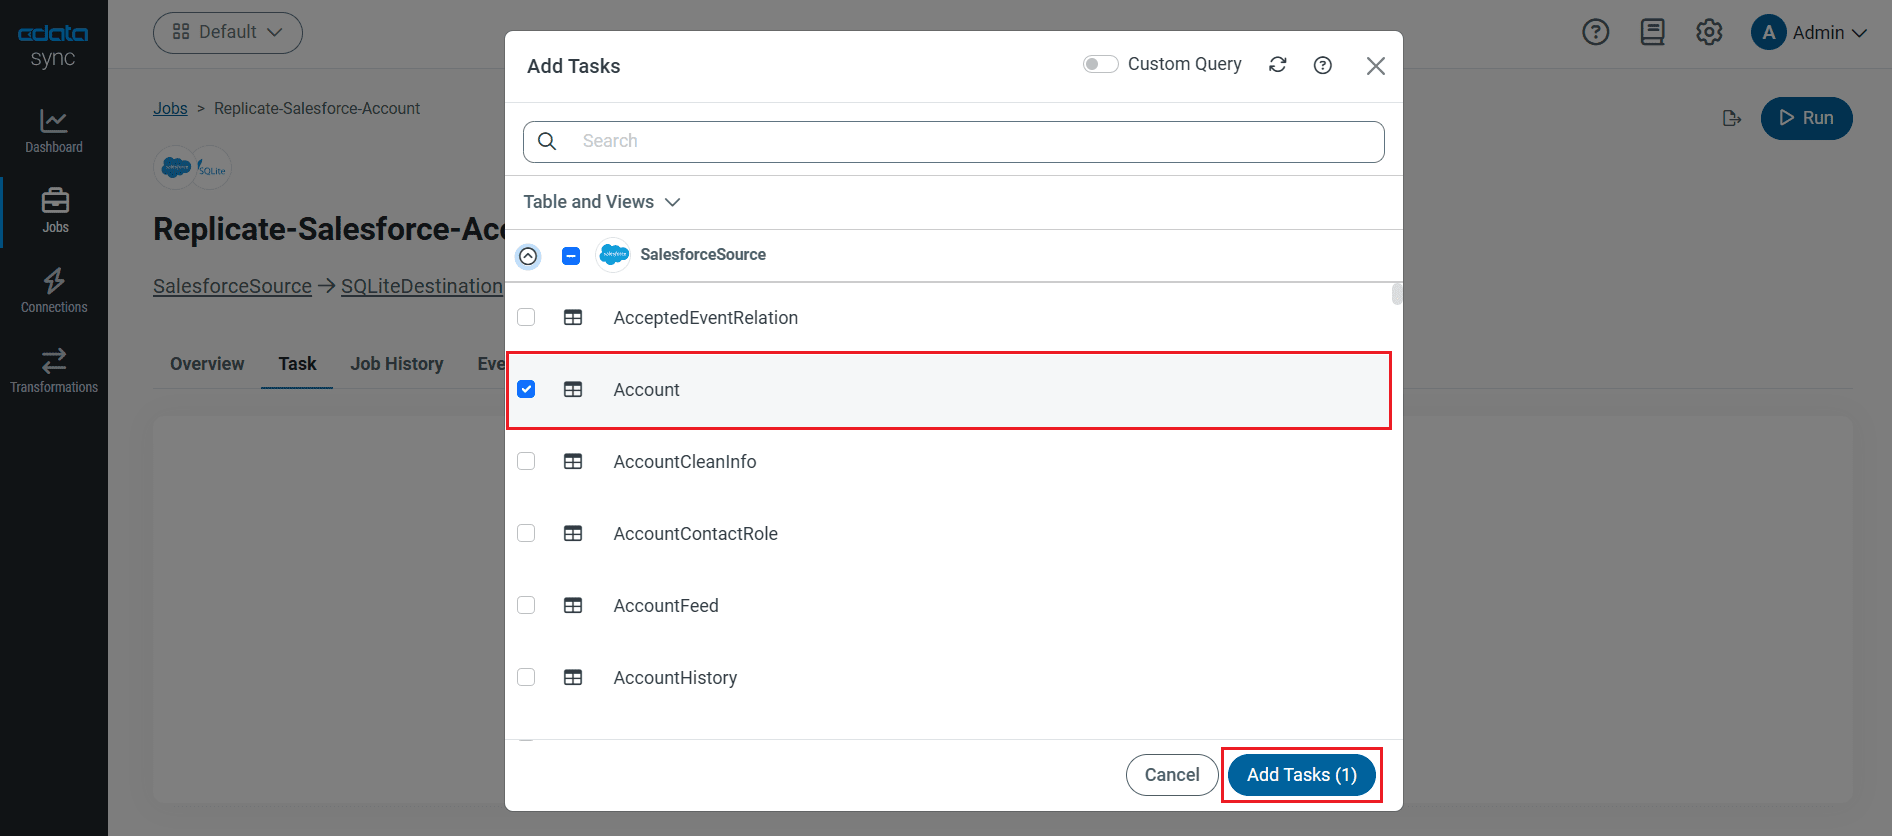
テーブル全体をレプリケーションするには、[テーブル]セクションで[テーブルを追加]をクリックします。表示されたテーブルリストからレプリケーションするテーブルをチェックします。.
テーブルをカスタマイズしてレプリケーションする
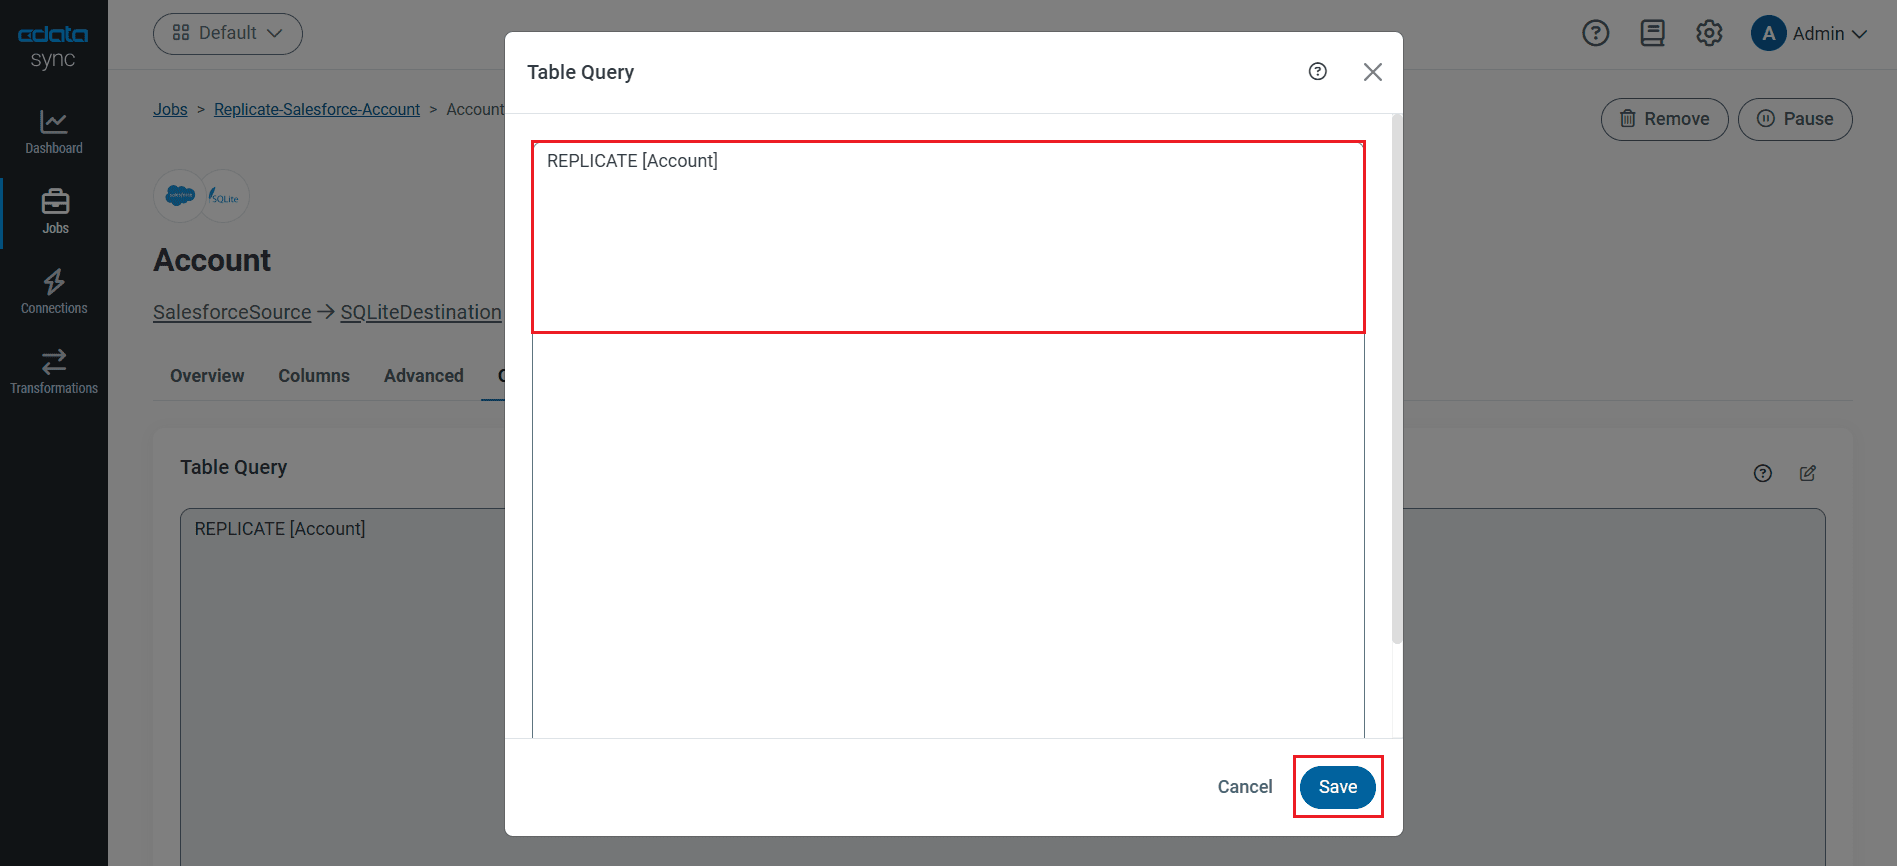
SQL クエリを使って、レプリケーションをカスタマイズできます。REPLICATE 構文はデータベースのテーブルにデータをキャッシュし、保存するハイレベルコマンドです。Perplexity API がサポートするSELECT クエリを定義することができます。レプリケーションのカスタマイズにはテーブルセクションで[カスタムクエリの追加]をクリックして、クエリステートメントを記述します。
Perplexity のデータ のテーブルを差分更新でキャッシュするステートメントは次のとおり:
REPLICATE AsyncJobResults;
使用するレプリケーションクエリを含むファイルを指定することで特定のデータベースを更新することが可能です。レプリケーションステートメントをセミコロンで区切ります。次のオプションは一つのデータベースに複数のPerplexity アカウントのデータを同期する例です:
-
REPLICATE SELECT ステートメントで異なるtable prefix を使用する:
REPLICATE PROD_AsyncJobResults SELECT * FROM AsyncJobResults; -
別の方法として、異なるスキーマを使うことも可能です:
REPLICATE PROD.AsyncJobResults SELECT * FROM AsyncJobResults;
レプリケーションのスケジュール起動
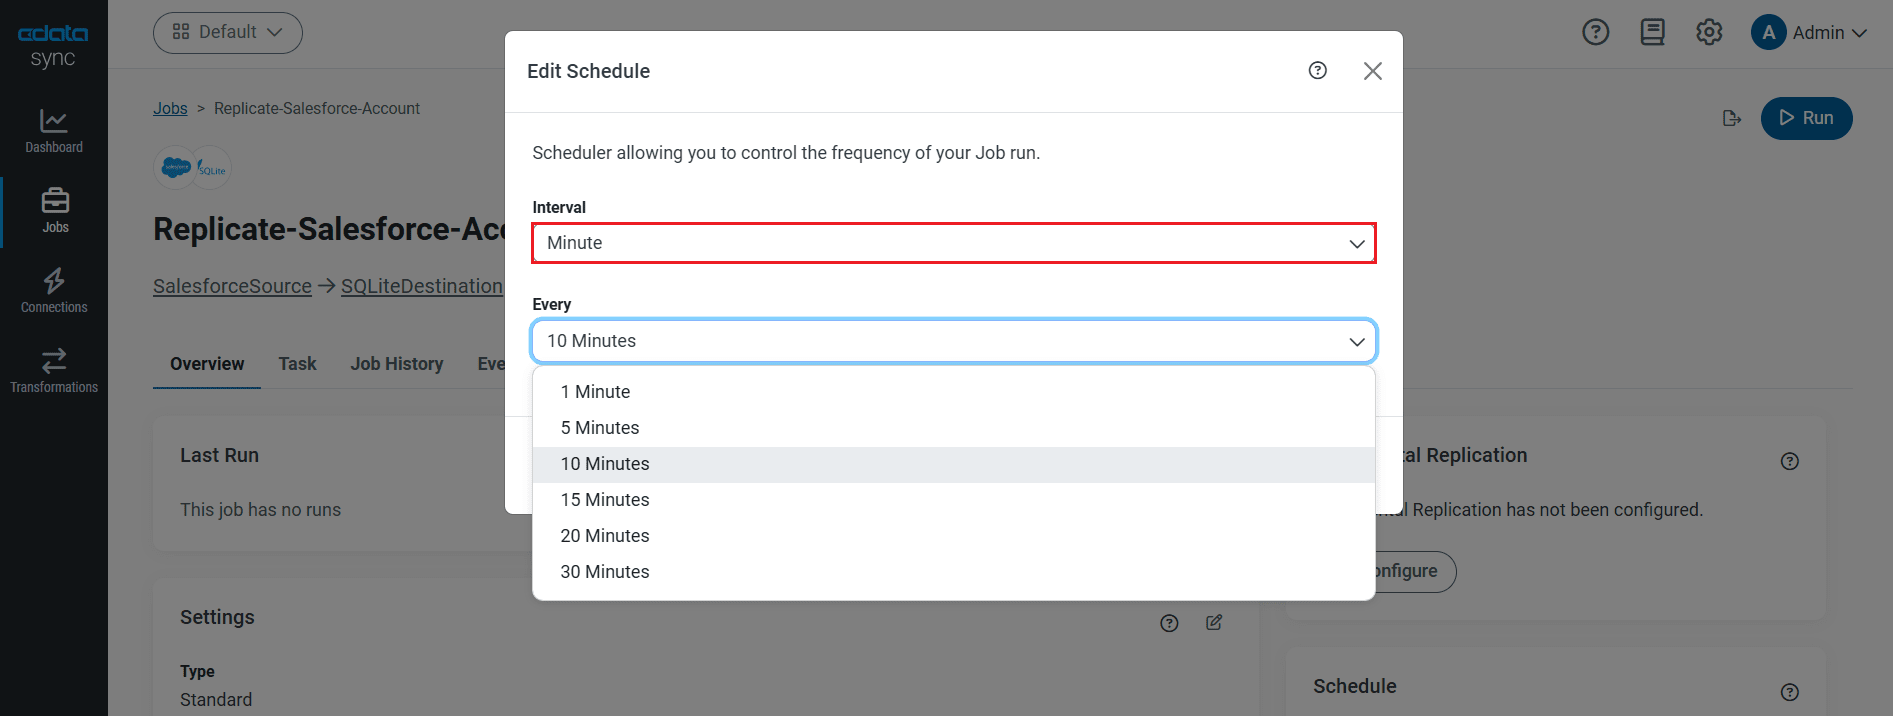
[スケジュール]セクションでは、レプリケーションジョブの自動起動スケジュール設定が可能です。反復同期間隔は、15分おきから毎月1回までの間で設定が可能です。
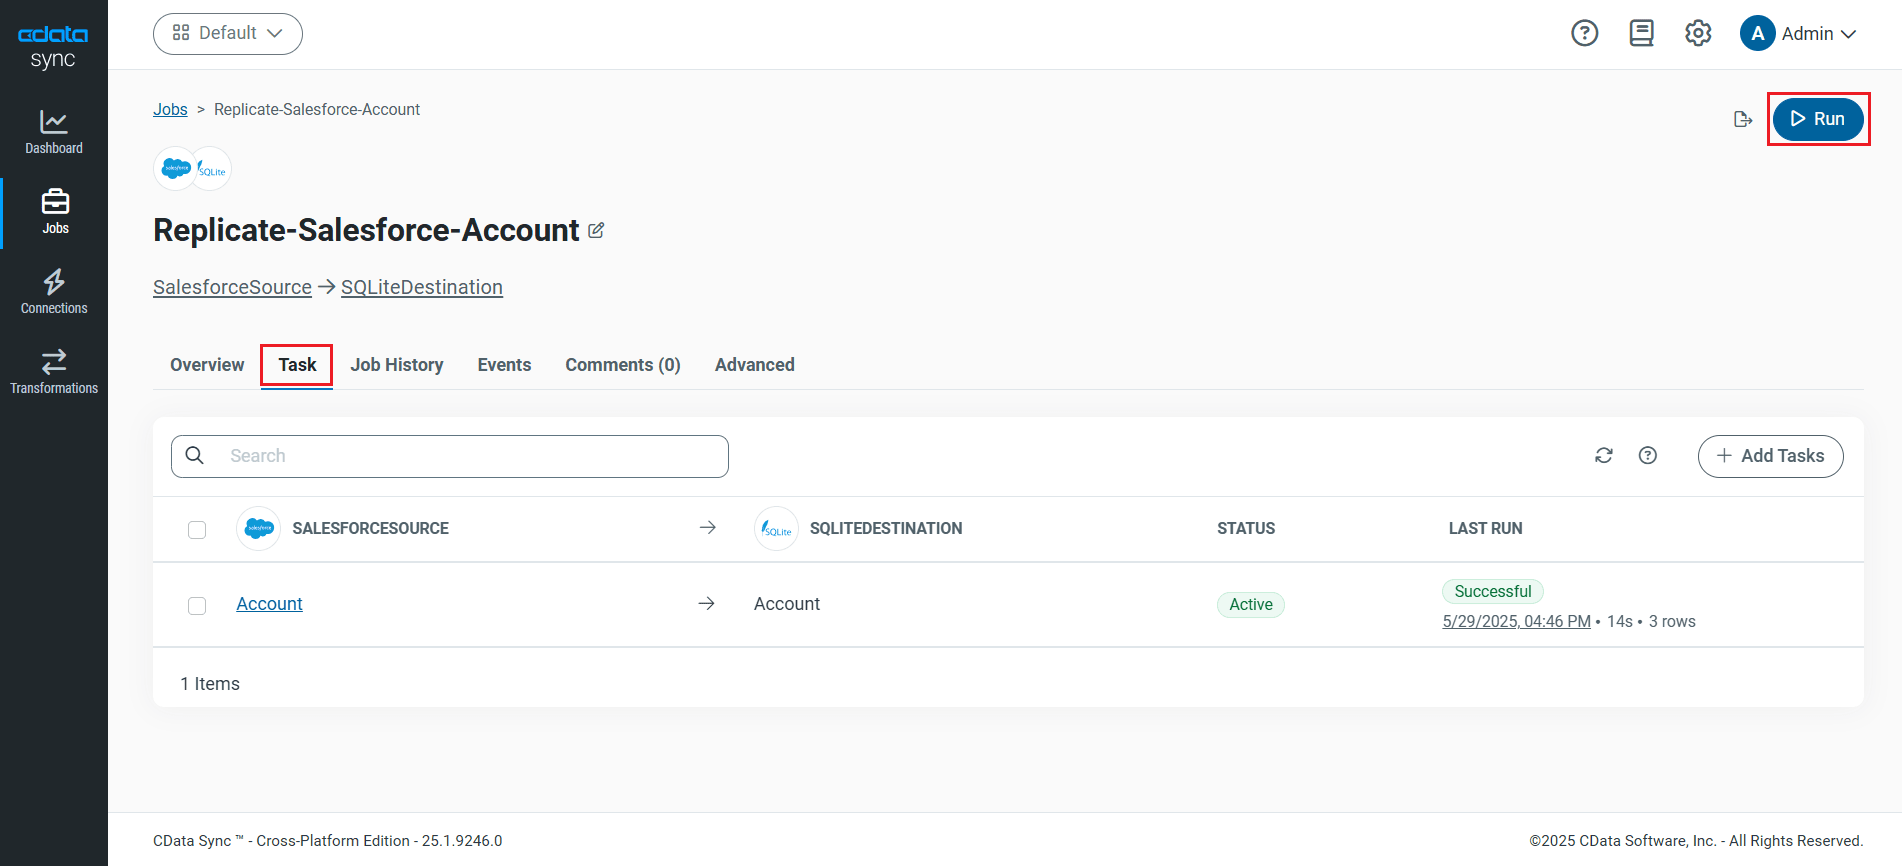
レプリケーションジョブを設定したら、[変更を保存]します。このように複数のPerplexity アカウントのデータを複製するジョブを作成することができました。