



CloverDX(旧CloverETL)で Pipeline CRM のデータ に接続
CData JDBC Driver for Pipeline CRM を使用すると、CloverDX(旧CloverETL)のデータ変換コンポーネントで Pipeline CRM をソースとして扱えます。この記事では、JDBC Driver for Pipeline CRM を使用して、フラットファイルへのシンプルな転送を設定する方法を説明します。
JDBC データソースとして Pipeline CRM に接続
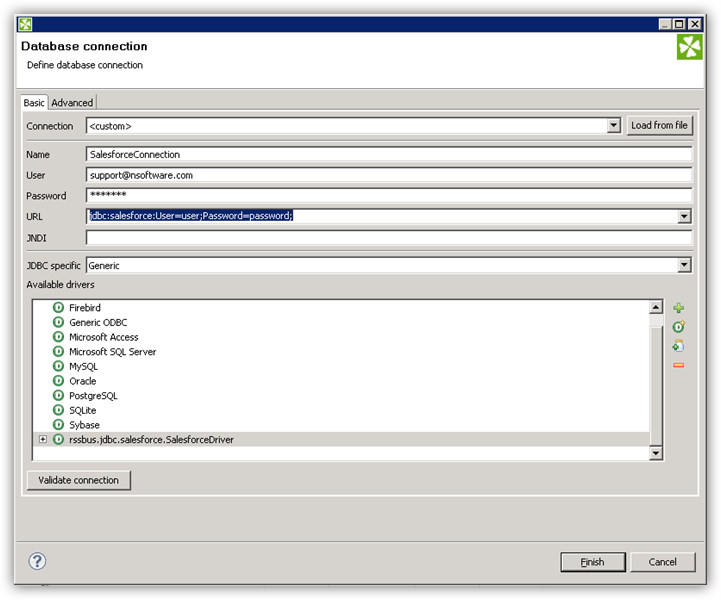
- Pipeline CRM のデータ への接続を作成します。新規のCloverDX グラフで、Outline ペインの「Connections」ノードを右クリックし、「Connections」->「Create Connection」をクリックします。Database Connection ウィザードが表示されます。
- プラスアイコンをクリックし、JAR からドライバーをロードします。インストールディレクトリのlib サブフォルダを参照し、cdata.jdbc.api.jar ファイルを選択します。
- JDBC URL を入力します。
まず、Profile 接続プロパティをディスク上の Pipeline CRM プロファイルの場所に設定します(例:C:\profiles\Pipeline.apip)。次に、ProfileSettings 接続プロパティを Pipeline CRM の接続文字列に設定します(以下を参照)。
Pipeline CRM API プロファイル設定
Account Settings > Pipeline API > Enable API Access > New API Key の順に進んで API キーを取得し、https://app.pipelinecrm.com/admin/modern/api で新しい Integration を作成して APP キーを生成します。
組み込みの接続文字列デザイナー
JDBC URL の構築には、Pipeline CRM JDBC Driver に組み込まれている接続文字列デザイナーを使用してください。JAR ファイルをダブルクリックするか、コマンドラインから実行します。
java -jar cdata.jdbc.api.jar接続プロパティを入力し、接続文字列をクリップボードにコピーします。
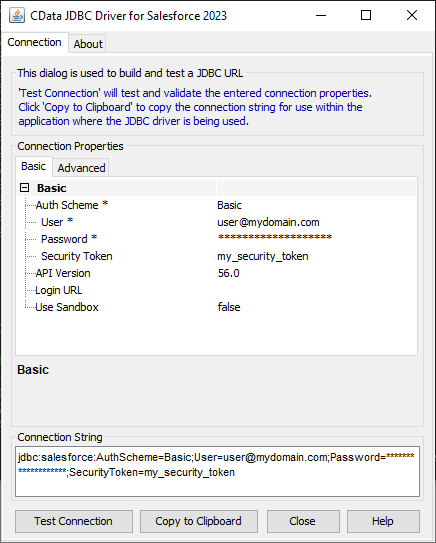
一般的なJDBC URL は次のようになります:
jdbc:api:Profile=C:\profiles\Pipeline.apip;ProfileSettings='APIKey=your_api_key;APPKey=your_app_key';
DBInputTable コンポーネントで Pipeline CRM のデータ をクエリ
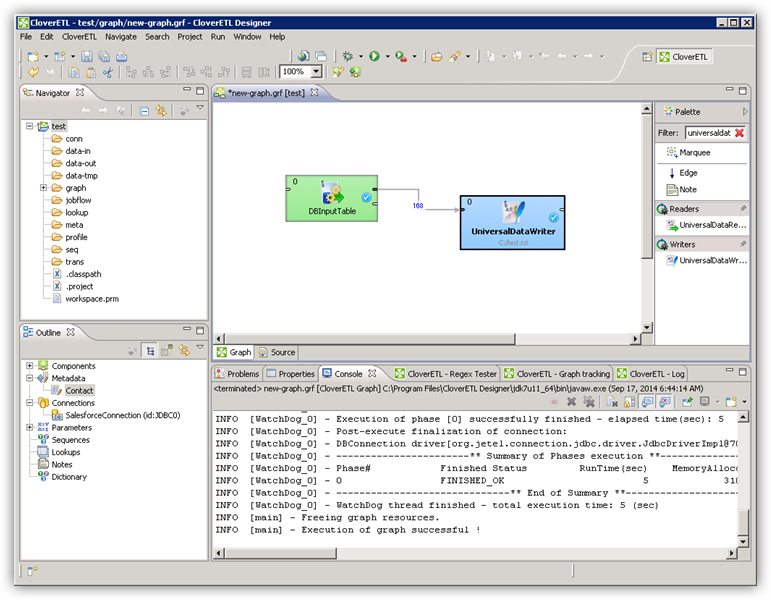
- Palette の「Readers」から「DBInputTable」をジョブフローにドラッグし、ダブルクリックして設定エディターを開きます。
- 「DB connection」プロパティで、ドロップダウンメニューから Pipeline CRM JDBC データソースを選択します。
- SQL クエリを入力します。例:
SELECT Id, AccountId FROM AccountNotifications WHERE Seen = 'true'
クエリの出力をUniversalDataWriter に書き込む
- 「Writers」から「UniversalDataWriter」をジョブフローにドラッグします。
- UniversalDataWriter をダブルクリックして設定エディターを開き、ファイルURL を追加します。
- DBInputTable を右クリックし、「Extract Metadata」をクリックします。
- DBInputTable の出力ポートをUniversalDataWriter に接続します。
- UniversalDataWriter の「Select Metadata」メニューで、AccountNotifications テーブルを選択します。(このメニューはUniversalDataWriter の入力ポートを右クリックしても開けます。)
- 「Run」をクリックして、ファイルに書き込みます。