



【ノーコード】Google Cloud SQLにTalkdeskのデータを連携・統合する方法

Cloud SQL はGoogle Cloud が提供するフルマネージドのRDB サービスです。CData Sync なら、Cloud SQL インスタンスにリアルタイムTalkdesk のデータを反復同期できます。企業のあらゆるデータを一か所に統合して管理することが可能になり、アーカイブ、レポーティング、アナリティクス、機械学習、AI などでデータを活用できます。
1.データソースとしてTalkdesk の接続を設定
まずはじめに、CData Sync のブラウザ管理コンソールにログインします。CData Sync のインストールをまだ行っていない方は本記事の製品リンクからCData Sync をクリックして、30日の無償トライアルとしてCData Sync をインストールしてください。インストール後にCData Sync が起動して、ブラウザ設定画面が開きます。
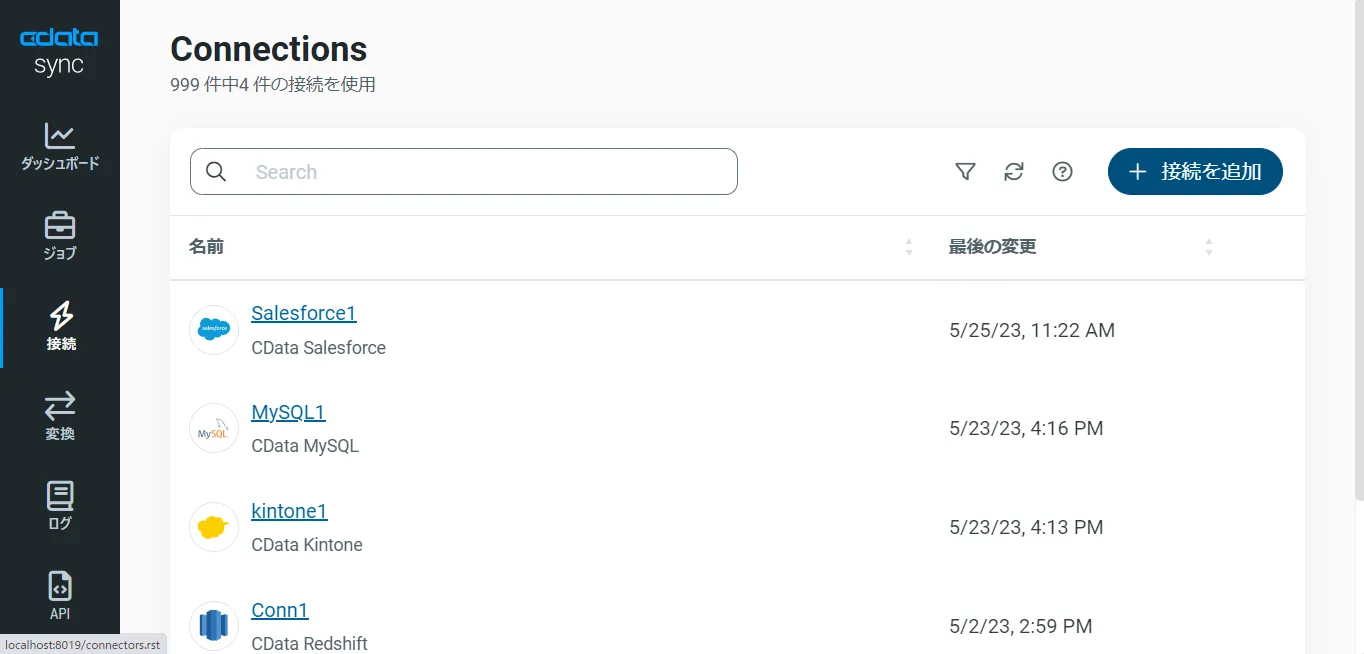
それでは、データソース側にTalkdesk を設定していきましょう。左の[接続]タブをクリックします。
- [+接続の追加]ボタンをクリックします。
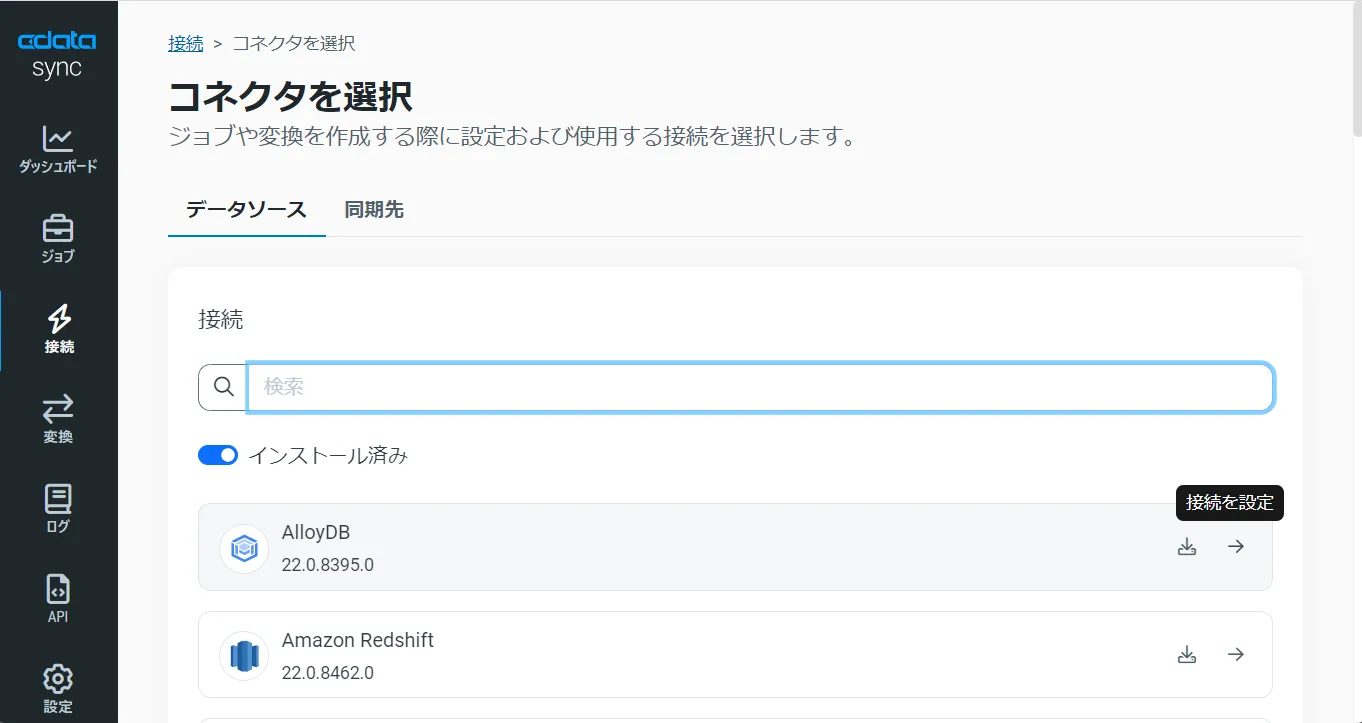
- [データソース]タブを選択して、リスト表示されるデータソースを選ぶか、検索バーにデータソース名を入力して、Talkdesk を見つけます。
- Talkdesk の右側の[→]をクリックして、Talkdesk アカウントへの接続画面を開きます。もし、Talkdesk のコネクタがデフォルトでCData Sync にインストールされていない場合には、ダウンロードアイコン(コネクタのアップロードアイコン)をクリックし、[ダウンロード]をクリックすると、CData Sync にコネクタがインストールされます。
- 接続プロパティにTalkdesk に接続するアカウント情報を入力をします。
Talkdesk では OAuth 2.0 の Client Credentials グラントを使用します。ブラウザでの認可ステップやコールバック URL は必要ありません。
以下の接続プロパティを設定します。
- AccountName:Talkdesk アカウントの名前。
- Region:Talkdesk インスタンスがデプロイされているリージョン。指定できる値は US(デフォルト)、EU、CA、AU、UK、FedRamp です。
- OAuthClientId:カスタム OAuth アプリケーションの登録時に割り当てられた Client Id。
- OAuthClientSecret:カスタム OAuth アプリケーションに割り当てられた Client Secret。
カスタム OAuth アプリケーションの作成
- Talkdesk アカウントにログインし、ナビゲーションメニューから OAuth Clients を選択します。
- Create OAuth Client をクリックし、クライアントにわかりやすい名前を付けます。
- Grant Type を Client Credentials に設定します。
- Add scopes をクリックし、アクセスしたいデータに応じたスコープを選択します。
- Create をクリックし、Client Id と Client Secret をコピーします。
接続時、ドライバーは Talkdesk にアクセストークンを自動でリクエストしてキャッシュし、有効期限が切れると更新します。アプリケーションで選択したスコープが、クエリ予定のビューに対応していることを確認してください。対応していない場合、トークンのリクエストが失敗することがあります。
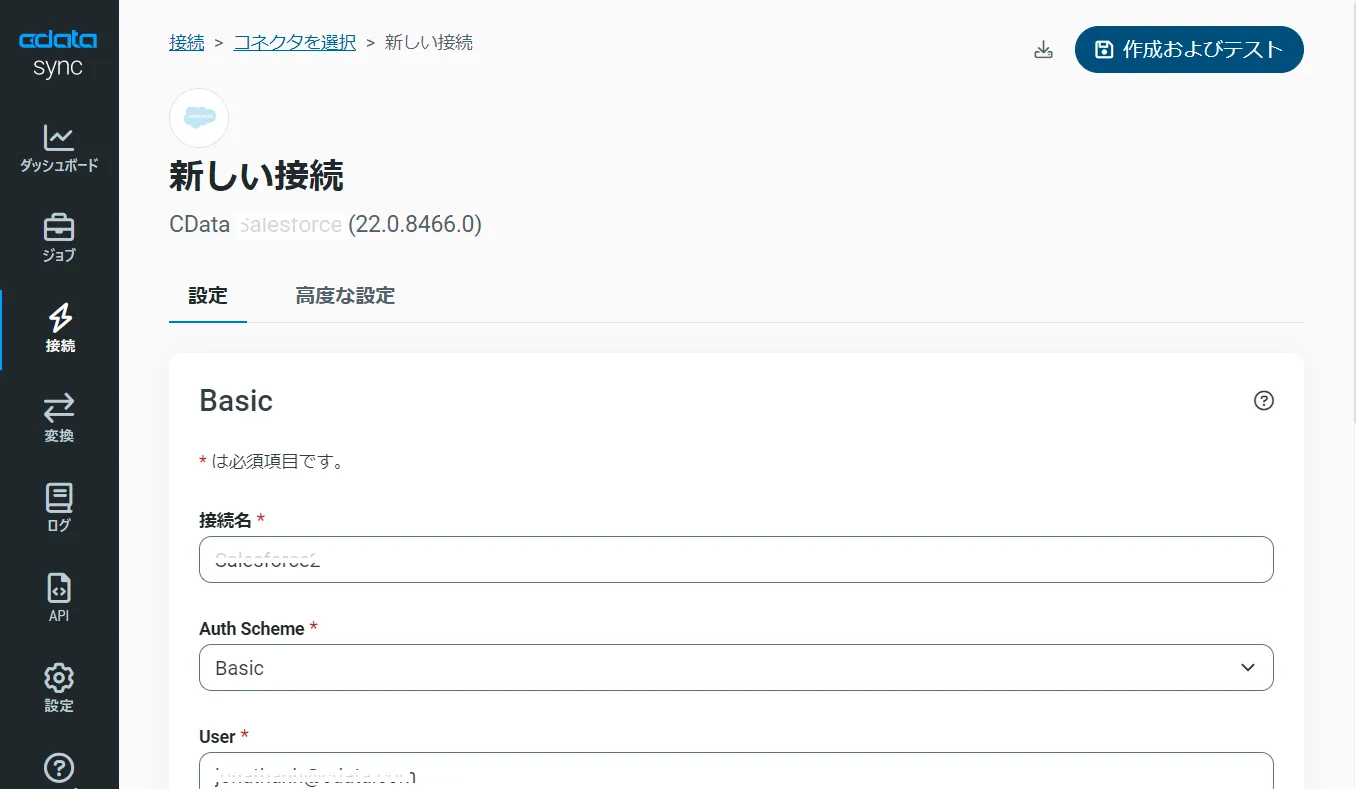
- [作成およびテスト]をクリックして、正しくTalkdesk に接続できているかをテストして保存します。これでレプリケーションのデータソースとしてTalkdesk への接続が設定されました。
Cloud SQL をレプリケーションの同期先に設定
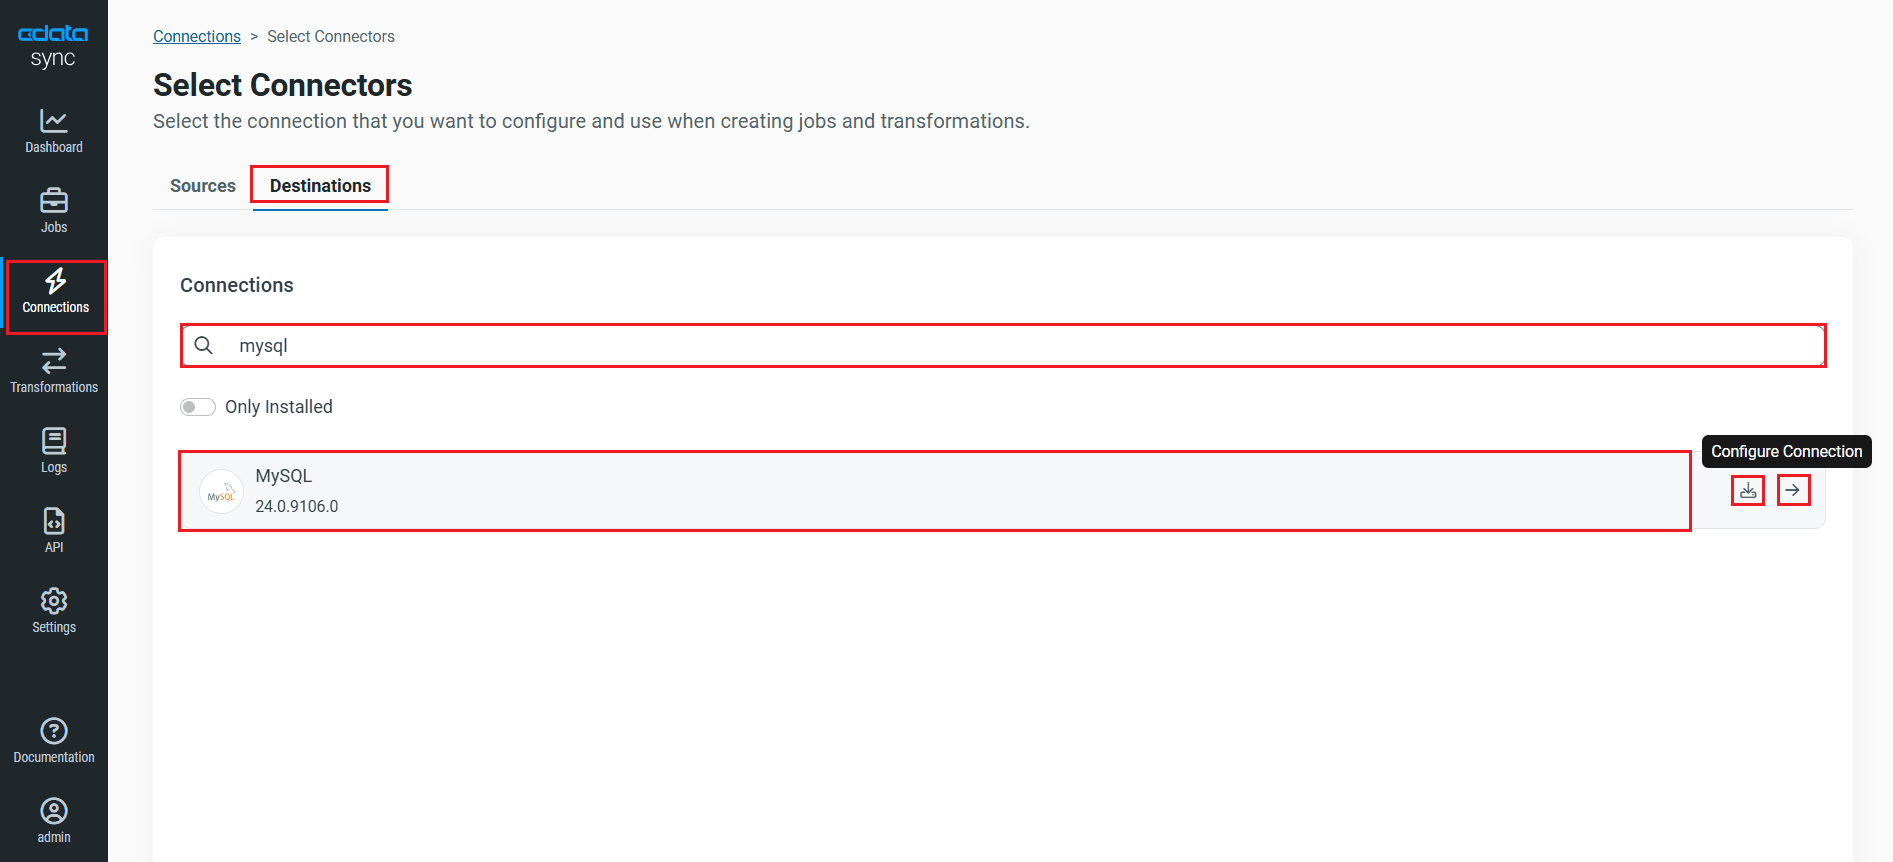
それでは、CData Sync を使ってCloud SQL にTalkdesk のデータをレプリケーションするための設定を行っていきましょう。レプリケーションの同期先を追加するには、[接続]タブを開きます。次に、使用するCloud SQL サービス(MySQL、PostgreSQL、またはSQL Server)に応じて、適切な保存先を選択します。
MySQL
- [接続を追加]をクリックします。
- MySQL を同期先として選択します。
- 必要な接続プロパティを入力します。MySQL に接続するには、以下を設定します。
- Server:接続するサーバーのIP アドレス、もしくはドメイン名。
- Port:サーバーが稼働するポート。
- User:データベースへの読み取り / 書き込みのアクセス権を持つユーザーのユーザー名。
- Password:データベースへの読み取り / 書き込みのアクセス権を持つユーザーのパスワード。
- Database:データベース名。
- [作成およびテスト]をクリックして、正しく接続できているかをテストします。
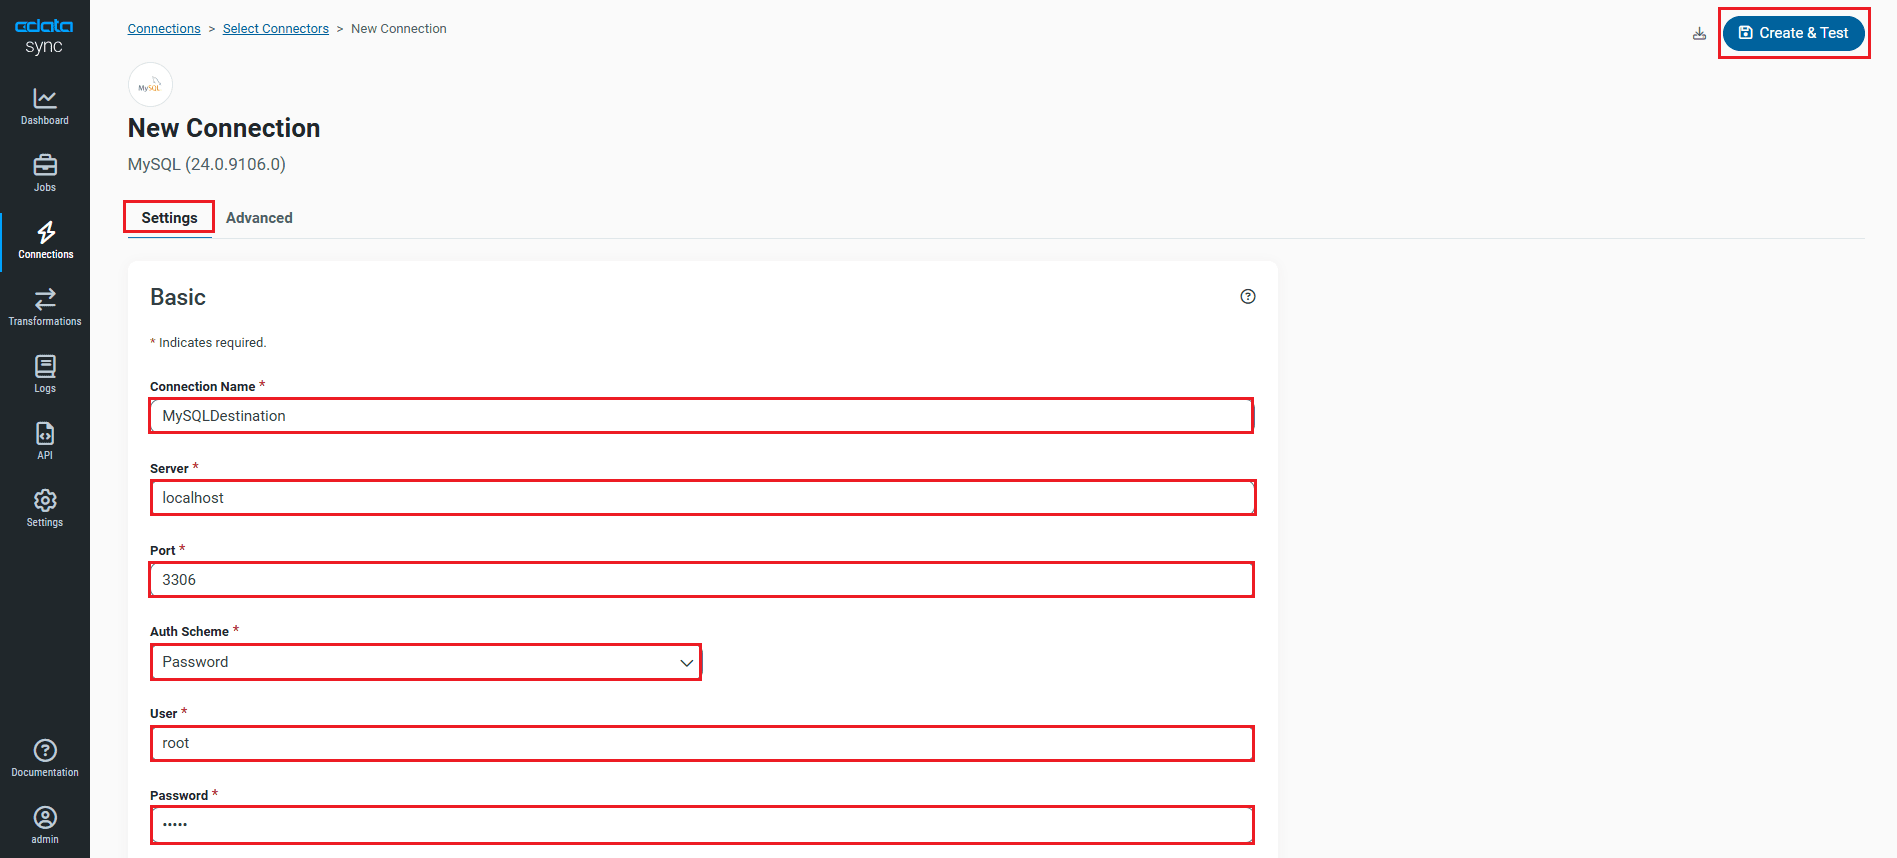
- [変更を保存]をクリックします。
PostgreSQL
- [接続を追加]をクリックします。
- PostgreSQL を同期先として選択します。
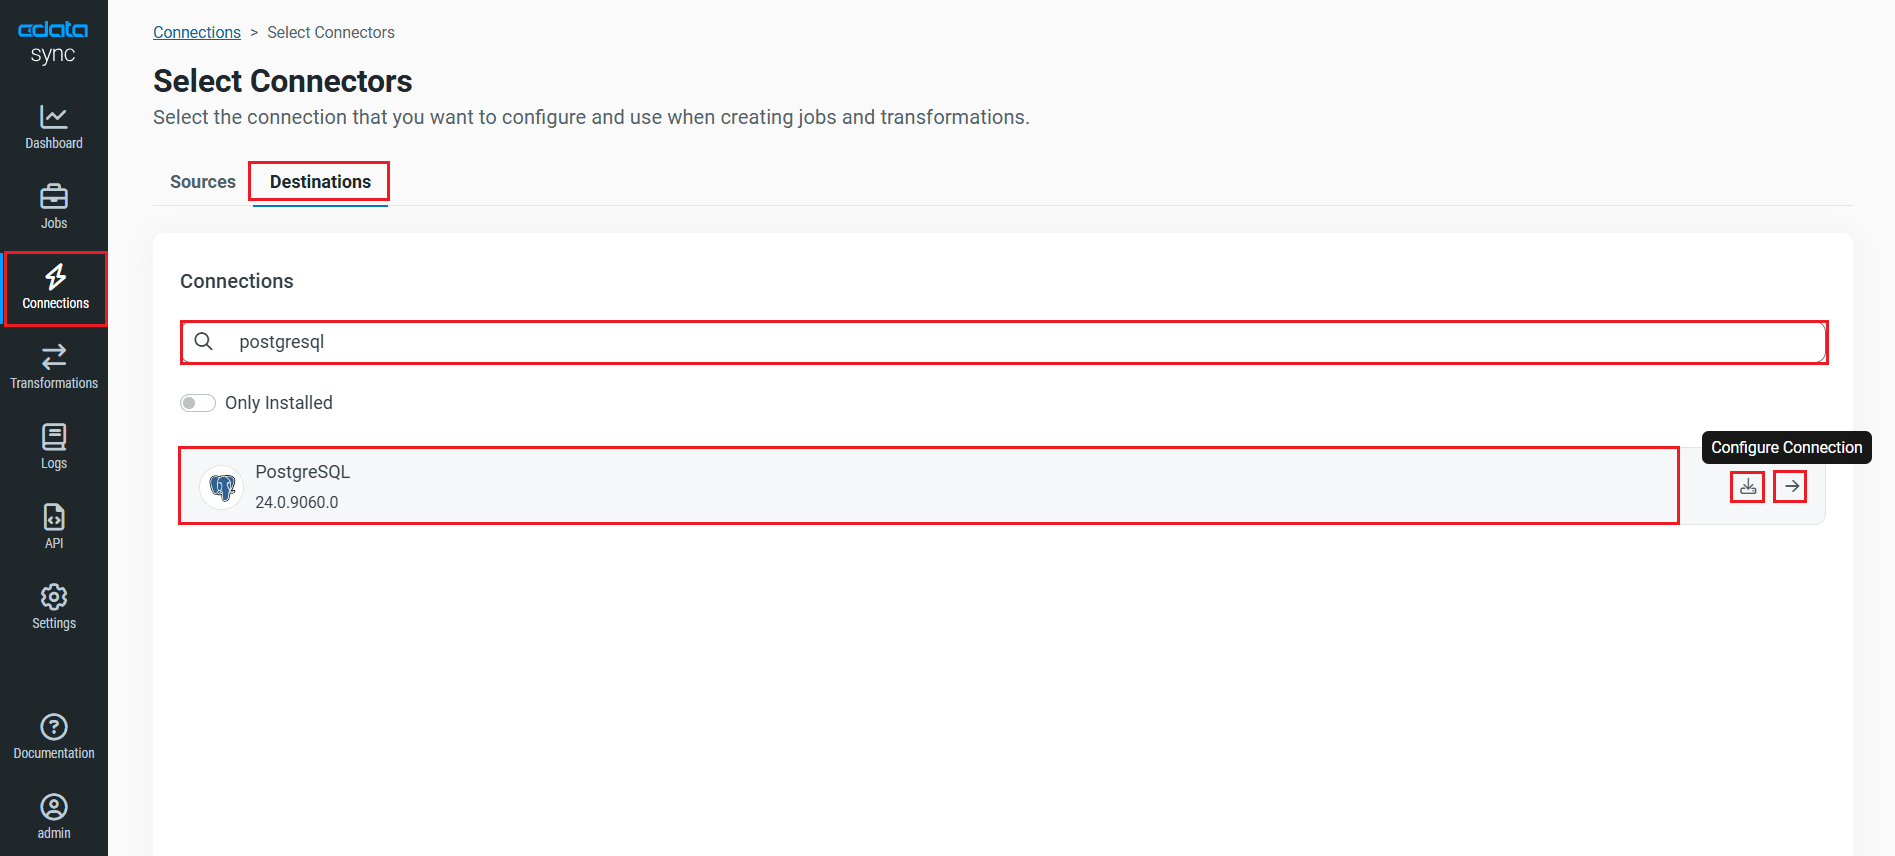
- 必要な接続プロパティを入力します。PostgreSQL に接続するには、次の接続プロパティを設定します。
- Server:PostgreSQL データベースをホストしているサーバーのアドレス。
- Port:PostgreSQL データベースをホスティングしているサーバーに接続する際のポート。
- User:PostgreSQL データベースへの認証のためのユーザーID。
- Password:PostgreSQL データベースへの認証のためのパスワード。
- Database:データベース名。
- [作成およびテスト]をクリックして、正しく接続できているかをテストします。
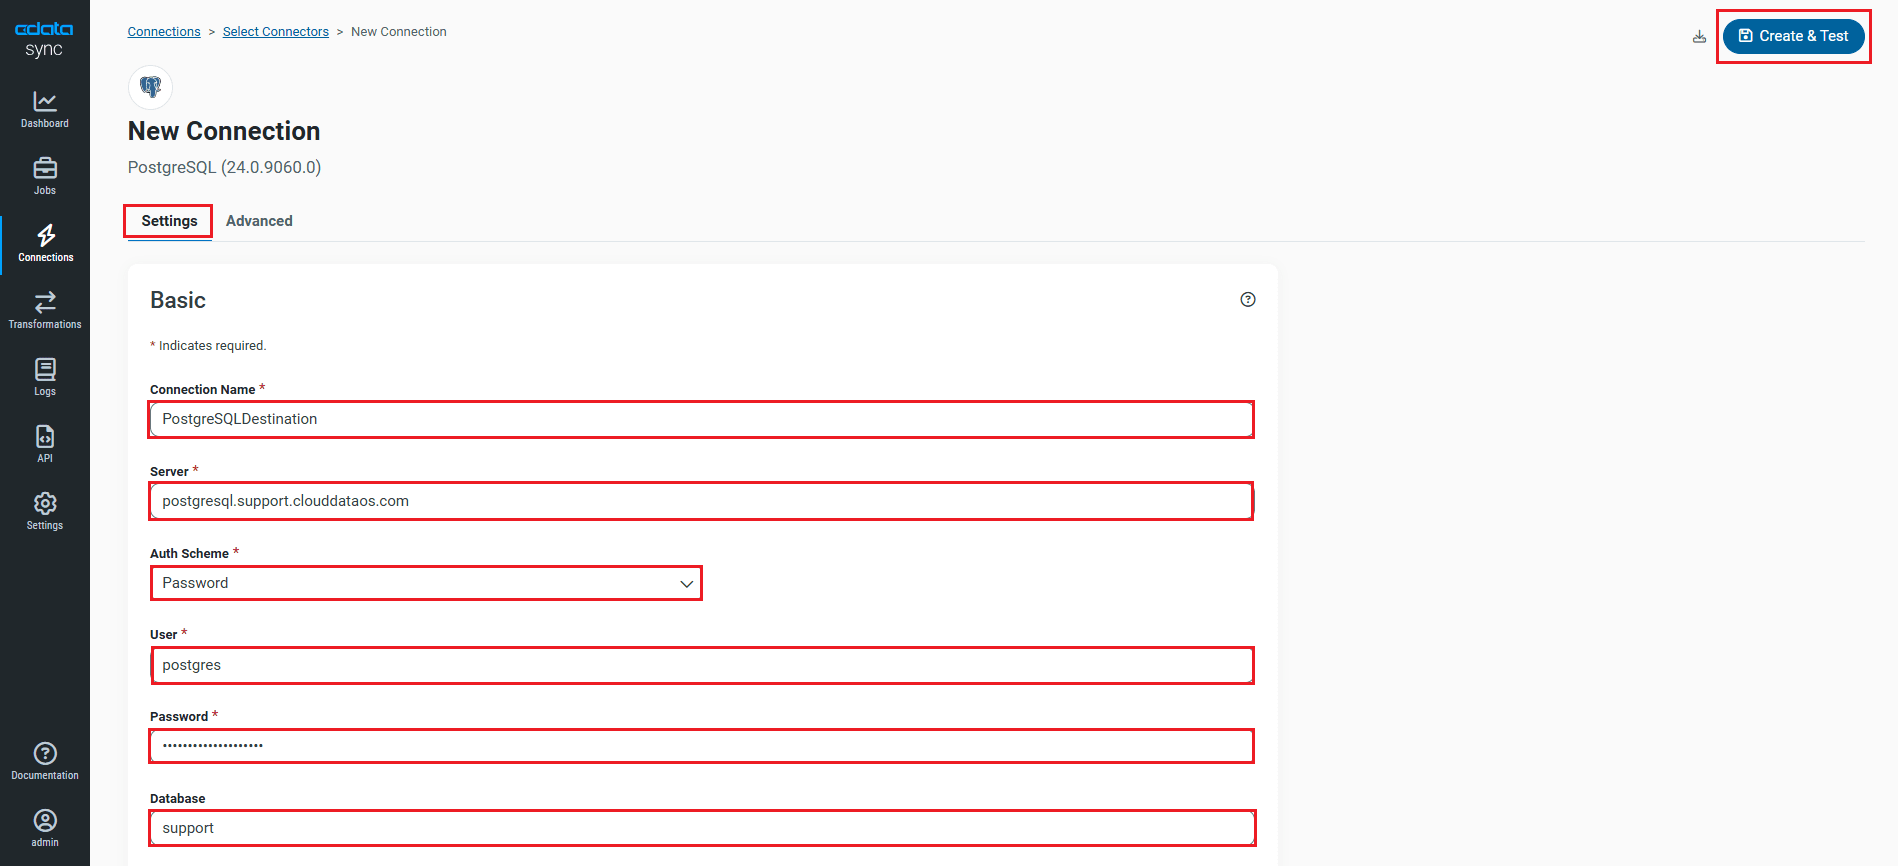
- [変更を保存]をクリックします。
SQL Server
- [接続を追加]をクリックします。
- SQL Server を同期先として選択します。
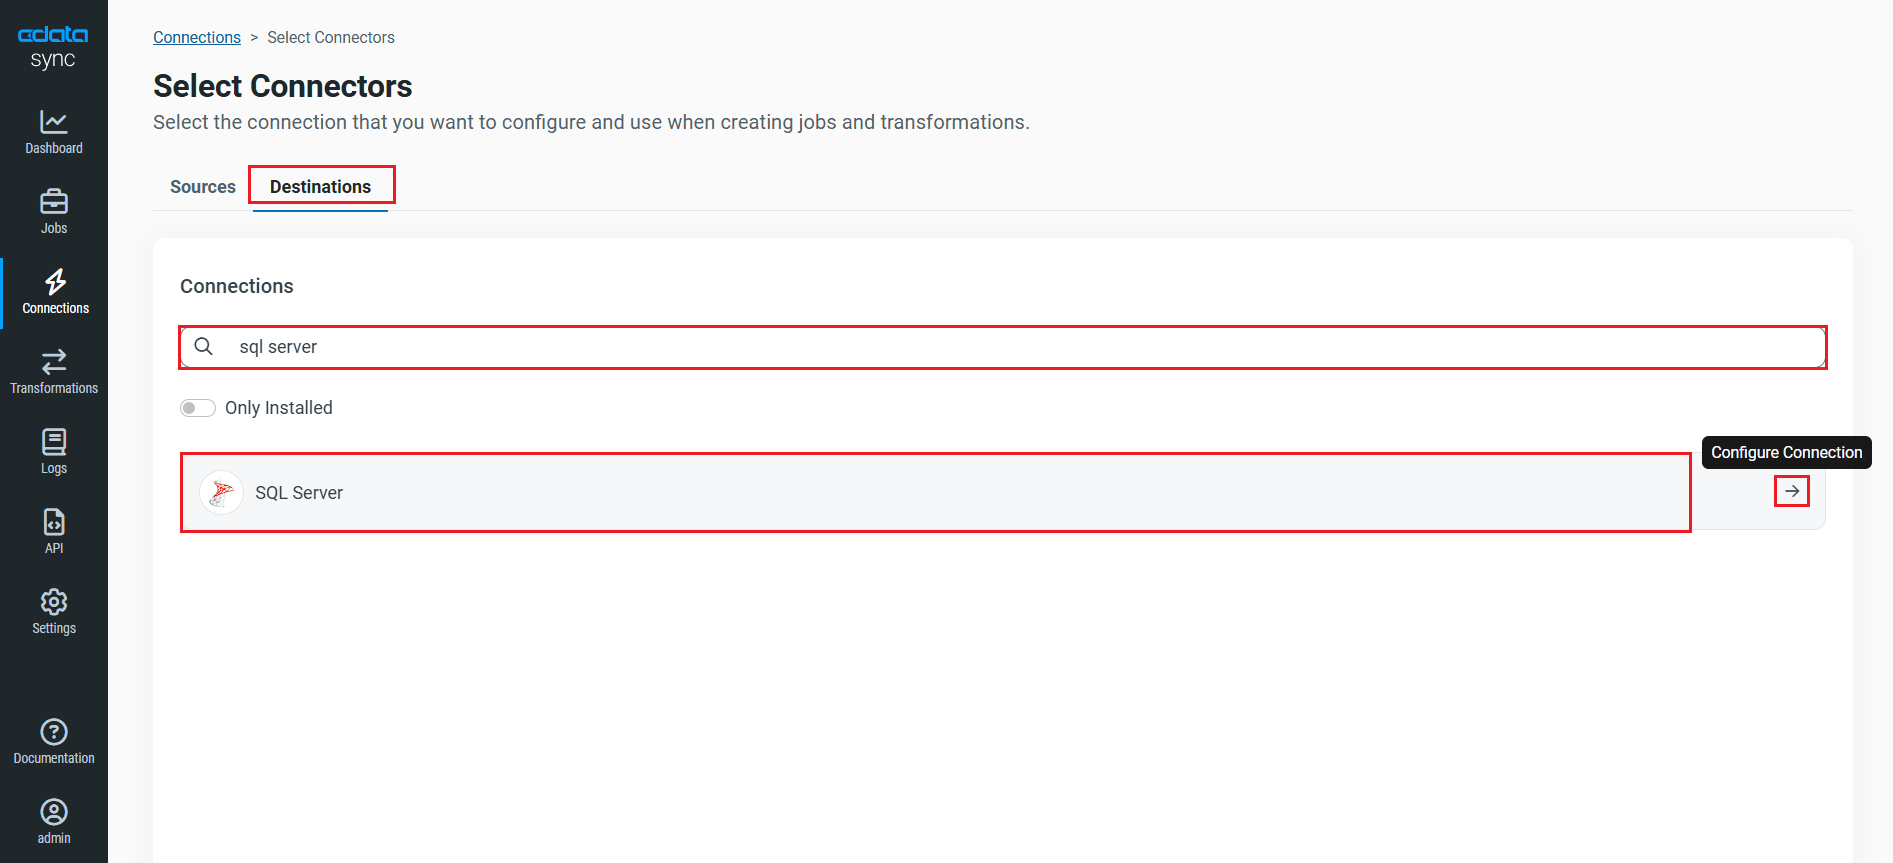
- 必要な接続プロパティを入力します。SQL Server に接続するには、以下を設定します。
- Server:SQL Server を起動しているコンピューターのネットワークアドレス名。
- User:forms 認証を使う場合に、SQL Server との認証に使われるユーザー名。
- Password:forms 認証を使う場合に、SQL Server との認証に使われるパスワード。
- Database:SQL Server データベース名。
Java 版
Java 版では、Microsoft SQL Server JDBC Driver が必要です。Microsoft ダウンロードセンターからダウンロードできます。JDBC ドライバーをJava Web サーバーのlib フォルダにコピーして接続します。
- [作成およびテスト]をクリックして、正しく接続できているかをテストします。
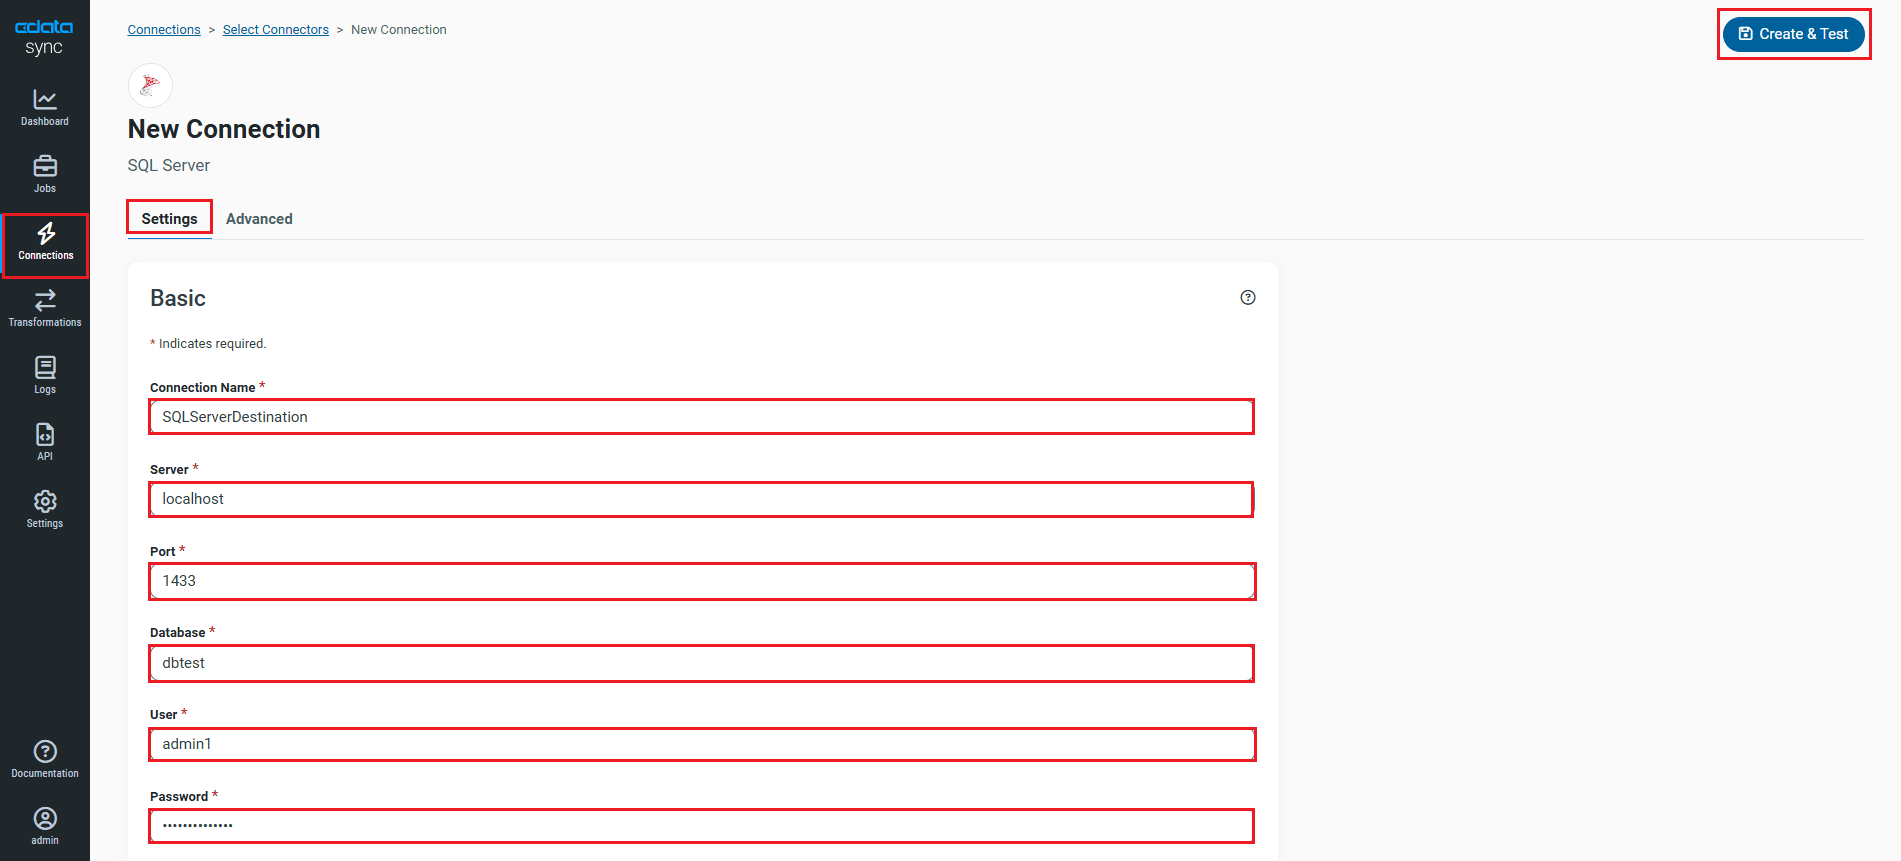
- これで同期先としてCloud SQL を設定できました。CData Sync では、Cloud SQL のデータベース名を指定するだけで、同期するTalkdesk に併せたテーブルスキーマを自動的にCREATE TABLE してくれます。同期データに合わせたテーブルを事前に作成するなどの面倒な手順は必要ありません。もちろん、既存テーブルにマッピングを行いデータ同期を行うことも可能です。
3.Talkdesk からCloud SQL へのレプリケーションジョブの作成
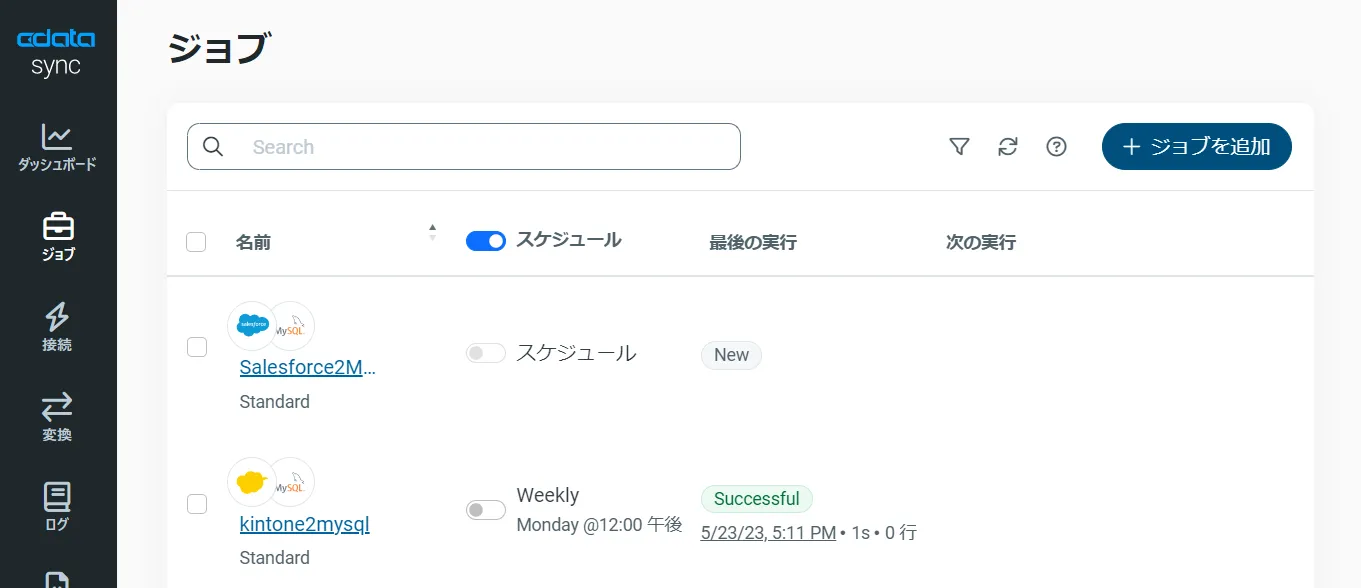
CData Sync では、レプリケーションをジョブ単位で設定します。ジョブは、Talkdesk からCloud SQL という単位で設定し、複数のテーブルを含むことができます。レプリケーションジョブ設定には、[ジョブ]タブに進み、[+ジョブを追加]ボタンをクリックします。
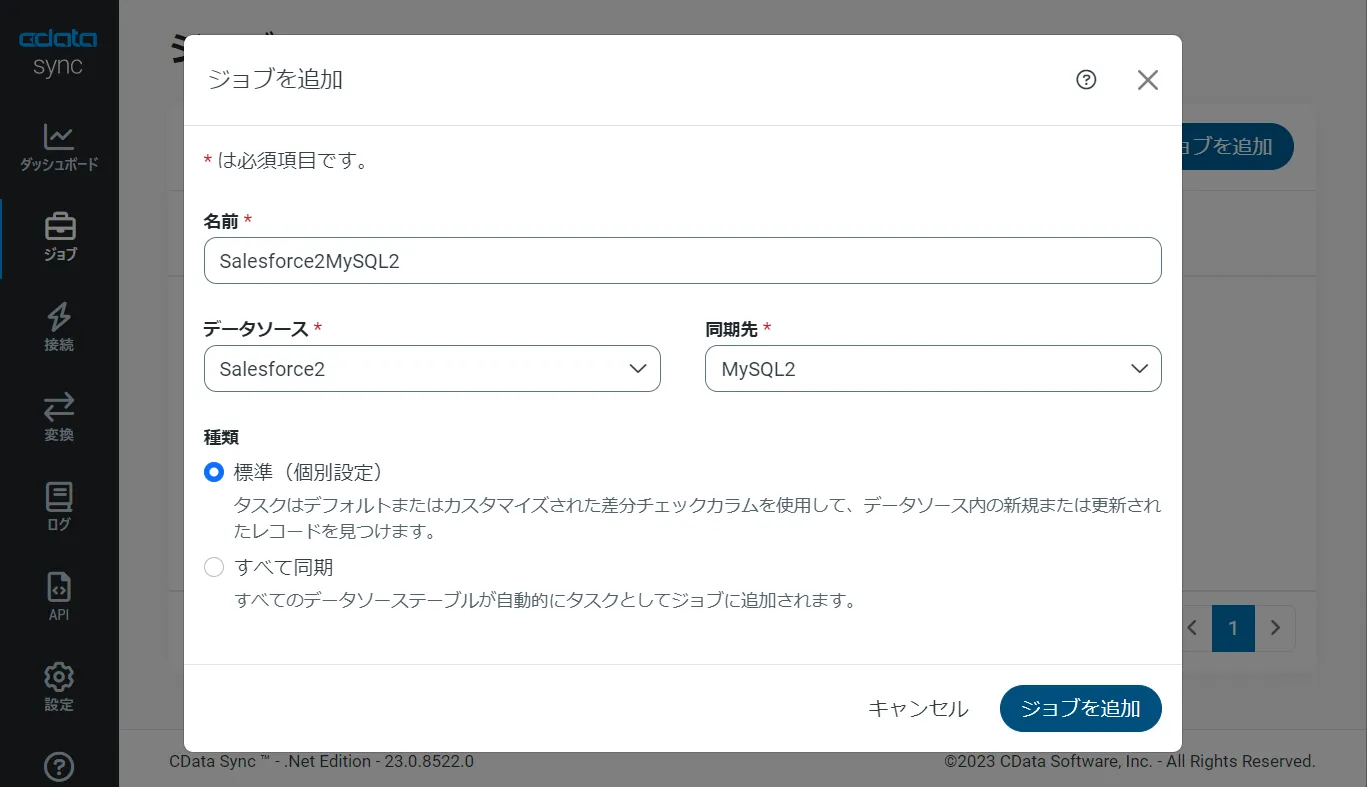
[ジョブを追加]画面が開き、以下を入力します:
- 名前:ジョブの名前
- データソース:ドロップダウンリストから先に設定したTalkdesk を選択
- 同期先:先に設定したCloud SQL を選択
すべてのオブジェクトをレプリケーションする場合
Talkdesk のすべてのオブジェクト / テーブルをレプリケーションするには、[種類]セクションで[すべて同期]を選択して、[タスクを追加]ボタンで確定します。
作成したジョブ画面で、右上の[▷実行]ボタンをクリックするだけで、全Talkdesk テーブルのCloud SQL への同期を行うことができます。
オブジェクトを選択してレプリケーションする場合
Talkdesk から特定のオブジェクト / テーブルを選択してレプリケーションを行うことが可能です。[種類]セクションでは、[標準(個別設定)]を選んでください。
次に[ジョブ]画面で、[タスク]タブをクリックし、[タスクを追加]ボタンをクリックします。 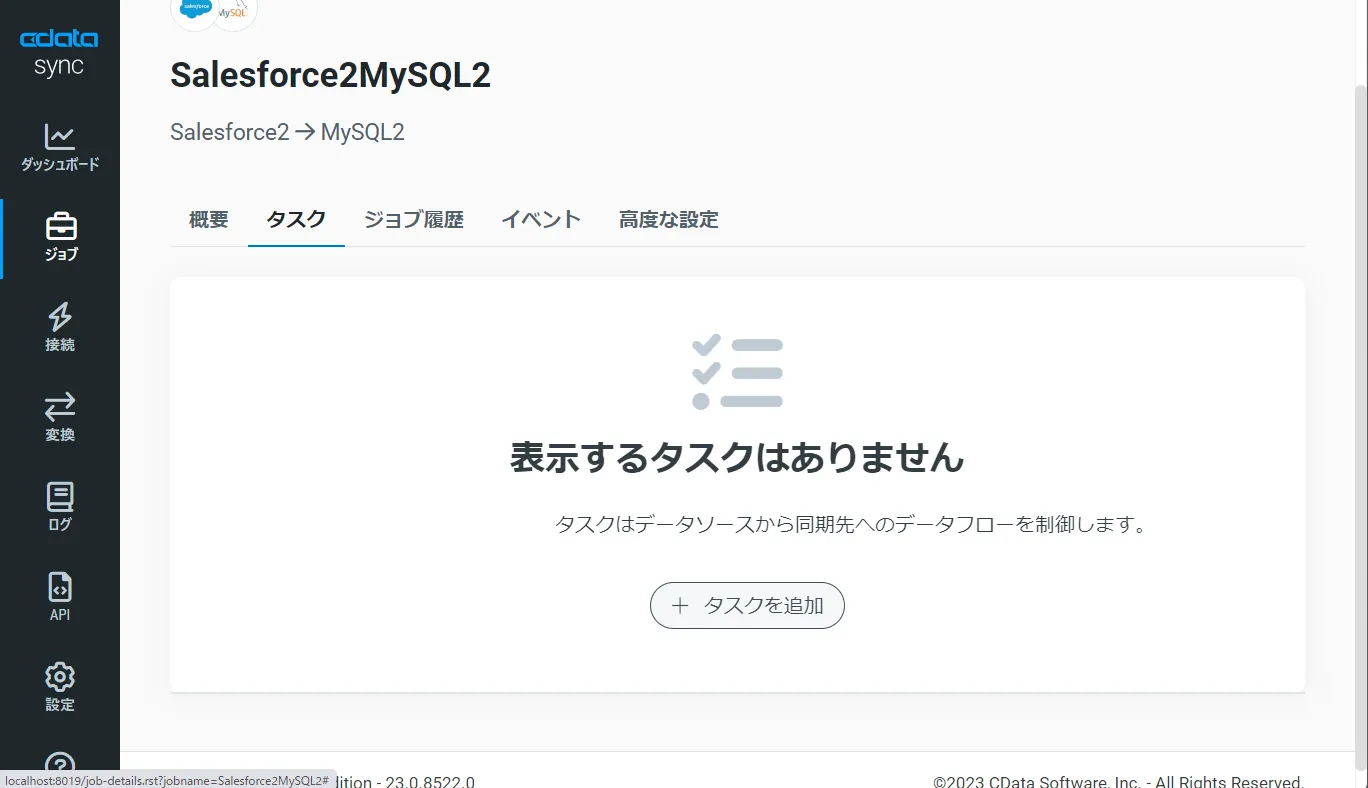
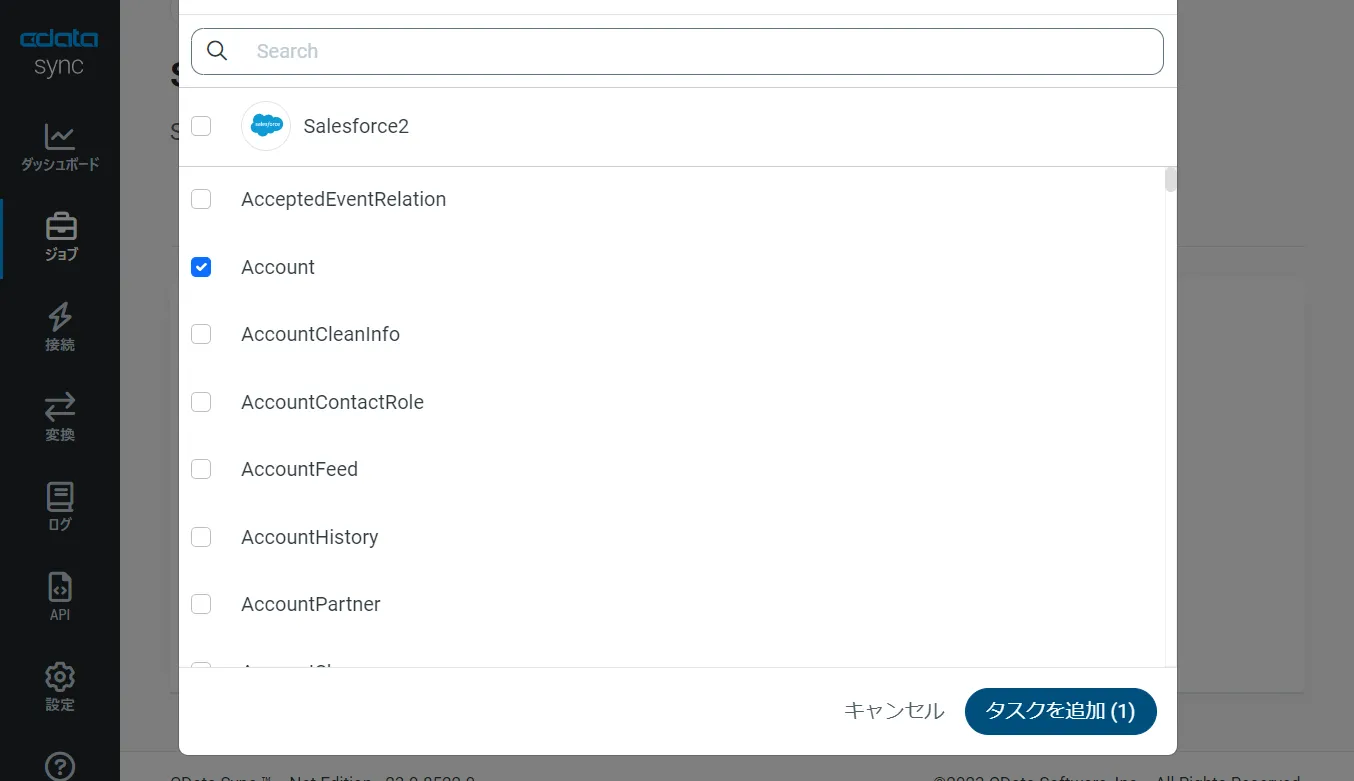
するとCData Sync で利用可能なオブジェクト / テーブルのリストが表示されるので、レプリケーションを行うオブジェクトにチェックを付けます(複数選択可)。[タスクを追加]ボタンで確定します。
作成したジョブ画面で、[▷実行]ボタンをクリックして(もしくは各タスク毎の実行ボタンを押して)、レプリケーションジョブを実行します。 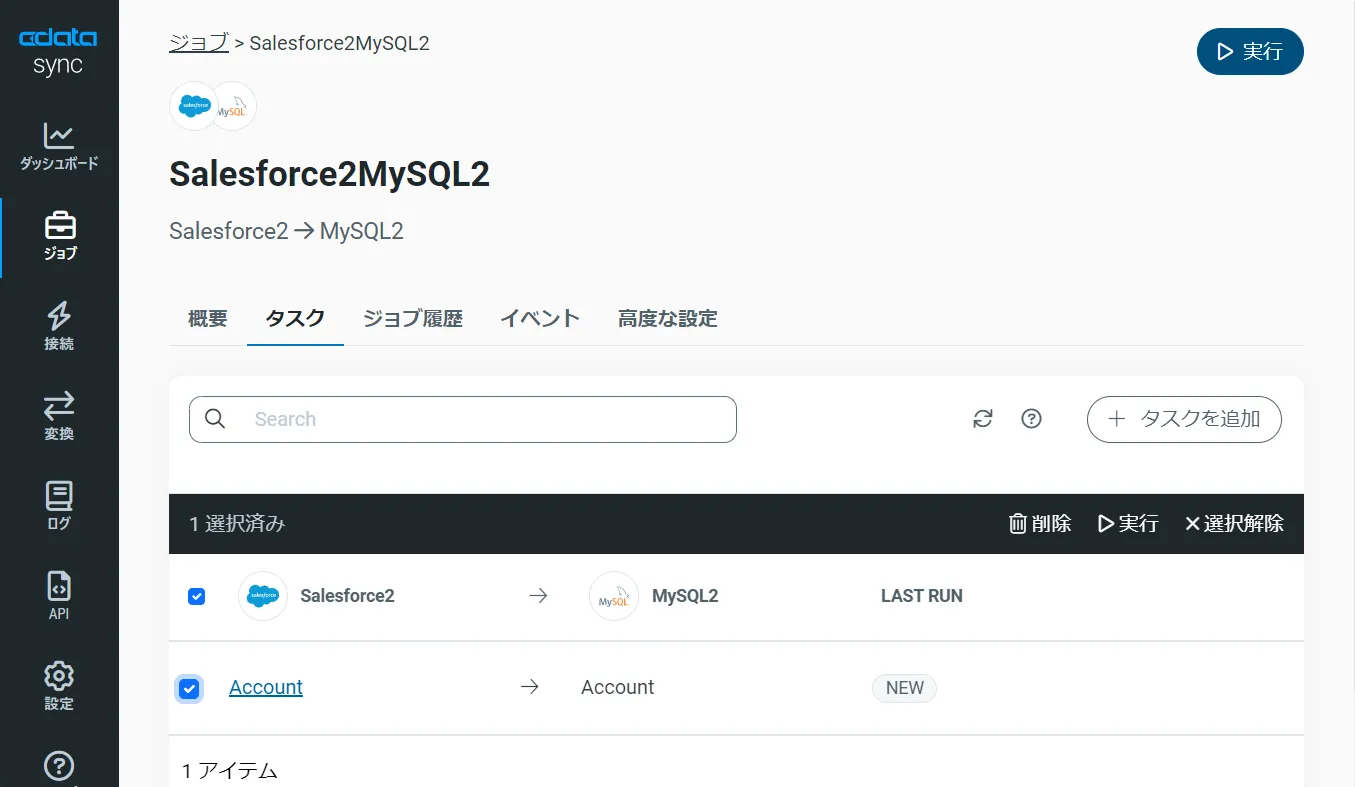
このようにとても簡単にTalkdesk からCloud SQL への同期を行うことができました。
CData Sync の主要な機能を試してみる:スケジューリング・差分更新・ETL
ジョブのスケジュール起動設定
CData Sync では、同期ジョブを1日に1回や15分に1回などのスケジュール起動をすることができます。ジョブ画面の[概要]タブから[スケジュール]パネルを選び、[⚙設定]ボタンをクリックします。[間隔]と同期時間の[毎時何分]を設定し、[保存]を押して設定を完了します。これでCData Sync が同期ジョブをスケジュール実行してくれます。ユーザーはダッシュボードで同期ジョブの状態をチェックするだけです。 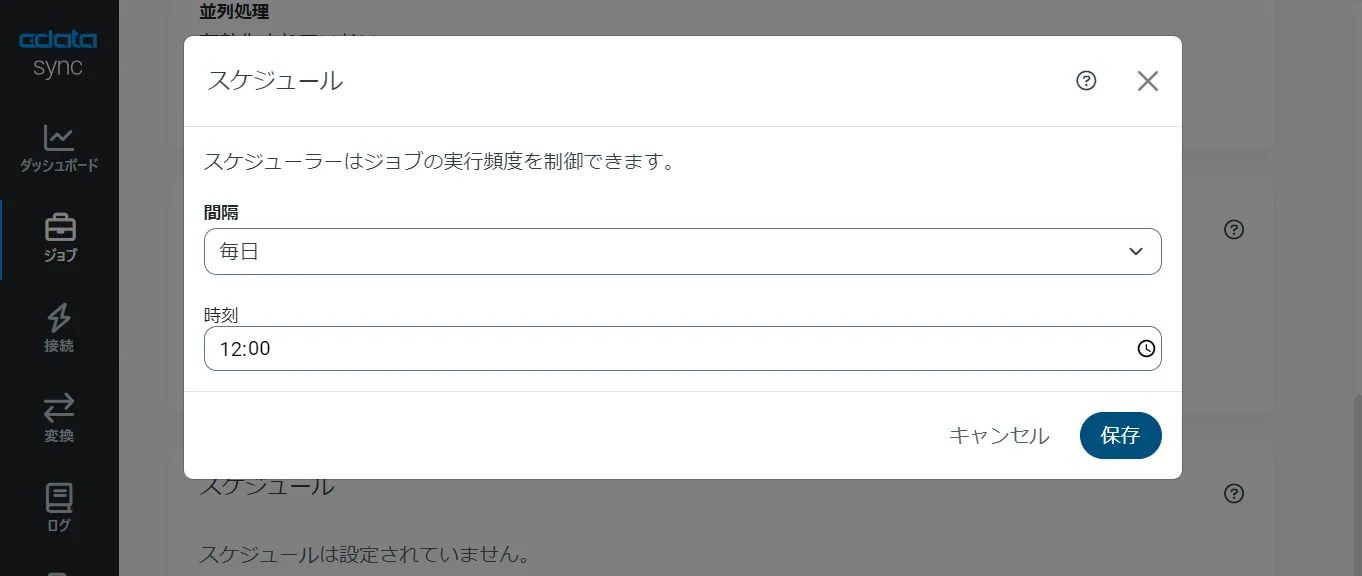
差分更新
CData Sync では、主要なデータソースでは、差分更新が可能です。差分更新では、最後のジョブ実行時からデータソース側でデータの追加・変更があったデータだけを同期するので、レプリケーションのクエリ・通信のコストを圧倒的に抑えることが可能です。
差分更新を有効化するには、ジョブの[概要]タブから「差分更新」パネルを選び、[⚙設定]ボタンをクリックします。[開始日]と[レプリケーション間隔]を設定して、[保存]します。
SQL での取得データのカスタマイズ
CData Sync は、デフォルトではTalkdesk のオブジェクト / テーブルをそのままCloud SQL に複製しますが、ここにSQL、またはdbt 連携でのETL 処理を組み込むことができます。テーブルカラムが多すぎる場合や、データ管理の観点から一部のカラムだけをレプリケーションしたり、さらにデータの絞り込み(フィルタリング)をしたデータだけをレプリケーションすることが可能です。
ジョブの[概要]タブ、[タスク]タブへと進みます。選択されたタスク(テーブル)の[▶]の左側のメニューをクリックし、[編集]を選びます。タスクの編集画面が開きます。
UI からカラムを選択する場合には、[カラム]タブから[マッピング編集]をクリックします。レプリケーションで使用しないカラムからチェックを外します。
SQL を記述して、フィルタリングなどのカスタマイズを行うには、[クエリ]タブをクリックし、REPLICATE [テーブル名]の後に標準SQL でフィルタリングを行います。
Talkdesk からCloud SQL へのデータ同期には、ぜひCData Sync をご利用ください
このようにノーコードで簡単にTalkdesk のデータをCloud SQL にレプリケーションできます。データ分析、AI やノーコードツールからのデータ利用などさまざまな用途でCData Sync をご利用いただけます。30日の無償トライアルで、シンプルでパワフルなデータパイプラインを体感してください。
日本のユーザー向けにCData Sync は、UI の日本語化、ドキュメントの日本語化、日本語でのテクニカルサポートを提供しています。
CData Sync の 導入事例を併せてご覧ください。