



Databricks(AWS)でUKG Pro HCM のデータを処理・分析
Databricks は、Apache Spark を通じたデータ処理機能を提供するクラウドベースのサービスです。CData JDBC Driver と組み合わせることで、Databricks を使用してリアルタイムUKG Pro HCM のデータに対してデータエンジニアリングとデータサイエンスを実行できます。この記事では、AWS でCData JDBC Driver をホストし、Databricks でリアルタイムUKG Pro HCM のデータに接続して処理する方法を説明します。
最適化されたデータ処理が組み込まれたCData JDBC Driver は、リアルタイムUKG Pro HCM のデータを扱う上で比類のないパフォーマンスを提供します。UKG Pro HCM に複雑なSQL クエリを発行すると、ドライバーはフィルタや集計などのサポートされているSQL 操作をUKG Pro HCM に直接プッシュし、サポートされていない操作(主にSQL 関数やJOIN 操作)は組み込みSQL エンジンを利用してクライアント側で処理します。組み込みの動的メタデータクエリを使用すると、ネイティブデータ型を使ってUKG Pro HCM のデータを操作・分析できます。
CData JDBC Driver をDatabricks にインストール
Databricks でリアルタイムUKG Pro HCM のデータを操作するには、Databricks クラスターにドライバーをインストールします。
- Databricks の管理画面に移動し、対象のクラスターを選択します。
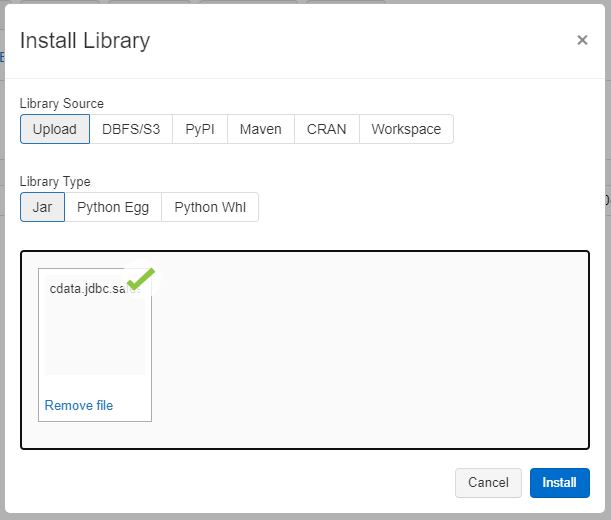
- Libraries タブで「Install New」をクリックします。
- Library Source として「Upload」を選択し、Library Type として「Jar」を選択します。
- インストール場所(通常はC:\Program Files\CData[product_name]\lib)からJDBC JAR ファイル(cdata.jdbc.api.jar)をアップロードします。
ノートブックでUKG Pro HCM のデータにアクセス:Python
JAR ファイルをインストールしたら、Databricks でリアルタイムUKG Pro HCM のデータを操作する準備が整いました。ワークスペースに新しいノートブックを作成します。ノートブックに名前を付け、言語としてPython を選択し(Scala も利用可能)、JDBC ドライバーをインストールしたクラスターを選択します。ノートブックが起動したら、接続を設定し、UKG Pro HCM をクエリして、基本的なレポートを作成できます。
UKG Pro HCM への接続を設定
JDBC Driver クラスを参照し、JDBC URL で使用する接続文字列を構築してUKG Pro HCM に接続します。また、JDBC URL でRTK プロパティを設定する必要があります(Beta ドライバーを使用している場合を除く)。このプロパティの設定方法については、インストールに含まれるライセンスファイルを参照してください。
ステップ1:接続情報
driver = "cdata.jdbc.api.APIDriver"
url = "jdbc:api:RTK=5246...;Profile=C:\profiles\UKGProHCM.apip;AuthScheme=Basic;User=your_username;Password=your_password;ProfileSettings='Host=yourcompany.ultipro.com;CustomerAPIKey=your_customer_api_key';"
組み込みの接続文字列デザイナー
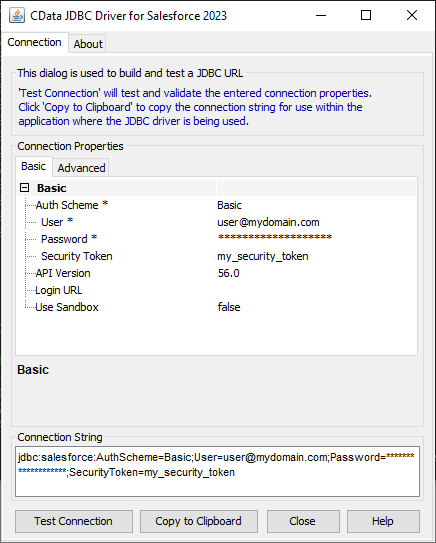
JDBC URL の作成をサポートするために、UKG Pro HCM JDBC Driver に組み込まれている接続文字列デザイナーが使用できます。JAR ファイルをダブルクリックするか、コマンドラインからJAR ファイルを実行します。
java -jar cdata.jdbc.api.jar
接続プロパティを入力し、接続文字列をクリップボードにコピーします。
まず、Profile 接続プロパティをディスク上の UKGProHCM プロファイルの場所に設定します(例:C:\profiles\UKGProHCM.apip)。次に、ProfileSettings 接続プロパティを UKGProHCM の接続文字列に設定します(以下を参照)。
UKGProHCM API プロファイル設定
UKG Pro HCM では、Basic 認証とカスタマー API キーを組み合わせて API へのアクセスを認可します。接続には、UKG Pro HCM の認証情報と、UKG が発行したカスタマー API キーが必要です。
認証するには、以下の接続プロパティを設定します。
- AuthScheme:Basic に設定します。
- User:UKG Pro HCM のユーザー名に設定します。
- Password:UKG Pro HCM のパスワードに設定します。
- ProfileSettings:以下の項目をセミコロン区切りで指定します。
- Host:UKG Pro HCM テナントのホスト名(例:yourcompany.ultipro.com)。
- CustomerAPIKey:UKG のカスタマー API キー。各 API 呼び出しで US-CUSTOMER-API-KEY リクエストヘッダーとして渡されます。
カスタマー API キーの入手方法については、UKG Pro HCM の管理者にお問い合わせいただくか、UKG Developer Portal(https://developer.ukg.com)をご参照ください。
UKG Pro HCM のデータをロード
接続を設定したら、CData JDBC Driver と接続情報を使用して、UKG Pro HCM のデータをDataFrame としてロードできます。
ステップ2:データの読み取り
remote_table = spark.read.format ( "jdbc" ) \
	.option ( "driver" , driver) \
	.option ( "url" , url) \
	.option ( "dbtable" , "UserDetails") \
	.load ()
UKG Pro HCM のデータを表示
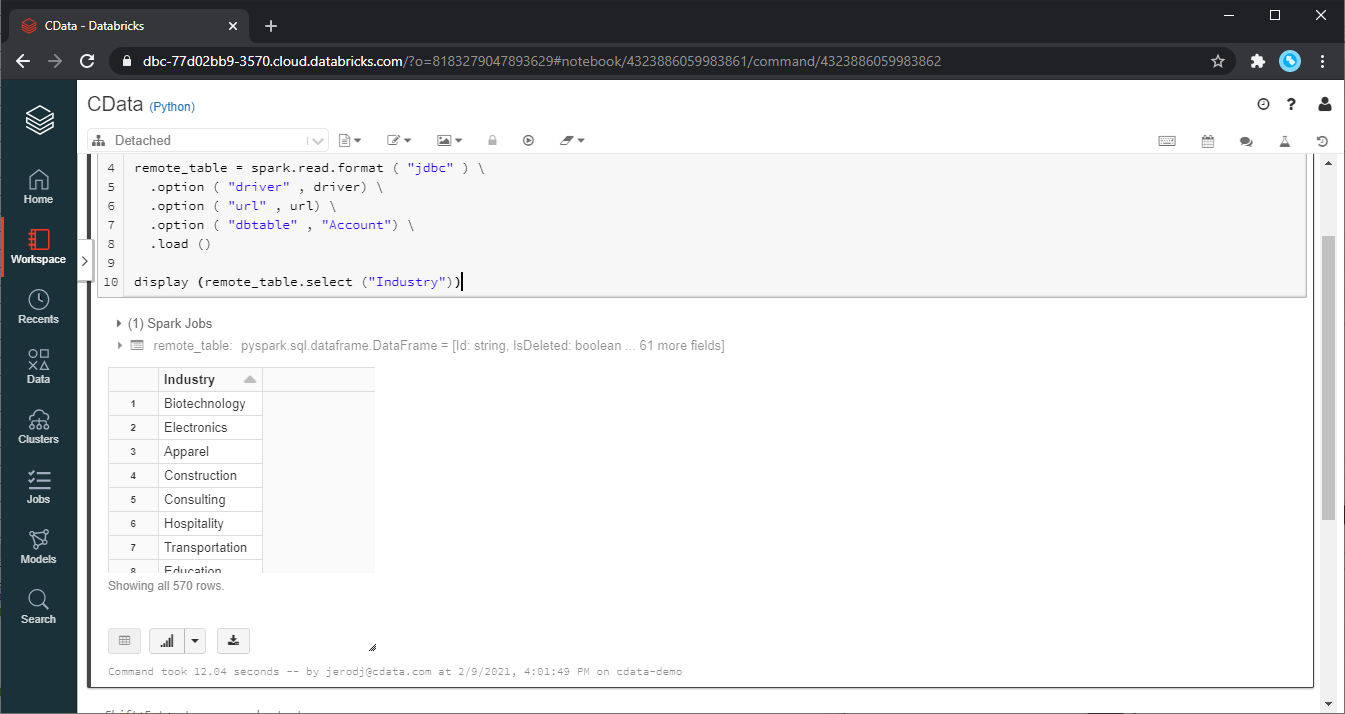
ロードしたUKG Pro HCM のデータをdisplay 関数を呼び出して確認します。
ステップ3:結果の確認
display (remote_table.select ("UserId"))
Databricks でUKG Pro HCM のデータを分析
Databricks SparkSQL でデータを処理するには、ロードしたデータをTemp View として登録します。
ステップ4:ビューまたはテーブルを作成
remote_table.createOrReplaceTempView ( "SAMPLE_VIEW" )
Temp View を作成したら、SparkSQL を使用してUKG Pro HCM のデータをレポート、ビジュアライゼーション、分析用に取得できます。
% sql

SELECT UserId, UserName FROM SAMPLE_VIEW ORDER BY UserName DESC LIMIT 5
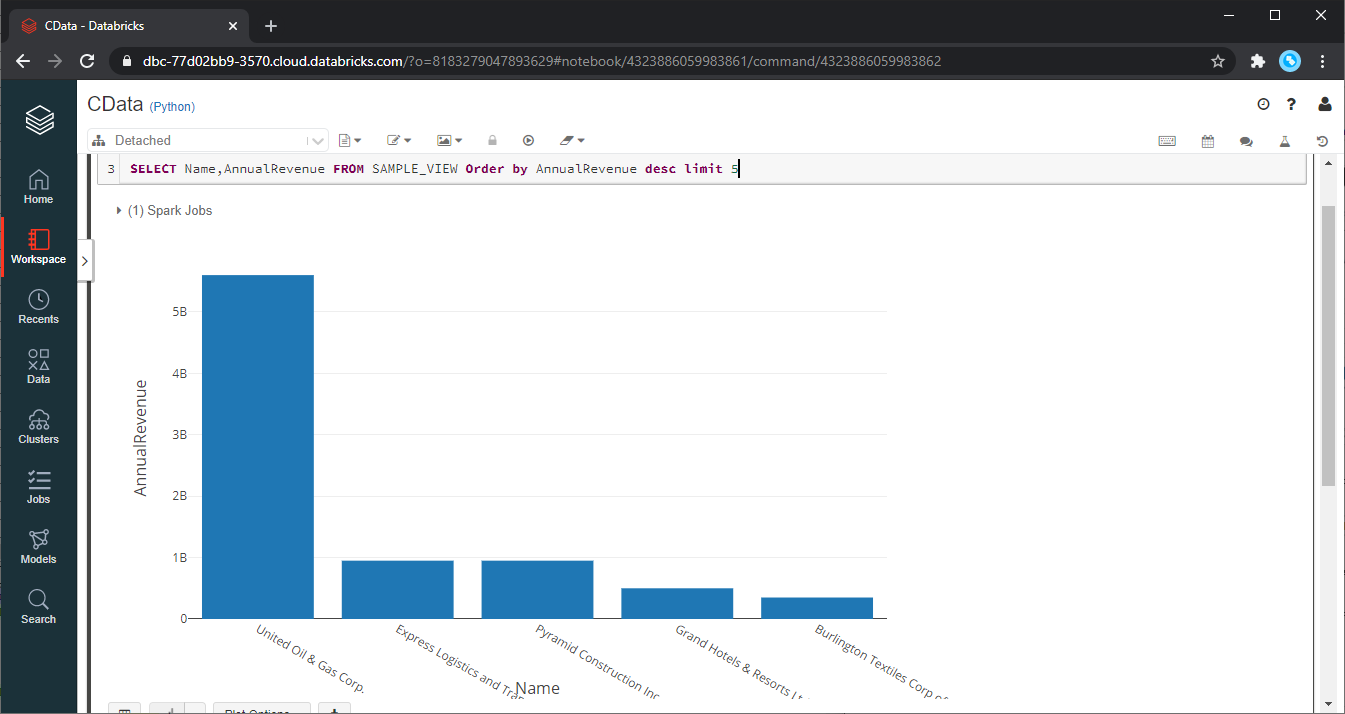
UKG Pro HCM からのデータは、対象のノートブックでのみ利用可能です。他のユーザーと共有したい場合は、テーブルとして保存します。
remote_table.write.format ( "parquet" ) .saveAsTable ( "SAMPLE_TABLE" )
CData API Driver for JDBC の30日間無償トライアルをダウンロードして、Databricks でリアルタイムUKG Pro HCM のデータの操作をはじめましょう。ご不明な点があれば、サポートチームにお問い合わせください。