



Azure Databricks でUKG Pro HCM のデータに接続してデータ処理を行う方法
Databricks は、Apache Spark によるデータ処理機能を提供するクラウドベースのサービスです。CData JDBC ドライバと組み合わせることで、Databricks を使用してリアルタイムUKG Pro HCM のデータのデータエンジニアリングとデータサイエンスを実行できます。この記事では、Azure で CData JDBC ドライバをホストし、Databricks からリアルタイムUKG Pro HCM のデータに接続してデータを処理する方法を説明します。
最適化されたデータ処理機能を組み込んだ CData JDBC ドライバは、リアルタイムUKG Pro HCM のデータとのインタラクションにおいて卓越したパフォーマンスを発揮します。UKG Pro HCM に対して複雑な SQL クエリを発行すると、ドライバーはフィルタや集計などのサポートされている SQL 操作を直接UKG Pro HCMにプッシュし、サポートされていない操作(主に SQL 関数や JOIN 操作)は組み込みの SQL エンジンを使用してクライアント側で処理します。動的メタデータクエリ機能により、ネイティブのデータ型を使用してUKG Pro HCM のデータの操作・分析が可能です。
CData JDBC ドライバを Azure にインストール
Databricks でリアルタイムUKG Pro HCM のデータを操作するには、Azure Data Lake Storage(ADLS)を通じてドライバーをインストールします。(以前のバージョンの記事で説明していた DBFS を介した接続方法は非推奨となっていますが、廃止日は公開されていません。)
- JDBC JAR ファイルを任意の Blob コンテナにアップロードします(例:「databrickslibraries」ストレージアカウントの「jdbcjars」コンテナ)。
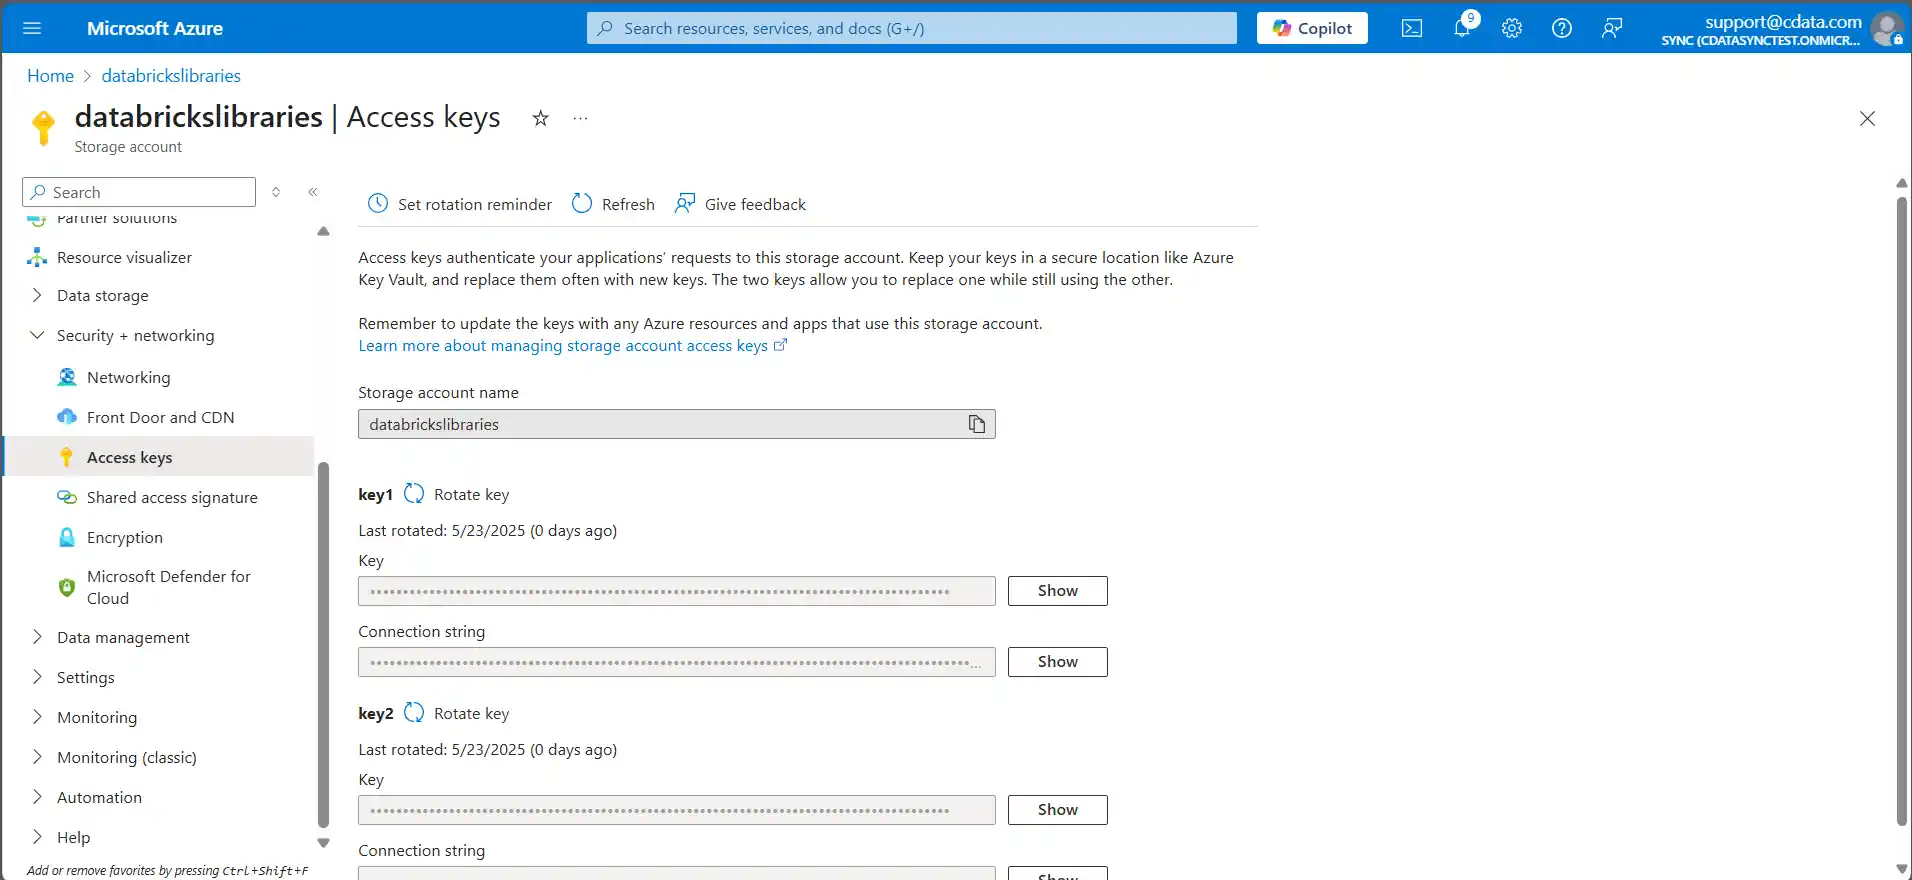
- ストレージアカウントから「セキュリティとネットワーク」を展開し、「アクセスキー」をクリックしてアカウントキーを取得します。使用するキーを表示してコピーしてください。
- コンテナに移動し、JAR を保存している特定のコンテナを開き、JDBC JAR ファイルのエントリを選択して JAR ファイルの URL を取得します。ファイルの詳細が開き、URL をクリップボードにコピーするボタンがあります。この値は以下のようになります(「blob」の部分はストレージアカウントの種類によって異なる場合があります):
https://databrickslibraries.blob.core.windows.net/jdbcjars/cdata.jdbc.salesforce.jar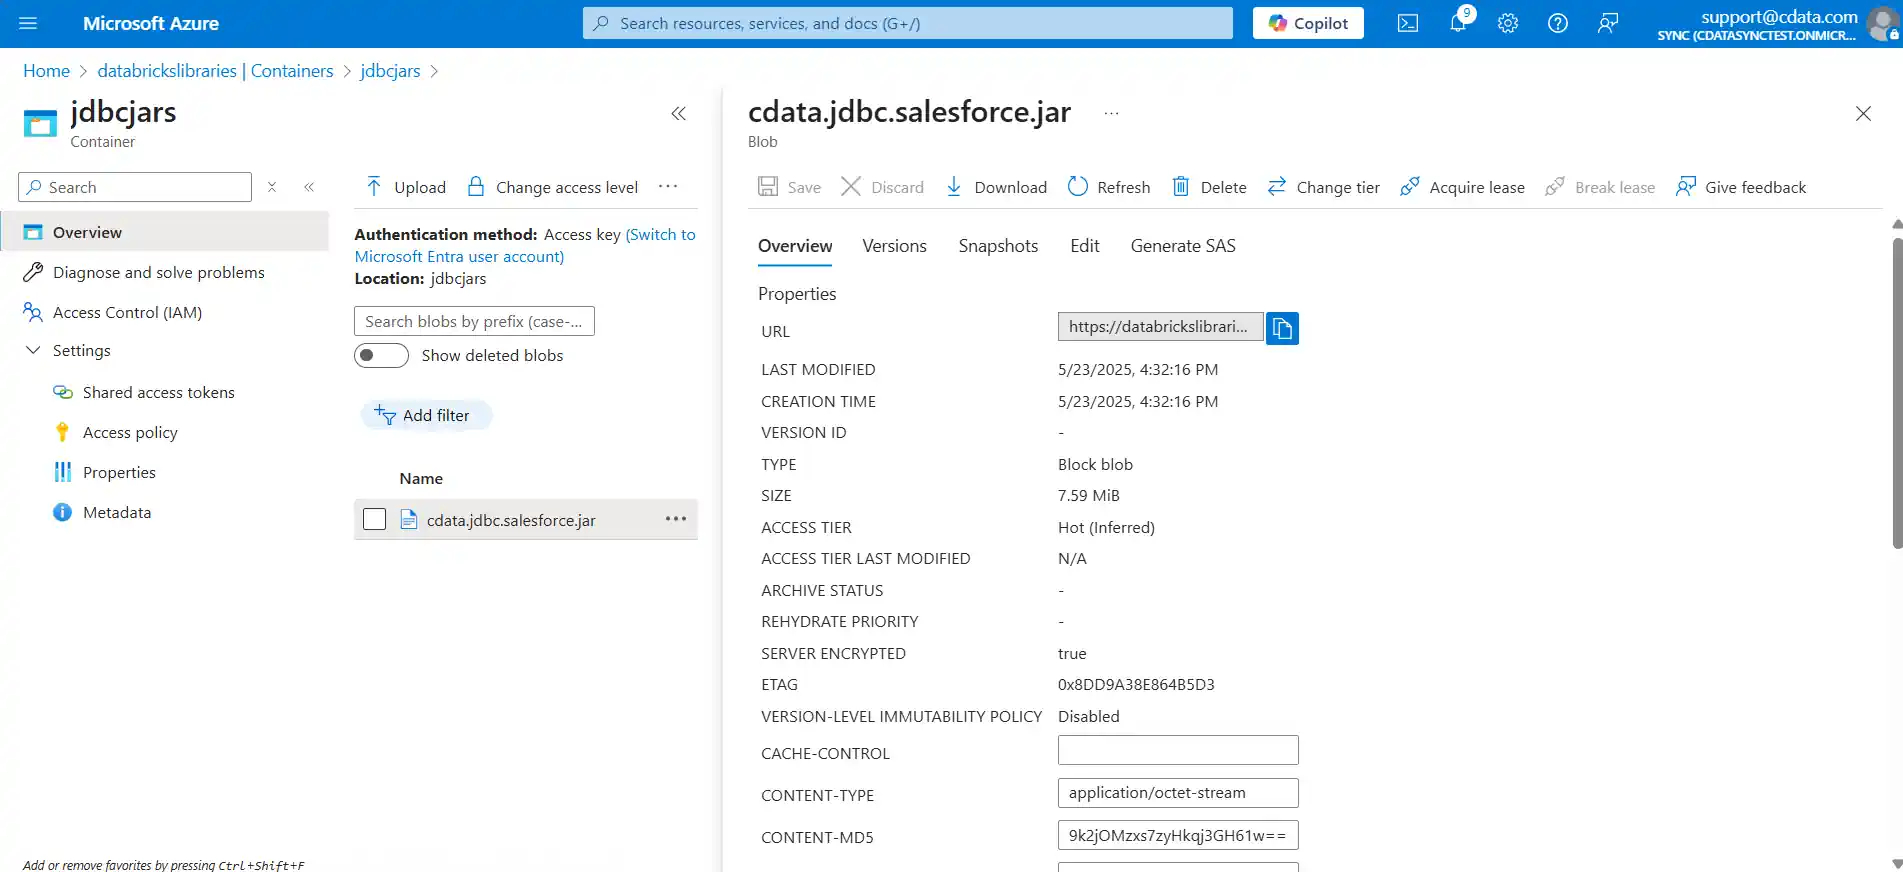
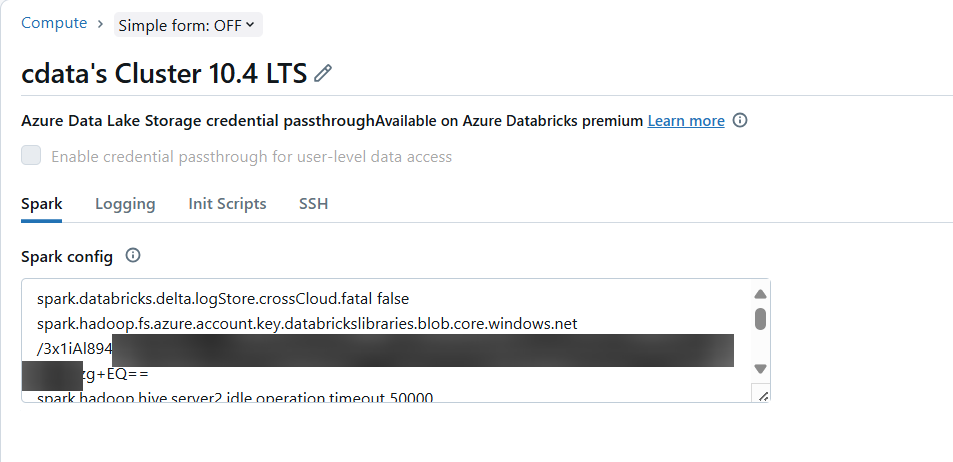
- Databricks クラスターの「Configuration」タブで「Edit」ボタンをクリックし、「Advanced options」を展開します。そこで、以下の Spark オプション(JAR URL のドメイン名から派生)に、コピーしたアカウントキーを値として追加し、「Confirm」をクリックします:
spark.hadoop.fs.azure.account.key.databrickslibraries.blob.core.windows.net
- Databricks クラスターの「Libraries」タブで「Install new」をクリックし、ADLS オプションを選択します。ドライバー JAR の ABFSS URL(これも JAR URL のドメイン名から派生)を指定し、「Install」をクリックします。ABFSS URL は以下のようになります:
abfss://[email protected]/cdata.jdbc.salesforce.jar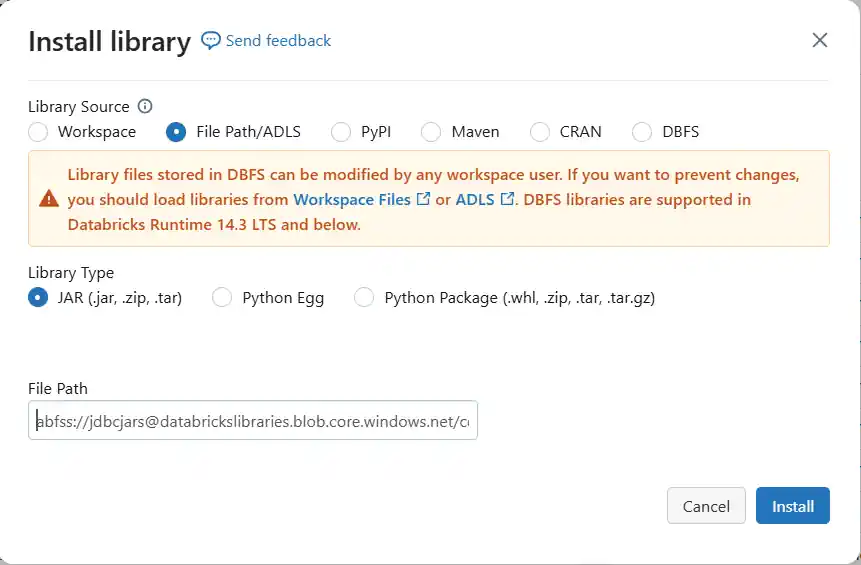
Databricks からUKG Pro HCMに接続
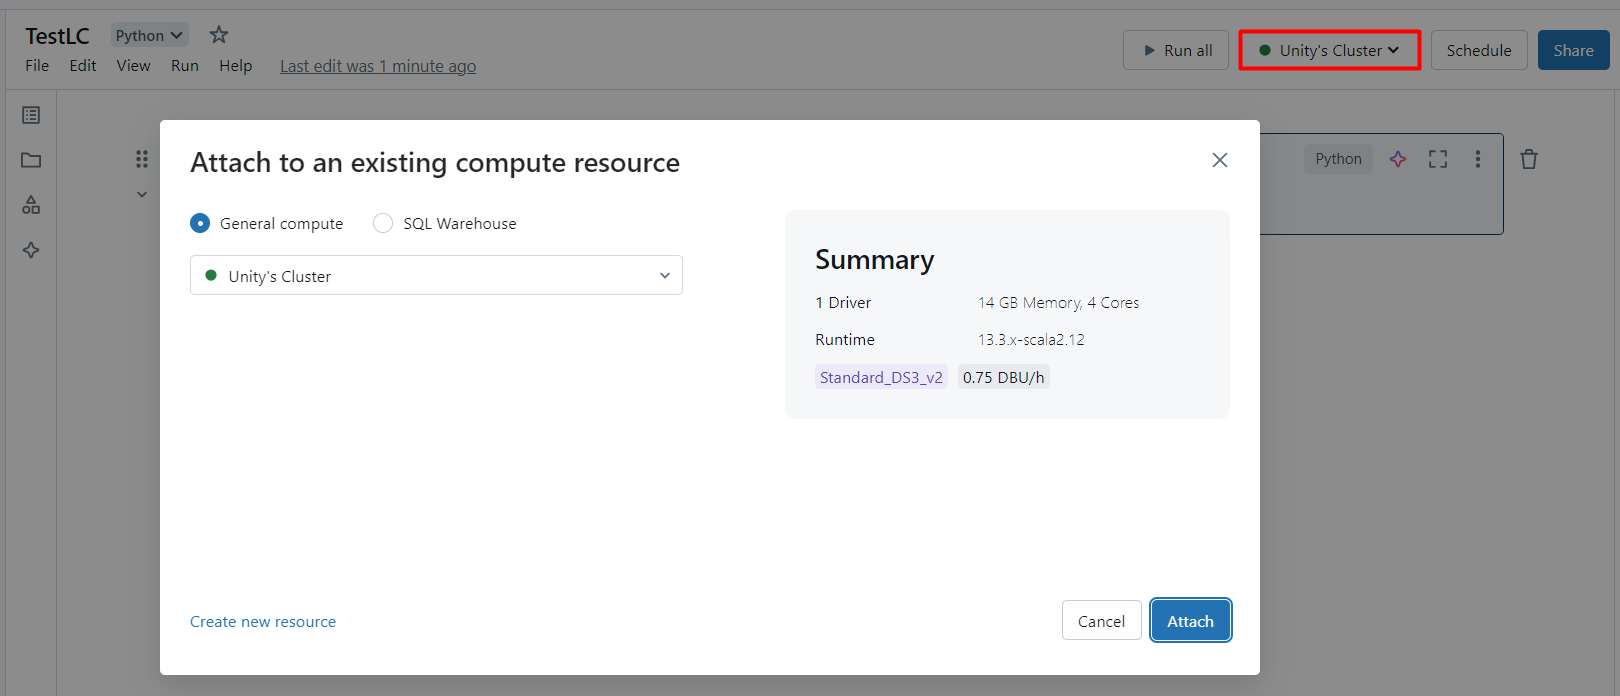
JAR ファイルがインストールされたら、Databricks でリアルタイムUKG Pro HCM のデータを操作する準備が整いました。まず、ワークスペースで新しいノートブックを作成します。ワークブックに名前を付け、言語として Python が選択されていることを確認し(デフォルトで選択されているはずです)、「Connect」をクリックして「General Compute」から JDBC ドライバーをインストールしたクラスターを選択します(デフォルトで選択されているはずです)。
UKG Pro HCMへの接続を設定
JDBC ドライバのクラスを参照し、JDBC URL で使用する接続文字列を構築してUKG Pro HCMに接続します。また、JDBC URL に RTK プロパティを設定する必要があります(Beta ドライバーを使用している場合を除く)。このプロパティの設定方法については、インストールに含まれるライセンスファイルを参照してください。
driver = "cdata.jdbc.api.APIDriver"
url = "jdbc:api:RTK=5246...;Profile=C:\profiles\UKGProHCM.apip;AuthScheme=Basic;User=your_username;Password=your_password;ProfileSettings='Host=yourcompany.ultipro.com;CustomerAPIKey=your_customer_api_key';"
組み込みの接続文字列デザイナー
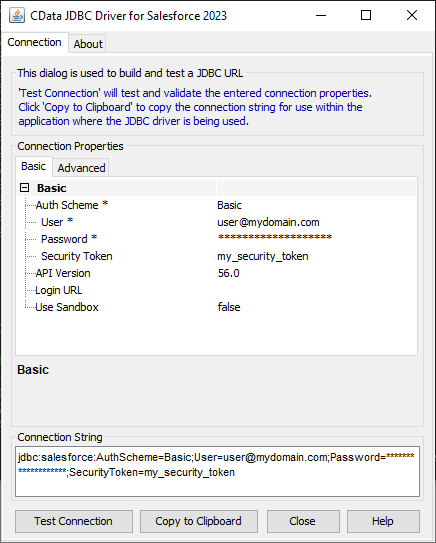
JDBC URL の構築には、UKG Pro HCM JDBC Driver に組み込まれている接続文字列デザイナーを使用できます。JAR ファイルをダブルクリックするか、コマンドラインから JAR ファイルを実行してください。
java -jar cdata.jdbc.api.jar
接続プロパティを入力し、接続文字列をクリップボードにコピーします。
まず、Profile 接続プロパティをディスク上の UKGProHCM プロファイルの場所に設定します(例:C:\profiles\UKGProHCM.apip)。次に、ProfileSettings 接続プロパティを UKGProHCM の接続文字列に設定します(以下を参照)。
UKGProHCM API プロファイル設定
UKG Pro HCM では、Basic 認証とカスタマー API キーを組み合わせて API へのアクセスを認可します。接続には、UKG Pro HCM の認証情報と、UKG が発行したカスタマー API キーが必要です。
認証するには、以下の接続プロパティを設定します。
- AuthScheme:Basic に設定します。
- User:UKG Pro HCM のユーザー名に設定します。
- Password:UKG Pro HCM のパスワードに設定します。
- ProfileSettings:以下の項目をセミコロン区切りで指定します。
- Host:UKG Pro HCM テナントのホスト名(例:yourcompany.ultipro.com)。
- CustomerAPIKey:UKG のカスタマー API キー。各 API 呼び出しで US-CUSTOMER-API-KEY リクエストヘッダーとして渡されます。
カスタマー API キーの入手方法については、UKG Pro HCM の管理者にお問い合わせいただくか、UKG Developer Portal(https://developer.ukg.com)をご参照ください。
UKG Pro HCM のデータの読み込み
接続を設定したら、CData JDBC ドライバと接続情報を使用してUKG Pro HCM のデータをデータフレームとして読み込むことができます。
remote_table = spark.read.format ( "jdbc" ) \
	.option ( "driver" , driver) \
	.option ( "url" , url) \
	.option ( "dbtable" , "UserDetails") \
	.load ()
UKG Pro HCM のデータの表示
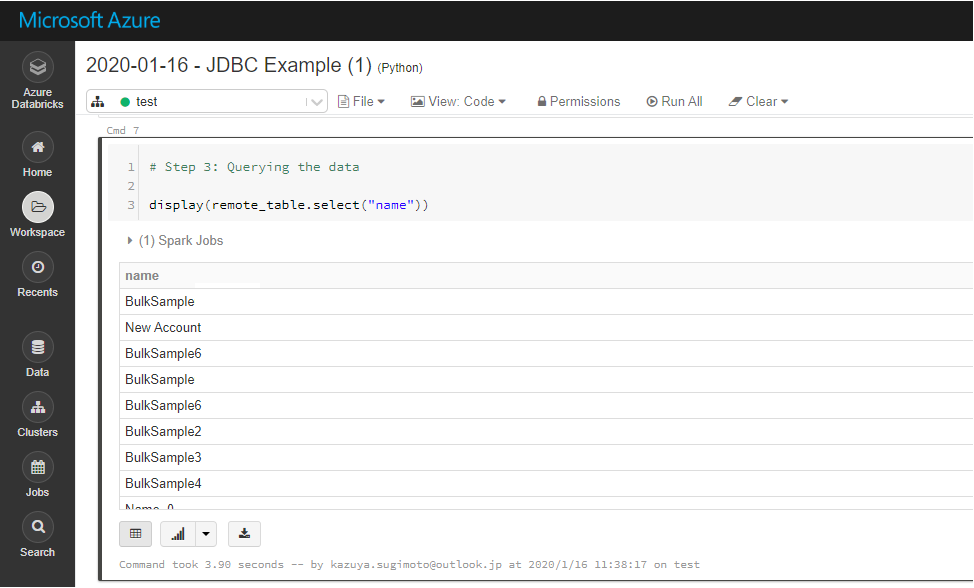
読み込んだUKG Pro HCM のデータを display 関数で確認してみましょう。
display (remote_table.select ("UserId"))
Azure Databricks でUKG Pro HCM のデータを分析
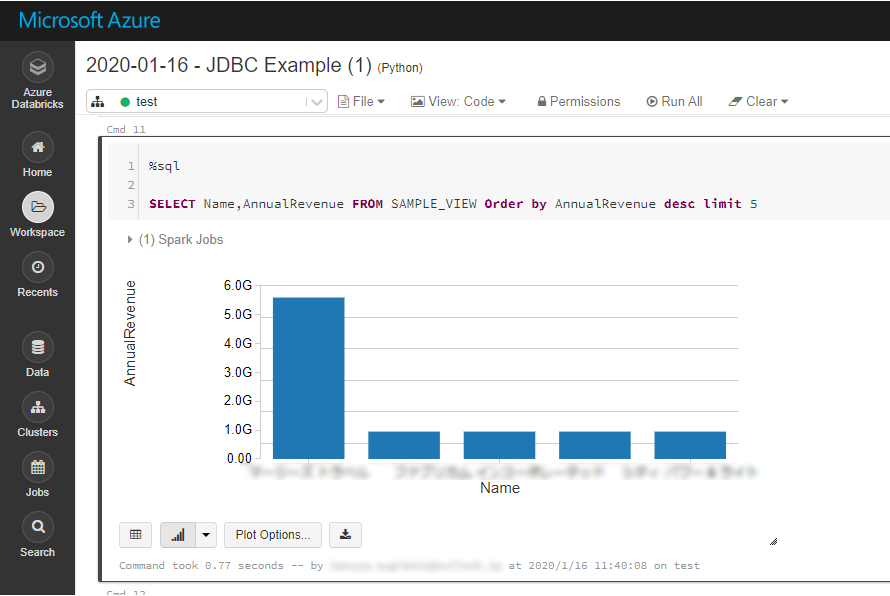
Databricks SparkSQL でデータを処理したい場合は、読み込んだデータを一時ビューとして登録します。
remote_table.createOrReplaceTempView ( "SAMPLE_VIEW" )
以下の SparkSQL で分析用のUKG Pro HCM のデータを取得できます。
result = spark.sql("SELECT UserId, UserName FROM SAMPLE_VIEW WHERE UserStatus = 'A'")
UKG Pro HCM からのデータは、対象のノートブック内でのみ利用可能です。他のユーザーと共有したい場合は、テーブルとして保存してください。
remote_table.write.format ( "parquet" ) .saveAsTable ( "SAMPLE_TABLE" )
CData API Driver for JDBC の30日間の無償トライアルをダウンロードして、Azure Databricks でリアルタイムUKG Pro HCM のデータを活用してみてください。ご不明な点があれば、サポートチームまでお気軽にお問い合わせください。