メールの下書きはAIに。会議の要約もAIに。アイデア出しだってAIに。生成AIは、すっかり仕事の「相棒」になりました。
では、その相棒に、自社のデータまで使わせていますか?たとえば「今四半期の売上見込みは?」「この顧客との過去の商談は?」と聞くだけで、社内のシステムから最新のデータを引いて答えてくれる。そんな使い方です。
「やりたいけれど、まだできていない」「試してみたけれど、うまくいかなかった」という声もよく聞きます。
なかなか前に進めない理由のひとつは、情報の多さかもしれません。生成AIの情報は次から次へと出てきて、とても追いきれない。MCP、AI Gateway……新しい言葉を目にするたびに、「結局、何から手をつければいいの?」と迷ってしまいますよね。
そこでこの記事では、生成AIと自社データの活用でぶつかる「5つの壁」とその乗り越え方という切り口で、さまざまな情報を整理しました。概要はこの記事でつかみ、詳しく知りたいところは、各章の最後にある「もっと詳しく」から関連記事や資料をたどってみてください。
自分がいまどの壁の前にいるかを確認して、気になるところから読んでみてください。
生成AI×自社データ活用の「5つの壁」
生成AIを業務で本格的に活かそうとすると、多くの企業がおおむね次の順番で、5つの壁にぶつかります。
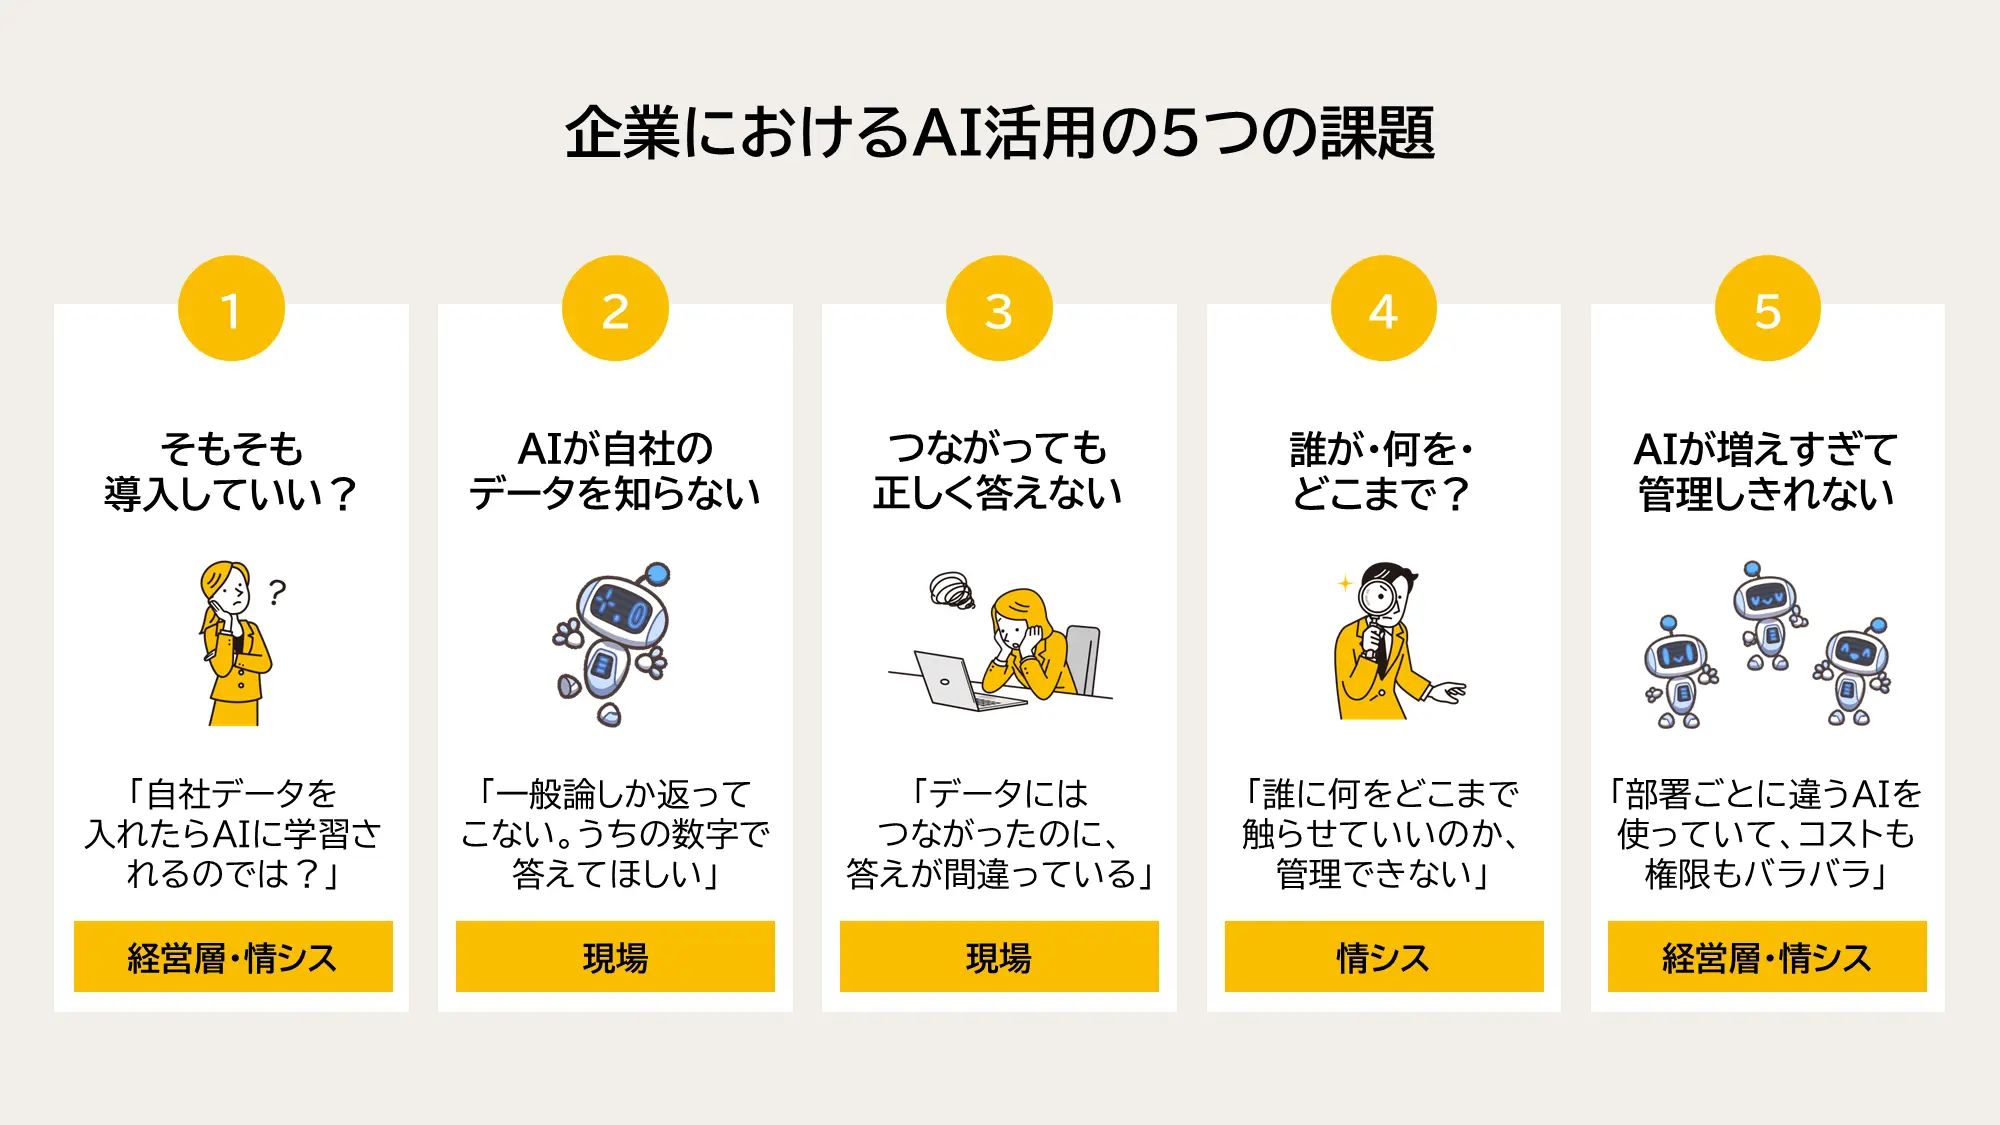
| 壁 | よくある声 | 悩む人 |
|---|
1 | そもそも導入していい? | 「自社データを入れたら、AIに学習されるのでは?」 | 経営層・情シス |
2 | AIが自社のデータを知らない | 「一般論しか返ってこない。うちの数字で答えてほしい」 | 現場 |
3 | つながっても、正しく答えない | 「データにはつながったのに、答えが間違っている」 | 現場 |
4 | 誰が・何を・どこまで? | 「誰に何をどこまで触らせていいのか、管理できない」 | 情シス |
5 | AIが増えすぎて管理しきれない | 「部署ごとに違うAIを使っていて、コストも権限もバラバラ」 | 情シス・経営層 |
どこから読めばいい?
現場でAIを活用したい方:壁②と壁③から
情シス・セキュリティ担当の方:壁①と壁④から
AI活用の全体戦略を考えている方:壁⑤から
もちろん、最初から順番に読んでいただくと、全体の流れがつかめます。それでは、1つずつ見ていきましょう。
壁① そもそも生成AIを導入していい?
生成AIの業務利用を提案したとき、上司や情シスからこう言われた経験はないでしょうか。
担当者:「案件データをAIで分析して、提案書づくりを自動化したいんです」
上司:「それ、データが外に出たり、AIに学習されたりしないの?」
担当者:「……確認します」
こうしてプロジェクトが止まってしまうのは、よくある話です。ここでは、特によく出る2つの疑問に答えます。
Q1. 入力したデータが、AIの学習に使われてしまうのでは?
A. 企業向けの契約(エンタープライズ契約)では、学習には使われません。
まず押さえておきたいのは、「学習」と「推論」は別物だということです。
「入力したデータが学習に使われる」というイメージは、個人向けの無料サービスから来ていることが多いです。個人向けの無料サービスは、初期設定では学習に使われることがあります(オプトアウトは可能)。
一方、企業向けの契約では、初期設定で学習には使われず、しかもそれが契約上の義務として明記されています。Microsoft、Google、Anthropic、OpenAIといった主要ベンダーは、いずれも契約書や利用規約にこの点を書いています。
各社の該当条項は、下の「もっと詳しく」で紹介している実践ガイドに比較表としてまとめています。上司や情シスへの説明資料としてご活用ください。
Q2. 入力したデータが、AI企業のサーバーに溜め込まれるのでは?
A. データは回答を作るために一時的に送られるもので、通信も暗号化されています。
社内のデータやプロンプトは、TLSで暗号化された通信でAIに一時的に送られ、返ってくるのはテキストの回答です。通信の安全性という点では、普段使っているメールやクラウドサービスと同じ水準の暗号化が使われています。
なお、不正利用の監視などを目的とした一時的な保持の扱いは、サービスや契約によって異なります。導入前には、利用するサービスのデータ処理契約(DPA)などで条件を確認しておくと安心です。
ここまで確認できれば、「漠然と怖いから使わない」から「条件を確認したうえで、どう使うかを考える」へと議論を進められます。
▶ もっと詳しく
壁② AIが自社のデータを知らない
無事に生成AIを導入できたとします。ところが、しばらく使ってみると「思ったほど業務が変わらない」と感じ始めることがあります。
これは珍しいことではありません。2025年8月にMITが発表したレポートでは「企業における生成AIのパイロットの95%が失敗している」という数字が話題になりました(この数字の正確さには議論もあります)。うまくいかない理由はいろいろありますが、その大きな1つが、この壁です。
ChatGPTやClaudeは、一般的な知識についてはとても賢いです。でも、あなたの会社の売上や顧客、在庫のことは知りません。
だからといって、毎回Excelからデータをコピーして貼り付けるのは手間がかかりますし、貼った時点でデータは古くなっていきます。必要なデータが複数のシステムに分かれていれば、なおさら大変です。
CDataが200名以上のデータ・AIリーダーに行った調査では、次のような結果が出ています。
AI向けの現在のデータ基盤に満足している企業は、わずか6%
AIチームの71%が、実装時間の4分の1以上をデータ統合の作業に費やしている
46%の組織が、1つのAIユースケースで6つ以上のデータソースへのリアルタイムアクセスを必要としている
調査から見えてきた結論は、「企業のAI活用を制約しているのは、もはやAIモデルの性能ではなく、データとのつながりだ」ということでした。
MCPの登場で「つなぐ」が一気に簡単に
この壁を大きく動かしたのが、MCP(Model Context Protocol) です。
MCPは、AIと業務システムをつなぐための共通の規格です。よく「AI版のUSB-C」と例えられます。USB-Cがあれば、メーカーが違ってもケーブル1本でパソコンと周辺機器をつなげるように、MCPに対応していれば、さまざまなAIツールとさまざまな業務システムを同じ方法でつなげられます。
MCPの登場によって、AIが社内のデータを参照して答える仕組みを、共通の方法でずっと簡単に作れるようになりました。上記の調査でも、ソフトウェア企業の76%がMCPをすでに検討、または実装していると答えています。
(MCPについてもう少し知りたい方は、記事末尾の「おまけ:MCPとは?」をご覧ください)
CDataのアプローチ:CData Connect AI
CDataでは、MCPで業務データとAIをつなぐためのマネージドMCPプラットフォーム 「CData Connect AI」 を提供しています。
Salesforce、kintone、SAP、Snowflake、SQL Serverなど、350以上のデータソースにノーコードで接続できます
ChatGPT、Claude、Microsoft Copilotなど、普段使っているAIツールからそのまま利用できます
データをコピーせず、元のシステムにリアルタイムで問い合わせるので、いつでも最新のデータで答えられます
MCPサーバーの構築や運用は、CDataがクラウドで担います
▶ もっと詳しく
壁③ つながっても、正しく答えない ― 精度とコストの問題
MCPでAIと業務データがつながりました。これで一件落着……かと思いきや、次の壁が待っています。
「接続できること」と「正しい答えが返ってくること」は、別の問題なのです。
先ほどの調査レポートでも、MCPは便利な一方で、データの定義の不一致や、データの意味の情報が足りないといった、もともとある課題をかえって浮き彫りにすることがある、と指摘されています。
実際に起きる4つの失敗
CDataでは、5種類のMCPサーバーを4つの業務システム(CRM、プロジェクト管理、データウェアハウス、ERP)につなぎ、計378回のテストを行いました。その中で、CData以外のMCPサーバーでは次のような失敗がよく起きていました。
失敗の種類 | AIへの依頼 | 実際に起きたこと | 業務への影響 |
|---|
日付の解釈ミス | 「今四半期にクローズする商談を出して」 | 日付で絞り込まず、すべての商談を返した | 営業チームが、関係ない商談の確認に時間を取られる |
条件の組み合わせミス | 「Aさん担当で、ステータスがTo Doの課題を出して」 | ステータスの条件を無視し、Aさんの課題を全部返した | マネージャーが、業務量を正しく把握できない |
更新の失敗 | 「この課題をIn Progressに移して」 | 更新しようとしたが、ワークフローのルールに引っかかって失敗した | 作業が止まり、人が手で直す必要が出る |
テーブル・項目の取り違え | 「金額の大きい注文トップ10を出して」 | 違うテーブルや項目を使って答えた | 間違った集計をもとに、経営判断をしてしまう |
怖いのは、こうした間違いがそれらしい顔をして返ってくることです。明らかなエラーなら気づけますが、もっともらしい間違いは見過ごされてしまいます。
100回あたりの間違いは?
テストの結果、MCPサーバーによって精度に大きな差が出ました。
MCPサーバーの種類 | 正解数 | 精度 | 100回あたりの間違い(目安) |
|---|
CData Connect AI | 67/68 | 98.5% | 約1.5回 |
CRMベンダー公式のMCP | 15/20 | 75.0% | 25回 |
ユニファイドAPI型 | 30/40 | 75.0% | 25回 |
MCPゲートウェイ型 | 29/40 | 72.5% | 約28回 |
iPaaS型 | 47/80 | 58.75% | 約41回 |
※ 2025年10〜12月にCDataが社内で実施したベンチマーク。AIモデルはGPT-5を使用。回答は「正解」か「不正解」かの二択で判定しています。テストの条件や評価方法の詳細は、ホワイトペーパーで紹介しています。
※ 100回あたりの間違いは、精度から換算した目安です。
CData Connect AIの間違いは68回中1回だけでした。一方、ほかのMCPサーバーは100回あたり25〜41回、つまり少なくとも4回に1回は間違える計算です。
そんなAIに、仕事を安心して任せられるでしょうか。ホワイトペーパーでは、用途ごとに求められる精度の目安を次のように整理しています。
用途 | 求められる精度の目安 | 理由 |
|---|
調べものの補助(コパイロット) | 85%超 | 人が内容を確認してから使う |
意思決定の支援 | 95%超 | 判断がデータの正しさに左右される |
自律型のAIエージェント | 98%超 | 人の確認を経ずに実行される |
AIの使い方が「人の補助」から「AIエージェントが自分で動く」へと移るほど、求められる精度は上がっていきます。
なぜConnect AIの精度は高いのか
ポイントは、Connect AIがデータの「意味」を理解したうえでAIにデータを渡している点です。大きく3つあります。
データの意味やつながりを理解している
「商談」と「取引先担当者」がどうつながっているか、会計年度の区切りはどこか、優先度の「Highest」と「High」は別物か、といった、システムごとの細かいルールを理解しています。
複雑な条件も正確に組み立てられる
AIからの依頼を、データベースでおなじみのSQLライクな操作に変換して実行します。そのため「Acme社の商談のうち、金額が5万ドル超で、今四半期にクローズするもの」のような、複数の条件や日付の計算を含む依頼にも対応できます。
長年のコネクタ開発の蓄積がある
CDataは長年、さまざまな業務システムとの接続ツール(コネクタ)を作り続けてきました。CRMの商談ステージ、プロジェクト管理ツールのスプリント、ERPの勘定科目の階層など、システムごとの「クセ」を熟知しています。
「高いモデルを使えば、精度の問題は解決する?」
ここでよく出るのが、「もっと賢い(高い)AIモデルを使えばいいのでは?」という疑問です。CDataでは、この点も検証しました。
22種類のAIモデル(低価格なものから最上位のものまで)を使い、CRM・データウェアハウス・ITSMのデータを対象に、計1,034回のテストを行いました。条件は2つです。
どちらの条件も、つないでいるシステムもプロンプトも同じです。違うのは、AIが使うツールに業務ルールが組み込まれているかどうかだけです。
結果は、はっきり分かれました。
| 条件A:生のデータに直接 | 条件B:業務ルール入りのツール経由 |
|---|
読み取りの正確さ | 22モデルすべてが正解できず、最高でもF1スコア0.45。18モデルは0点 | 17モデルが満点(F1スコアの中央値1.00) |
|---|
書き込みの安全性 | 22モデル中14モデルが、少なくとも1回は対象外のデータを書き込んだ(最悪のケースで628行) | 対象外のデータへの書き込みはゼロ |
|---|
※ F1スコアは、AIが出した答えが正解とどれだけ一致しているかを0〜1で表す指標です。
つまり、最上位のAIモデルでも、生のデータを渡すだけでは正しく答えられませんでした。 逆に、業務ルールを組み込んだツールを通せば、低価格なモデルでも最上位モデルと同じ正解にたどり着けます。
そして、ここで大きく差がつくのがコストです。同じ正解を出したモデルの間で、1回の正解にかかるコストには最大178倍の差がありました(最も安いモデルで約0.0009ドル、最も高いモデルで約0.157ドル)。
精度と安全性を担保する仕組みがあれば、モデル選びは「どれが一番賢いか」ではなく「どれが一番安く済むか」で決められるようになる、ということです。この考え方は、後で出てくる壁⑤にもつながります。
▶ もっと詳しく
壁④ 誰が・何を・どこまで? ― セキュリティとガバナンス
正しく答えられるようになったら、いよいよ本格的な運用です。ここで、情シスの方が必ず気にするのがセキュリティとガバナンスです。
生成AIは、指示を「解釈」して動きます。たとえば営業担当者が「先月から動きのない案件を整理して」とAIに頼んだとします。AIが「整理=進展のない案件を失注扱いにする」と解釈し、他人の商談まで一括で書き換えてしまう、ということが起こりえます。
大切なのは、AIが何かをしたくても、物理的にできない設計にしておくことです。
Connect AIの「5層のアクセス制御」
Connect AIでは、5つの層を重ねて、AIに「やってほしいことだけをやらせる」環境を作れます。
層 | 何を決めるか | 内容 |
|---|
第1層 | 元のシステムの権限 | SalesforceなどのシステムでアクセスできないデータはConnect AI経由でもアクセスできない。既存の権限がそのまま効く |
第2層 | 誰として接続するか | 全員共通のアカウントで接続するか、ユーザーごとに本人の権限で接続するかを選べる |
第3層 | 何ができるか | 「参照」「追加」「更新」「削除」などの操作を、ユーザーや接続先ごとに許可・禁止できる |
第4層 | 何を見せるか | AIに見せるテーブルや項目を絞り込める。個人情報の列を除いた「AI専用のビュー」も作れる |
第5層 | AIにどんな道具を渡すか | AIが使えるツールを管理者が選べる。更新用のツールを渡さなければ、どんな指示を受けてもAIは更新できない |
まずは「参照のみ」の状態から始めて、必要に応じて少しずつ権限を広げていくのが安全な進め方です。
そのほかのセキュリティの仕組み
5層の制御に加えて、情シスの方がセキュリティレビューで確認したいポイントにも対応しています。
データを保存しない:Connect AIはデータをコピーも保存もせず、問い合わせのたびに元のシステムへリアルタイムでアクセスします
監査ログ:誰が、いつ、どのツールで、どのデータにアクセスしたかを記録します。権限不足で拒否されたアクセスも残ります
既存の認証基盤との連携:Microsoft Entra ID、Okta、Google WorkspaceなどのSSOに対応しています
暗号化:通信はTLS 1.3、保管する認証情報・ログなどはAES-256で暗号化しています
第三者認証:SOC 2 Type IIの監査を完了し、ISO/IEC 27001:2022にも準拠しています
社内システムにも対応:社内(オンプレミス)のシステムも、ファイアウォールに穴を開けずに安全に接続できます
▶ もっと詳しく
壁⑤ AIが増えすぎて管理しきれない ― 複数LLM時代への対応
精度もセキュリティも整い、AIの業務活用が軌道に乗ってきました。これで落ち着く……かと思いきや、利用が広がるにつれて、新しい課題が見えてきます。
「社内で使っているAIが、いつの間にか増えすぎている」 という課題です。
なぜ、複数のAIモデルを使うようになるのか
これまでは「全社でChatGPTを使う」のように、1つのAIモデルを使うケースが中心でした。しかし最近は、複数のAIモデル(LLM)を使い分ける企業が増えています。理由は主に3つです。
用途に合わせて使い分けたい:簡単な作業は安くて速いモデルに、難しい作業は高性能なモデルに任せたい
特定のベンダーに依存したくない:1社のサービスが止まったり、値上げされたりしたときのリスクを減らしたい
データを置く地域を選びたい:規制や社内ルールに合わせて、データを処理するリージョンを選びたい
実際、CDataの調査でも、企業のAI活用は1つのツールにまとまっていません。76%の組織がOpenAIやClaude、Geminiといった企業向けLLMを使う一方で、BIツールに組み込まれたAIや、エージェントの基盤、カスタマーサービス用のAIなども並行して使われています。
複数のAIを使うと、何が困るのか
AIが増えると、それぞれがバラバラにデータへつながり、バラバラに管理されることになります。すると、次のような問題が出てきます。
コスト:どの部署の、どのAIが、いくら使っているのか分からない
障害対応:1つのAIサービスが止まると、そのAIを使う業務も止まってしまう
ガードレール:AIごとに権限やルールを設定し直す必要があり、抜け漏れが生まれる
監査:AIが何をしたのかを、まとめて追いかけられない
そこで登場するのが「AI Gateway」
この課題を解決する考え方が、AI Gateway です。
AI Gatewayは、AIを使う側(アプリやAIエージェント)と、AIが使うもの(AIモデル、ツール、業務データ)の間に立つ「関所」のような仕組みです。AIへのリクエストはすべてここを通り、通してよいか、どのモデルやツールへ向かわせるかが決まります。そのため、ルールを1か所で決めれば、すべてのAIにまとめて適用できます。
AI Gatewayは、一般に次の2つの役割を担います。
この仕組みによって、先ほどの4つの問題に、まとめて手を打てます。
コスト:チームやエージェントごとに、利用量や予算の上限を設ける
障害対応:1つのAIサービスが止まっても、別のモデルに切り替える
ガードレール:誰が、どのAIで、どのデータを使えるかを一元管理する
監査:すべてのやり取りを記録する
Gartnerは、複数のAIモデルを使う開発チームのうちAI Gatewayを使う割合が、2025年の約25%から2028年には70%に達すると予測しています(AI Gatewayとは?AIコスト・権限を一元管理する仕組みを徹底解説 より)。
問題は、振り分けた「先」で何が起きるか
ここまでの機能は、多くのAI Gatewayが備える、いわば基本機能です。ただ、壁③を思い出してください。AIが正しく答えられなかった原因は、データの「意味」が伝わっていないことでした。リクエストを適切なモデルやツールに振り分けても、その先でデータの意味が分からなければ、答えは間違ったままです。
つまり、AI Gatewayの価値を左右するのは、振り分けの機能そのものより、その先にデータの意味を理解する層(コンテキスト)があるかどうかです。壁③のベンチマークで「MCPゲートウェイ型」の精度が伸びなかったのも、この層を持たないためです。
逆に、この層があれば、安いモデルでも高いモデルと同じ正解を出せます。AI Gatewayで精度と安全性を担保できれば、用途ごとに一番コストの低いモデルを選ぶ、という運用が現実的になります。
CDataの答え:CData Connect AI Gateway
CDataは2026年10月1日、Connect AIを進化させた 「CData Connect AI Gateway」 を発表し、アーリーアクセスプログラムを開始しました。
Connect AI Gatewayは、まったく新しい別のサービスではありません。壁②〜④で紹介してきたCData Connect AIの延長線上にあるものです。業務システムへの接続、データの意味の理解、アクセス制御といったConnect AIの土台はそのままに、管理の対象を業務データだけでなく、AIモデルやAIエージェントにまで広げました。
こうしてConnect AI Gatewayは、AIモデル、MCPサーバー、AIエージェントを1か所に登録し、それぞれが何をしてよいかのルールを決められる「AIとビジネスシステムの間の、ただ1つの管理ポイント」になっています。
たとえば、「Q3のパイプラインカバレッジは?」という質問を考えてみましょう。言葉は単純ですが、「Q3」が何月から何月を指すのか、「パイプラインカバレッジ」を自社でどう計算するのかは、会社によって違います。Connect AI Gatewayは、こうした自社ならではの定義を踏まえて質問の意味を補い、データと「解釈に必要な意味」をセットでAIに渡します。
主な特長は次の5つです。
数百の業務システムに、すぐつながる:CDataのコネクタを通じて、数百の業務システムをAIから使えます
社内の「意味」をAIに伝える:社内の指標の定義や用語をAIに渡し、たとえば経理と営業で「売上」の解釈がずれるのを防ぎます
本人の権限のまま、安全に:AIエージェントも、利用者本人と同じ権限で動きます。元のシステムで設定した権限が、そのまま効きます
ムダなコストを抑える:必要なデータだけをAIに渡すので、トークンのムダを減らせます。AIの利用状況も1か所で把握できます
特定のAIに縛られない:定義や文脈をモデルの外で管理するので、AIモデルを切り替えても同じ前提を引き継げます
現在、アーリーアクセスプログラムの参加企業を募集しています。いち早く試してみたい方は、アーリーアクセスの申込みフォームからどうぞ。
▶ もっと詳しく
まとめ:5つの壁と乗り越え方
最後に、この記事の内容を1枚の表にまとめます。
あなたへのおすすめ
現場でAIを活用したい方:まずは壁②と壁③の記事から。無料トライアルで、普段使っているシステムを1つつないで試してみるのがおすすめです
情シス・セキュリティ担当の方:壁①と壁④の記事、そしてセキュリティベストプラクティスガイドを、社内レビューのチェックリストとしてお使いください
AI活用の全体戦略を考えている方:壁⑤の記事と、AI Gatewayの学習シリーズで、これからのAI基盤の姿をつかんでください。Connect AI Gatewayのアーリーアクセスも受付中です
生成AIと自社データの活用は、一気に完成させるものではなく、壁を1つずつ越えながら育てていくものです。この記事が、みなさんの「次の一歩」を考えるきっかけになればうれしいです。
おまけ:MCPとは?
MCP(Model Context Protocol) は、AIが外部のツールやデータにアクセスするための共通の規格です。2024年にAnthropic社が公開し、現在では多くのAIツールが対応しています。その後、MCPはLinux Foundation傘下の団体に移管され、特定の企業のものではない、業界共通の規格になっています。
MCP以前は、AIと業務システムをつなぐには、システムごとに個別の連携を作る必要がありました。AIツールが3つ、業務システムが5つあれば、最大で15通りの連携が必要になる計算です。
MCPでは、AIツール側も業務システム側も「MCPという共通の形」に対応すればよいので、組み合わせの数だけ連携を作る必要がなくなります。これが「AI版のUSB-C」と呼ばれる理由です。
MCPの世界には、主に2つの登場人物がいます。
CData Connect AIは、このMCPサーバーを、350以上のデータソースに対してクラウドでまとめて提供するサービスです。
▶ もっと詳しく