kintone を使っている現場から寄せられる相談で、いちばん多いのが「連携」の話です。売上データを DWH に溜めて分析したい、基幹システムの受注情報を kintone のアプリに書き戻したい、Claude や ChatGPT から kintone の案件を直接読ませたい、などなど。どれも「kintone 連携」という一言で語られますが、実際にやろうとしている作業の中身はまったく別物になります。
厄介なのは、検索して出てくる情報が横並びに見えてしまう点でしょう。REST API を自作する記事、ETL ツールの紹介、BI から直接つなぐ手順、プラグインの一覧、そして最近は MCP の解説まで並びます。どれも間違ってはいないのですが、前提としている要件が違うので、そのまま読み比べても自社の答えは出てきません。
この記事は、kintone 連携の選択肢を整理した地図として書いています。個別のツールの操作手順やスクリーンショットは載せていません。そのかわり、どんな手段があり、何を基準に絞り込むのかを最初に示して、深掘りが必要な部分は具体的な手順を書いた記事へ送り出す構成にしました。まずは自分の要件がどの枠に入るのかを、この地図の上で見つけてみてください。
kintone 連携の選択肢を4つの軸で整理する
kintone は外部システムとつなぐための手段を公式に用意しています。中心にあるのが REST API で、レコードの取得・登録・更新はここを通ります。もう一方の柱が Webhook です。こちらは kintone 側でレコードが変わったことをきっかけに外部へ通知を飛ばす仕組みです。待ち受け型の連携を組むときの入口になります。
ETL ツールにせよ BI ツールにせよ AI エージェントにせよ、最終的にはこの2つのどちらか(あるいは両方)に行き着きます。
では選択肢は何で分かれるのでしょうか。ツールの名前で分けると混乱するので、要件のほうから4つの軸で切ってみます。
方向:kintone からデータを取り出すのか、kintone へ書き戻すのか、それとも双方向で整合を取り続けるのかを見極めます。ここが最初の分岐です。取り出すだけなら選択肢はかなり広く、書き戻しが入ると設計の難易度が一段上がります。
頻度:見るときにその場でクエリするのか、夜間や1時間おきの定期バッチで動かすのか、レコードの変更を起点にしたイベント駆動にするのかを決めます。同じ「同期」という言葉でも、この3つは別の作りになります。
データ量:数百件で収まるのか、数万件を超えるのかを押さえます。後述するとおり kintone の API には1回あたりの取得件数の制約があるため、件数は方式選択に直接影響してきます。
運用者:連携を書いて保守するのが開発者なのか、それとも管理画面の操作で完結させたい情シス・業務側の担当者なのかを確かめます。ここを見落とすと、動いたけれど誰も面倒を見られない仕組みができあがってしまいます。
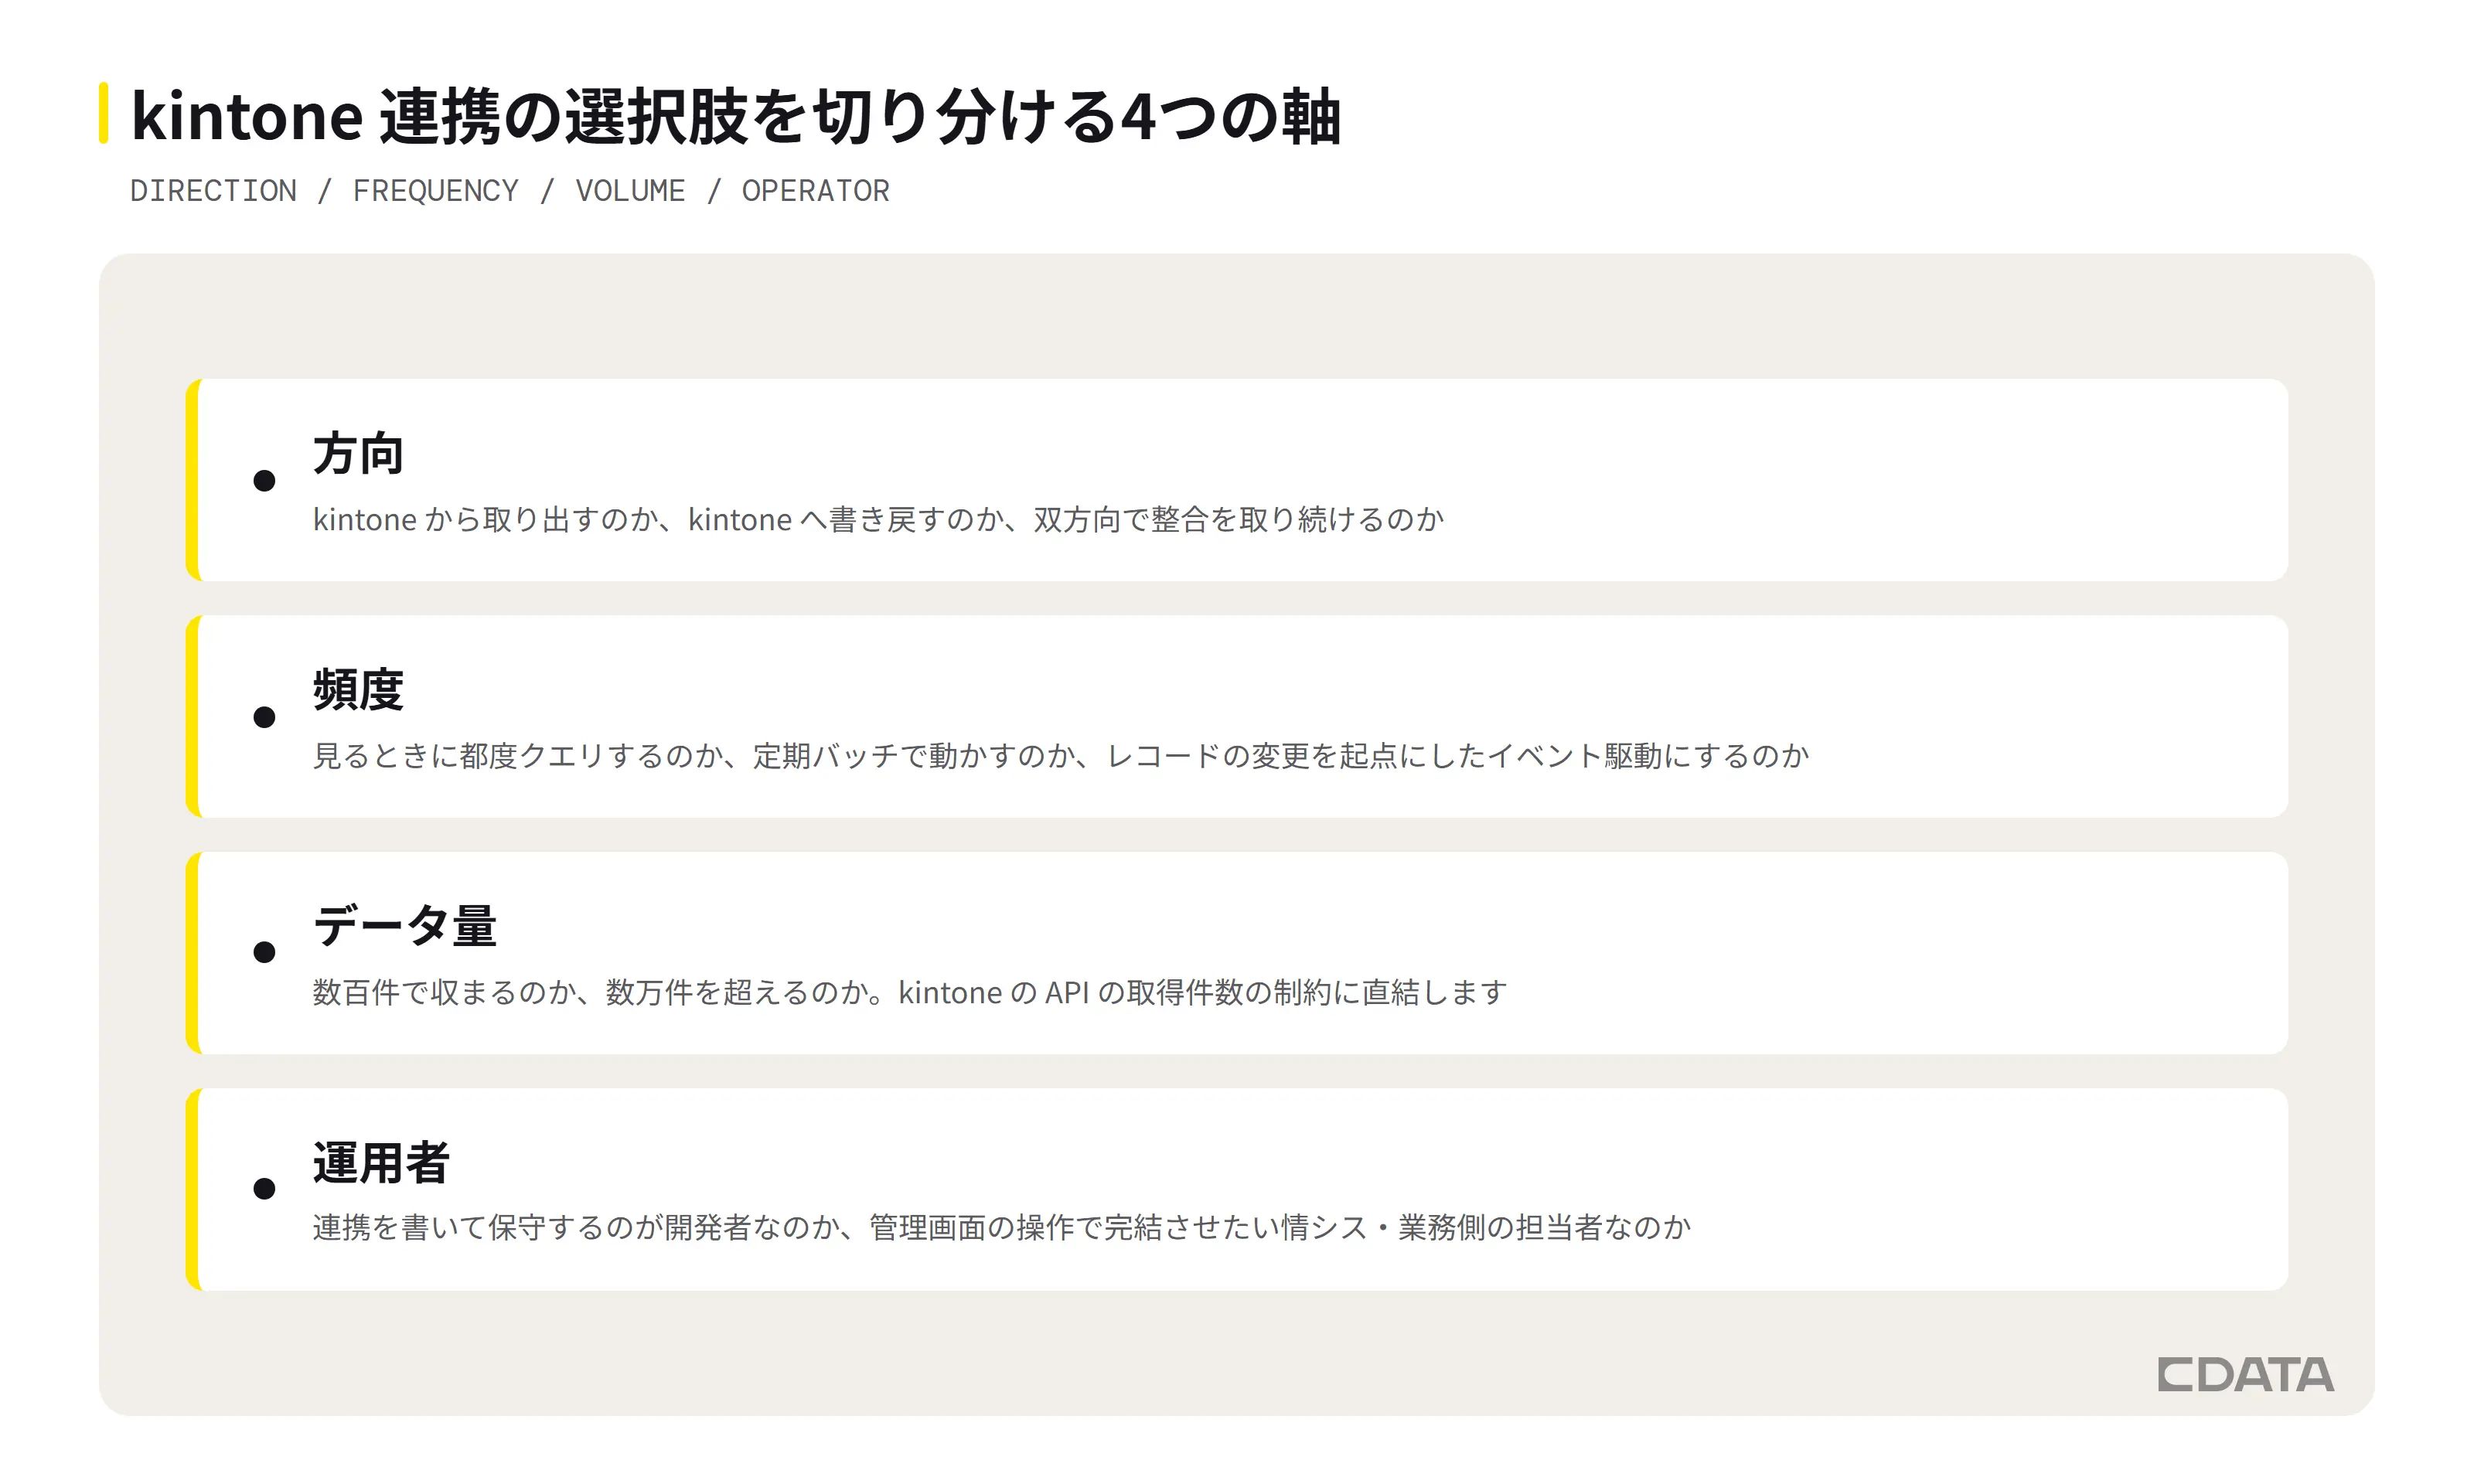
この4軸に自社の要件を当てはめると、候補は自然に2つか3つに絞れます。逆に軸を決めずにツールを比較し始めると、機能表の広さだけで判断してしまい、あとから「そもそも書き戻しが必要だった」と戻ることになりがちです。
先に結論だけ知りたい方のために、絞り込みの流れをまとめました。詳しい判断基準は後述の「要件から連携方法を絞り込む」に記載しています。
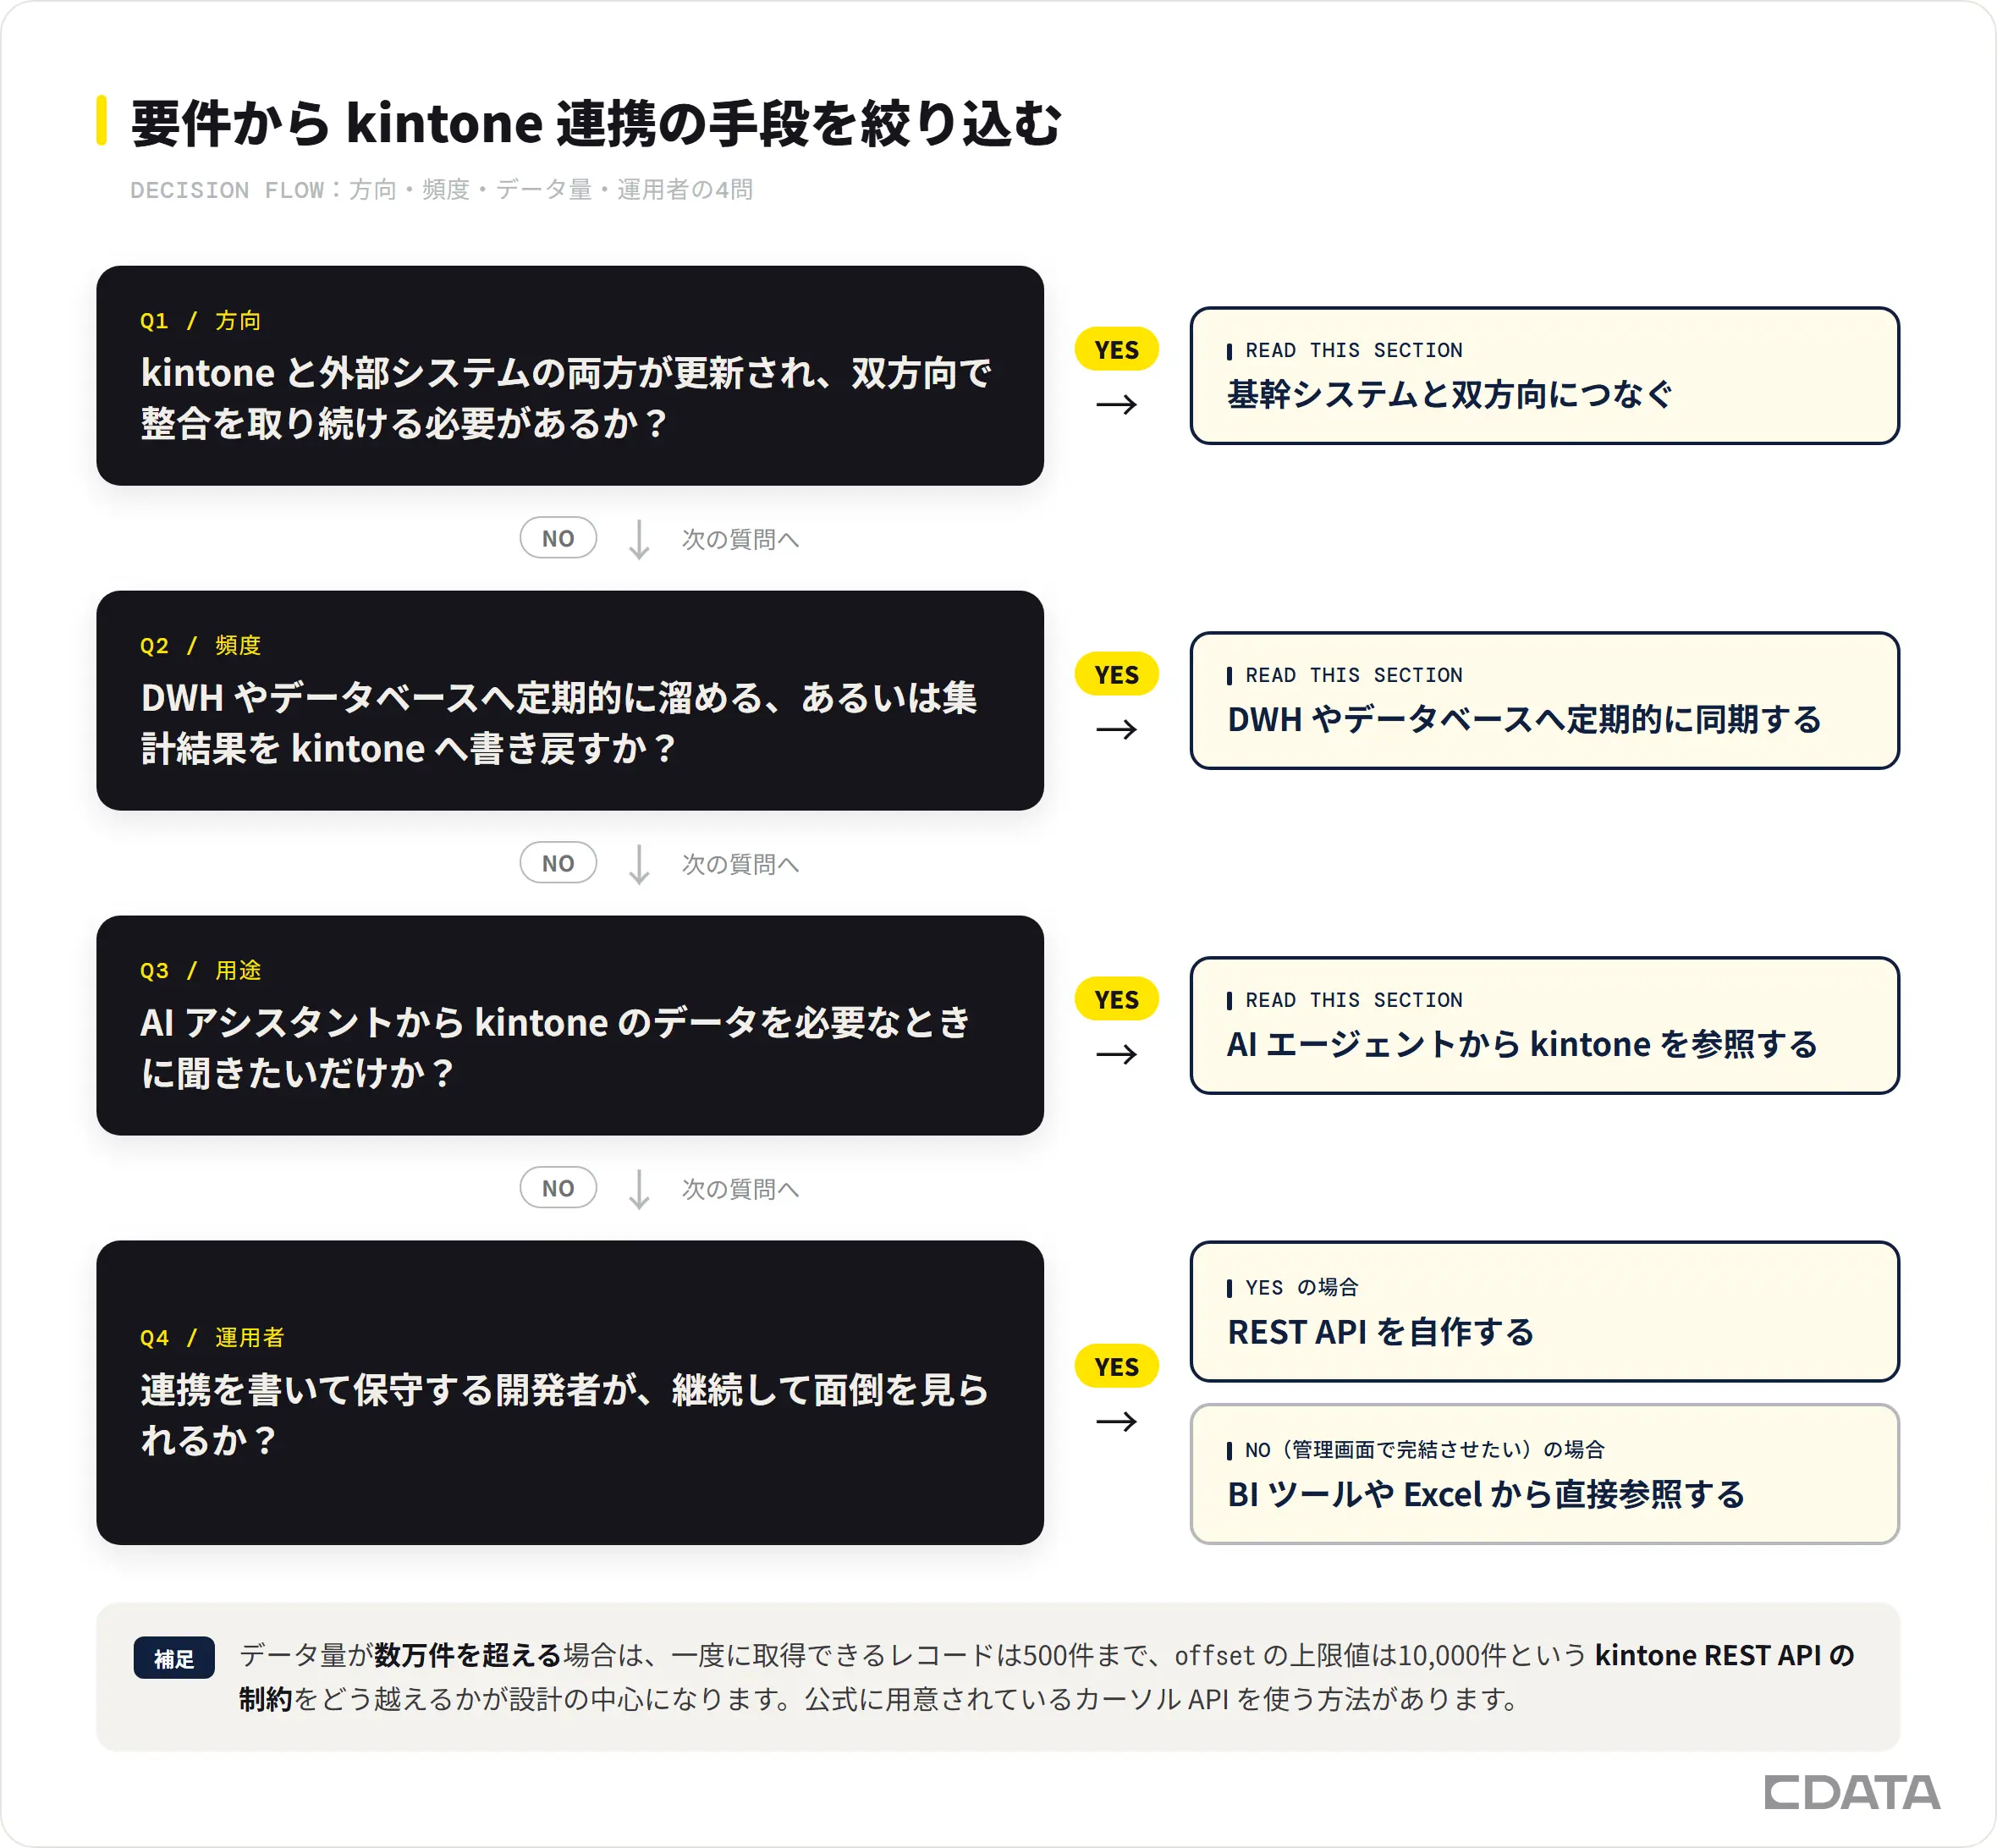
0. 範囲:kintone の中だけで完結するフローかどうかを確認します。
1. 方向:取り出す/書き戻す/双方向のどれかを決めます。
2. 頻度:都度参照/定期バッチ/イベント駆動のどれかを決めます。
3. データ量:数百件か、数万件を超えるかを確認します。
4. 運用者:開発者が保守するのか、管理画面の操作で完結させたいのかを確認します。
混同しやすい「kintone 連携」を切り分ける
手段を並べる前に、言葉のほうを片づけておきましょう。「kintone 連携」で検索してたどり着く情報のうち、そもそも目的が違うものが混ざっています。
なお、kintone アプリ同士のデータ連携(ルックアップやフィールドの自動反映、関連レコード一覧といった標準機能)は、この記事の対象には含めていません。社外・社内の別システムとの連携ではなく、kintone 内部の処理にあたるためです。詳しくは kintone公式ヘルプをご確認ください。
プラグイン・連携サービス
サイボウズ公式の プラグイン・連携サービスのカタログには、JavaScript や CSS を使った kintone 専用の拡張機能サービスと、API 連携による外部サービス連携の両方が並びます。ここで一度、読者の方に立ち止まっていただきたいところです。kintone の中だけで完結する拡張を探しているのであれば、上記のプラグイン・連携サービスのカタログをご覧いただくのが早道です。画面の入力チェックや表示の作り込み、krewData・krewSheet のようなアプリ内の加工がこれにあたります。一方で、外部システムとデータを授受する基盤を探しているのであれば、目的が異なるので、この先の §5 以降で扱う ETL・BI 連携・双方向連携の話が該当します。
カスタマイズ(JavaScript API)
kintone には画面の挙動を変えるための JavaScript API が公式に用意されています。入力チェックや表示の作り込みには向きますが、システム間でデータを流し続ける役割は担いません。
CSV の手動インポート・エクスポート
現場でいちばん使われている「連携」はこれです。動いてはいるものの、人が毎回操作する前提なので、頻度と件数が増えた時点で限界が来ます。
「API 連携」と「データ連携」
検索語としては別の言葉ですが、読者の意図はほぼ重なります。前者は手段(API を叩く)、後者は目的(データをつなぐ)を指していると考えるとすっきりします。
ETL とリバース ETL
kintone は取り出される側にも書き戻される側にもなります。どちらの向きの話をしているのかで、使うツールも設計も変わってきます。
MCP と通常の API 連携
MCP は AI エージェントがデータへ手を伸ばすための経路です。定期バッチや常時同期の代わりになるものではなく、目的そのものが別だと捉えてください。
kintone 公式の MCP Server と CData Connect AI の kintone MCP
名前が似ていますが別物です。どこが違うのかは kintone の MCP 連携で選べる3つの方法を整理した記事で比較しているので、そちらをご覧ください。
よくある SaaS 連携パターン
ご相談としてよく挙がるのは、①kintone のレコード追加を Slack に通知する、②Google フォームの回答を kintone のアプリに取り込む、③案件の進捗に合わせて Gmail からメールを送る、といった身近なパターンです。ノーコードのプラグインで足りる範囲なら、それがいちばん早い選択になります。条件分岐やデータの変換が絡んでプラグインの設定項目では書ききれなくなった段階で、Webhook を起点に CData Arc でフローとして組む形へ切り替えられます(手順はWebhook を起点にしたフローを Arc で組むで追えます)。通知ではなく溜めて分析したいという話であれば、DWH やデータベースへ定期的に同期するの節が該当します。
API連携を自作する方法とその課題
もっとも素直なルートは、REST API を叩くコードを自社で書くことです。API トークンを発行して認証し、レコードを取得して、必要な変換をかけて相手のシステムに投げます。連携が1本で、対象が数百件で、システムを運用する方がずっと社内にいるのであれば、この方法で十分に足るでしょう。
困るのはデータ量や連携先が増えたときです。API のリファレンスには、一度に取得できるレコードは500件まで、query パラメーターの offset の上限値は10,000件、limit の初期値は100件と明記されています。つまり数万件のアプリを丸ごと取り出そうとすると、ページングを回すだけでは10,000件の壁にぶつかります。
この壁を越える公式の手段が カーソル API です。自作する場合は、件数に応じて通常のページングとカーソルを使い分ける分岐を自分で書き、エラー時の再開も自分で面倒を見ることになります。CData 側でこの制約をどう吸収したのかは offset の上限値制限への対応をまとめた記事にまとめています。
自作か既製かの判断は、機能の優劣ではなく保守の引き受け先の話だと考えるのが実務的です。連携が3本を超えたあたりから、認証・ページング・リトライ・スキーマ変更への追従といった作業を自社で引き受けるコストが課題になるでしょう。
AI エージェントから kintone を参照する
Claude や ChatGPT、MS Copilot から kintone のデータを扱いたいというニーズは急速に拡大しています。この用途では、データをどこかに溜め直すのではなくエージェントが必要なときに kintone を読む形になります。経路として使われるのが MCP(Model Context Protocol)で、その裏側で実際に使用しているのはREST API です。
CData Connect AI はこの連携を提供する製品です。各種AIツールから連携方法から実際のユースケースまで各種照会記事を用意しているので、該当するものを選んでお読みください。
費用面も気になりますよね。公式の MCP Server と CData Connect AI を実際に両方動かして、トークン消費量と回答の正確さ、向いている場面を比べた コスト・正確性・使える場面の実測比較がありますので、判断材料にご利用ください。
DWH やデータベースへ定期的に同期する
分析基盤に kintone のデータを溜めたいという方も多いはず。BigQuery や Snowflake、SQL Server などに定期的に書き出しておけば、BI 側は kintone の API 制約を意識せずに済みます。たとえば kintone から Amazon Redshift へ同期して Tableau で可視化する手順はそのまま手順を追える形になっています。逆に、DWH で集計した結果を kintone のアプリに戻して現場に見せたい、という向きの相談も少なくありません。こちらはリバース ETL と呼ばれる領域です。
CData Sync を使った具体的なデータの連携方法は以下にまとめています。
基幹システムと双方向につなぐ
オンプレミスの基幹システムと kintone を、片方向ではなく双方向で連携したい場合もあるでしょう。受注は基幹側が正で、進捗管理は kintone 側が正、という具合に真となるデータが分かれているケースです。この場合は定期バッチだけで構築すると反映の遅れが問題になるため、変更を起点にしたイベント駆動を混ぜることになります。
その起点として使えるのが Webhook です。kintone のヘルプに設定手順が載っており、アプリの設定画面から通知先を登録できます。つまり kintone 側の準備は開発作業ではなく管理画面の操作で済みます。業務側の担当者と分担しやすいのも、実務上ありがたいところでしょう。
双方向連携を回し始めると、1件ずつではなく数百件をまとめて登録・更新したい場面が出てきます。その書き方は kintone への登録や更新をバッチで実行する方法にまとめているので、扱う件数が読めている段階で目を通しておくと設計が楽になります。
CData Arc を使った双方向連携やファイル・子テーブルの扱いは、以下の記事で具体的に紹介しています。
BI ツールや Excel から直接参照する
DB/DWHにデータを貯めることなくBI から kintone をそのまま見たい——そんな相談もよく寄せられます。Power BI や Tableau、Excel から ODBC / JDBC 経由でつなぐ方法がこれにあたり、データの置き場所を増やさずに済み、同期頻度などを気にせず最新のデータにアクセスできるのが利点です。ただし、大量のデータを分析する用途には向きません。
CData の kintone コネクタは Kintone REST API を利用して、kintone のアプリをテーブルとして表現します。SQL を書ける人にとっては、見慣れた形でデータを取得できるのです。
認証については、ユーザー名とパスワード・API トークン・OAuth の3方式から選べます。OAuth を使う場合は InitiateOAuth によってトークンの取得とリフレッシュを自動化できるため、長く動かす連携では選択肢に入れておくとよいでしょう。
直接参照を選んでも、クラウド側の BI サービスから最新の状態を定期的に取得したいという場合はありますよね。その場合はPower BIならオンプレミスデータゲートウェイを挟む構成になり、Power BI Service で kintone データを自動で定期更新する手順に実際の設定まで記載しています。取得件数の制限や認証の選び分け、サブテーブルの具体的な見え方といった実際のハマりどころは、BI 接続に絞った記事で詳しく扱っています。
さらに細かい実装の制御が必要な場合には、UPSERT の書き方を解説した記事や、テーブル名の扱いを切り替える方法を紹介した記事も用意しています。
要件から連携方法を絞り込む
ここまでの手段を、冒頭の4軸で順番に絞り込んでみましょう。上から順に答えていくと、読むべき節が決まります。
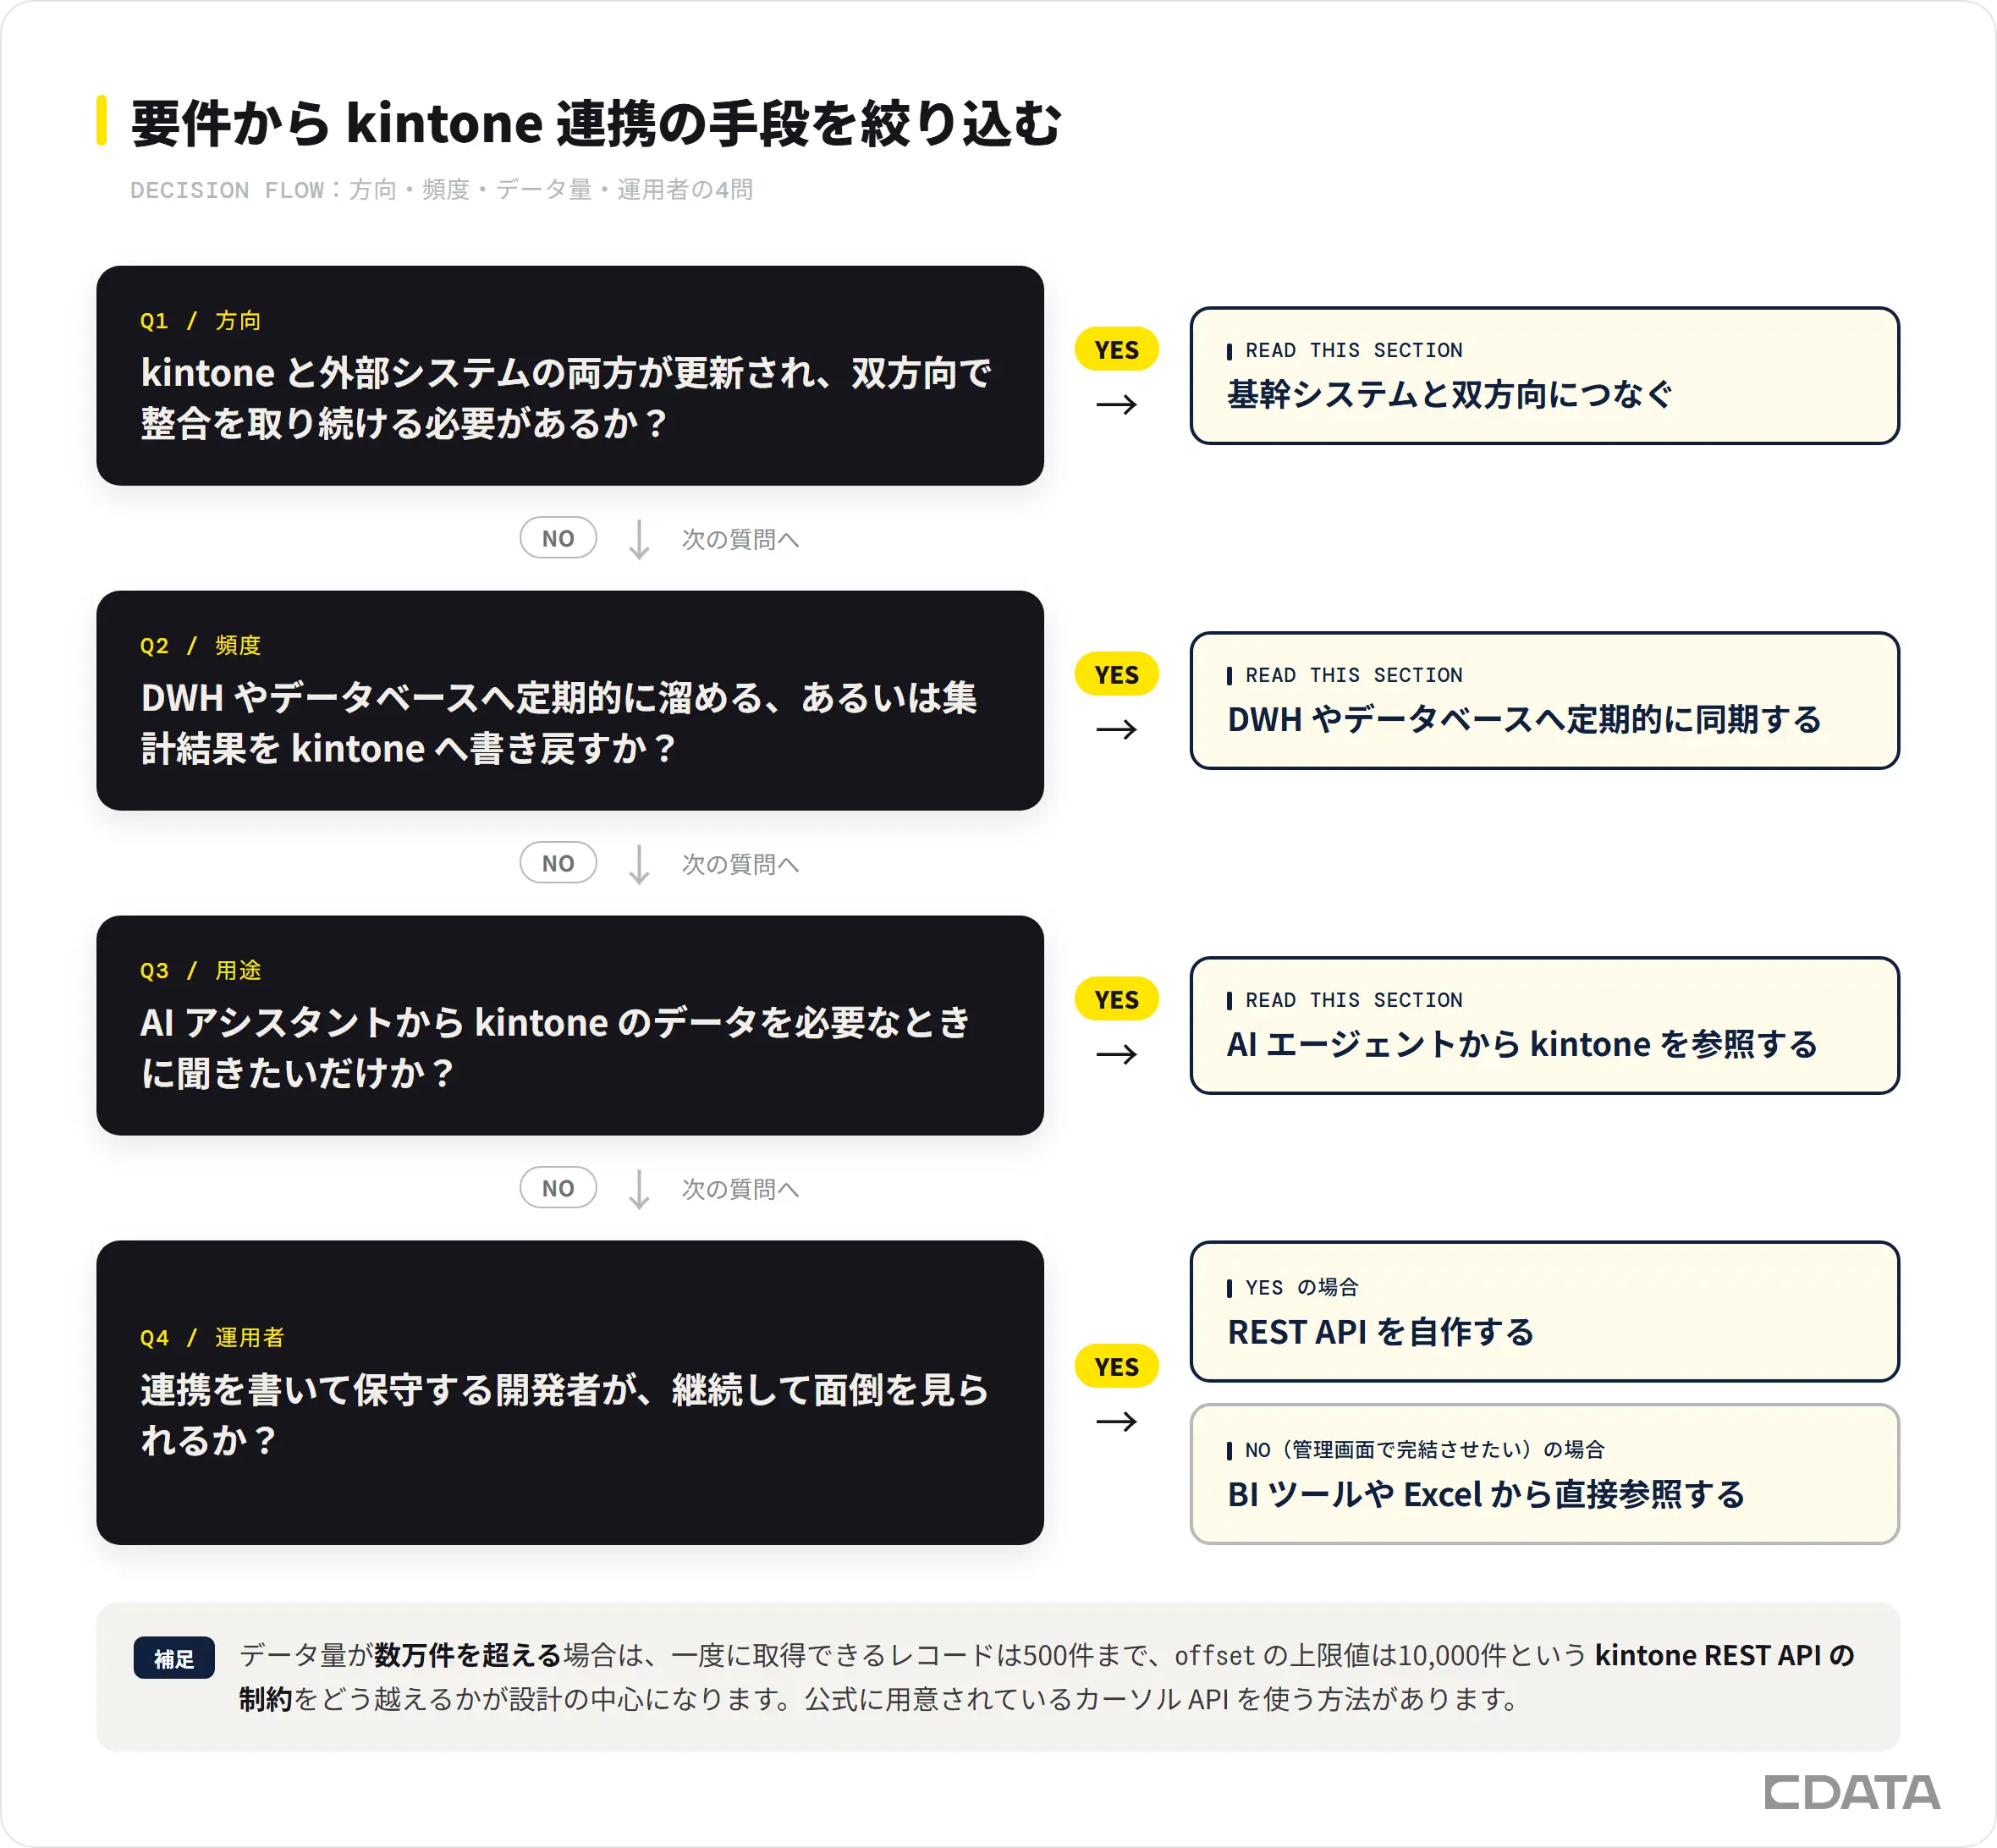
0. kintoneの中だけで完結する話ですか。YES であれば外部システムとのやり取りは発生しないので、プラグイン・連携サービスのカタログを確認してみてください。NO であれば次の問いに進んでください。
1. 方向はどちらですか。取り出すだけなら、参照で足りるのか溜める必要があるのかを確認します。バッチでの書き戻しが中心なら DWH やデータベースへ定期的に同期するの節(後半でリバース ETL による書き戻しも)、システムの変更を起点にした常時の双方向整合が必要なら基幹システムと双方向につなぐに進んでください。
2. 頻度はどうですか。データを確認したいときに読む込めばOKであれば BI ツールや Excel からの直接参照、DB/DWHに定期的に溜めるなら 同期、レコードの変更を起点にしたいなら 双方向の節が該当します。AI アシスタントから活用したい場合は AI エージェントから kintone を参照するをご参照ください。
3. データ量はどれくらいですか。数百件なら方式の自由度は高く、自社開発も現実的です。数万件を超えるなら、500件・10,000件という API の制約をどう越えるかが設計の中心になります。この段階で開発の負担は大きく増してきます。
4. 誰が運用しますか。開発者が継続して面倒を見られるなら API連携を自作する方法も選べます。管理画面の操作で完結させたいなら、ベンダーの製品を利用する判断がいいかもしれません。
差分だけを連携したい、kintone 側のフィールド追加に追従したい、といった一段細かい要件は、方式が決まったあとに検討すればよいでしょう。
kintone をどのツールから使いたいのかがはっきりしている場合は、ここまで紹介してきた製品の無料トライアルにお進みください。要件がバッチ同期や基幹システムとの双方向連携に寄っている場合も含めて、どの製品が適しているかなどお気軽にご相談ください。
CData Connect AI で kintone を AI とツールにつなぐ
kintone のデータを AI アシスタントや BI ツールから直接扱いたい場合、CData Connect AI が最適です。接続設定はクラウド上で完結するためREST API のページングや認証の実装を自社で抱え込む必要はなく、認証・権限などガバナンス周りもすべておまかせです。
無料トライアルを用意していますので、実際の kintone アプリをつないだ動きをぜひ確認してみてください。
よくある質問
kintone の REST API で一度に取得できるレコード件数に上限はありますか。
あります。kintone の公式リファレンスには、一度に取得できるレコードは500件まで、query パラメーターの offset の上限値は10,000件、limit の初期値は100件と記載されています。10,000件を超える範囲を扱う場合は、公式に用意されているカーソル API を使う方法があります。
kintone のサブテーブルは連携時にどう扱われますか。
CData の kintone コネクタでは、サブテーブルは別のテーブルとして表現され、区切り文字は SubtableSeparatorCharacter プロパティで制御します。BI での見え方や Arc での子テーブルの扱いは、それぞれの専用記事で具体的に解説しています。
kintone への書き戻し(更新)もできますか。
はい、可能です。CData の kintone コネクタでは、レコードがあれば更新・なければ挿入する UPSERT を SQL の1文として実行できます。CData Sync を使ったリバース ETL の具体的な手順は、UPSERT 版と INSERT 版で記事が分かれています。
kintone 公式の MCP Server と CData Connect AI の kintone MCP は何が違いますか。
この2つは別物です。どちらを選ぶべきかは前提とする環境や運用によって変わるため、選択肢を並べて比較した専用記事をご覧ください。
API トークンと OAuth はどちらを使うべきですか。
CData の kintone コネクタは、ユーザー名とパスワード・API トークン・OAuth の3方式に対応しています。API トークンは設定が簡単で単一用途の連携に向き、OAuth は InitiateOAuth によってトークンの取得とリフレッシュを自動化できるため、長期間動かし続ける連携で選ばれます。
HULFT や DataSpider で組んでいる kintone 連携を移行する際、何を検討すべきですか。
他社製品の機能や価格を比較するより先に、運用の実態から検討するのがおすすめです。確認すべき3つのポイントと、それぞれの次の一歩は、詳しくは上記「レガシー EAI からの移行という相談」セクションをご覧ください。
kintone と Slack や Google Workspace のような身近な SaaS との連携もできますか。
できます。相手が身近な SaaS でも考え方は同じで、kintone の Webhook を起点に CData Arc でフローを組むか、CData Connect AI 経由で AI アシスタントやツールから kintone を参照する形になります。ノーコードのプラグインで足りる範囲ならプラグインが最短ですが、条件分岐や複数システムをまたぐ変換が入るのであれば、連携基盤側に寄せたほうが後の保守は楽になります。
出典・参考情報