



Google Data Fusion で Alchemy に連携した ETL プロセスを作成
Google Data Fusion を使用すると、セルフサービス型のデータ連携を行い、異なるデータソースを統合できます。CData API Driver for JDBC をアップロードすることで、Google Data Fusion のパイプライン内から Alchemy のデータ にリアルタイムでアクセスできるようになります。CData JDBC Driver を使用すると、Alchemy のデータ を Google Data Fusion でネイティブにサポートされている任意のデータソースにパイプできますが、この記事では、Alchemy から Google BigQuery へデータをパイプする方法を説明します。
CData API Driver for JDBC を Google Data Fusion にアップロード
CData API Driver for JDBC を Google Data Fusion インスタンスにアップロードして、Alchemy のデータ にリアルタイムでアクセスしましょう。Google Data Fusion では JDBC ドライバーの命名規則に制限があるため、JAR ファイルを driver-version.jar という形式に合わせてコピーまたはリネームしてください。例:cdataapi-2020.jar
- Google Data Fusion インスタンスを開きます
- をクリックしてエンティティを追加し、ドライバーをアップロードします
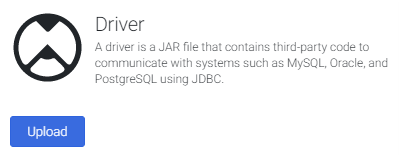
- "Upload driver" タブで、リネームした JAR ファイルをドラッグまたは参照します。
- "Driver configuration" タブで以下を設定します:
- Name: ドライバーの名前(cdata.jdbc.api)を作成し、メモしておきます
- Class name: JDBC クラス名を設定します:(cdata.jdbc.api.APIDriver)
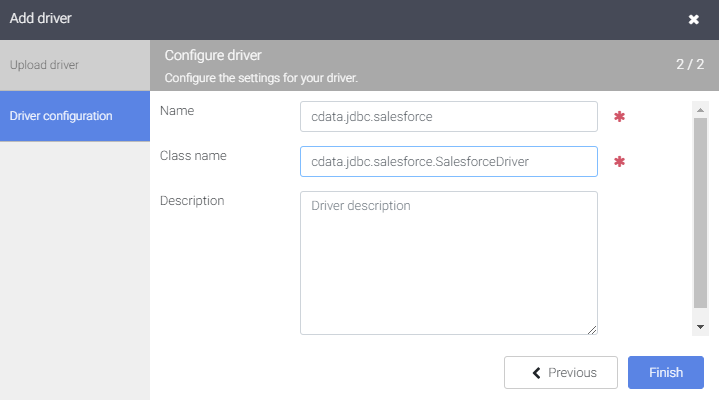
- "Finish" をクリックします
Google Data Fusion で Alchemy のデータ に接続
JDBC Driver をアップロードしたら、Google Data Fusion のパイプラインで Alchemy のデータ にリアルタイムでアクセスできます。
- Pipeline Studio に移動して、新しいパイプラインを作成します
- "Source" オプションから "Database" をクリックして、JDBC Driver 用のソースを追加します
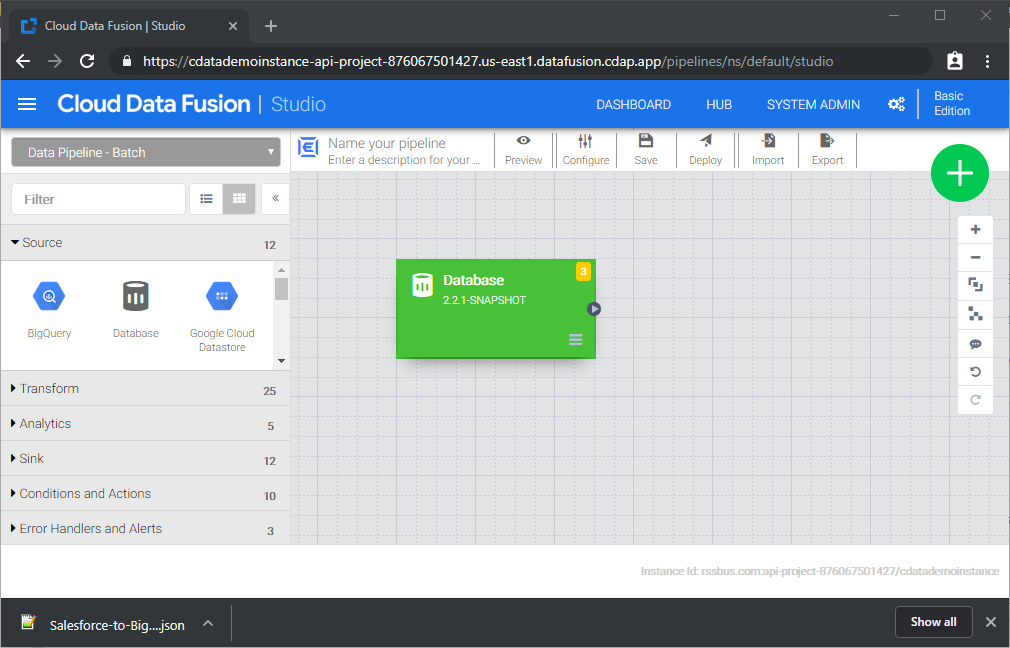
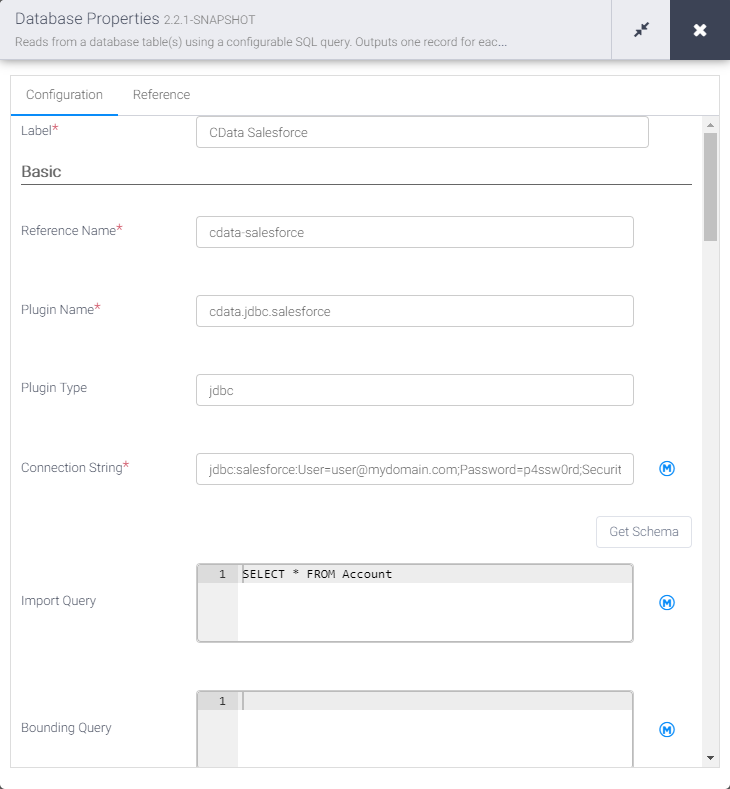
- Database ソースの "Properties" をクリックしてプロパティを編集します
NOTE:Google Data Fusion で JDBC Driver を使用するには、ライセンス(製品版またはトライアル)とランタイムキー(RTK)が必要です。ライセンス(またはトライアル)の取得については、CData までお問い合わせください。
- Label を設定します
- Reference Name を将来の参照用の値に設定します(例:cdata-api)
- Plugin Type を "jdbc" に設定します
- Connection String を Alchemy の JDBC URL に設定します。例:
jdbc:api:RTK=5246...;Profile=C:\profiles\Alchemy.apip;AuthScheme=APIKey;Network=eth-mainnet;ProfileSettings='APIKey=your_api_key';まず、Profile 接続プロパティをディスク上の Alchemy プロファイルの場所に設定します(例:C:\profiles\Alchemy.apip)。次に、ProfileSettings 接続プロパティを Alchemy の接続文字列に設定します(以下を参照)。
Alchemy API プロファイル設定
Alchemy では API キー認証を使用します。API キーはリクエスト URL のパスに含めて送信されます。API キーは以下の手順で取得できます。
- https://dashboard.alchemy.com で Alchemy アカウントにサインインします。
- 既存のアプリを開くか、新しいアプリを作成します。
- 「API Key」ダイアログから、アプリの API キーをコピーします。
API キーを取得したら、以下の接続プロパティを設定します。
- AuthScheme:APIKey に設定します。
- Network:(オプション)NFT API リクエストの対象となるブロックチェーンネットワークのスラッグです(例:eth-mainnet、base-mainnet、polygon-mainnet)。デフォルトは eth-mainnet です。
ProfileSettings 接続プロパティには、以下を設定します。
- APIKey:Alchemy アプリの API キーに設定します。
ビルトイン接続文字列デザイナー
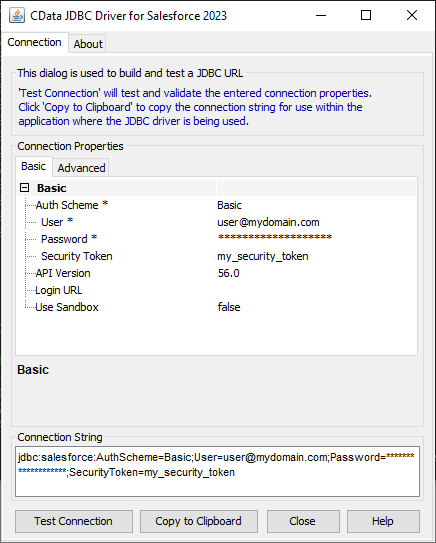
JDBC URL の作成には、Alchemy JDBC Driver に組み込まれている接続文字列デザイナーを使用できます。JAR ファイルをダブルクリックするか、コマンドラインから JAR ファイルを実行してください。
java -jar cdata.jdbc.api.jar接続プロパティを入力し、接続文字列をクリップボードにコピーします。
- Import Query を Alchemy から取得したいデータを抽出する SQL クエリに設定します。例:
SELECT * FROM ContractsForOwner
- "Sink" タブから、同期先シンクを追加します(この例では Google BigQuery を使用します)
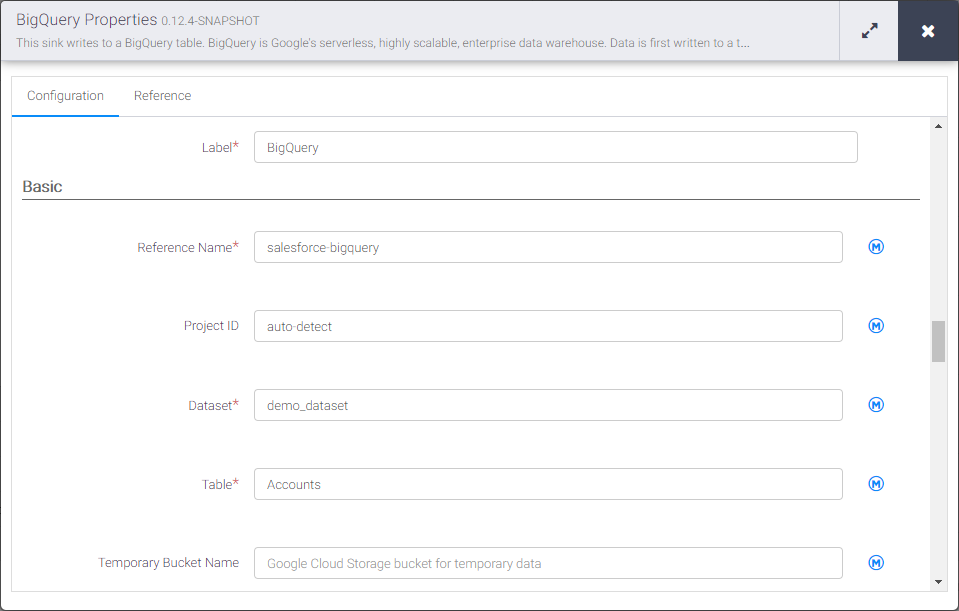
- BigQuery シンクの "Properties" をクリックしてプロパティを編集します
- Label を設定します
- Reference Name を api-bigquery のような値に設定します
- Project ID を特定の Google BigQuery プロジェクト ID に設定します(またはデフォルトの "auto-detect" のままにします)
- Dataset を特定の Google BigQuery データセットに設定します
- Table を Alchemy のデータ を挿入するテーブル名に設定します
Source と Sink を設定すると、Alchemy のデータ を Google BigQuery にパイプする準備が整います。パイプラインを保存してデプロイしてください。パイプラインを実行すると、Google Data Fusion が Alchemy からリアルタイムデータをリクエストし、Google BigQuery にインポートします。
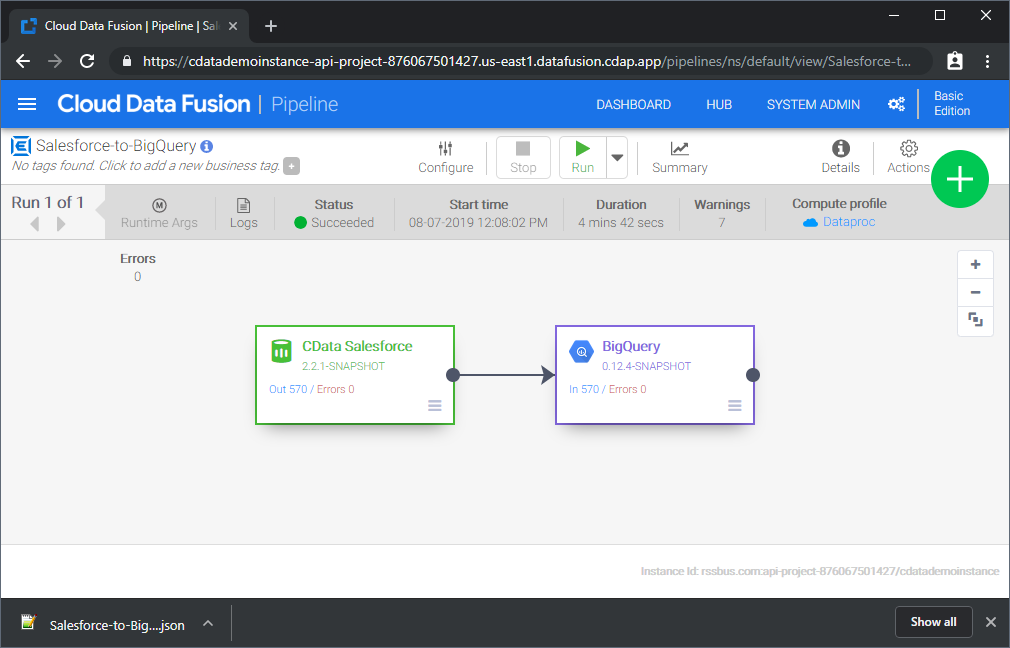
これはシンプルなパイプラインの例ですが、変換、分析、条件などを使用してより複雑な Alchemy パイプラインを作成できます。CData API Driver for JDBC の 30日間の無償トライアルをダウンロードして、今すぐ Google Data Fusion で Alchemy のデータ をリアルタイムで活用しましょう。