



AWS Glue ジョブからApprovalMax のデータにJDBC 経由で接続

AWS Glue はAmazon のETL サービスであり、簡単にデータプレパレーションを実行してストレージおよび分析用に読み込むことができます。AWS Glue と一緒にPySpark モジュールを使用すると、JDBC 接続経由でデータを処理するジョブを作成し、そのデータをAWS データストアに直接読み込むことができます。ここでは、CData JDBC Driver for API をAmazon S3 バケットにアップロードし、ApprovalMax からデータを抽出してCSV ファイルとしてS3 に保存するためのAWS Glue ジョブを作成・実行する方法について説明します。
CData JDBC Driver for API をAmazon S3 バケットにアップロード
CData JDBC Driver for API をAWS Glue から使用するには、ドライバーの.jar ファイル(および必要なライセンスファイル)をAmazon S3 のバケットに配置する必要があります。
- Amazon S3 コンソールを開きます。
- バケットを選択、もしくは作成します。
- [アップロード]をクリックします。
- JDBC Driver の.jar ファイル(cdata.jdbc.api.jar) をインストールディレクトリのlib フォルダから選択してアップロードします。
Amazon Glue Job を設定
- [分析]->[AWS Glue]をクリックします。
- AWS Glue コンソールで、[ETL]->[ジョブ]をクリックします。
- [ジョブの追加]をクリックして新しいGlue ジョブを作成します。
- ジョブのプロパティを設定します:
- 名前: APIGlueJob など任意のジョブ名
- IAM ロール: AWSGlueServiceRole もしくは AmazonS3FullAccessSelect の権限があるIAM ロールを設定(JDBC Driver がAmazon S3 バケットにあるため)。
- Type: [Spark]を選択。
- Glue version: ドロップダウンからバージョンを選択。
- このジョブ実行: [ユーザーが作成する新しいスクリプト]を選択。
スクリプトプロパティの設定: - スクリプトファイル名: GlueAPIJDBC などのスクリプトファイル名。
- スクリプトが保存されているS3 パス: S3 バケットを入力もしくは選択。
- 一時ディレクトリ: S3 バケットを入力もしくは選択
- ETL 言語: [Python]を選択
- セキュリティ設定、スクリプトライブラリおよびジョブパラメータを展開。依存JARS パスは、JDBC の.jar ファイルをアップロードしたS3 バケットに設定。.jar ファイル名 s3://mybucket/cdata.jdbc.api.jar も含めます。
- [次へ]をクリックすると、ほかのAWS エンドポイントへの接続オプション追加ができます。Redshift、MySQL などに接続する際にはここで接続を作成できます。
- [ジョブの保存とスクリプトの編集]をクリックします。
- 開いたエディタで、Python スクリプトを記述します。サンプルは以下です。
サンプルGlue スクリプト
CData JDBC driver でApprovalMax に接続するには、JDBC URL を作成します。さらにライセンスとしてJDBC URL にRTK プロパティを設定する必要があります。RTK は通常のライセンスと異なりますので、CData まで直接ご連絡をください。
まず、Profile 接続プロパティをディスク上の ApprovalMax プロファイルの場所に設定します(例:C:\profiles\ApprovalMax.apip)。次に、ProfileSettings 接続プロパティを ApprovalMax の接続文字列に設定します(以下を参照)。
ApprovalMax API プロファイル設定
ApprovalMax Public API では、OAuth 2.0 の認可コードフローで認証を行います。自分のデータに接続するだけでなく、他のユーザーが各自のデータに接続できるようにすることも可能です。
まず、ApprovalMax に OAuth アプリケーションを登録する必要があります。ApprovalMax Developer Portal(https://developer.approvalmax.com/applications)にサインインし、新しいアプリケーションを作成します。OAuth アプリケーションには Client ID と Client Secret が割り当てられます。また、Redirect URI(Callback URL)を少なくとも1つ登録しておく必要があります。
Public API を利用するには、ApprovalMax の Premium サブスクリプション(または有効なトライアル)が必要です。
以下の接続プロパティを設定すると、接続できるようになります。
- AuthScheme:OAuth に設定します。
- InitiateOAuth:GETANDREFRESH に設定します。InitiateOAuth を使うと、OAuthAccessToken を取得するプロセスを管理できます。
- OAuthClientId:ApprovalMax Developer Portal のアプリケーション設定に表示される Client ID に設定します。
- OAuthClientSecret:ApprovalMax Developer Portal のアプリケーション設定に表示される Client Secret に設定します。
- CallbackURL:アプリケーション設定で登録した Redirect URI に設定します。
- Scope:(オプション)デフォルトの OAuth スコープを上書きします。デフォルト値の openid offline_access https://www.approvalmax.com/scopes/public_api/read は、このプロファイルのすべてのテーブルへの読み取り専用アクセスを許可し、リフレッシュトークンを有効にします。スコープを絞り込む際は、最小権限の原則に従ってください。
OAuth の Authorization URL は https://identity.approvalmax.com/connect/authorize、Token URL は https://identity.approvalmax.com/connect/token です。グラントタイプは authorization_code と refresh_token の両方に対応しています。
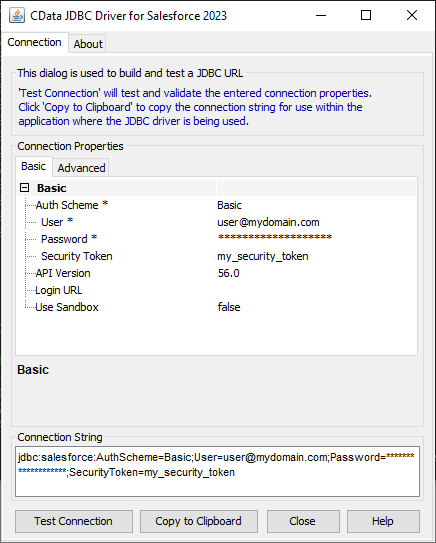
ビルトイン接続文字列デザイナー
JDBC URL の作成をサポートするビルトインの接続文字列デザイナーがあります。ドライバーの.jar ファイルをダブルクリックするか、コマンドラインで.jar ファイルを実行するとデザイナーが開きます。
java -jar cdata.jdbc.api.jar
必要項目を入力すると、デザインs-下部に接続文字列が生成されますのでクリップボードにコピーして使います。
CData JDBC driver をPySpark で使用して、AWS Glue モジュールでApprovalMax のデータを取得して、S3 にCSV 形式で保存するシンプルなスクリプト例は以下です。
import sys
from awsglue.transforms import *
from awsglue.utils import getResolvedOptions
from pyspark.context import SparkContext
from awsglue.context import GlueContext
from awsglue.dynamicframe import DynamicFrame
from awsglue.job import Job

args = getResolvedOptions(sys.argv, ['JOB_NAME'])

sparkContext = SparkContext()
glueContext = GlueContext(sparkContext)
sparkSession = glueContext.spark_session

##Use the CData JDBC driver to readApprovalMax のデータfrom the UserProfiles table into a DataFrame
##Note the populated JDBC URL and driver class name
source_df = sparkSession.read.format("jdbc").option("url","jdbc:api:RTK=5246...;Profile=C:\profiles\ApprovalMax.apip;AuthScheme=OAuth;InitiateOAuth=GETANDREFRESH;OAuthClientId=your_client_id;OAuthClientSecret=your_client_secret;CallbackURL=your_callback_url;").option("dbtable","UserProfiles").option("driver","cdata.jdbc.api.APIDriver").load()

glueJob = Job(glueContext)
glueJob.init(args['JOB_NAME'], args)

##Convert DataFrames to AWS Glue's DynamicFrames Object
dynamic_dframe = DynamicFrame.fromDF(source_df, glueContext, "dynamic_df")

##Write the DynamicFrame as a file in CSV format to a folder in an S3 bucket.
##It is possible to write to any Amazon data store (SQL Server, Redshift, etc) by using any previously defined connections.
retDatasink4 = glueContext.write_dynamic_frame.from_options(frame = dynamic_dframe, connection_type = "s3", connection_options = {"path": "s3://mybucket/outfiles"}, format = "csv", transformation_ctx = "datasink4")

glueJob.commit()
Glueジョブを実行する
スクリプト記述後、Glue ジョブを実行します。実行した取得/ロードのジョブが完了するとAWS Glue コンソールのジョブページでステータスが確認できます。成功するとS3 バケットにApprovalMax のデータのCSV ファイルが生成されています。
このようにCData JDBC Driver for API をAWS Glue で使用することで、ApprovalMax のデータをAWS Glue で自在に扱うことができます。Glue の外部データへの接続性を拡張するJDBC Driver を是非お試しください。