

LangGraph と Bitbucket のデータを CData Connect AI で統合
LangGraph は、推論モデル(LLM)、ツール統合、データ操作を組み合わせたインテリジェントなグラフベースの AI ワークフローを構築・可視化するためのフレームワークです。CData Connect AI と統合することで、エージェントは標準化されたツールセットを通じてエンタープライズデータにリアルタイムでセキュアにアクセス、クエリ、操作できるようになります。
CData Connect AI は、Bitbucket などのデータソースを Model Context Protocol(MCP)を通じて公開できるマネージド MCP プラットフォームです。これにより、AI エージェントは複雑な ETL やカスタム統合なしに、数百種類のデータソースのメタデータ、カタログ、テーブル、SQL 対応のデータアクセスを操作できます。
この記事では、LangGraph で MCP エンドポイントを登録し、CData Connect AI を通じてデータソース接続を設定し、リアルタイムデータ(例:Bitbucket オブジェクト)をオンデマンドでクエリ・可視化するワークフローを構築する方法を説明します。また、組み込みの MCP ツールセット(getCatalogs、getSchemas、getTables、queryData など)を使用して、自然言語エージェントがエンタープライズデータとセキュアかつインタラクティブに対話できるようにする方法を示します。
前提条件
- CData Connect AI のアカウント
- Python バージョン 3.10 以上(LangGraph パッケージのインストール用)
- OpenAI API キーを生成して保存
- Visual Studio Code をシステムにインストール
- LangGraph から LangGraph API キーを取得して保存
ステップ1:LangGraph 用の Bitbucket 接続を設定
LangGraph が Bitbucket にアクセスする前に、CData Connect AI で Bitbucket 接続を作成する必要があります。この接続はリモート MCP サーバーを通じて LangGraph に公開されます。
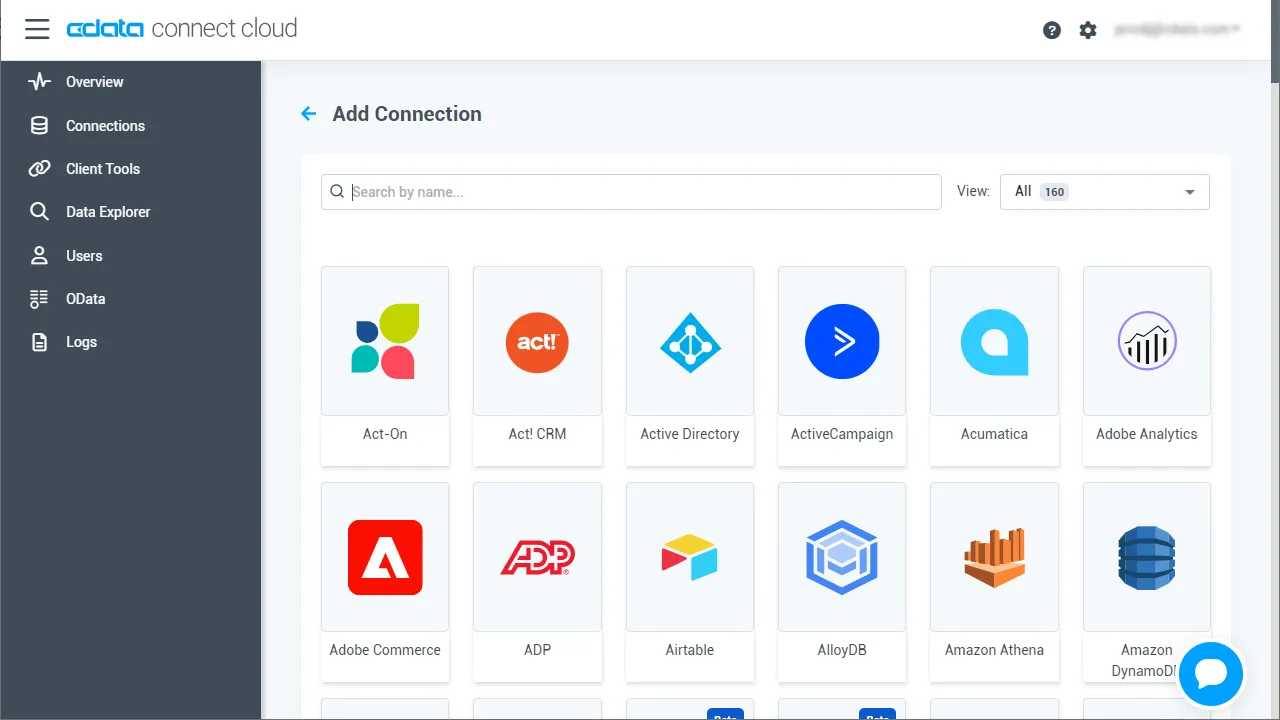
- Connect AI にログインして「Sources」をクリック、次に「+ Add Connection」をクリック
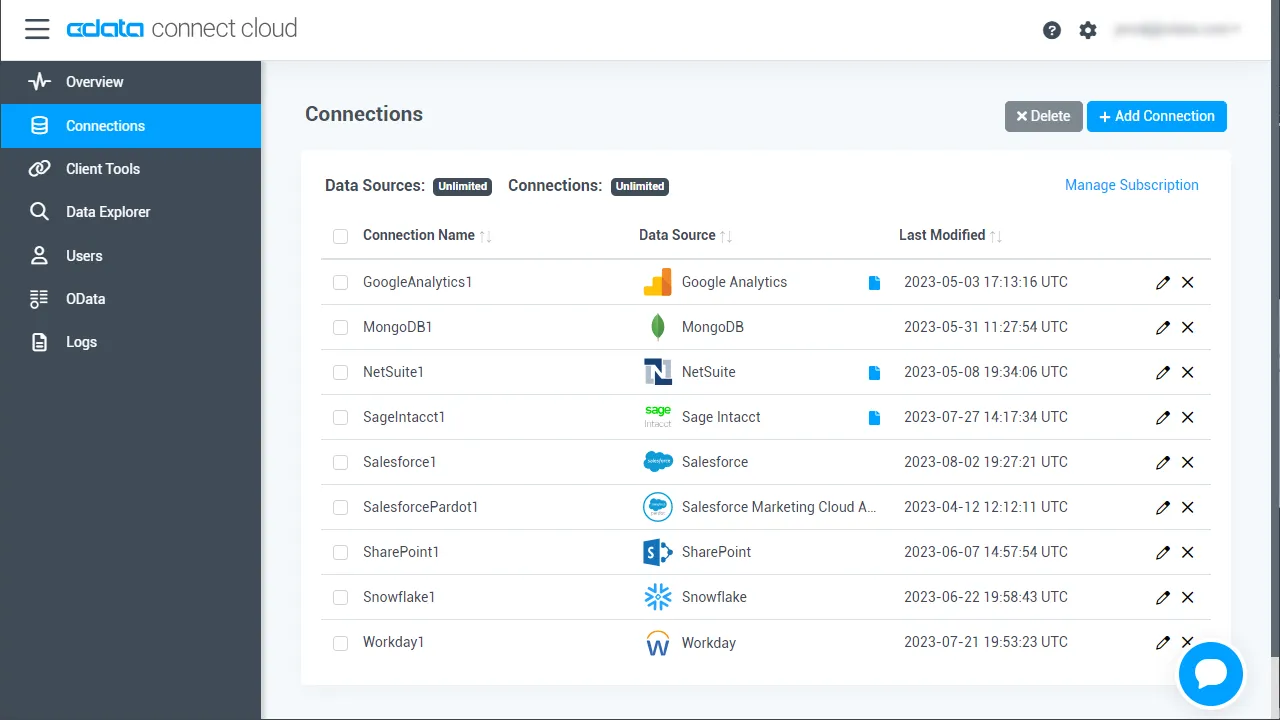
- 利用可能なデータソースから「Bitbucket」を選択
-
Bitbucket に接続するために必要な認証プロパティを入力します。
ほとんどのクエリでは、ワークスペースを設定する必要があります。唯一の例外は、Workspacesテーブルです。このテーブルはこのプロパティの設定を必要とせず、クエリを実行すると、Workspaceの設定に使用できるワークスペーススラッグのリストが提供されます。このテーブルにクエリを実行するには、スキーマを'Information'に設定し、SELECT * FROM Workspacesクエリを実行する必要があります。
Schemaを'Information'に設定すると、一般的な情報が表示されます。Bitbucketに接続するには、以下のパラメータを設定してください。
- Schema: ワークスペースのユーザー、リポジトリ、プロジェクトなどの一般的な情報を表示するには、これを'Information'に設定します。それ以外の場合は、クエリを実行するリポジトリまたはプロジェクトのスキーマに設定します。利用可能なスキーマの完全なセットを取得するには、sys_schemasテーブルにクエリを実行してください。
- Workspace: Workspacesテーブルにクエリを実行する場合を除き、必須です。Workspacesテーブルへのクエリにはこのプロパティは必要ありません。そのクエリはWorkspaceの設定に使用できるワークスペーススラッグのリストのみを返すためです。
Bitbucketでの認証
BitbucketはOAuth認証のみをサポートしています。すべてのOAuthフローからこの認証を有効にするには、カスタムOAuthアプリケーションを作成し、AuthSchemeをOAuthに設定する必要があります。
特定の認証ニーズ(デスクトップアプリケーション、Webアプリケーション、ヘッドレスマシン)に必要な接続プロパティについては、ヘルプドキュメントを必ず確認してください。
カスタムOAuthアプリケーションの作成
Bitbucketアカウントから、以下のステップを実行します。
- 設定(歯車アイコン)に移動し、ワークスペース設定を選択します。
- アプリと機能セクションで、OAuthコンシューマーを選択します。
- コンシューマーを追加をクリックします。
- カスタムアプリケーションの名前と説明を入力します。
- コールバックURLを設定します。
- デスクトップアプリケーションとヘッドレスマシンの場合、http://localhost:33333または任意のポート番号を使用します。ここで設定するURIがCallbackURLプロパティになります。
- Webアプリケーションの場合、信頼できるリダイレクトURLにコールバックURLを設定します。このURLは、ユーザーがアプリケーションにアクセスが許可されたことを確認するトークンを持って戻るWebの場所です。
- クライアント認証情報を使用して認証する予定の場合、これはプライベートコンシューマーですを選択する必要があります。ドライバーでは、AuthSchemeをclientに設定する必要があります。
- OAuthアプリケーションに与える権限を選択します。これにより、読み取りおよび書き込みできるデータが決まります。
- 新しいカスタムアプリケーションを保存するには、保存をクリックします。
- アプリケーションが保存された後、それを選択して設定を表示できます。アプリケーションのKeyとSecretが表示されます。これらを将来の使用のために記録してください。Keyを使用してOAuthClientIdを設定し、Secretを使用してOAuthClientSecretを設定します。
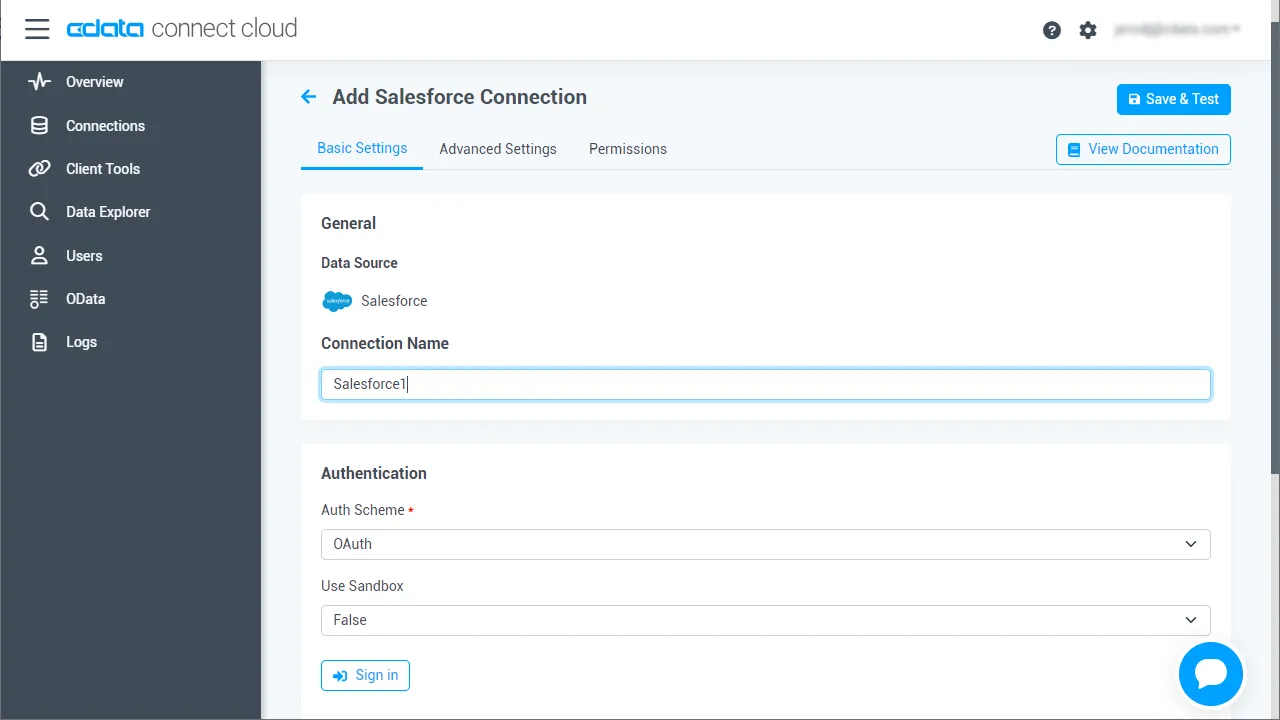
- 「Save & Test」をクリック
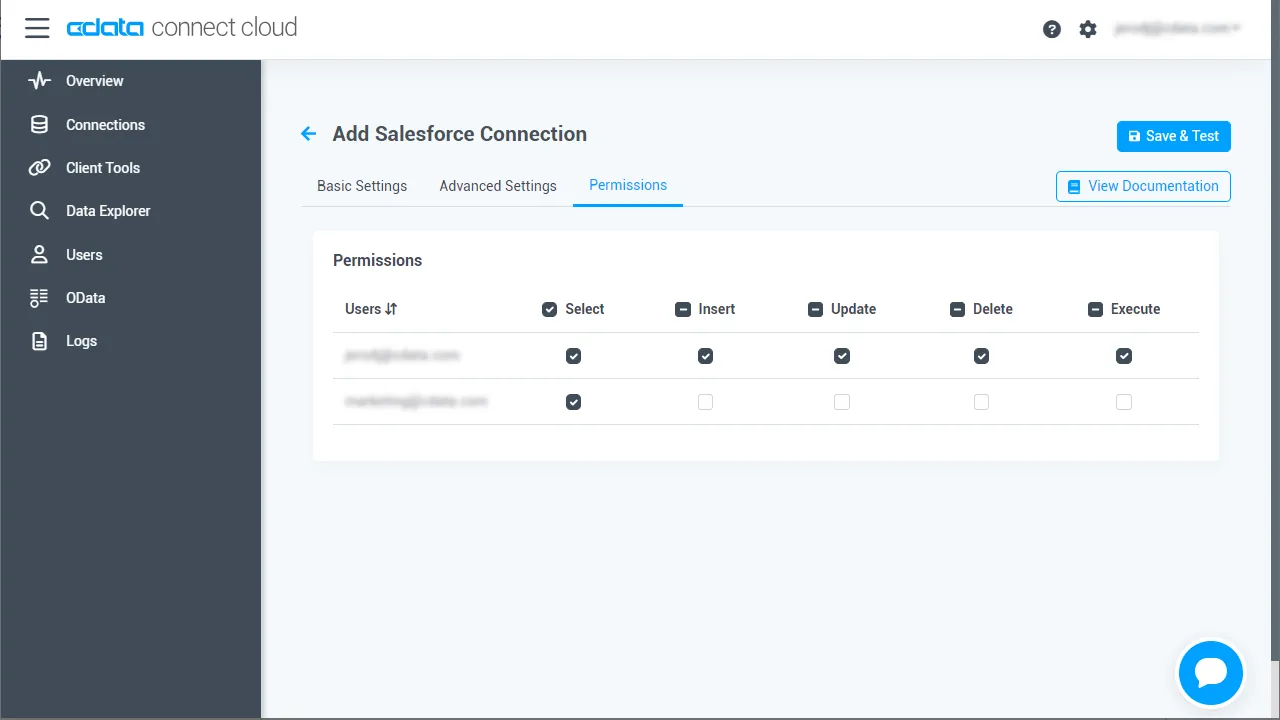
- 認証後、Bitbucket 接続の「Permissions」タブを開き、必要に応じてユーザーベースの権限を設定します
パーソナルアクセストークン(PAT)を生成
LangGraph はアカウントのメールアドレスとパーソナルアクセストークン(PAT)を使用して Connect AI に認証します。きめ細かなアクセス制御を維持するため、統合ごとに個別の PAT を作成することをお勧めします。
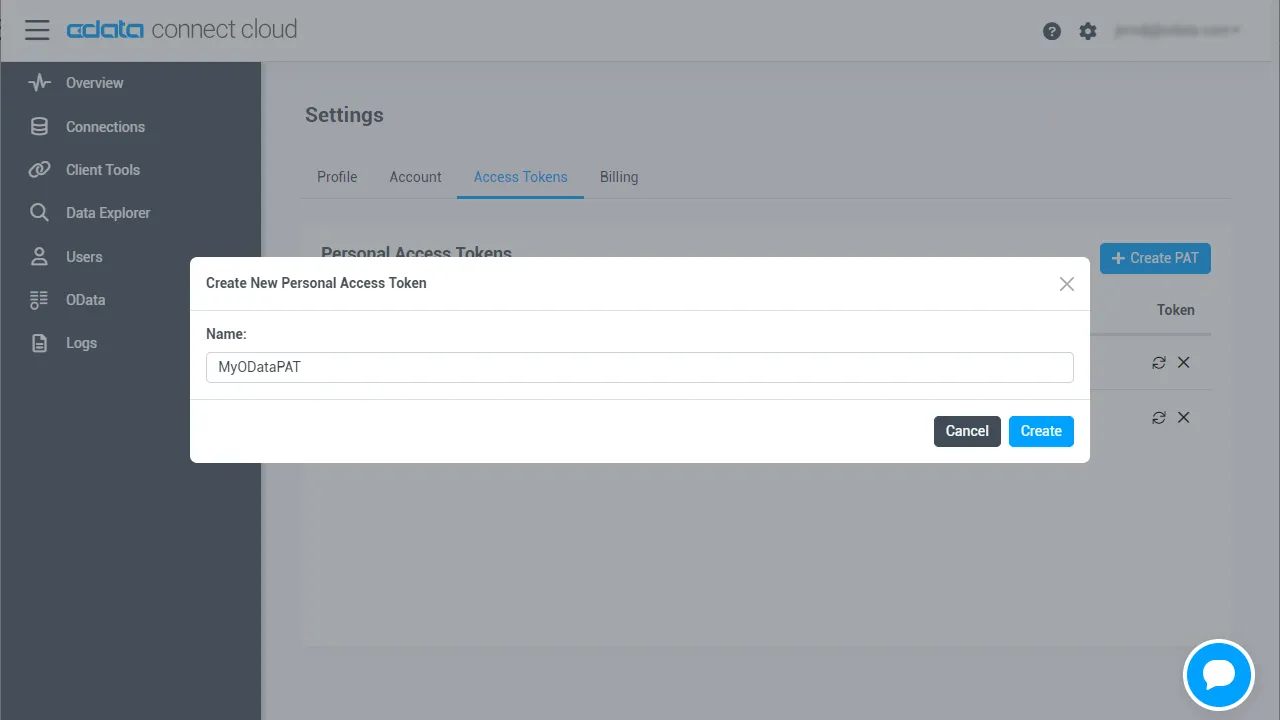
- Connect AI で、右上の「歯車アイコン」を選択して「Settings」を開きます
- 「Access Tokens」で「Create PAT」を選択します
- トークンにわかりやすい名前を付けて「Create」を選択します
- トークンをコピーして安全に保管します。PAT は作成時にのみ表示されます
Bitbucket 接続が設定され PAT が生成されたので、LangGraph は CData MCP サーバーを通じてBitbucket のデータに接続する準備が整いました。
ステップ2:開発環境をセットアップ
LangGraph と CData Connect AI を接続し、OpenAI LLM を推論に使用するためのプロジェクトディレクトリをセットアップし、必要な依存関係をインストールします。このセットアップにより、LangGraph は Connect AI が公開する Bitbucket MCP サーバーツールを呼び出し、OpenAI が自然言語推論を処理できるようになります。
- LangGraph プロジェクト用の新しいフォルダを作成します:
mkdir LangGraph cd LangGraph - 必要な Python パッケージをインストールします:
pip install langgraph langchain-openai langchain-mcp-adapters python-dotenv "langgraph-cli[inmem]" - Python 3.10 以上と有効な OpenAI API キーが環境に設定されていることを確認します。
ステップ3:MCP 接続の環境変数を設定
LangGraph は環境変数を使用して CData Connect AI に接続し、API 認証情報と設定を定義します。これらの認証情報を .env ファイルに保存して、セキュアで再利用可能にします。LangGraph は実行時にこのファイルを自動的に読み込むため、スクリプトは機密情報をハードコードすることなく MCP サーバーに認証・通信できます。
- プロジェクトディレクトリに .env という新しいファイルを作成します。
- 以下の環境変数を追加して、LangGraph、CData Connect AI、OpenAI の設定を定義します:
# LangSmith(オプション) LANGSMITH_API_KEY=lsv2_pt_xxxx #LangSmith API Key LANGCHAIN_TRACING_V2=true LANGCHAIN_PROJECT=LangGraph-Demo # MCP 設定 MCP_BASE_URL=https://mcp.cloud.cdata.com/mcp #MCP サーバー URL MCP_AUTH=base64encoded(EMAIL:PAT) #Base64 エンコードされた Connect AI Email:PAT OPENAI_API_KEY=sk-proj-xxxx - ファイルを保存します。LangGraph はこれらの値を使用して CData Connect AI の Bitbucket MCP サーバーに認証し、Bitbucket のデータに接続し、推論用に OpenAI モデルを初期化します。
注意: Base64 エンコードされた認証文字列は、Base64 エンコードツールなどのオンライン Base64 エンコーダーを使用して生成できます。前提条件で取得した CData Connect AI のユーザー名と PAT をエンコードしてください。
ステップ4:LangGraph エージェントスクリプトを作成
このステップでは、LangGraph を CData Connect AI MCP サーバーに接続する Python スクリプトを作成します。スクリプトは getCatalogs、getSchemas、queryData などの利用可能な MCP ツールを取得し、LangGraph ワークフローを構築し、接続されたBitbucket のデータに対して自然言語プロンプトを実行します。
ワークフローは MCP を使用して Connect AI からリアルタイムのBitbucket のデータをセキュアに取得し、OpenAI GPT-4o を使用してそのデータを解釈・推論します。 また、後で LangGraph Studio で可視化できるようにグラフを公開します。
ファイルを作成
LangGraph プロジェクトフォルダ内に test.py という新しい Python ファイルを作成します。
以下のコードを追加
test.py に以下のスクリプトを使用します:
import asyncio
import os
import operator
from typing_extensions import TypedDict, Annotated
from dotenv import load_dotenv

from langgraph.graph import StateGraph, START, END
from langchain.agents import create_agent
from langchain_mcp_adapters.client import MultiServerMCPClient
from langchain_openai import ChatOpenAI
from langchain_core.messages import BaseMessage, HumanMessage

# Load environment variables
load_dotenv()

# Define the agent state
class AgentState(TypedDict):
    messages: Annotated[list[BaseMessage], operator.add]

# Define the async agent logic
async def run_agent(user_prompt: str) -> str:
    MCP_BASE_URL = os.getenv("MCP_BASE_URL")
    MCP_AUTH = os.getenv("MCP_AUTH")
    OPENAI_API_KEY = os.getenv("OPENAI_API_KEY")

    print("Connecting to the MCP server...")
    mcp_client = MultiServerMCPClient(
        connections={
            "default": {
                "transport": "streamable_http",
                "url": MCP_BASE_URL,
                "headers": {"Authorization": f"Basic {MCP_AUTH}"} if MCP_AUTH else {},
            }
        }
    )

    print("Loading available MCP tools...")
    all_mcp_tools = await mcp_client.get_tools()
    print(f"Loaded tools: {[tool.name for tool in all_mcp_tools]}")

    # Initialize the LLM
    llm = ChatOpenAI(model="gpt-4o", temperature=0.2, api_key=OPENAI_API_KEY)

    print("Creating the LangGraph agent...")
    agent = create_agent(
        model=llm,
        tools=all_mcp_tools,
        system_prompt="You are a helpful assistant. Use tools when needed."
    )

    # Build the workflow graph
    builder = StateGraph(AgentState)
    builder.add_node("agent", agent)
    builder.add_edge(START, "agent")
    builder.add_edge("agent", END)
    graph_instance = builder.compile()

    print(f"Processing user query: {user_prompt}\n")
    initial_state = {"messages": [HumanMessage(content=user_prompt)]}
    result = await graph_instance.ainvoke(initial_state)
    print(f"Agent Response:\n{result['messages'][-1].content}")

# Expose the graph for visualization
builder = StateGraph(AgentState)
builder.add_node(
    "agent",
    create_agent(
        model=ChatOpenAI(model="gpt-4o", temperature=0.2, api_key=os.getenv("OPENAI_API_KEY")),
        tools=[],
        system_prompt="You are a helpful assistant."
    )
)
builder.add_edge(START, "agent")
builder.add_edge("agent", END)
graph = builder.compile()

if __name__ == "__main__":
    import argparse
    parser = argparse.ArgumentParser()
    parser.add_argument("--serve", action="store_true", help="Run visualization server")
    args = parser.parse_args()

    if args.serve:
        print("To visualize the graph, run:")
        print("langgraph dev")
    else:
        asyncio.run(run_agent("List the first 2 catalogs available"))
ステップ5:LangGraph プロジェクトを設定
CLI がワークフローグラフと環境設定を認識できるように LangGraph プロジェクトを設定します。LangGraph Studio での使用またはローカル可視化実行中にグラフを登録する設定ファイルを作成します。
設定ファイルを作成
プロジェクトディレクトリに langgraph.json という新しいファイルを作成します。
以下の設定を追加
langgraph.json ファイルに以下の内容を使用します:
{
  "dependencies": ["."],
  "graphs": {
    "agent": "./test.py:graph"
  },
  "env": ".env"
}
ステップ6:LangGraph で Bitbucket をプロンプト(Connect AI 経由)
LangGraph 開発サーバーを実行して、LangGraph Studio でワークフローを表示し対話します。これにより、エージェントがプロンプトを処理し、ツールを呼び出し、MCP サーバーを通じてBitbucket のデータを取得する様子を直接可視化できます。
LangGraph 開発サーバーを起動
プロジェクトディレクトリでターミナルを開き、以下を実行します:
langgraph dev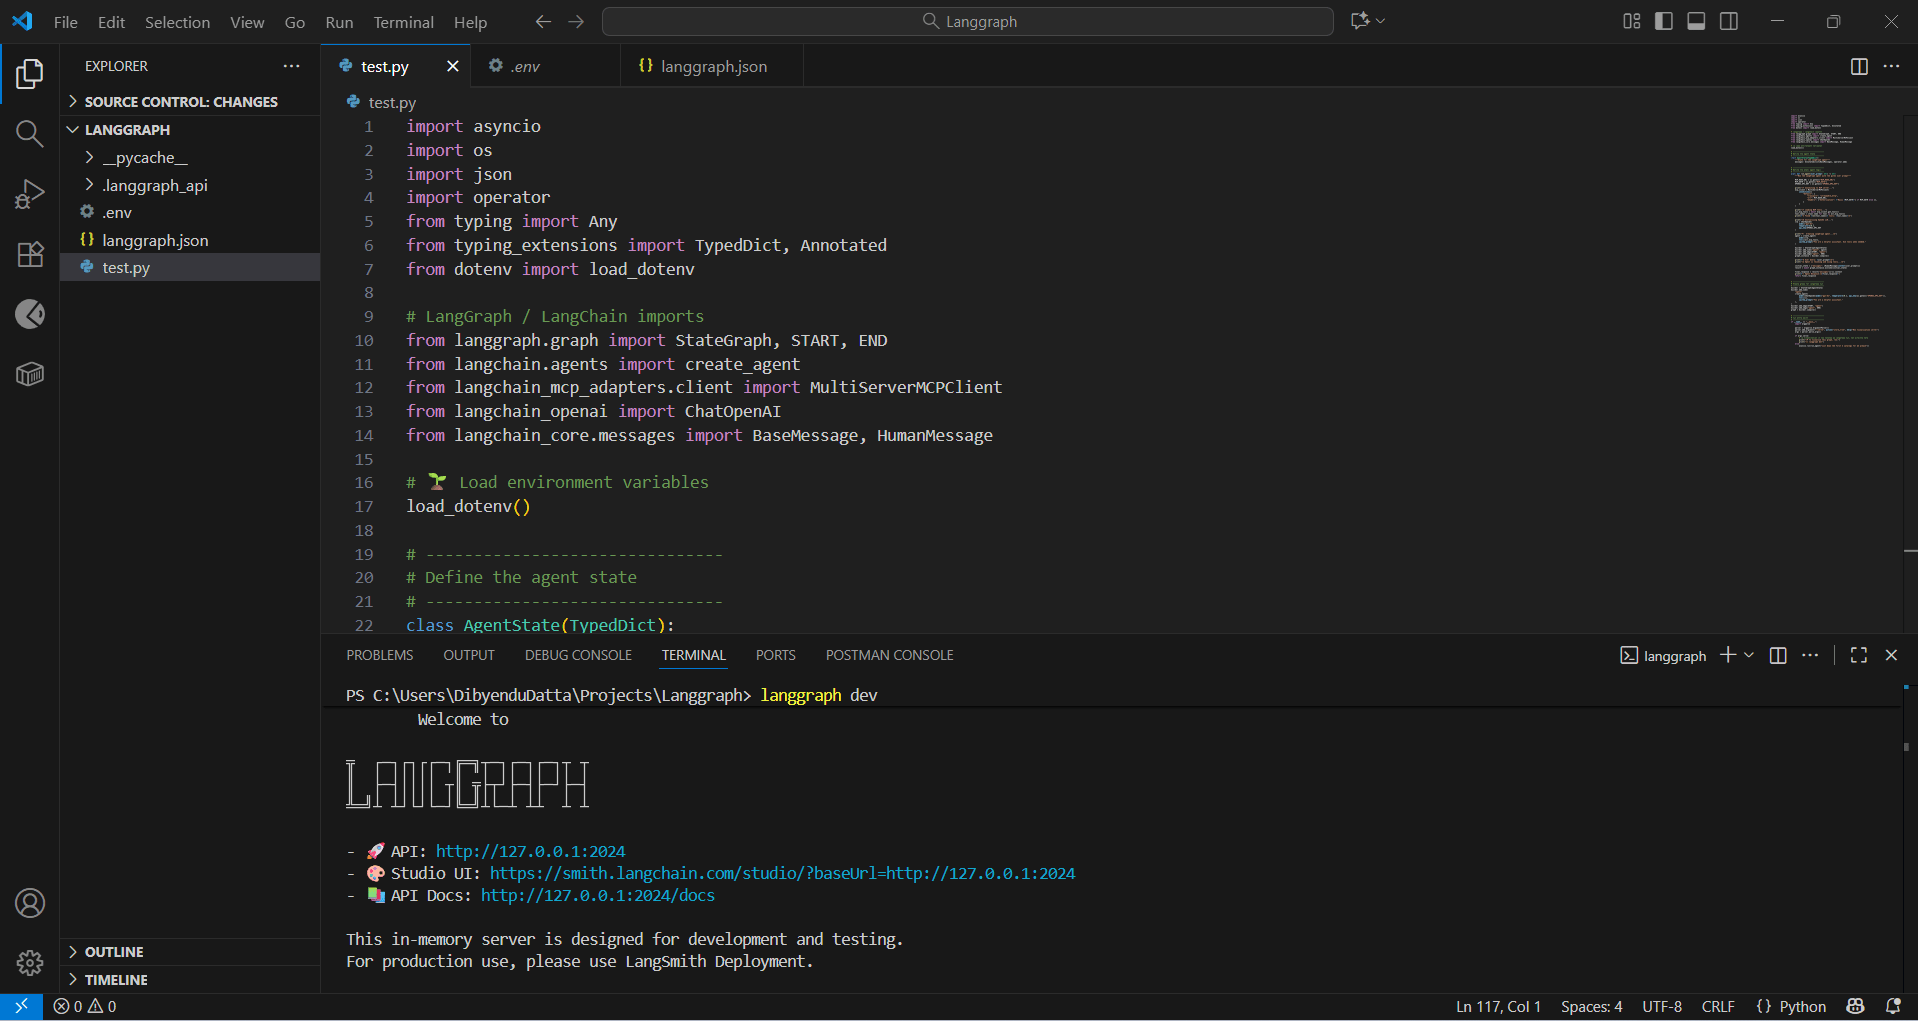
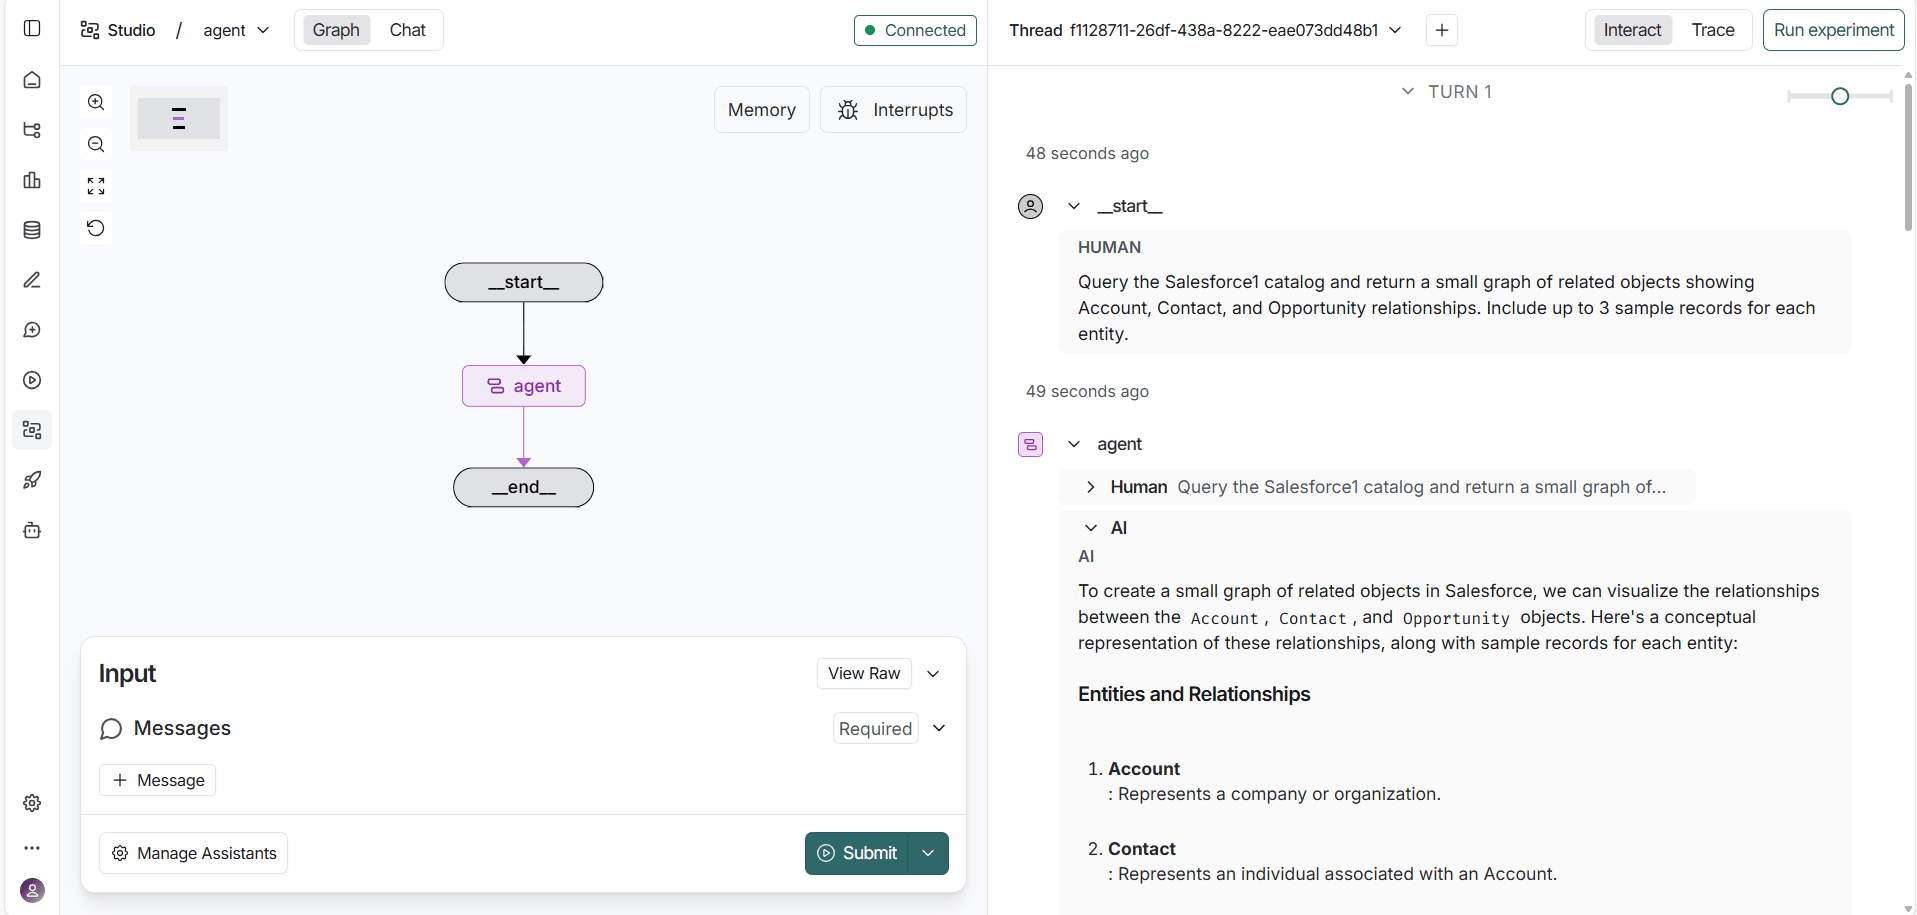
Studio インターフェースにアクセス
サーバーが起動すると、LangGraph はローカル API を起動し、Studio UI へのリンクを提供します:
https://smith.langchain.com/studio/?baseUrl=http://127.0.0.1:2024通常、コマンド実行時にリンクは自動的に開きます。開かない場合は、ブラウザでこのリンクを開いて LangGraph Studio ダッシュボードをロードしてください。
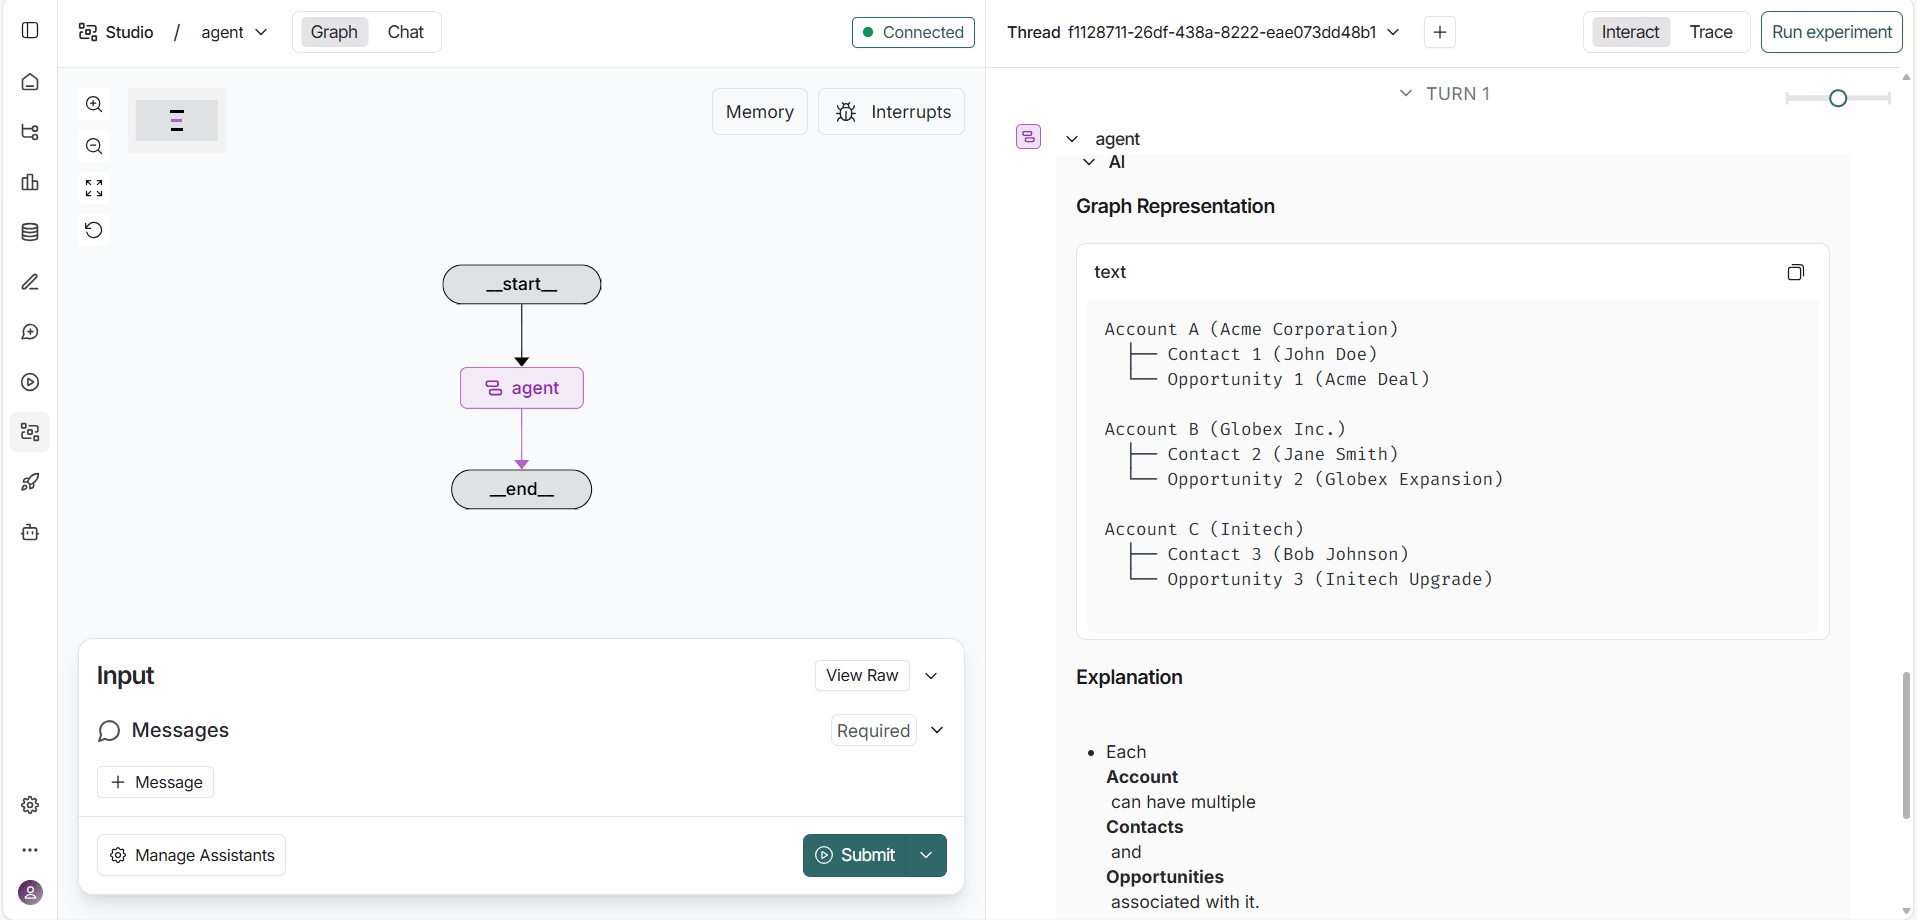
エージェントと対話
Studio インターフェースで、以下のような自然言語プロンプトを入力します:
カタログで利用可能なすべての Bitbucket テーブルを表示LangGraph はエージェントの推論フローをリアルタイムで可視化し、プロンプトの解釈、適切な MCP ツールの呼び出し、Bitbucket からのリアルタイムデータの取得の様子を表示します。
CData Connect AI を入手
数百種類の SaaS、ビッグデータ、NoSQL ソースへのリアルタイムデータアクセスをクラウドアプリケーションから直接取得するには、CData Connect AI を今すぐお試しください!