

自社システムのコンテキストを備えた、唯一のゲートウェイ
リクエストの背後にあるデータとアクセスルールを踏まえて、すべてのリクエストを最適なモデルへ、最適なコストで振り分けます。


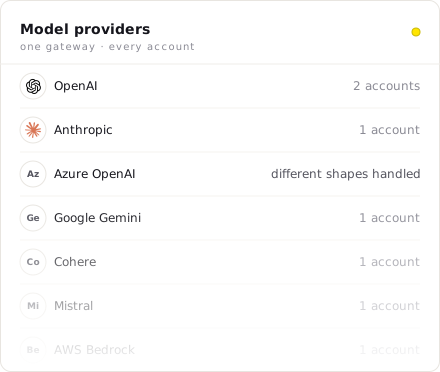
あらゆるプロバイダー、キー、コストを一元管理
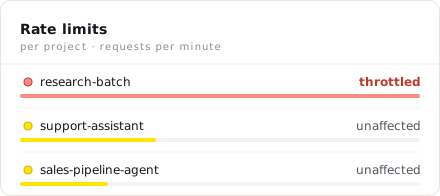
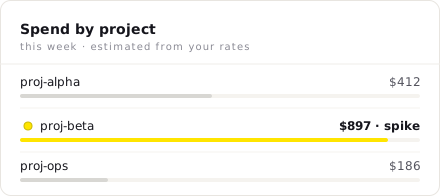
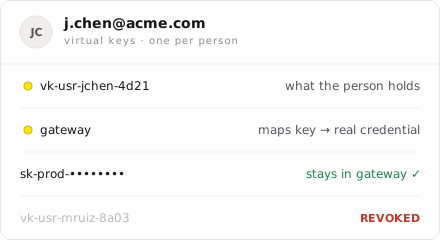
すべてのプロバイダーの前段に置く、1 つのエンドポイント。仮想キー、ハードリミット付きの予算、レート制限、個人・エージェント単位のコスト配分をすべて標準で備えています。
ルーティング、予算、フェイルオーバーを一元管理
ポリシーはゲートウェイで一度定義するだけ。ユーザー、チーム、部門など、AI を管理するあらゆる階層で、すべてのリクエストに適用されます。
部門、チーム、ユーザーごとにデフォルトモデルを設定
デフォルトモデルは、部門、チーム、ユーザーのどの階層でも設定できます。設定は下位の階層へ引き継がれ、必要に応じて下位で上書きすることも可能です。一度変更すれば、対象範囲内のすべてのエージェントに反映されます。
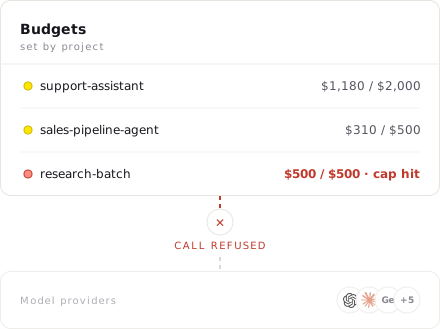
コストが発生する前に止める上限設定
部門、チーム、ユーザーごとに、専用の予算とレート制限をハードリミットまたはソフトリミットで設定できます。あるチームの試行錯誤が別のチームの予算を圧迫することはなく、想定外の請求に驚かされることもありません。
プロバイダーに障害が起きても、誰も気づかない
フォールバックの順序は一度設定するだけ。プロバイダーの品質が低下すると、リクエストはコンテキストを保ったまま正常なモデルへスムーズに切り替わり、何事もなかったかのように作業が続きます。
 gpt-5
品質低下
 sonnet-4.5
稼働中
すべてのリクエストにガバナンスを適用
すべての呼び出しは、プロバイダーに届く前に、スコープ、モデル、予算、フォールバックがゲートウェイで決定されます。
階層的に継承されるスコープ
1 回の変更で、数千のエージェントを管理できます。部門、チーム、ユーザーのいずれかの階層でポリシーを設定すれば、対象範囲内のすべてに即座に反映されます。エージェントごとに設定を追いかける必要はありません。
スコープごとに独立した台帳
想定外の請求について、説明に追われることはもうありません。スコープごとに利用状況を記録する専用の台帳があり、ソフトリミットでは警告を出し、ハードリミットではコストが発生する前に停止します。
継続的なヘルスチェック
プロバイダーが停止しても、エージェントは動き続けます。ゲートウェイはすべてのプロバイダーを監視し、品質低下を検知した瞬間に再ルーティングします。エンドユーザーが障害を体感することはありません。
既存環境にそのまま導入可能
エージェントを 1 つも書き換えることなく導入できます。OpenAI および Anthropic と互換性があるため、移行はベース URL と API キーを変更するだけ。主要なプロバイダーからオープンウェイトモデルまで、そのまま前段に配置できます。
自社のビジネスコンテキストを、あらゆるモデルに
ゲートウェイは、モデルに届く前に各呼び出しをコンテキストエンジンでグラウンディングします。そのため、より少なく、より安価なトークンで済みます。
コンテキストを 1 つのグラフに集約
スキーマ、データモデル、セマンティック定義、社内のナレッジを、エージェントが知っておくべき情報として 1 つのグラフに統合します。
あらゆるモデルに適用
コンテキストは特定のモデルではなく、ゲートウェイに保持されます。Claude、GPT、Gemini のどれを使っても同じ理解が適用され、フェイルオーバーの際にも引き継がれます。
処理はモデルではなくエンジンで
データはプラットフォーム内で処理され、モデルには質問に必要な情報だけが渡されます。トークンを節約でき、探索のステップも不要です。
リクエストがルーティングされるまで
すべての呼び出しは、プロバイダーに届く前に、スコープ、モデル、予算、フォールバックがゲートウェイで決定されます。1 件のリクエストの中で、4 つの判断が行われます。
ゲートウェイが呼び出し元を特定
リクエストには、呼び出し元のアイデンティティが含まれています。ゲートウェイはモデルを選ぶ前に、それをユーザー、チーム、部門というスコープの階層に対応付けます。
ルーティングルールがモデルを選択
最も限定的なルールが優先されます。優先順位は、ユーザー単位の固定、チームによるオーバーライド、部門のデフォルトの順です。選ばれたモデルと、その根拠となったルールはリクエストに記録されます。
呼び出しの前に予算をチェック
トークンを消費する前に、スコープの台帳を確認します。ソフトリミットでは警告付きでリクエストを続行し、ハードリミットに達した場合は 402 を返します。想定外の請求が発生することはありません。
ヘルスチェックを経て、フォールバックを備えた状態で呼び出し
選ばれたプロバイダーの品質が低下している場合、リクエストは即座にフォールバックリストの次の候補へ移ります。共有コンテキストも一緒に引き継がれるため、どのモデルが応答しても回答の品質は変わりません。
リクエストのたびに、賢くなる
すべてのリクエストがゲートウェイを通過するため、その背後にあるコンテキストは継続的に改善されていきます。リクエストを中継するだけのゲートウェイでは実現できない、自己学習ループです。
自己学習の仕組みを見る会話から得られるシグナル
ユーザーが意図と異なる切り口の結果を受け取って修正すると、ループはその意図を最終的にうまくいったクエリとひも付け、背後にある概念の定義を更新します。
クエリマイニング
よく参照されるテーブル、頻繁に使われる結合パス、よく使われるフィルターが時間とともに浮かび上がり、実際の利用状況をもとに検索の精度が高まっていきます。
人が関与しながら、洗練と整合を重ねる
エンジンは定期的に自己レビューを行い、矛盾や抜け漏れを洗い出します。学習による変更はレビュー可能な差分として提示され、オーナーが承認します。解決できないものは、適切な担当者に引き継がれます。
Model Gateway の枠を超えて
AI 導入に必要なすべてを 1 つに
Model Gateway は、制御とセキュリティ、コンテキストエンジン、リアルタイムのデータレイヤーという基盤の上に構築されたプラットフォームの一部です。AI の導入に必要なものを個別に組み合わせる必要はなく、1 つのプラットフォームですべてそろいます。
AI Gateway の詳細を見る Copilot
Claude
 ChatGPT
 Perplexity
 Agentforce
 LangChain
 CrewAI
 n8n
Model・MCP・Agent Gateway(ルーティング、ガードレール、コスト管理)
アイデンティティ、ポリシー、ガードレールをすべてのステップで適用
社内のナレッジ、セマンティクス、スキーマをすべてのリクエストに付与
数百の企業向けデータソースへのリアルタイムな読み取り・書き込み
 Salesforce
 SAP
 Snowflake
 NetSuite
 Databricks
 HubSpot
Sonnet
GPT-5
 Gemini
 Grok
 DeepSeek
CIO、Anaqua
1 つのエンドポイントで、すべてのモデルを完全に制御。
ユーザー、チーム、部門ごとのルーティング、あらゆる階層でのコスト上限、プロバイダーをまたいだフェイルオーバー。そのすべてを、コンテキストを保ったまま Model Gateway から実現できます。