

CData Connect AI 経由でPostgreSQL インターフェースからリアルタイムの Kafka のデータに接続
インターネット上には数多くのPostgreSQL クライアントがあります。PostgreSQL はデータアクセスのための一般的なインターフェースです。PostgreSQL をCData Connect AI と組み合わせることで、PostgreSQL からリアルタイムのKafka のデータにデータベースのようにアクセスできます。この記事では、Connect AI でKafka のデータに接続し、TDS foreign data wrapper(FDW)を使用してConnect AI とPostgreSQL 間の接続を確立するプロセスを説明します。
CData Connect AI は Kafka 専用のSQL Server インターフェースを提供し、ネイティブでサポートされているデータベースにデータをレプリケートすることなく Kafka のデータをクエリできます。最適化されたデータ処理を標準で使用し、CData Connect AI はサポートされているすべてのSQL 操作(フィルター、JOIN など)を Kafka に直接プッシュし、サーバーサイド処理を活用して必要なKafka のデータを迅速に返します。
Connect AI で Kafka に接続
CData Connect AI は、シンプルなポイント&クリック操作でデータソースに接続できるインターフェースを提供しています。
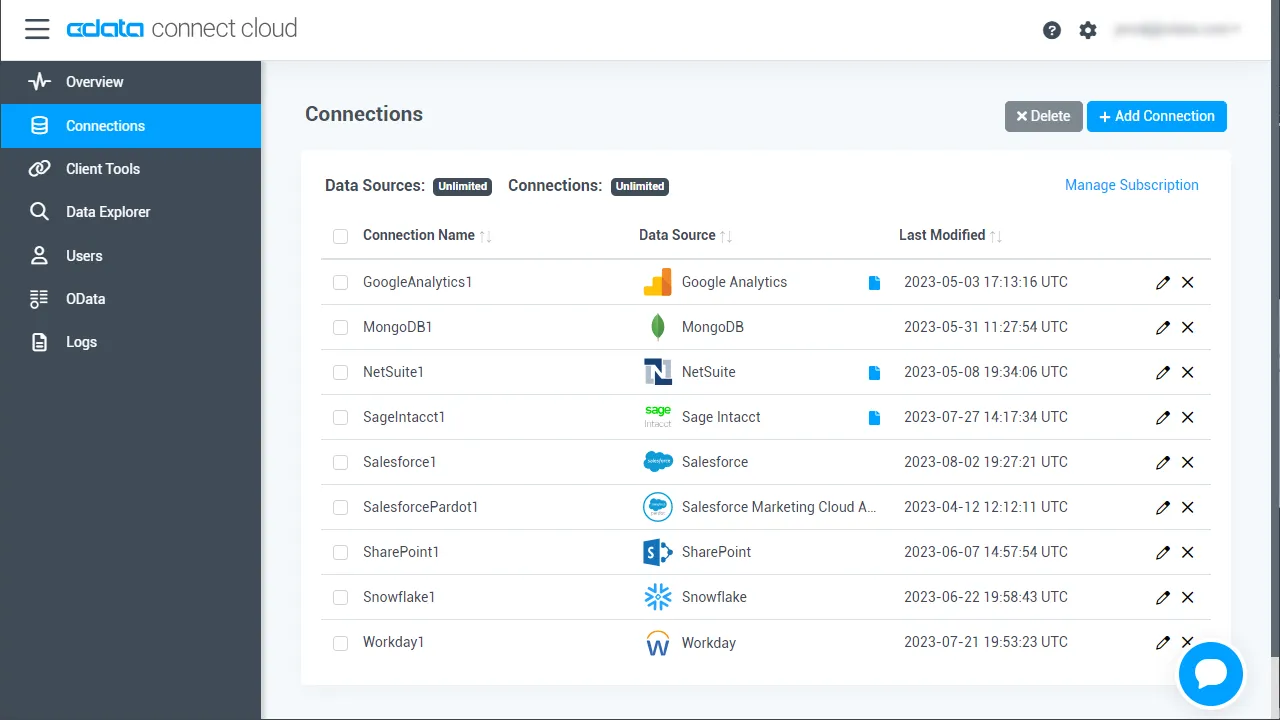
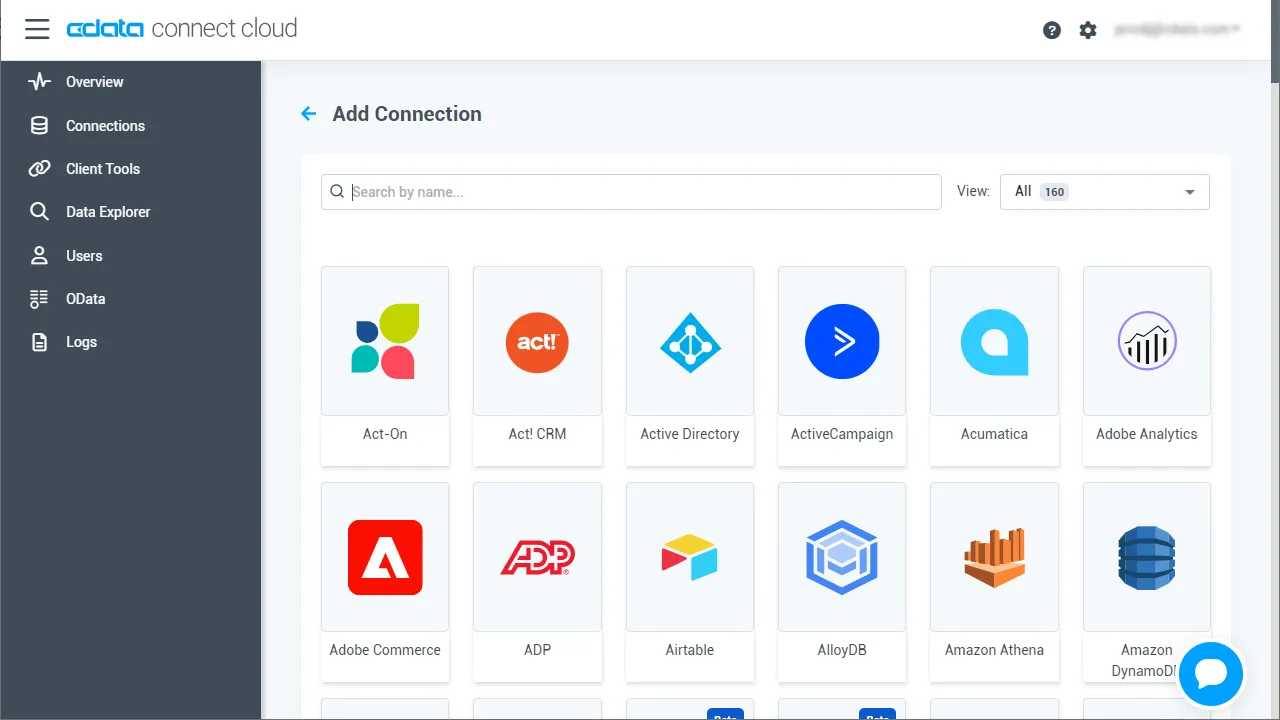
- Connect AI にログインして「Sources」をクリックし、 Add Connection をクリックします
- Add Connection パネルから「Kafka」を選択します
-
Kafka への接続に必要な認証プロパティを入力します。
Apache Kafka 接続プロパティの取得・設定方法
それでは、Apache Kafka に接続していきましょう。.NET ベースのエディションは、Confluent.Kafka およびlibrdkafka ライブラリに依存して機能します。 これらのアセンブリはインストーラーにバンドルされており、CData 製品と一緒に自動的にインストールされます。 別のインストール方法をご利用の場合は、NuGet から依存関係のあるConfluent.Kafka 2.6.0をインストールしてください。
Apache Kafka サーバーのアドレスを指定するには、BootstrapServers パラメータを使用します。
デフォルトでは、CData 製品はデータソースとPLAINTEXT で通信しており、そのため、データはすべて暗号化されずに送信されます。 通信を暗号化したい場合は、以下の設定を行ってください:
- UseSSL をtrue に設定し、CData 製品がSSL 暗号化を使用するように構成します
- SSLServerCert およびSSLServerCertType を設定して、サーバー証明書をロードします
Apache Kafka への認証
続いて、認証方法を設定しましょう。Apache Kafka データソースでは、以下の認証方法をサポートしています:
- Anonymous
- Plain
- SCRAM ログインモジュール
- SSL クライアント証明書
- Kerberos
Anonymous 認証
Apache Kafka の特定のオンプレミスデプロイメントでは、認証接続プロパティを設定することなくApache Kafka に接続できます。 このような接続はanonymous(匿名)と呼ばれます。
匿名認証を行うには、以下のプロパティを設定してください。
- AuthScheme:None
その他の認証方法については、ヘルプドキュメントをご確認ください。
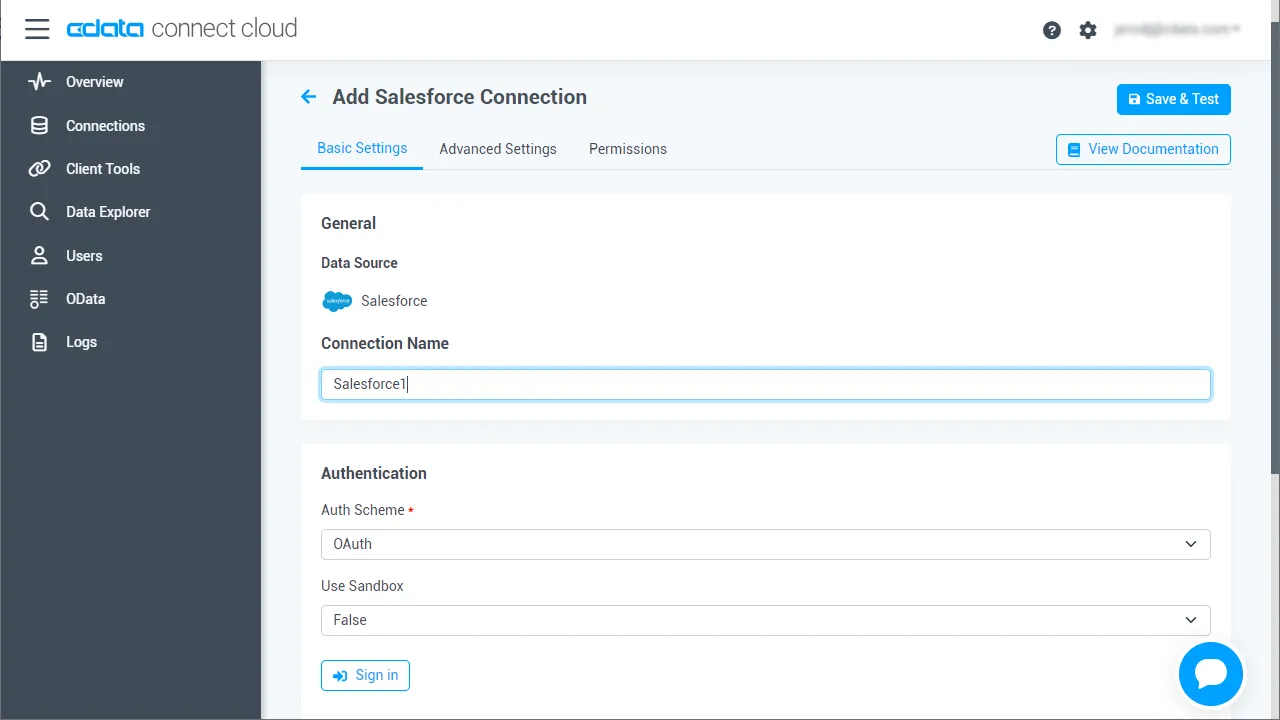
- Save & Test をクリックします
-
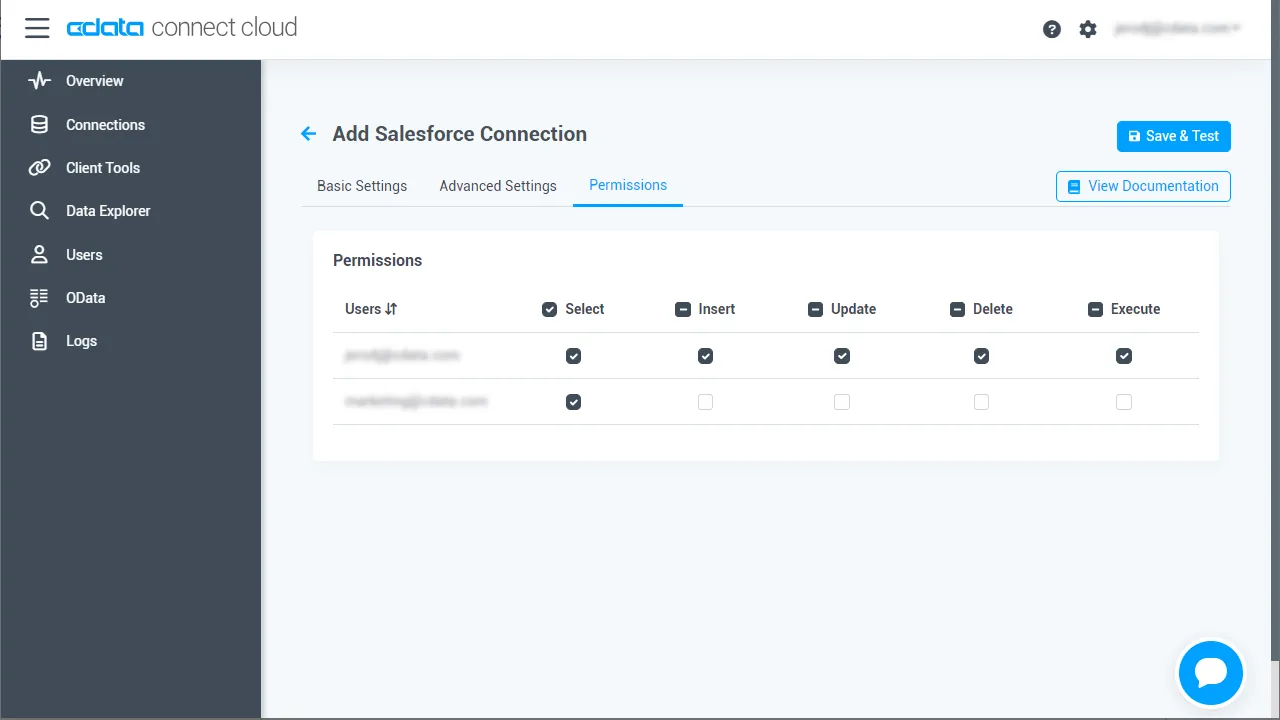
Add Kafka Connection ページの「Permissions」タブに移動し、ユーザーベースの権限を更新します。
Personal Access Token の追加
REST API、OData API、またはVirtual SQL Server 経由でConnect AI に接続する場合、Personal Access Token(PAT)を使用してConnect AI への接続を認証します。アクセス管理の粒度を維持するために、サービスごとに個別のPAT を作成することをお勧めします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして設定ページを開きます。
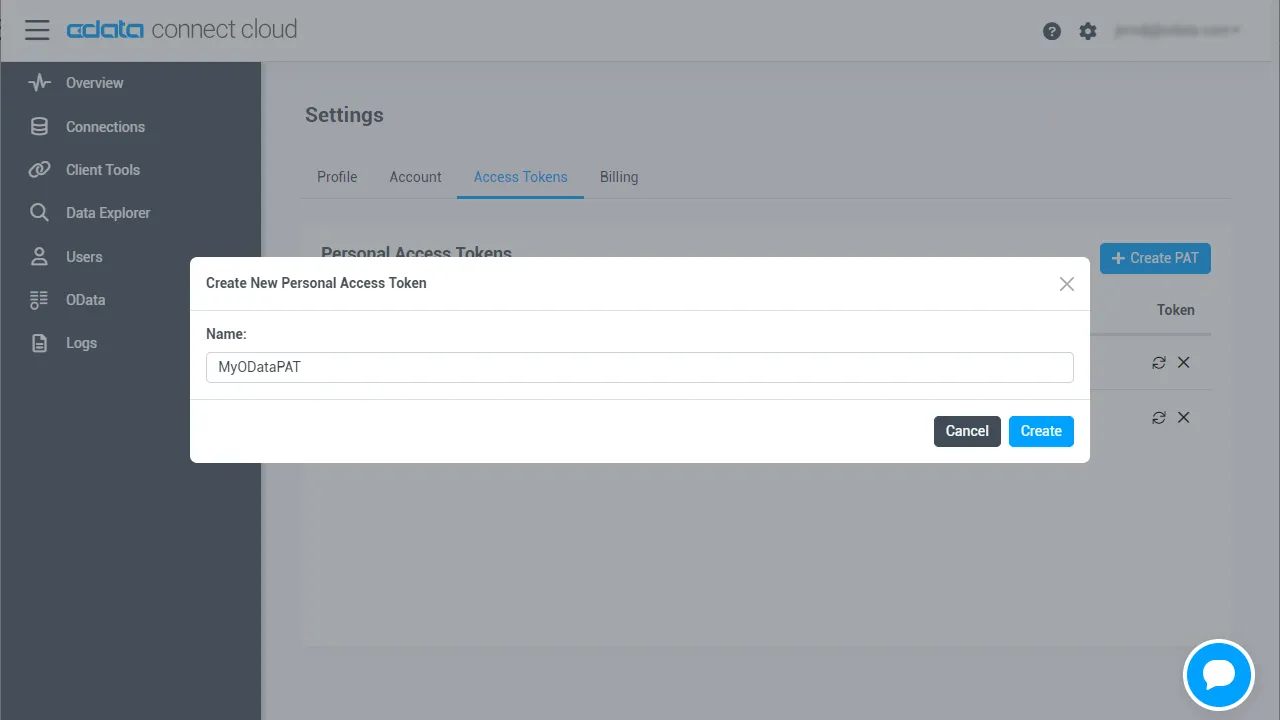
- Settings ページで「Access Tokens」セクションに移動し、 Create PAT をクリックします。
-
PAT に名前を付けて「Create」をクリックします。
- Personal Access Token は作成時にのみ表示されるため、必ずコピーして安全な場所に保存してください。
接続の設定とPAT の生成が完了したら、PostgreSQL からKafka のデータに接続する準備が整いました。
TDS Foreign Data Wrapper のビルド
Foreign Data Wrapper は、PostgreSQL を再コンパイルすることなく、PostgreSQL の拡張機能としてインストールできます。例として tds_fdw 拡張機能を使用します(https://github.com/tds-fdw/tds_fdw)。
- 以下のようにgit リポジトリをクローンしてビルドできます:
注意:複数のPostgreSQL バージョンがあり、デフォルト以外のバージョン用にビルドする場合は、まずpg_config のバイナリの場所を見つけてフルパスをメモし、make コマンドでUSE_PGXS=1 の後にPG_CONFIG=sudo apt-get install git git clone https://github.com/tds-fdw/tds_fdw.git cd tds_fdw make USE_PGXS=1 sudo make USE_PGXS=1 installを追加します。 - インストールが完了したら、サーバーを起動します:
sudo service postgresql start - 次に、Postgres データベースに入ります
注意:localhost の代わりにPostgreSQL がホストされているIP を指定することもできます。psql -h localhost -U postgres -d postgres
PostgreSQL データベースとしてKafka のデータに接続し、データをクエリ!
拡張機能をインストールした後、以下の手順に従ってKafka のデータへのクエリを開始します:
- データベースにログインします。
- データベース用の拡張機能をロードします:
CREATE EXTENSION tds_fdw; - Kafka のデータ 用のサーバーオブジェクトを作成します:
CREATE SERVER "ApacheKafka1" FOREIGN DATA WRAPPER tds_fdw OPTIONS (servername'tds.cdata.com', port '14333', database 'ApacheKafka1'); - Connect AI アカウントのメールアドレスとPersonal Access Token を使用してユーザーマッピングを設定します:
CREATE USER MAPPING for postgres SERVER "ApacheKafka1" OPTIONS (username '[email protected]', password 'your_personal_access_token' ); - ローカルスキーマを作成します:
CREATE SCHEMA "ApacheKafka1"; - ローカルデータベースに外部テーブルを作成します:
#table_name 定義を使用: CREATE FOREIGN TABLE "ApacheKafka1".SampleTable_1 ( id varchar, Column1 varchar) SERVER "ApacheKafka1" OPTIONS(table_name 'ApacheKafka.SampleTable_1', row_estimate_method 'showplan_all'); #またはschema_name とtable_name 定義を使用: CREATE FOREIGN TABLE "ApacheKafka1".SampleTable_1 ( id varchar, Column1 varchar) SERVER "ApacheKafka1" OPTIONS (schema_name 'ApacheKafka', table_name 'SampleTable_1', row_estimate_method 'showplan_all'); #またはquery 定義を使用: CREATE FOREIGN TABLE "ApacheKafka1".SampleTable_1 ( id varchar, Column1 varchar) SERVER "ApacheKafka1" OPTIONS (query 'SELECT * FROM ApacheKafka.SampleTable_1', row_estimate_method 'showplan_all'); #またはリモートカラム名を設定: CREATE FOREIGN TABLE "ApacheKafka1".SampleTable_1 ( id varchar, col2 varchar OPTIONS (column_name 'Column1')) SERVER "ApacheKafka1" OPTIONS (schema_name 'ApacheKafka', table_name 'SampleTable_1', row_estimate_method 'showplan_all'); - これで、Kafka に対して読み取り/書き込みコマンドを実行できます:
SELECT id, Column1
FROM "ApacheKafka1".SampleTable_1;
詳細情報と無償トライアル
これで、リアルタイムのKafka のデータからシンプルなクエリを作成できました。Kafka(およびその他200以上のデータソース)への接続の詳細については、Connect AI ページをご覧ください。無償トライアルに登録して、今すぐPostgreSQL でリアルタイムのKafka のデータを活用してみてください。