



Sage X3 Cloud のデータ を Microsoft Fabric の OneLake に自動で継続的にレプリケーションする方法
常時稼働のアプリケーションには、自動フェイルオーバー機能とリアルタイムのデータアクセスが欠かせません。CData Sync を使えば、Microsoft Fabric の OneLake インスタンスにSage X3 Cloud のデータをリアルタイムで統合できます。すべてのデータを1カ所に集約し、アーカイブ、レポーティング、分析、機械学習、AI などさまざまな用途に活用できます。
OneLake を同期先として設定する
CData Sync を使って、Sage X3 Cloud のデータ を OneLake にレプリケーションできます。同期先を追加するには、接続タブに移動します。
- 接続の追加をクリックします。
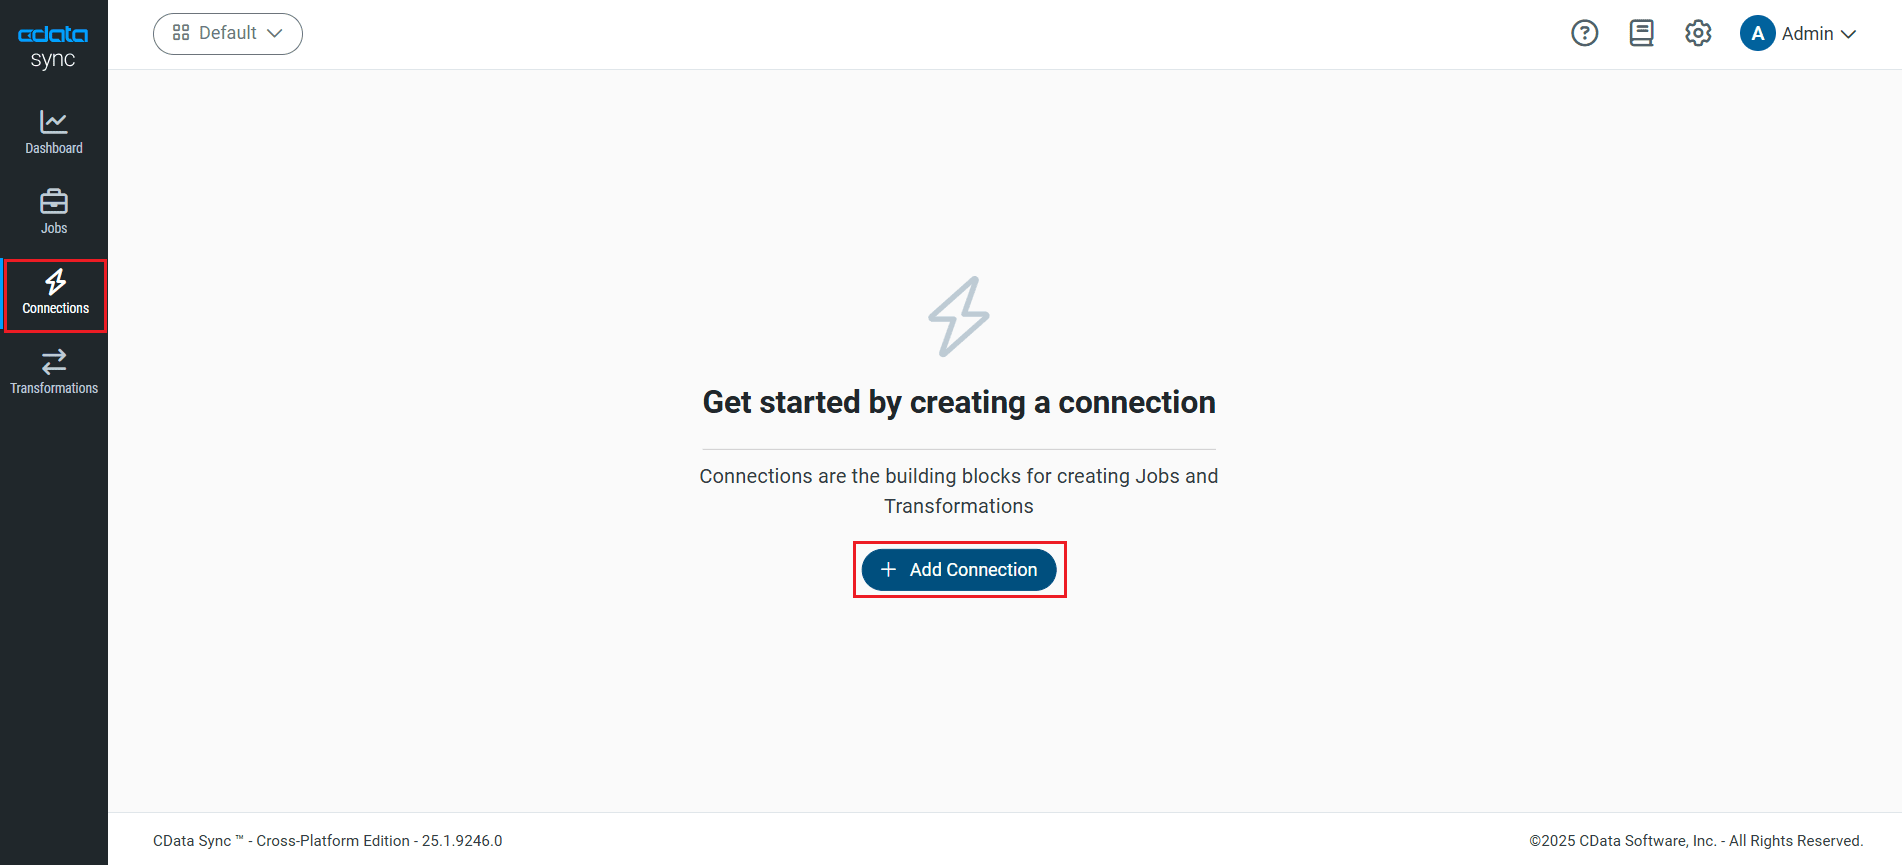
- 同期先タブをクリックし、Microsoft OneLake コネクタを探します。
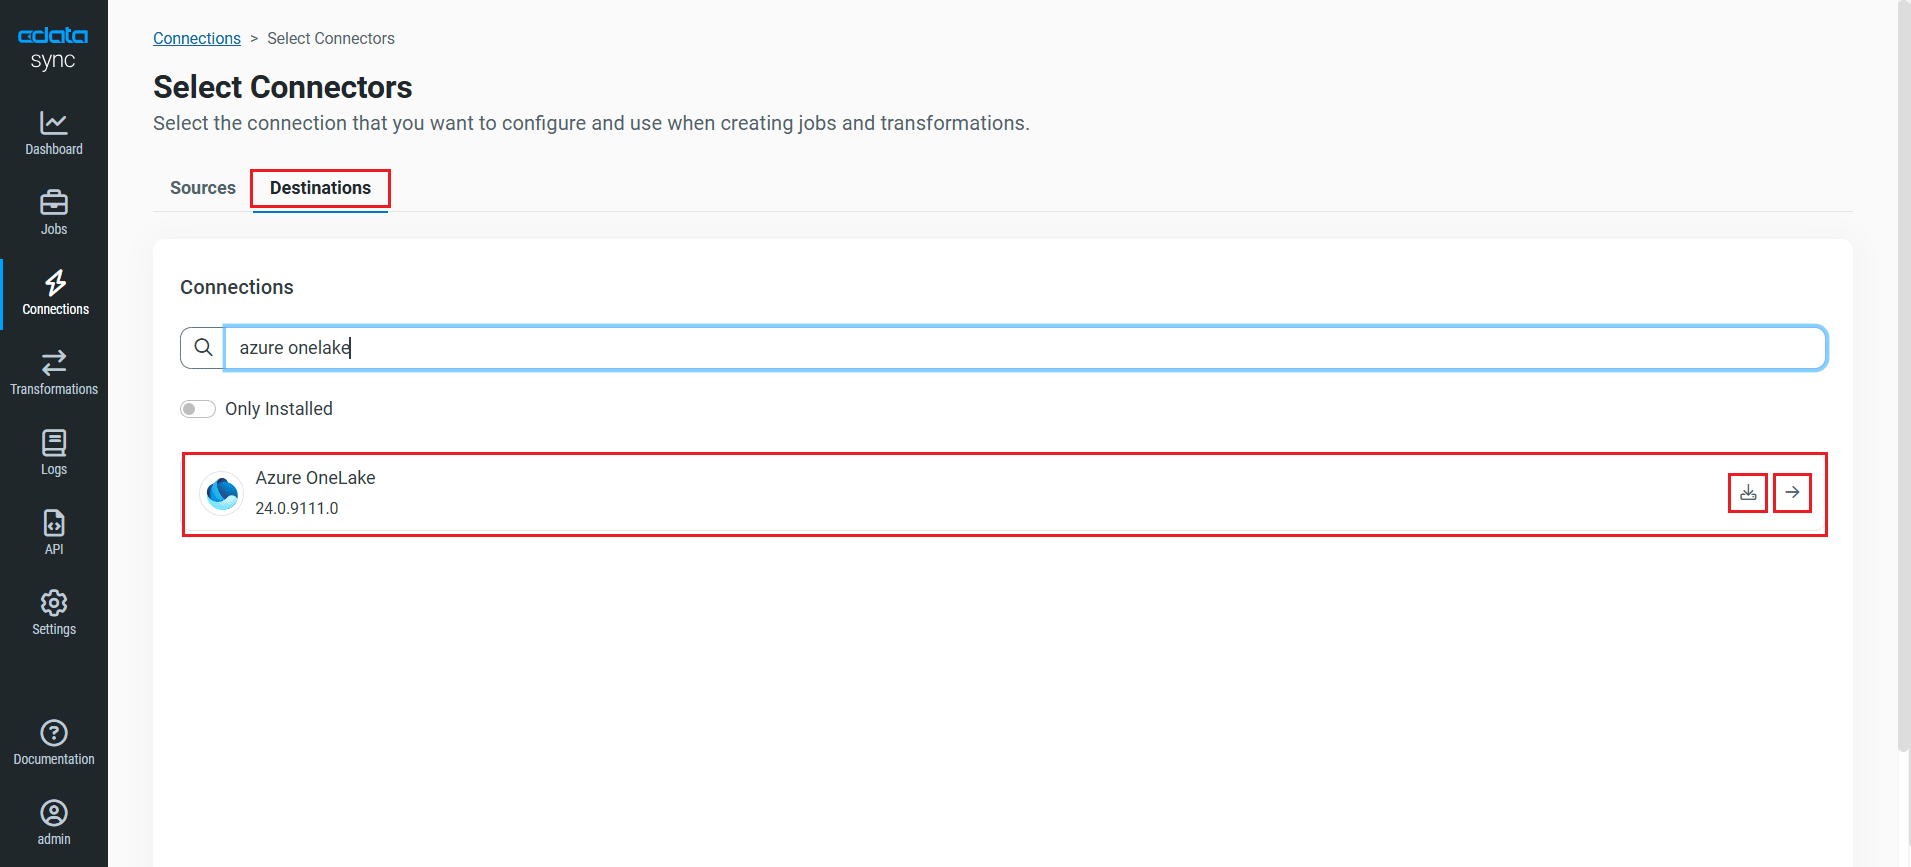
- 該当行の末尾にある接続の設定アイコンをクリックして、新しい接続ページを開きます。接続の設定アイコンが表示されていない場合は、コネクタのダウンロードアイコンをクリックして OneLake コネクタをインストールします。新しいコネクタのインストールについて詳しくは、ヘルプドキュメントの「接続」セクションをご覧ください。
- コネクタが追加されたら、設定の基本タブで以下の接続プロパティを入力して OneLake に接続します:
- 接続名:任意の接続名を入力します。
- File Format:使用するファイル形式を選択します。Sync は CSV、PARQUET、AVRO ファイル形式をサポートしています。
- URI:ファイルを含むファイルシステムとフォルダのパスを入力します(例:onelake://Workspace/Test.LakeHouse/Files/CustomFolder)。
- Auth Scheme:Microsoft Entra ID ユーザーアカウントで接続する場合は、Auth Scheme にAzure ADを選択します。CData Sync には組み込みの OAuth アプリケーションが用意されているため、追加のプロパティ設定は不要です。
- Data Model:選択したファイル形式のドキュメントを解析し、データベースメタデータを生成する際に使用するデータ形式を指定します。
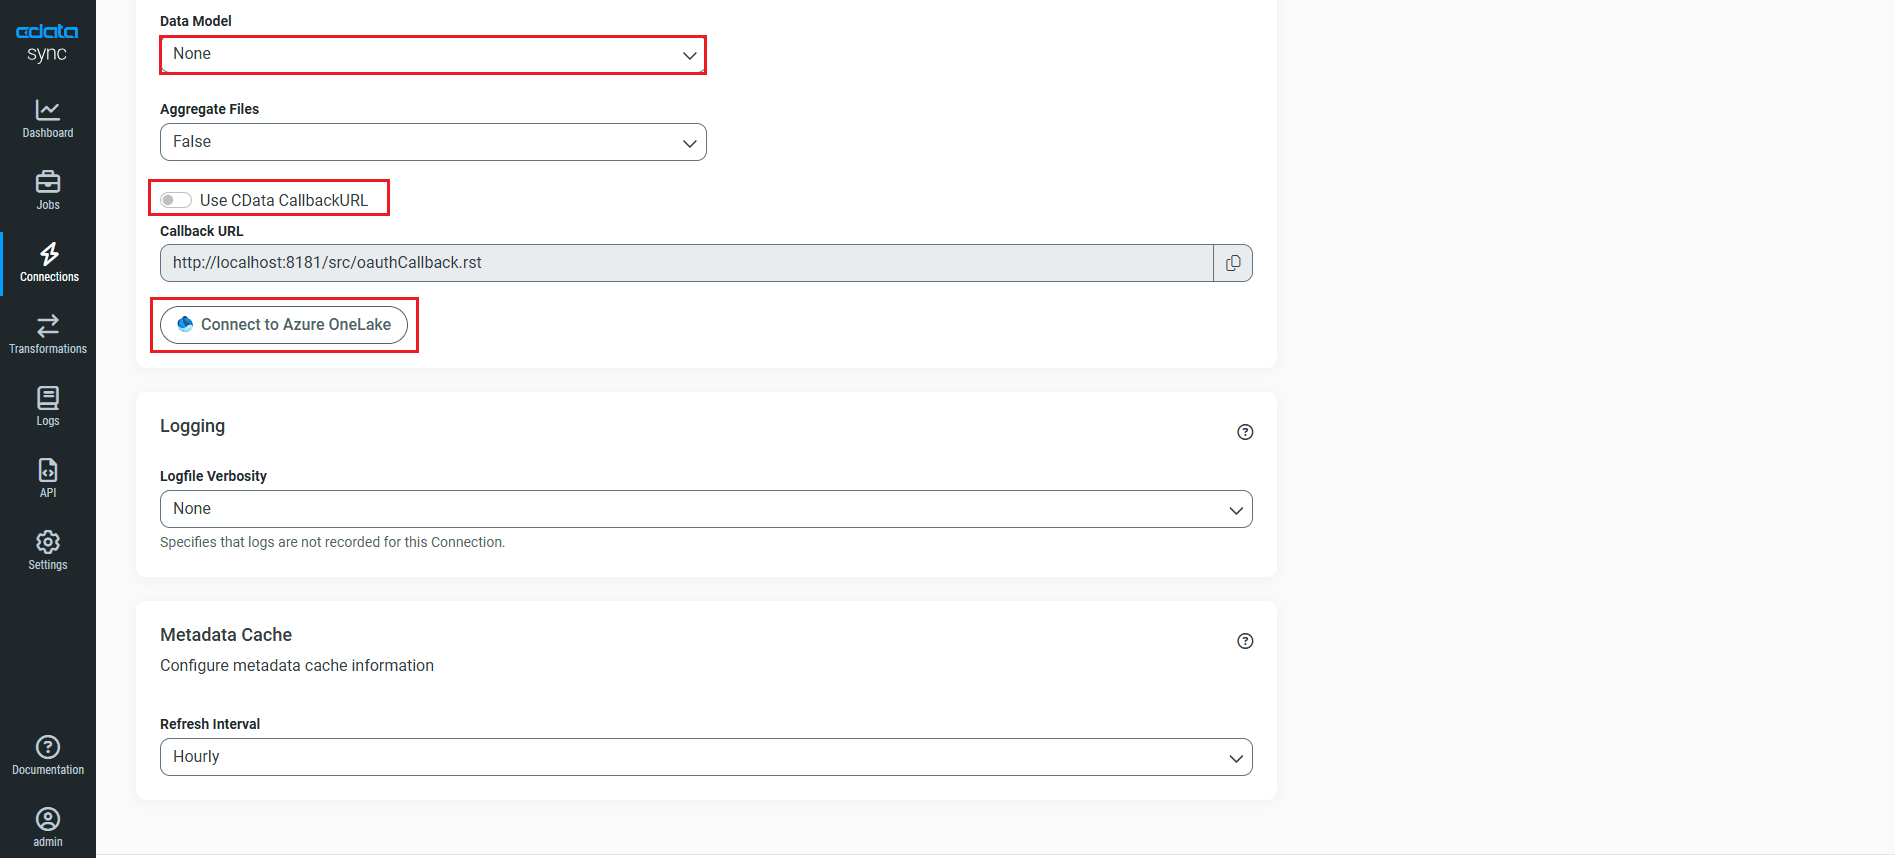
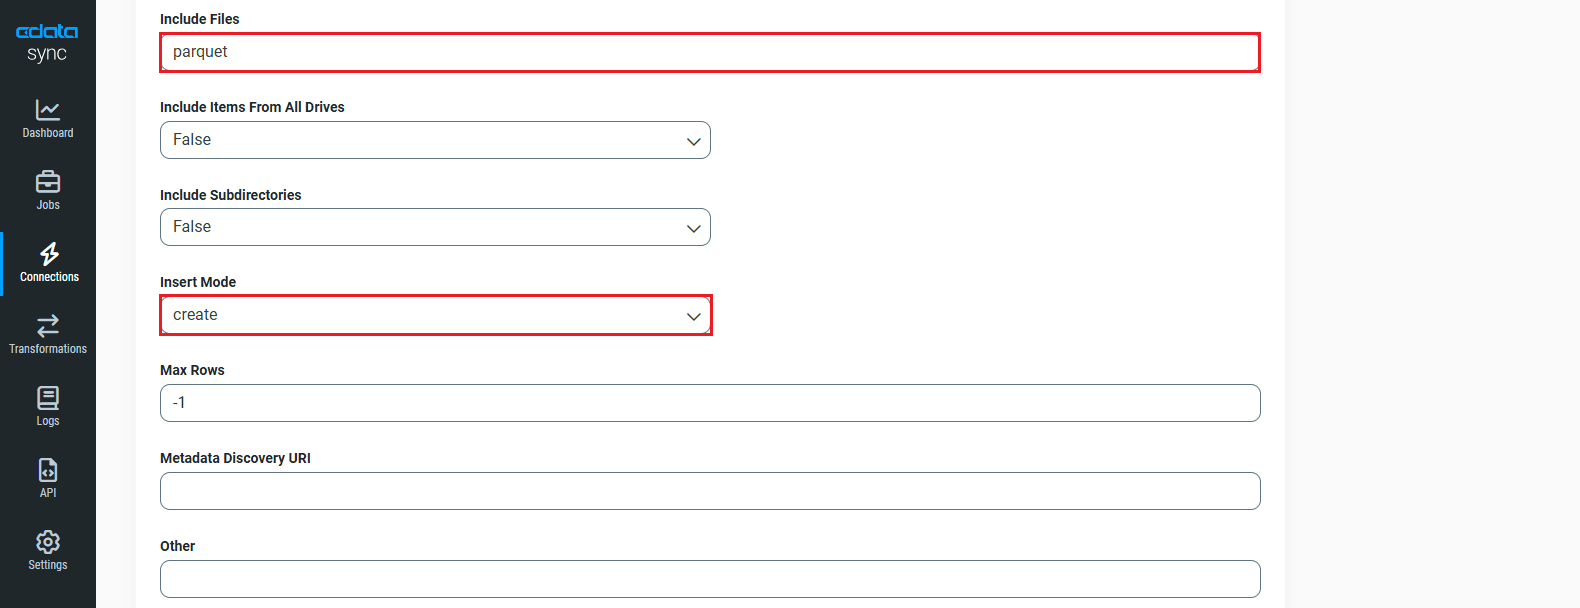
- 詳細タブに移動し、その他セクションまでスクロールします。
- Include Filesに、最初に選択したファイル形式を入力します。
- 基本設定に戻り、Microsoft OneLake に接続をクリックします。
- 接続が確立されたら、作成およびテストをクリックして接続を保存します。
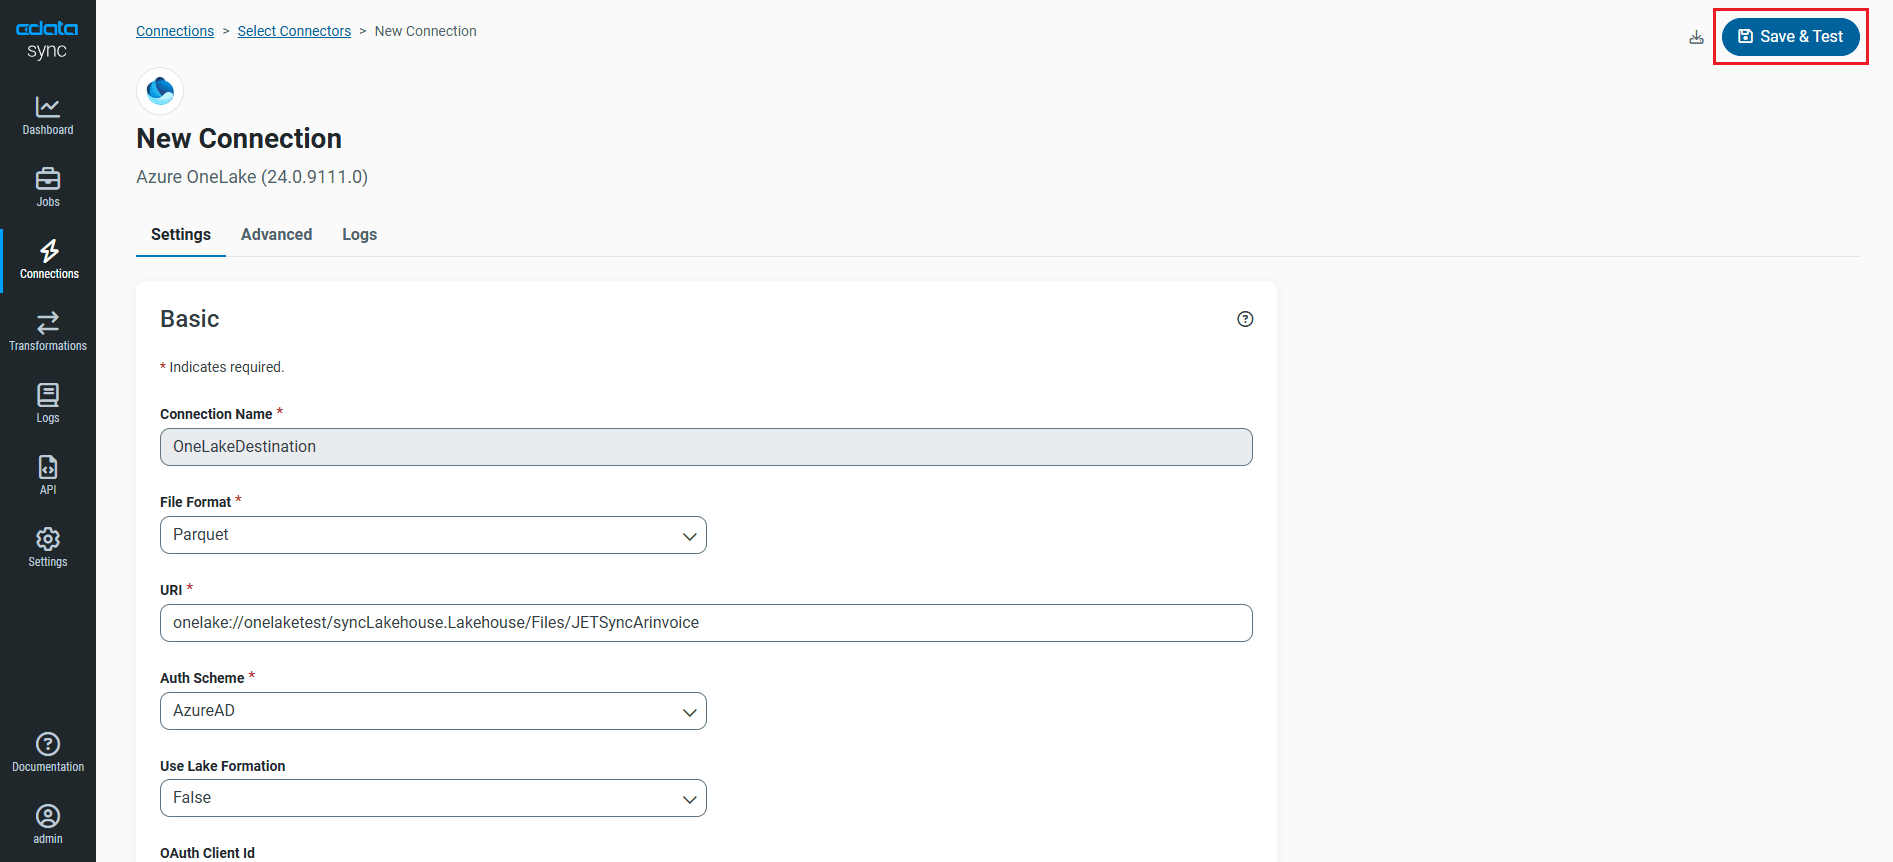
これで OneLake に接続され、データソースとしても同期先としても使用できるようになりました。
NOTE:ラベル機能を使って、データソースや同期先にラベルを追加できます。
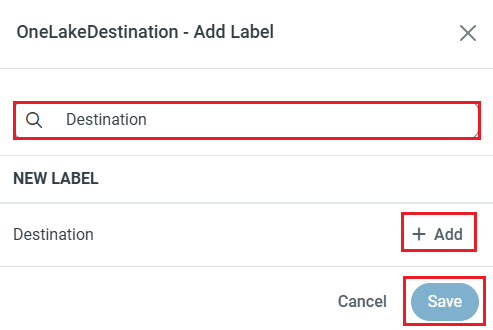
この記事では、Sage X3 Cloud のデータ を OneLake にロードし、同期先として活用する方法をご紹介します。
Sage X3 Cloud への接続を設定する
Sage X3 Cloud への接続は、接続タブから設定できます。Sage X3 Cloud アカウントへの接続を追加するには、接続タブに移動します。
- 接続の追加をクリックします。
- データソース(Sage X3 Cloud)を選択します。
- 接続プロパティを設定します。
Sage X3 Cloud では OAuth 2.0 の Client Credentials フローを使用し、API へのアクセスには X-API-Key も必要です。AuthScheme を OAuth に設定し、以下の接続プロパティを指定します。
- URL:Sage X3 Cloud インスタンスのベース URL。
- OAuthAccessTokenUrl:OAuth トークンエンドポイント(例:https://your-auth-domain/oauth/token)。
- OAuthClientId:OAuth アプリケーションのクライアント ID。
- OAuthClientSecret:OAuth アプリケーションのクライアントシークレット。
- Audience:トークンリクエストで使用する API の Audience 値。
- XAPIKey:Sage X3 Cloud の管理者から提供された X-API-Key。
- Folder:Sage X3 のフォルダ名(例:SEED)。このフォルダがデフォルトのスキーマとして使用されます。
- Folders(オプション):Sage X3 フォルダのカンマ区切りリスト(例:SEED,PERF)。各フォルダが個別のスキーマとして公開されるため、Schema.Table 構文でフォルダをまたいだクエリを実行できます。
ドライバーは Client Credentials フローでアクセストークンを取得し、すべての API リクエストで X-API-Key とあわせて送信します。InitiateOAuth を GETANDREFRESH(デフォルト)に設定しておけば、トークンの取得と更新は自動で行われます。
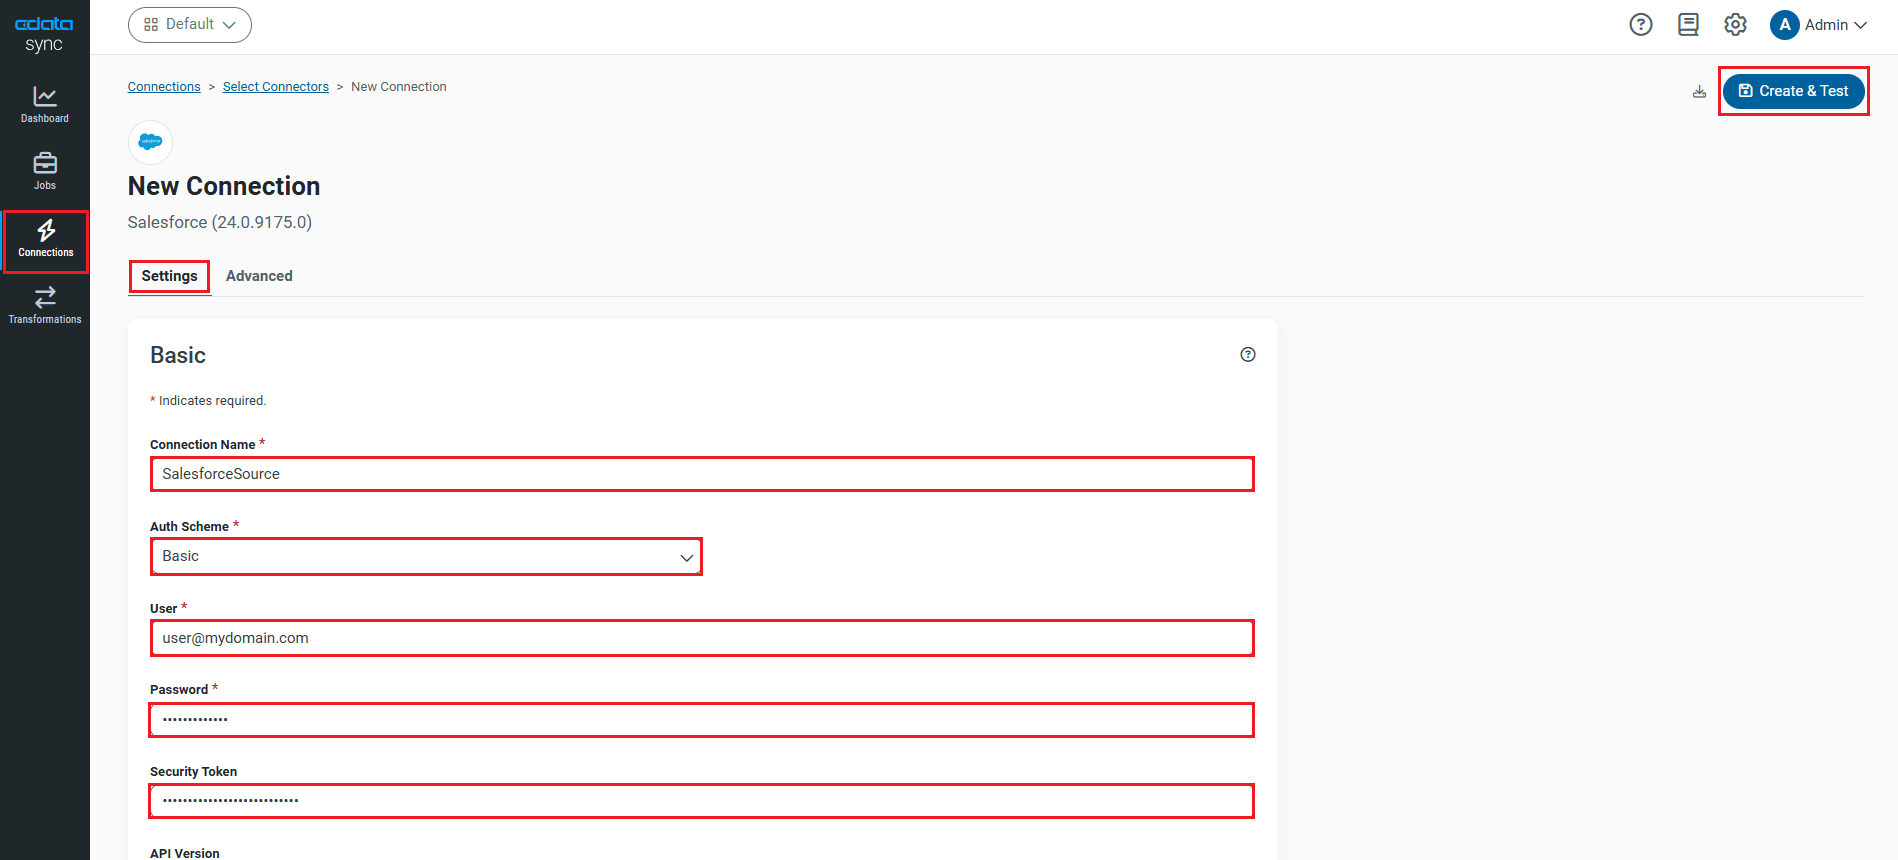
- Sage X3 Cloud に接続をクリックして、接続が正しく設定されていることを確認します。
- 作成およびテストをクリックして変更を保存します。
レプリケーションクエリの設定
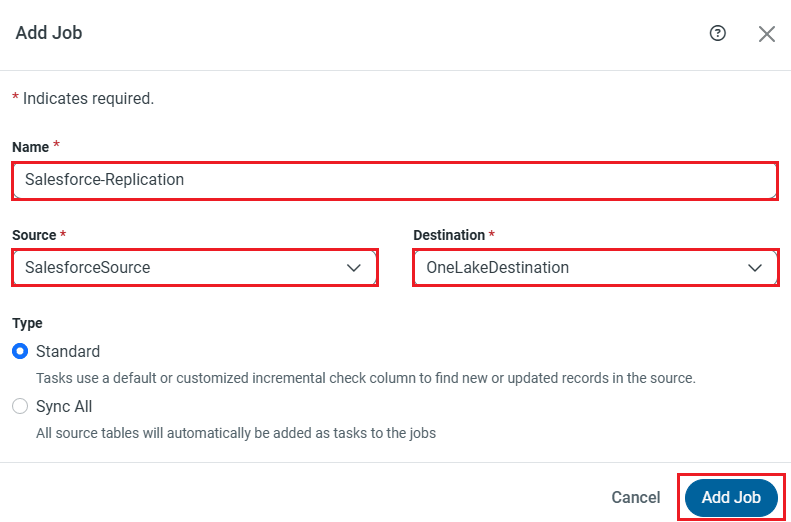
CData Sync では、ポイント&クリック操作と SQL クエリの両方でレプリケーションを制御できます。レプリケーションを設定するには、ジョブタブに移動し、ジョブを追加をクリックします。レプリケーションのデータソースと同期先を選択します。
テーブル全体をレプリケーションする
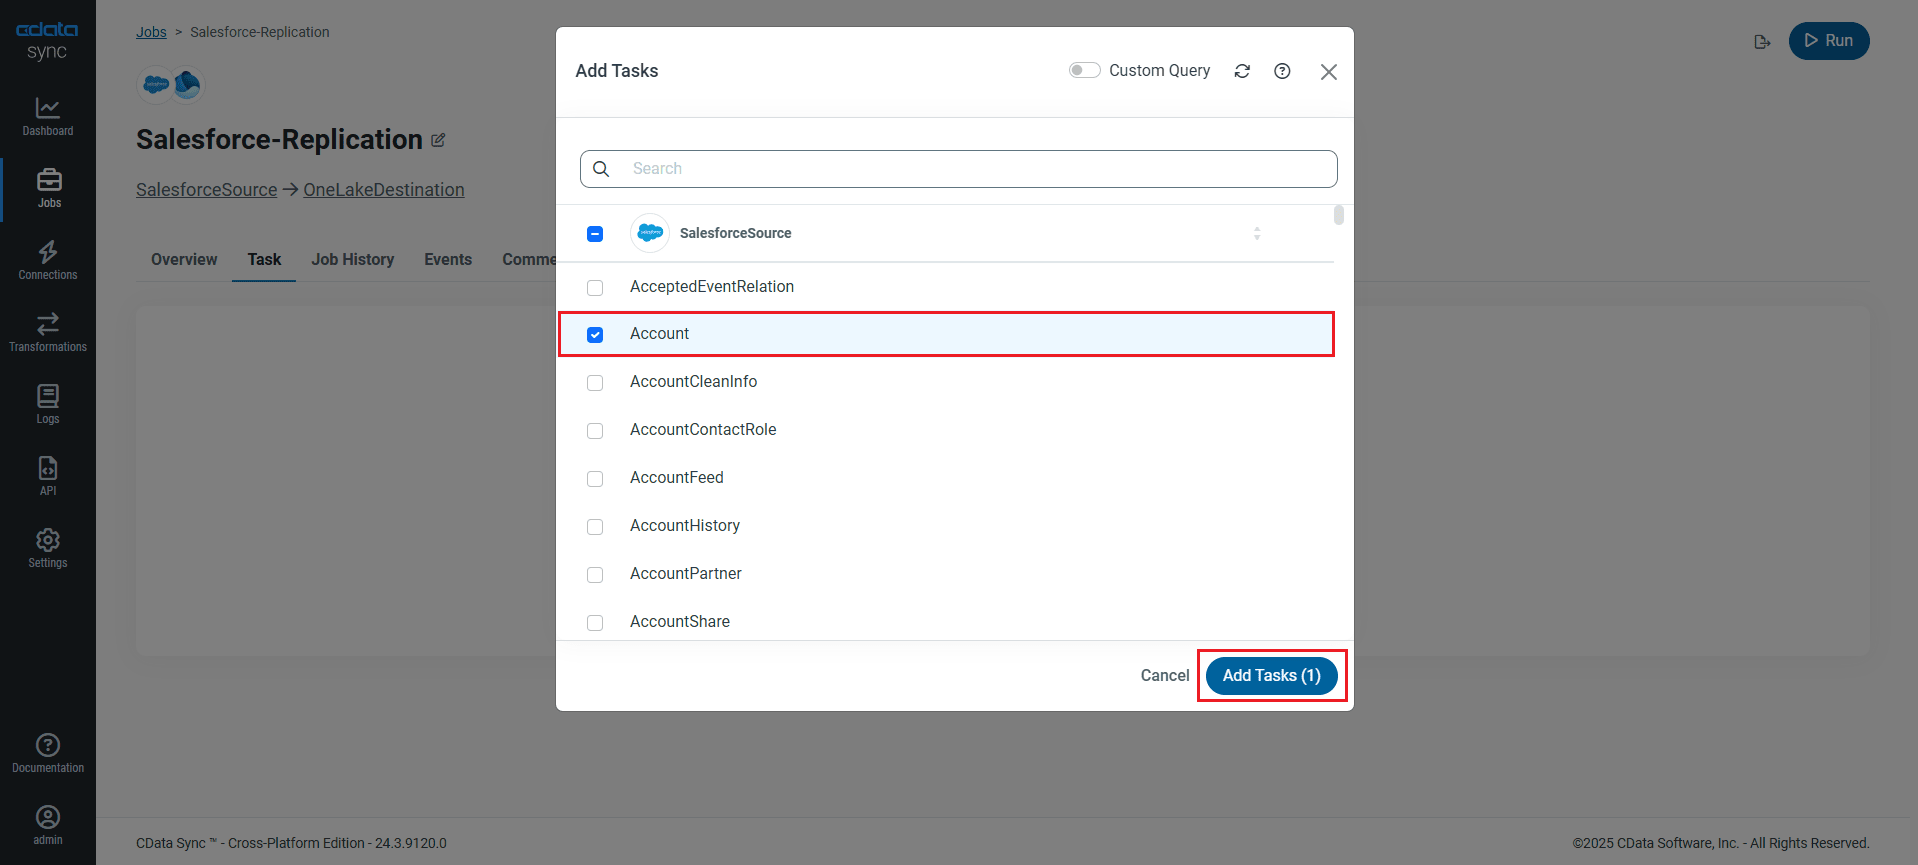
テーブル全体をレプリケーションするには、ジョブのタスクタブでタスクを追加をクリックし、OneLake にレプリケーションしたい Sage X3 Cloud テーブルをリストから選択して、再度タスクを追加をクリックします。
レプリケーションのカスタマイズ
タスクのカラムタブとクエリタブを使って、レプリケーションをカスタマイズできます。カラムタブでは、レプリケーションするカラムの指定、同期先でのカラム名の変更、レプリケーション前のデータ操作などが可能です。クエリタブでは、SQL クエリを使ってフィルタ、グループ化、ソートを追加できます。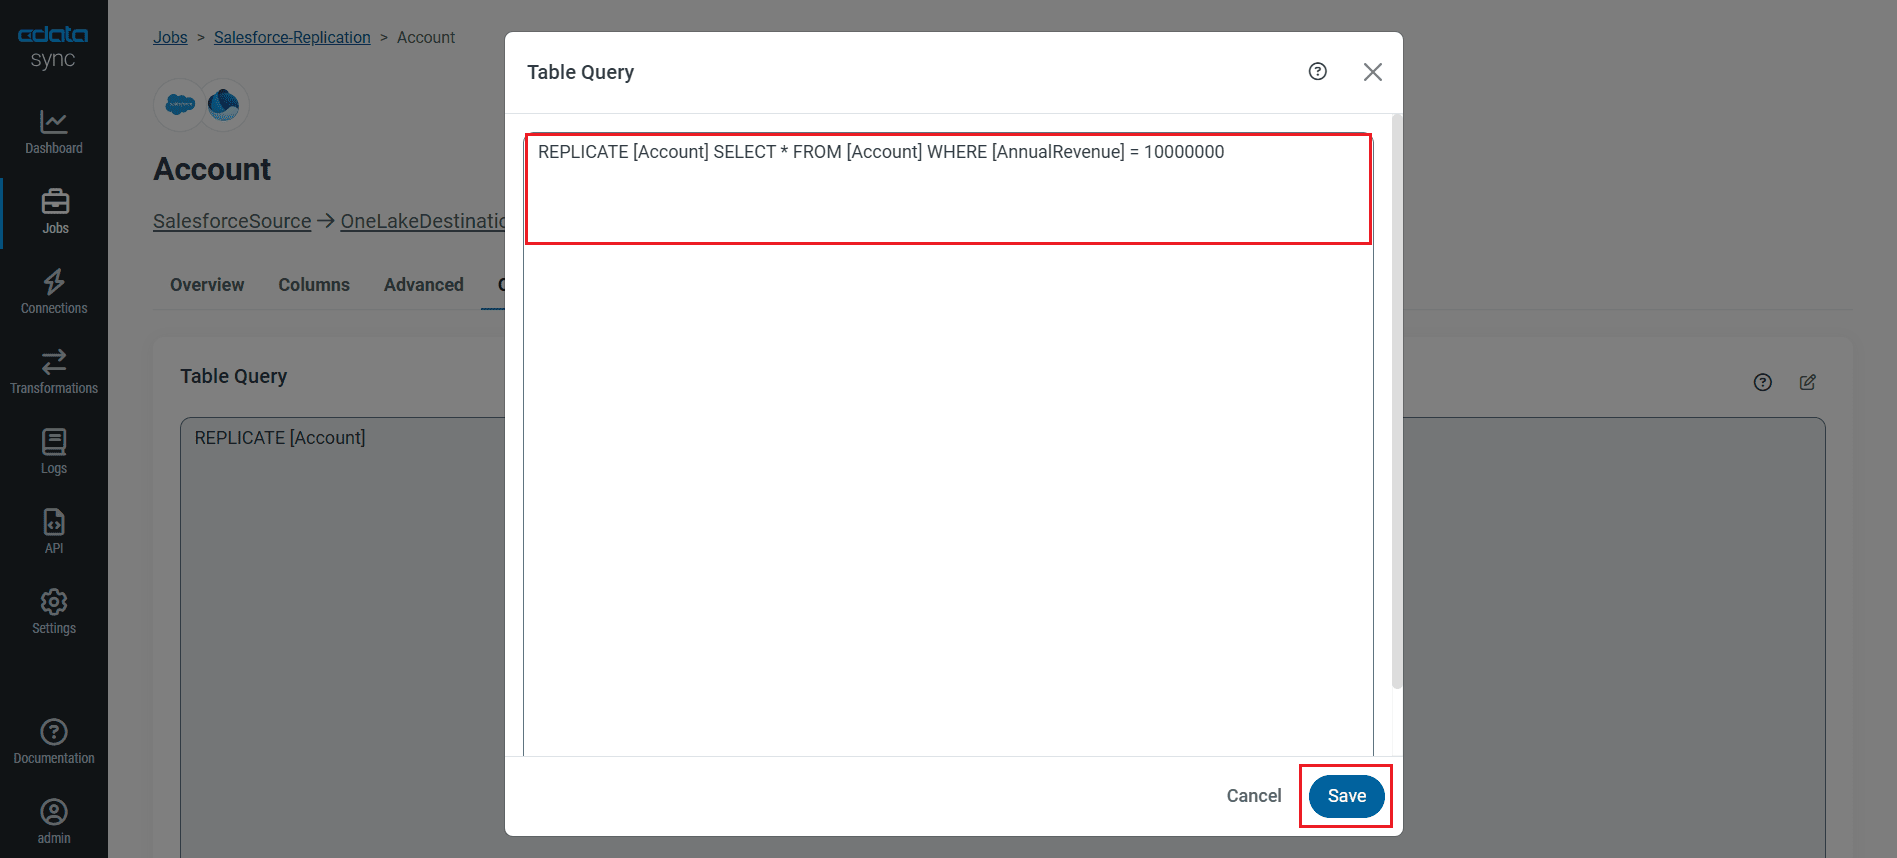
レプリケーションのスケジュール
ジョブの概要タブを選択し、スケジュールの下にある設定をクリックします。10分ごとから月1回まで、指定した間隔でジョブを自動実行するようにスケジュールできます。
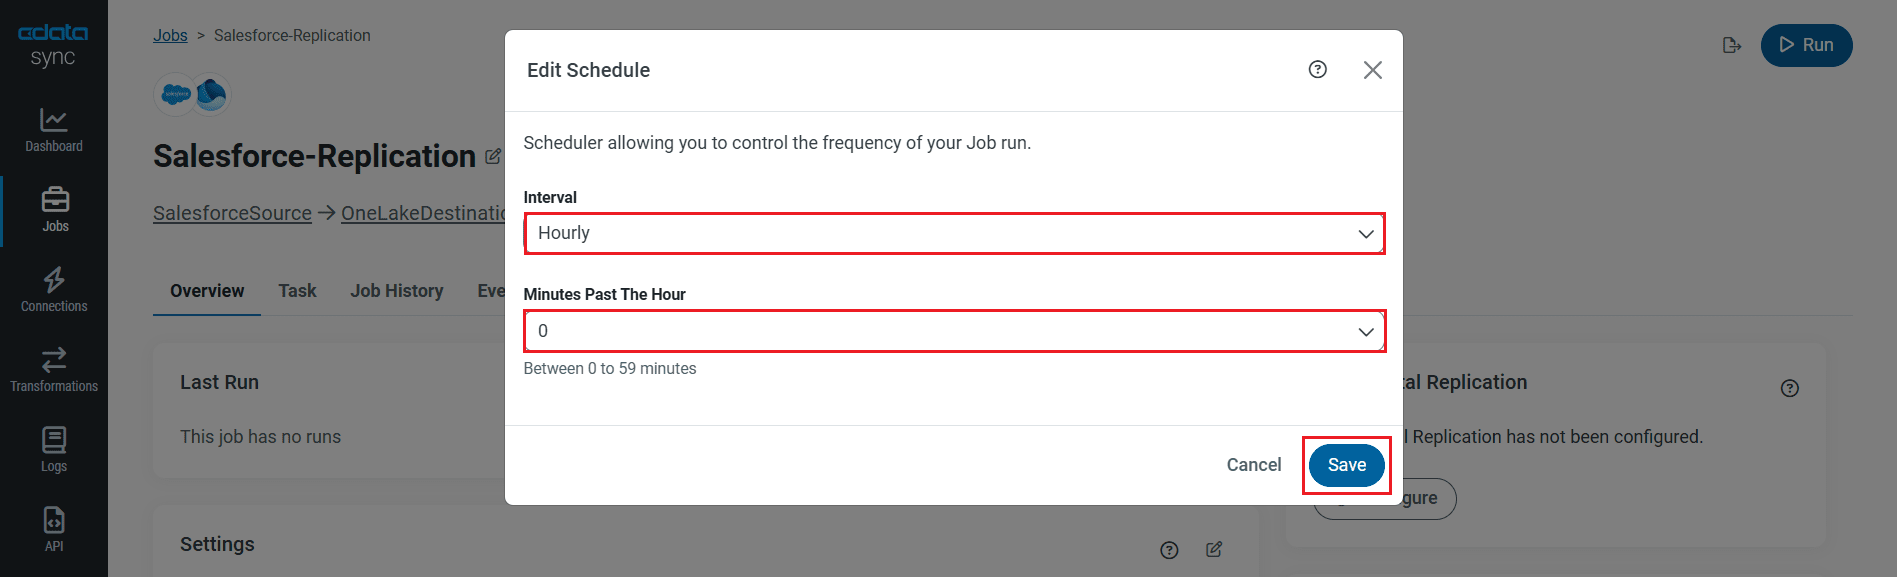
レプリケーションジョブを設定したら、変更を保存をクリックします。Sage X3 Cloud のデータ から OneLake へのレプリケーションを管理するジョブをいくつでも設定できます。
レプリケーションジョブの実行
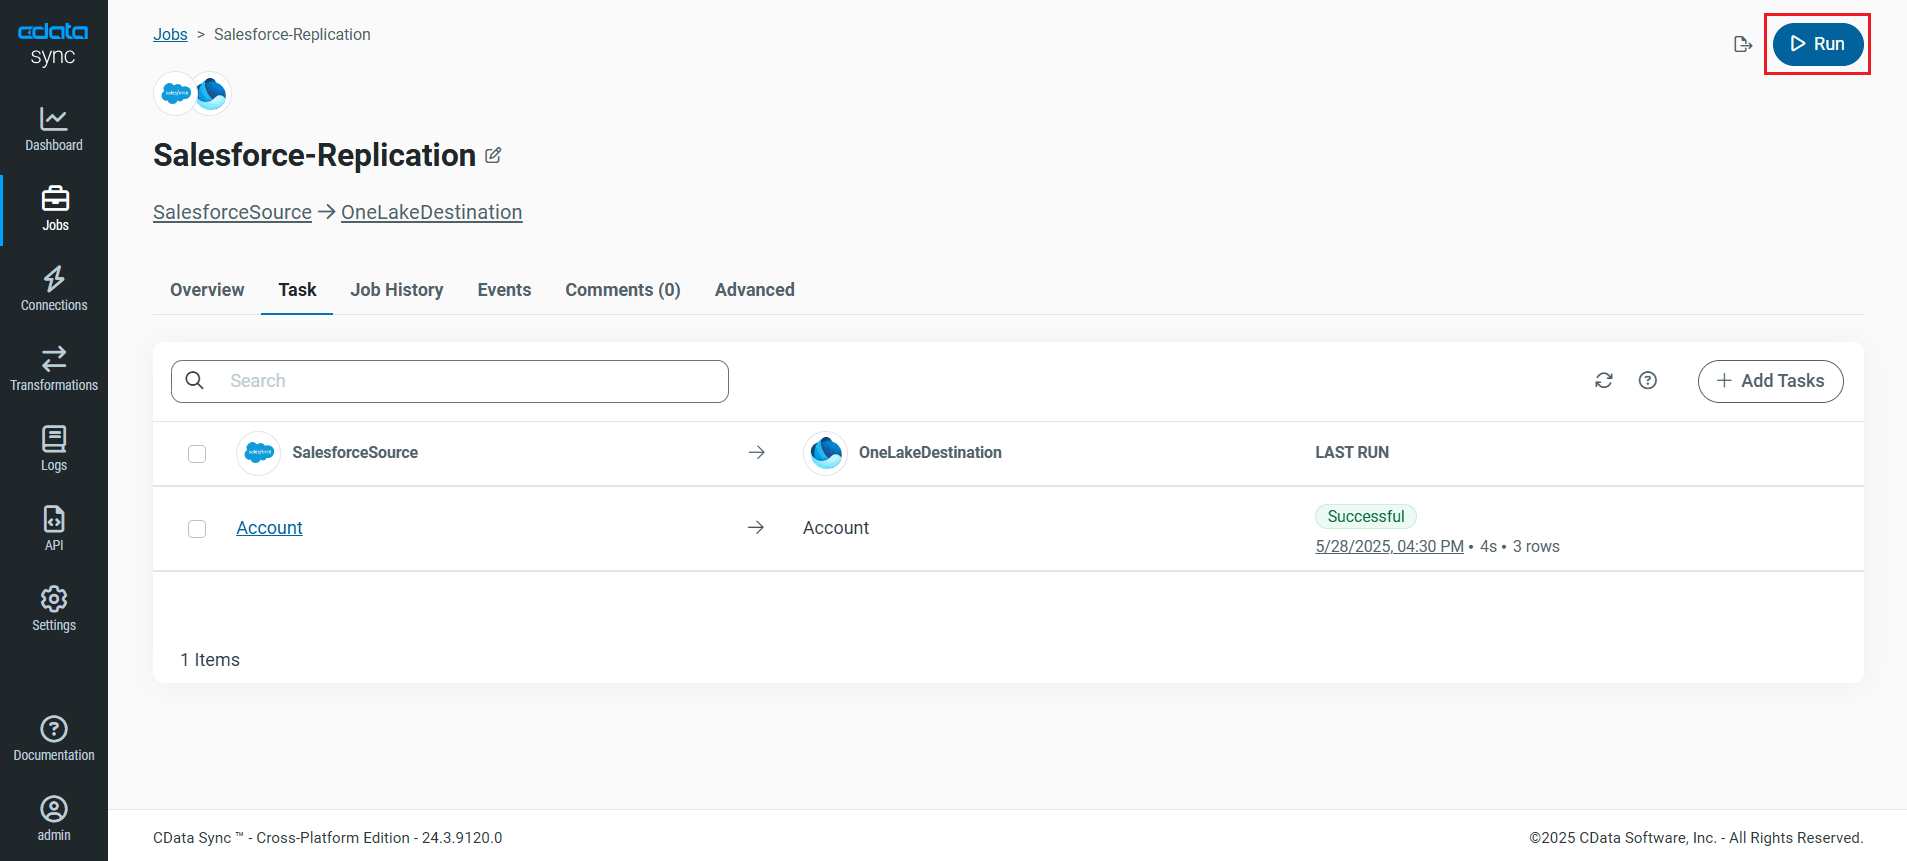
ジョブに必要なすべての設定が完了したら、レプリケーションしたい Sage X3 Cloud テーブルを選択し、実行をクリックします。レプリケーションが正常に完了すると、ジョブの実行時間とレプリケーションされた行数を示す通知が表示されます。
無料トライアル & 詳細情報
Sage X3 Cloud のデータ を OneLake にレプリケーションする方法をご覧いただきました。CData Sync ページで詳細をご確認いただき、30日間の無料トライアルをダウンロードして、エンタープライズデータの統合を始めましょう。
ご不明な点がございましたら、サポートチームがいつでもお手伝いいたします。