



CData SSIS Components を使用して Talkdesk のデータを Databricks にマイグレーション
Databricks は、大量のデータを簡単に処理、分析、可視化できる統合データ分析プラットフォームです。データエンジニアリング、データサイエンス、機械学習の機能を単一のプラットフォームに統合し、チームがコラボレーションしてデータからインサイトを得ることを容易にします。
CData SSIS Components は、SQL Server Integration Services を拡張し、さまざまなソースやデスティネーションからデータを簡単にインポート・エクスポートできるようにします。
この記事では、Databricks へのエクスポート時のデータ型マッピングの考慮事項を確認し、CData SSIS Components for Talkdesk と Databricks を使用してTalkdesk のデータを Databricks にマイグレーションする方法を説明します。
データ型マッピング
| Databricks スキーマ | CData スキーマ |
|---|---|
|
int, integer, int32 |
int |
|
smallint, short, int16 |
smallint |
|
double, float, real |
float |
|
date |
date |
|
datetime, timestamp |
datetime |
|
time, timespan |
time |
|
string, varchar |
長さ > 4000 の場合:nvarchar(max)、それ以外:nvarchar(length) |
|
long, int64, bigint |
bigint |
|
boolean, bool |
tinyint |
|
decimal, numeric |
decimal |
|
uuid |
nvarchar(length) |
|
binary, varbinary, longvarbinary |
binary(1000) または SQL Server 2000 以降は varbinary(max) |
特別な考慮事項
- String/VARCHAR: Databricks の String カラムは、カラムの長さによって異なるデータ型にマッピングされます。カラムの長さが 4000 を超える場合、カラムは nvarchar(max) にマッピングされます。それ以外の場合は、nvarchar(length) にマッピングされます。
- DECIMAL: Databricks は最大 38 桁の精度の DECIMAL 型をサポートしていますが、それを超えるソースカラムはロードエラーを引き起こす可能性があります。
前提条件
- Visual Studio 2022
- Visual Studio 2022 用 SQL Server Integration Services Projects 拡張機能
- CData SSIS Components for Databricks
- CData SSIS Components for Talkdesk
プロジェクトの作成とコンポーネントの追加
-
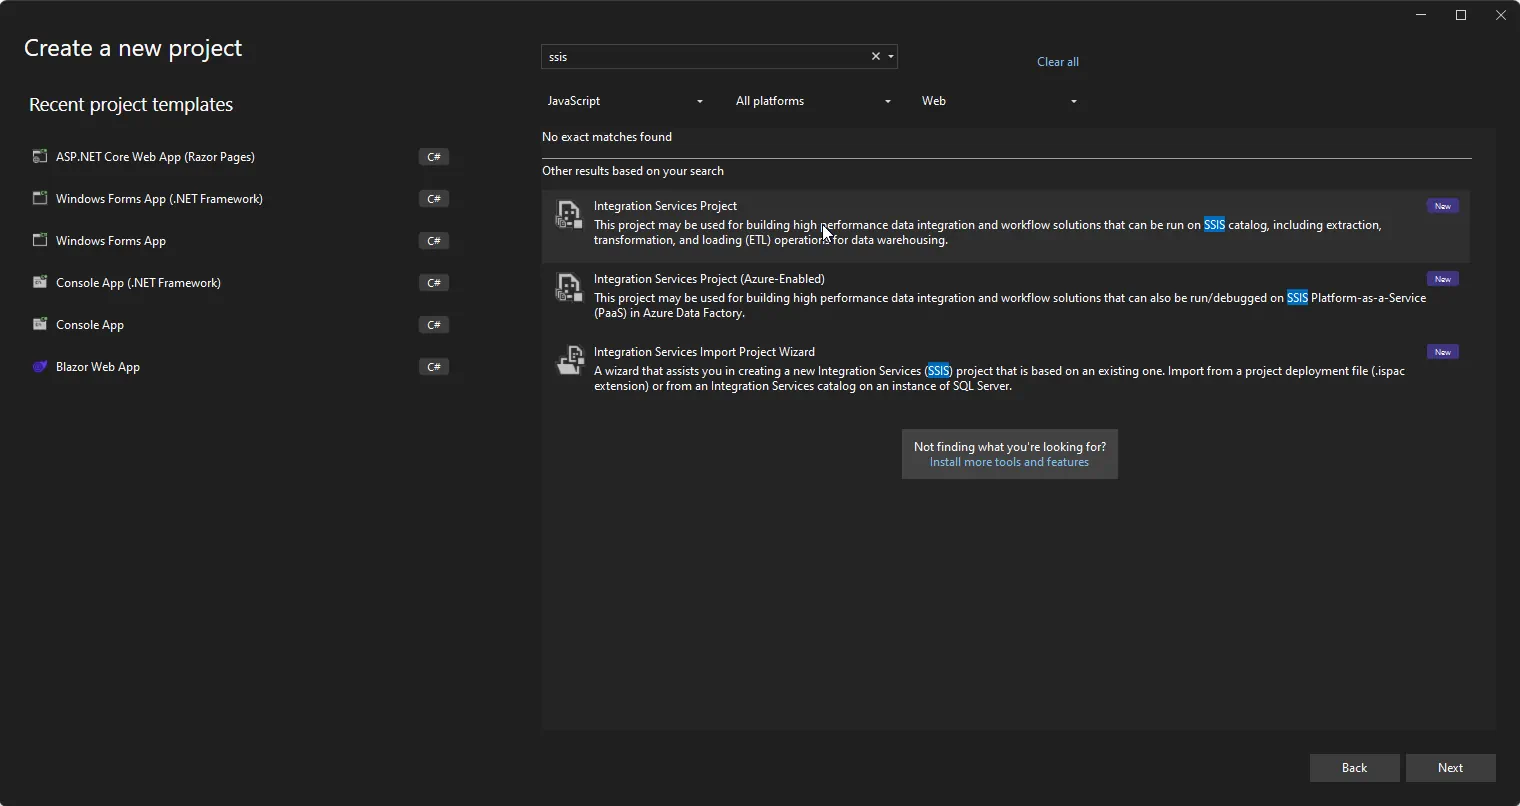
Visual Studio を開き、新しい Integration Services プロジェクトを作成します。
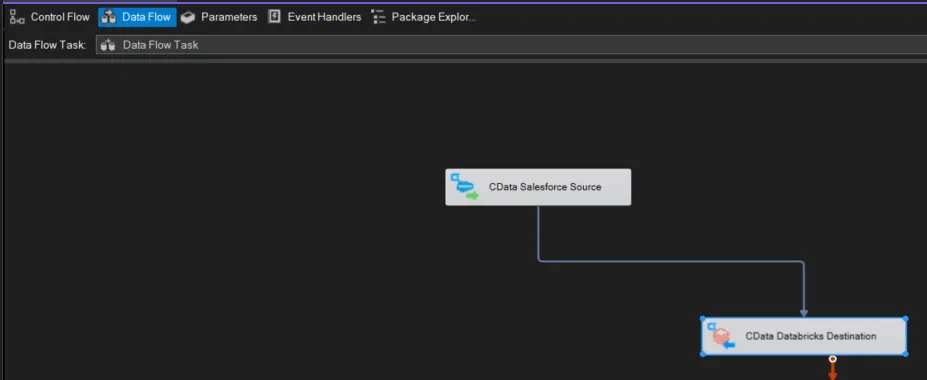
- Control Flow 画面に新しい Data Flow Task を追加し、Data Flow Task を開きます。
-
Data Flow Task に CData Talkdesk Source コントロールと CData Databricks Destination コントロールを追加します。
Talkdesk ソースの設定
以下の手順に従って、Talkdesk への接続に必要なプロパティを指定します。
-
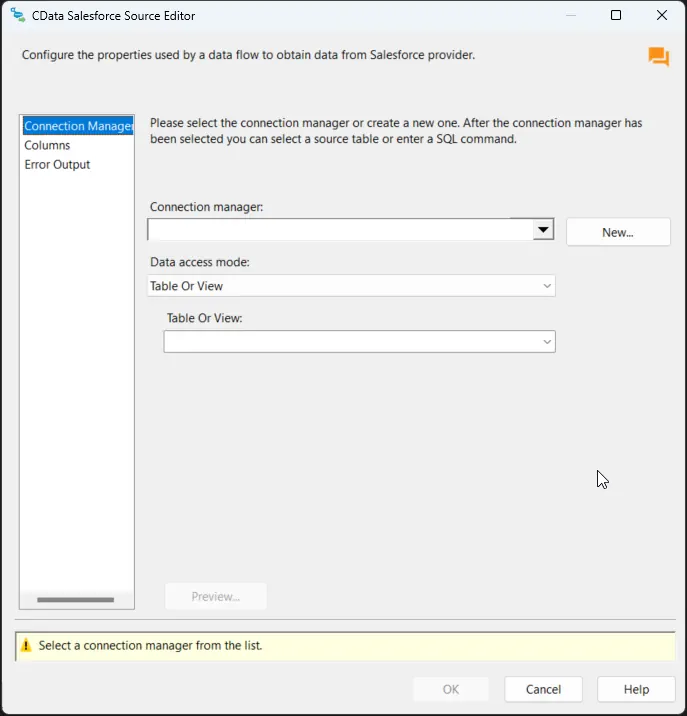
CData Talkdesk Source をダブルクリックしてソースコンポーネントエディタを開き、新しい接続を追加します。
-
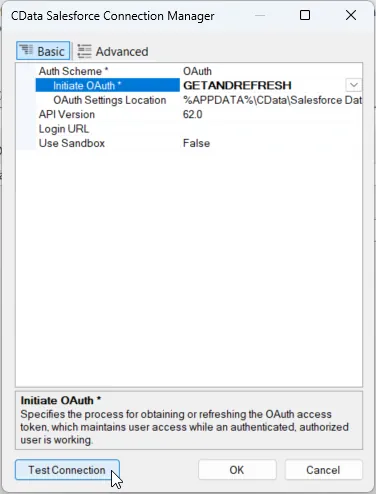
CData Talkdesk Connection Manager で接続プロパティを設定し、接続をテストして保存します。
Talkdesk では OAuth 2.0 の Client Credentials グラントを使用します。ブラウザでの認可ステップやコールバック URL は必要ありません。
以下の接続プロパティを設定します。
- AccountName:Talkdesk アカウントの名前。
- Region:Talkdesk インスタンスがデプロイされているリージョン。指定できる値は US(デフォルト)、EU、CA、AU、UK、FedRamp です。
- OAuthClientId:カスタム OAuth アプリケーションの登録時に割り当てられた Client Id。
- OAuthClientSecret:カスタム OAuth アプリケーションに割り当てられた Client Secret。
カスタム OAuth アプリケーションの作成
- Talkdesk アカウントにログインし、ナビゲーションメニューから OAuth Clients を選択します。
- Create OAuth Client をクリックし、クライアントにわかりやすい名前を付けます。
- Grant Type を Client Credentials に設定します。
- Add scopes をクリックし、アクセスしたいデータに応じたスコープを選択します。
- Create をクリックし、Client Id と Client Secret をコピーします。
接続時、ドライバーは Talkdesk にアクセストークンを自動でリクエストしてキャッシュし、有効期限が切れると更新します。アプリケーションで選択したスコープが、クエリ予定のビューに対応していることを確認してください。対応していない場合、トークンのリクエストが失敗することがあります。
-
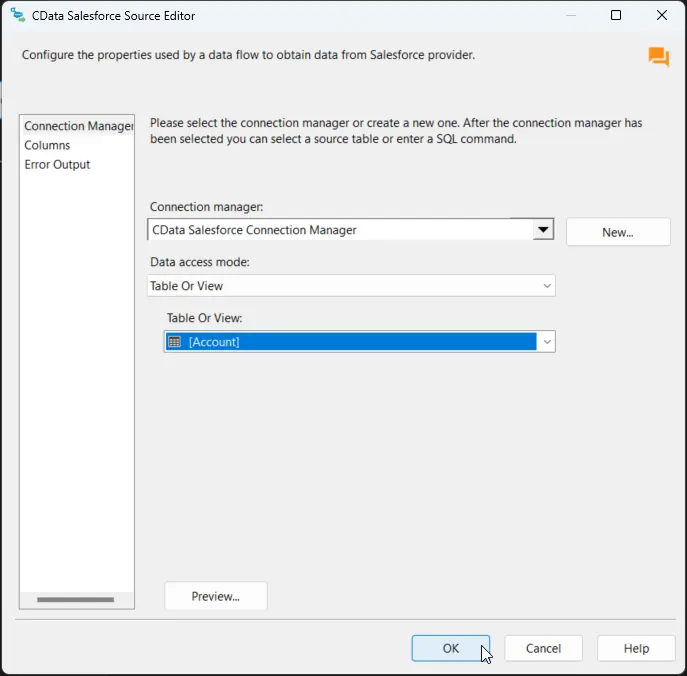
接続を保存後、「Table or view」を選択し、Databricks にエクスポートするテーブルまたはビューを選択して、CData Talkdesk Source Editor を閉じます。
Databricks デスティネーションの設定
Talkdesk Source を設定したら、Databricks 接続を設定してカラムをマッピングします。
-
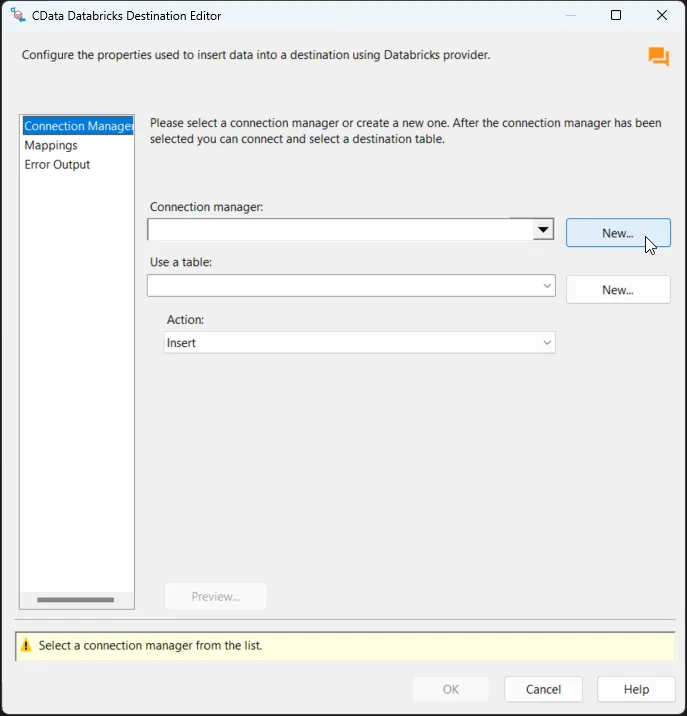
CData Databricks Destination をダブルクリックしてデスティネーションコンポーネントエディタを開き、新しい接続を追加します。
-
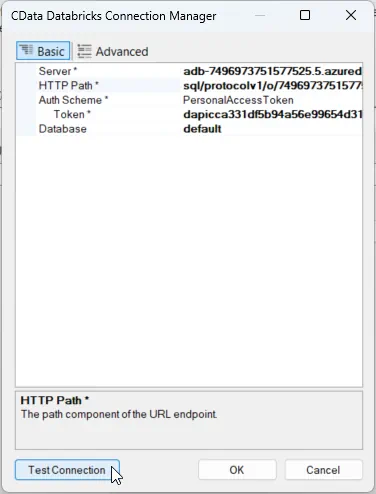
CData Databricks Connection Manager で接続プロパティを設定し、接続をテストして保存します。Databricks クラスターに接続するには、以下のようにプロパティを設定します。
注意:必要な値は、Databricks インスタンスで Clusters に移動し、目的のクラスターを選択して、Advanced Options の下にある JDBC/ODBC タブを選択することで確認できます。
- Server:Databricks クラスターの Server Hostname を設定します。
- HTTPPath:Databricks クラスターの HTTP Path を設定します。
- Token:個人用アクセストークンを設定します(この値は、Databricks インスタンスの User Settings ページに移動し、Access Tokens タブを選択することで取得できます)。
その他の便利な接続プロパティ
- QueryPassthrough: True に設定すると、クエリは Databricks に直接渡されます。
- ConvertDateTimetoGMT: True に設定すると、コンポーネントはローカルマシンの時刻ではなく、日時値を GMT に変換します。
- UseUploadApi: このプロパティを true に設定すると、Bulk INSERT 操作で大量のデータがある場合にパフォーマンスが向上します。
- UseCloudFetch: このオプションは、テーブルに 100 万件を超えるエントリがある場合にクエリ効率を向上させるために CloudFetch を使用するかどうかを指定します。
-
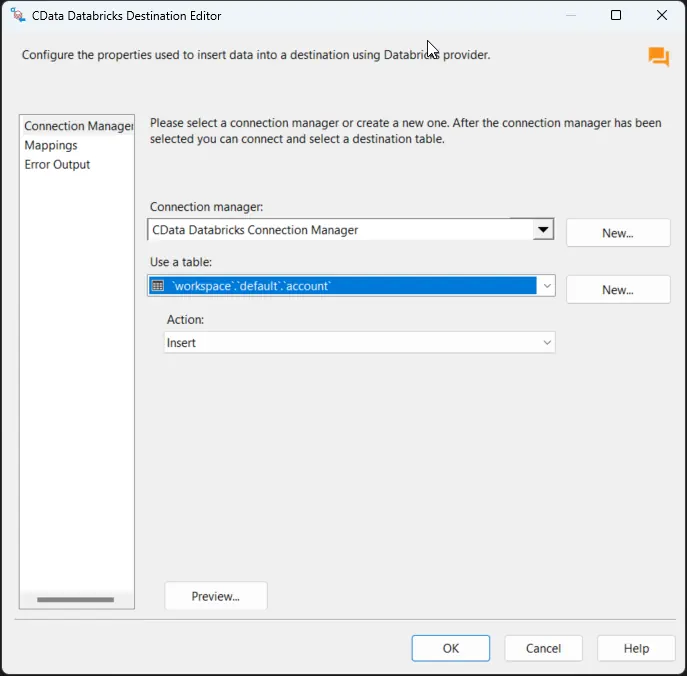
接続を保存後、Use a Table メニューでテーブルを選択し、Action メニューで Insert を選択します。
-
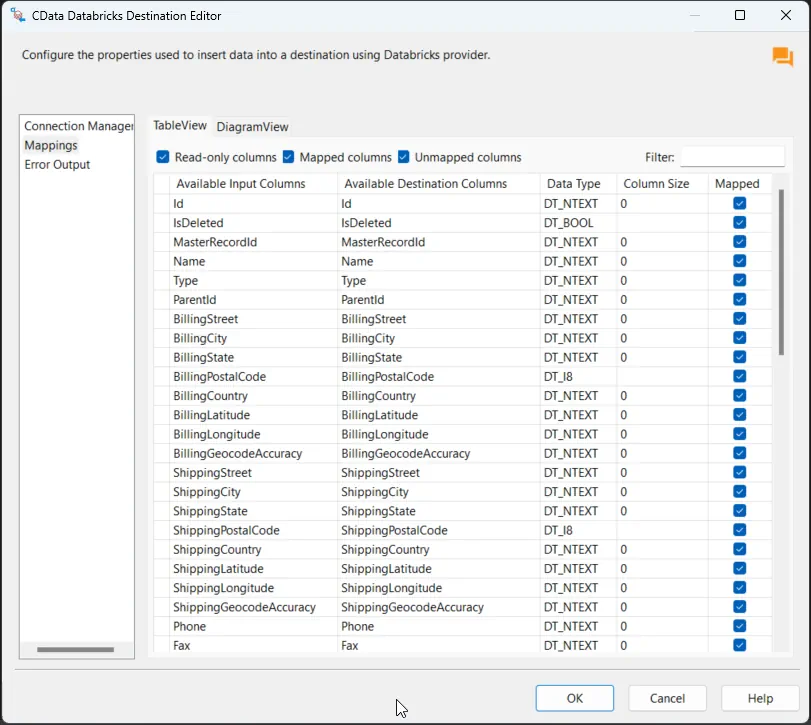
Column Mappings タブで、入力カラムからデスティネーションカラムへのマッピングを設定します。
プロジェクトの実行
これでプロジェクトを実行できます。SSIS Task の実行が完了すると、SQL テーブルのデータが選択したテーブルにエクスポートされます。
はじめる準備はできましたか?
Talkdesk SSIS Component の無料トライアルをダウンロードしてお試しください:
ダウンロード詳細:
 Talkdesk SSIS Components
SSIS ソースコンポーネントは、SQL Server SSIS のワークフロー内で簡単にTalkdesk データにリアルタイム接続できるパワフルなツールです。
データフロー内のTalkdesk コンポーネントを使ってAccounts、Attributes、BillingAccounts、Callbacks、Campaigns、Cases、Contacts、GuardianUsers、Invoices、Products、Subscriptions、Teams、Users、Wallets などを同期できます。データ同期、ローカルバックアップ、ワークフローの自動化などに最適!