

DatabricksからConnect AI経由でXML に接続・クエリ
Databricks は、データエンジニアリング、機械学習、アナリティクスを大規模に統合する AI クラウドネイティブプラットフォームです。 データウェアハウスのパフォーマンスとデータレイクの柔軟性を兼ね備えた強力なデータレイクハウスアーキテクチャを提供しています。 Databricks を CData Connect AI と統合すると、 複雑な ETL パイプラインやデータの複製を必要とせず、XML のデータ にリアルタイムでアクセスでき、 運用の効率化とインサイトまでの時間短縮を実現できます。
この記事では、CData Connect AI を使用して Databricks から XML へのセキュアなライブ接続を設定する方法を説明します。 設定が完了すると、標準 SQL を使用して Databricks ノートブックから直接XML のデータにアクセスでき、 データエコシステム全体でリアルタイム分析を統合できます。
概要
シンプルなステップの概要は以下のとおりです:
- ステップ 1 - 接続と設定: CData Connect AI で XML ソースへの接続を作成し、ユーザー権限を設定して、 Personal Access Token(PAT)を生成します。
- ステップ 2 - Databricks からクエリ: Databricks に CData JDBC ドライバーをインストールし、ノートブックに接続情報を設定して、 SQL クエリでリアルタイムのXML のデータにアクセスします。
前提条件
始める前に、以下を準備してください:
- アクティブな XML アカウント
- CData Connect AI アカウント。ログインまたは 無料トライアルにサインアップできます。
- Databricks アカウント。こちらからサインアップまたはログインできます。
ステップ 1:CData Connect AI で XML 接続を設定
1.1 XML への接続を追加
CData Connect AI は、利用可能なデータソースに接続するためのシンプルなポイント&クリックインターフェースを提供しています。
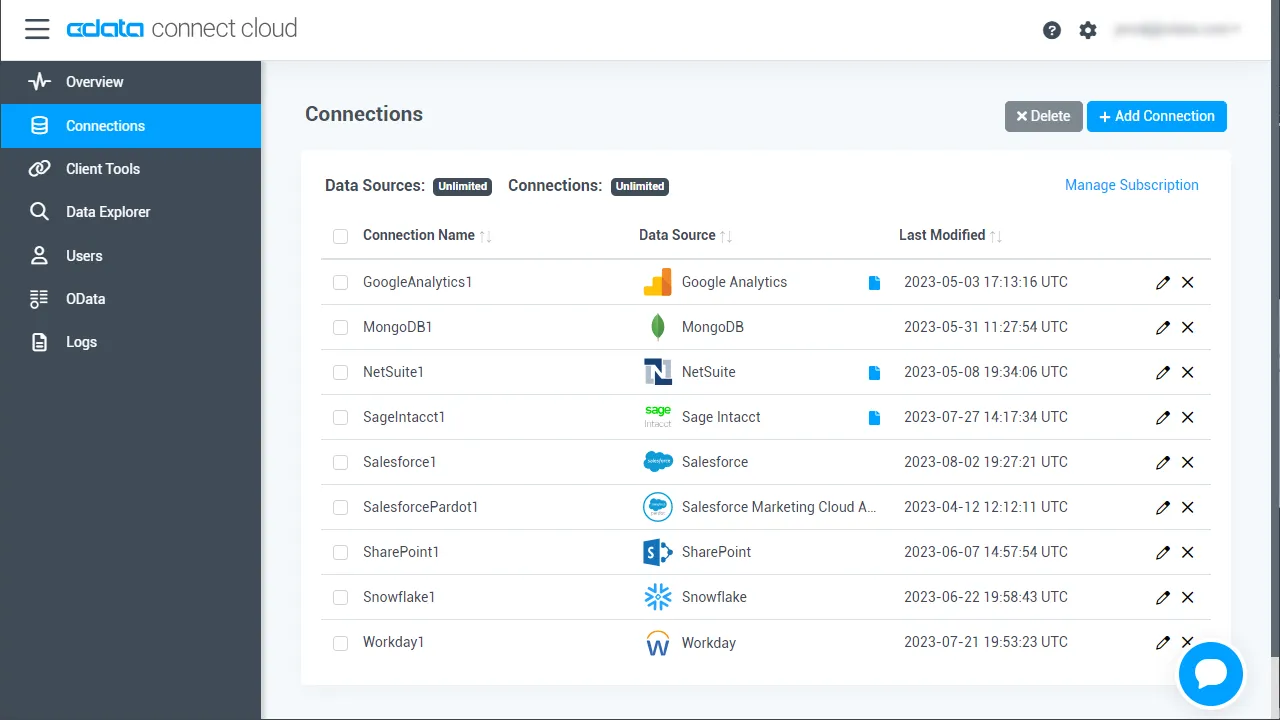
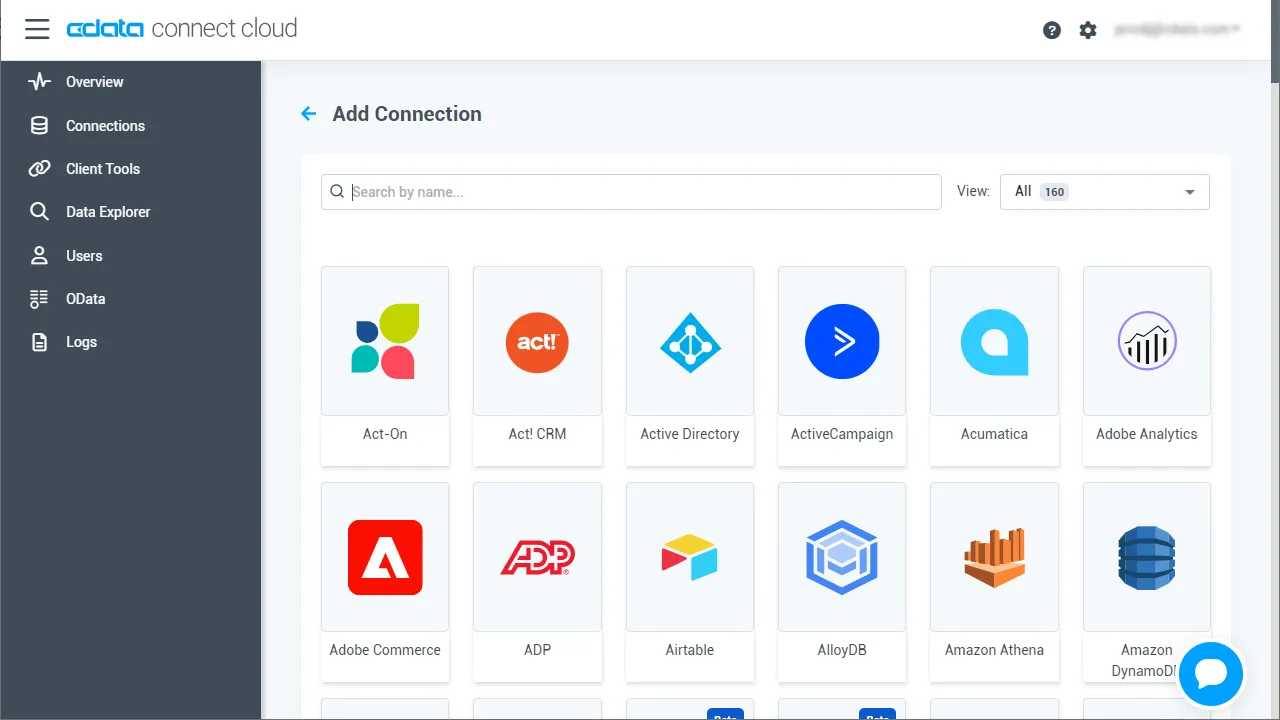
- Connect AI にログインし、左側の Sources をクリックして、 右上の Add Connection をクリック
- Add Connection パネルから 「XML」 を選択
-
XML に接続するために必要な認証プロパティを入力します。
データソースを認証するには、データプロバイダーのドキュメント内の「はじめに」セクションをご覧ください。 データプロバイダーはXML API を双方向データベーステーブルとしてモデル化し、XML ファイルをread-only ビュー(ローカルファイル、人気のクラウドサービスに格納されたファイル、およびFTP サーバー)としてモデル化します。 HTTP Basic、Digest、NTLM、OAuth、およびFTP を含む主な認証スキームはサポートされています。認証のガイドについては、データプロバイダーのドキュメント内の「はじめに」セクションをご覧ください。
URI と認証値を設定した後で、DataModel を設定することでデータの構造によりよくマッチするようデータの抽象化を調整できます。
DataModel プロパティはデータがどのようにテーブルとして抽象化されるかを制御するプロパティであり、次の基本的な設定を調整します。
- Document(デフォルト):XML データのトップレベルのドキュメントビューをモデル化します。データプロバイダーは入れ子化した要素をデータの集約値として返します。
- FlattenedDocuments:入れ子化したドキュメントとその親を結合して単一のテーブルに入力します。
- Relational:個別の関連テーブルを階層化されたデータから返します。テーブルは主キーと、親ドキュメントにリンクする外部キーを含みます。
リレーショナルな抽象化の設定についての詳細は、「XML データのモデリング」セクションを参照してください。次の例で使用されているサンプルデータも存在します。 このデータには、人名、その人たちが所有する車、車に施されたさまざまなメンテナンスに関する情報が含まれます。
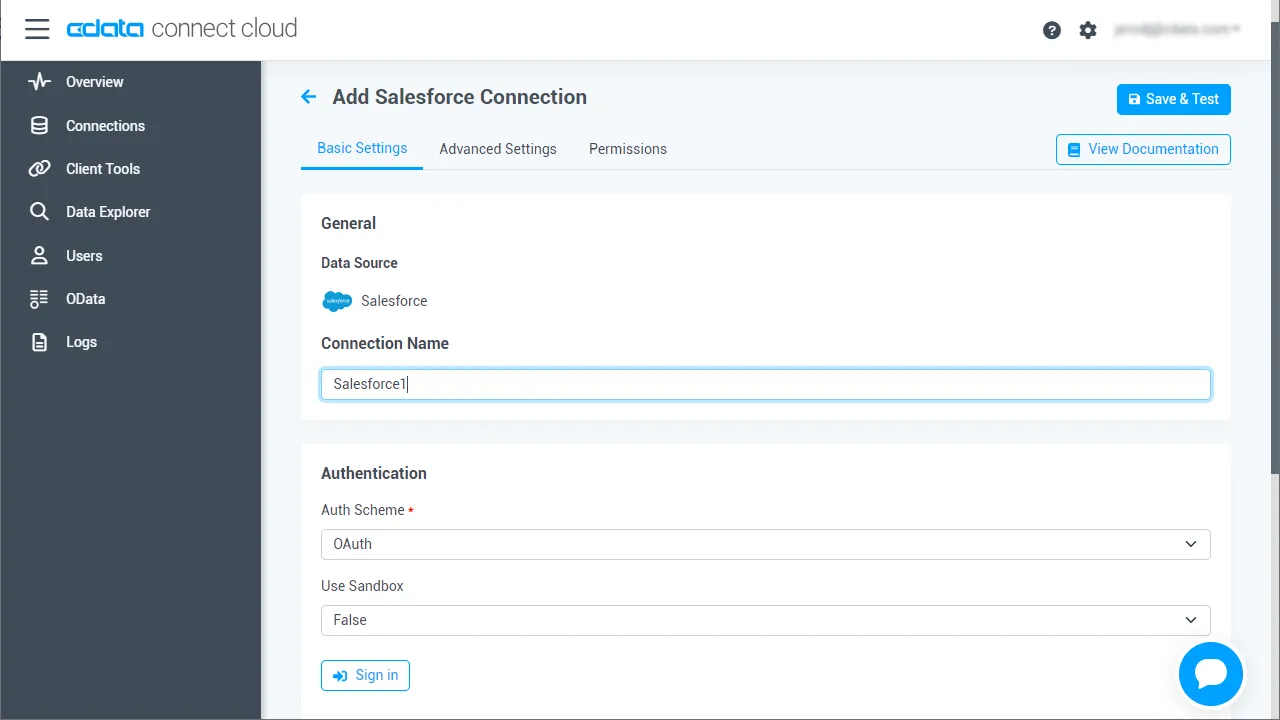
- 右上の Save & Test をクリック
-
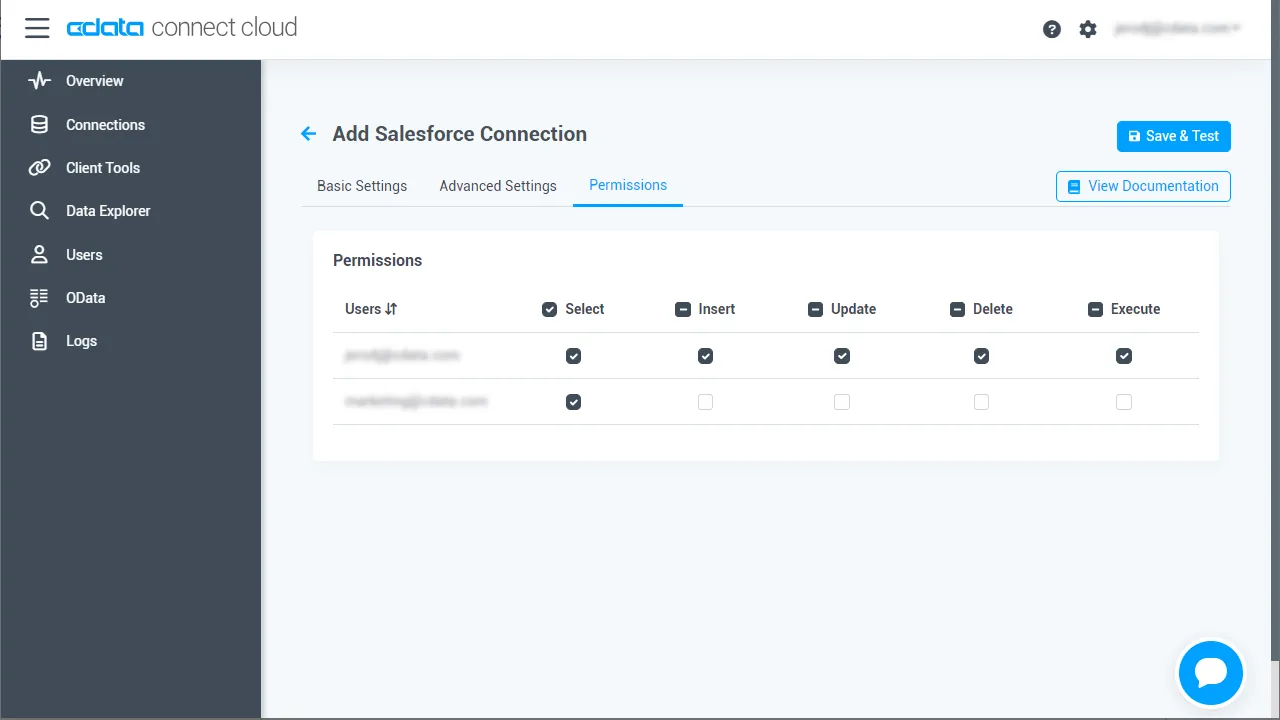
XML Connection ページで Permissions タブに移動し、
お好みに応じてユーザーベースの権限を更新します。
1.2 Personal Access Token(PAT)を生成
REST API、OData API、または仮想 SQL Server 経由で Connect AI に接続する場合、 Personal Access Token(PAT)が Connect AI への接続認証に使用されます。PAT は、セキュアなトークンベースの認証として ログイン認証情報の代わりに機能します。アクセスの粒度を維持するため、 サービスごとに個別の PAT を作成することをお勧めします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして Settings ページを開く
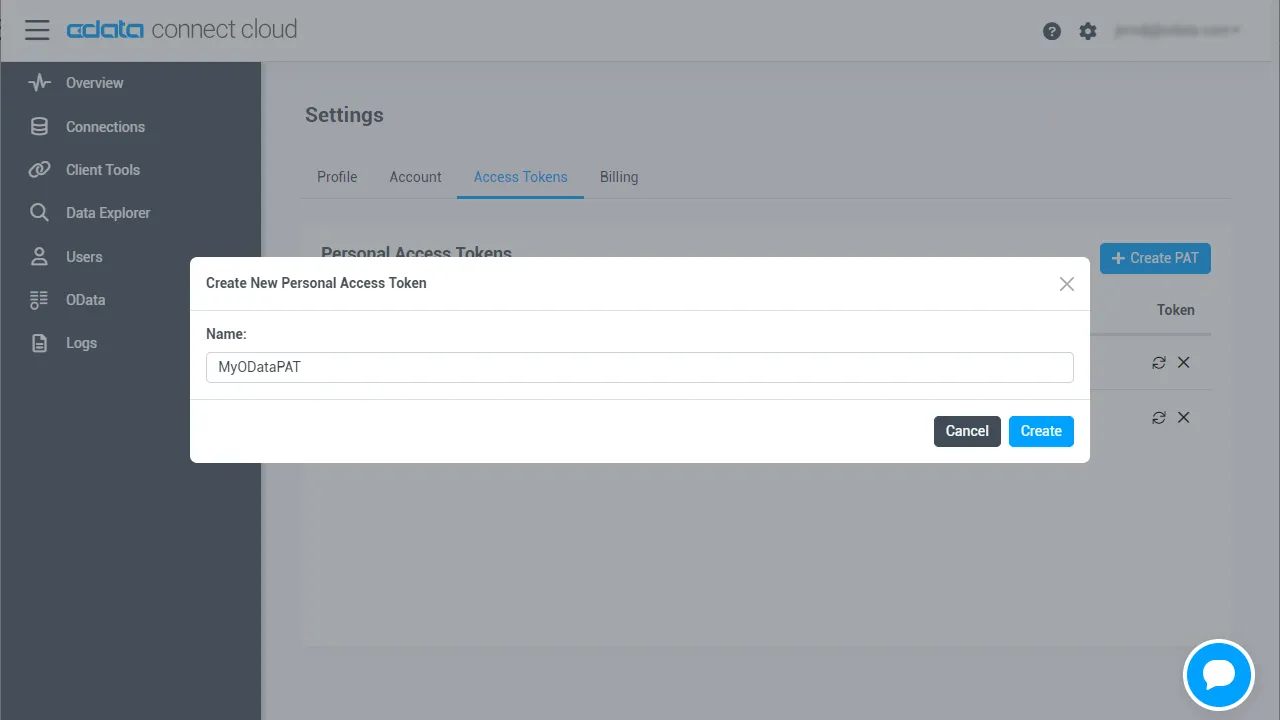
- Settings ページで Access Tokens セクションに移動し、 Create PAT をクリック
-
PAT に名前を付けて Create をクリック
- 注意:Personal Access Token は作成時にのみ表示されるので、必ずコピーして安全な場所に保存してください。
ステップ 2:Databricks で XML データに接続・クエリ
以下の手順に従って、Databricks から XML への接続を確立します。 CData JDBC Driver for Connect AI をインストールし、JAR ファイルをクラスターに追加して、ノートブックを設定し、 SQL クエリでリアルタイムのXML のデータにアクセスします。
2.1 CData JDBC Driver for Connect AI をインストール
- CData Connect AI で、左側の Integrations ページをクリック。 JDBC または Databricks を検索し、Download をクリックして、 お使いの OS 用のインストーラーを選択します。
-
ダウンロード後、インストーラーを実行して指示に従います:
- Windows の場合:セットアップファイルを実行し、インストールウィザードに従います。
- Mac/Linux の場合:アーカイブを解凍し、フォルダを /opt または /Applications に移動します。実行権限があることを確認してください。
-
インストール後、インストールディレクトリで JAR ファイルを見つけます:
- Windows:
C:\Program Files\CData\CData JDBC Driver for Connect AI\lib\cdata.jdbc.connect.jar - Mac/Linux:
/Applications/CData/CData JDBC Driver for Connect AI/lib/cdata.jdbc.connect.jar
- Windows:
2.2 Databricks に JAR ファイルをインストール
-
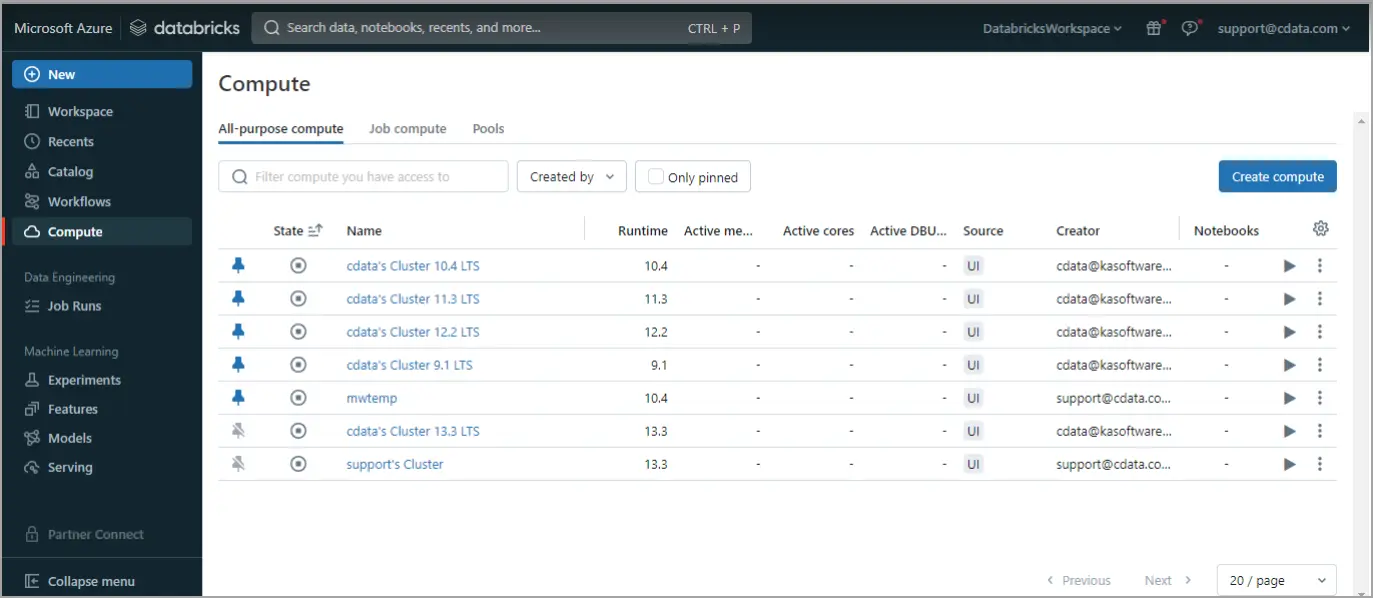
Databricks にログイン。左側のナビゲーションペインで Compute をクリック。コンピュートクラスターを開始または作成します。
-
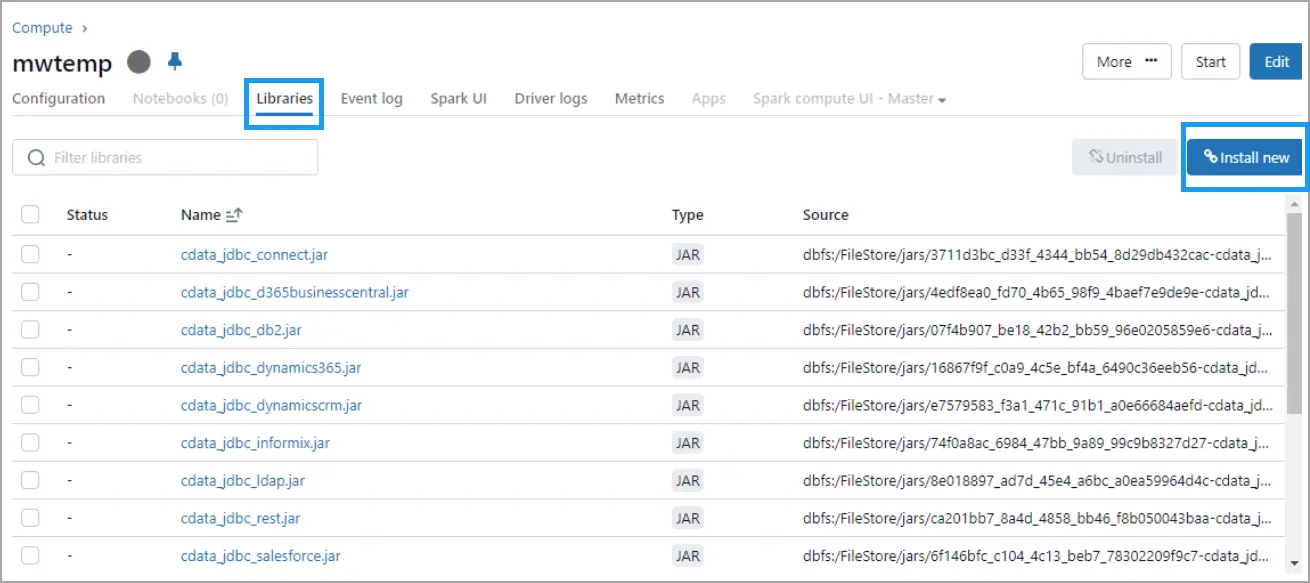
実行中のクラスターをクリックし、Libraries タブに移動して、右上の Install New をクリック。
-
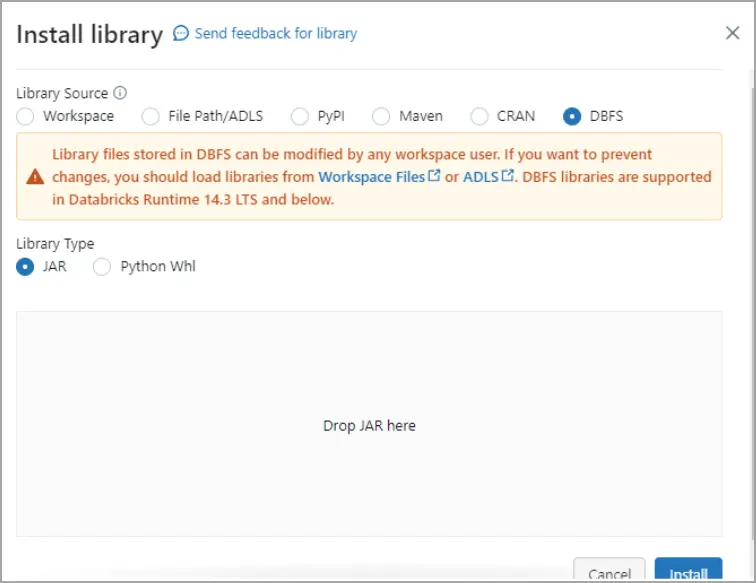
Install Library ダイアログで DBFS を選択し、
cdata.jdbc.connect.jar ファイルをドラッグ&ドロップ。Install をクリック。
2.3 Databricks ノートブックで XML データをクエリ
ノートブックスクリプト 1 - JDBC 接続を定義:
- 以下のスクリプトをノートブックセルに貼り付けます:
driver = "cdata.jdbc.connect.ConnectDriver"
url = "jdbc:connect:AuthScheme=Basic;User=your_username;Password=your_pat;URL=https://cloud.cdata.com/api/;DefaultCatalog=Your_Connection_Name;"
- 以下を置き換えます:
- your_username - CData Connect AI のユーザー名
- your_pat - CData Connect AI の Personal Access Token(PAT)
- Your_Connection_Name - Sources ページの Connect AI データソース名
- スクリプトを実行します。
ノートブックスクリプト 2 -XML のデータから DataFrame を読み込み:
- 2 番目のスクリプト用に新しいセルを追加します。ノートブック右側のメニューから Add cell below をクリック。
- 以下のスクリプトを新しいセルに貼り付けます:
remote_table = spark.read.format("jdbc") \
  .option("driver", "cdata.jdbc.connect.ConnectDriver") \
  .option("url", "jdbc:connect:AuthScheme=Basic;User=your_username;Password=your_pat;URL=https://cloud.cdata.com/api/;DefaultCatalog=Your_Connection_Name;") \
  .option("dbtable", "YOUR_SCHEMA.YOUR_TABLE") \
  .load()
- 以下を置き換えます:
- your_username - CData Connect AI のユーザー名
- your_pat - CData Connect AI の Personal Access Token(PAT)
- Your_Connection_Name - Sources ページの Connect AI データソース名
- YOUR_SCHEMA.YOUR_TABLE - スキーマとテーブル名(例:XML.people)
- スクリプトを実行します。
ノートブックスクリプト 3 - カラムをプレビュー:
- 同様に、3 番目のスクリプト用に新しいセルを追加します。
- 以下のスクリプトを新しいセルに貼り付けます:
display(remote_table.select("ColumnName1", "ColumnName2"))
- ColumnName1 と ColumnName2 を XML 構造の実際のカラム名に置き換えます(例:[ personal.name.first ]、[ personal.name.last ] など)。
- スクリプトを実行します。
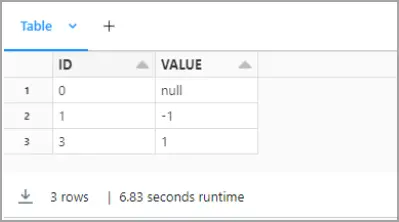
これで、バックエンド API の複雑さを意識することなく、またXML のデータをレプリケーションすることなく、 Databricks ノートブック内で直接リアルタイムの XML のデータ を探索、結合、分析できるようになりました。
CData Connect AI を 14 日間無料でお試しください
XML のデータへのリアルタイムアクセスを簡素化する準備はできましたか? CData Connect AI の 14 日間無料トライアルを今すぐ開始して、 Databricks から XML へのシームレスなライブ接続を体験してください。
ローコード、インフラ不要、レプリケーション不要 - 重要なデータとインサイトへの シームレスでセキュアなアクセスを実現します。