

DataikuとConnect AIでAdobe Target のデータを統合
Dataiku は、チームがガバナンスされた環境内で機械学習や生成 AI プロジェクトを設計、デプロイ、管理できるコラボレーティブなデータサイエンス・AI プラットフォームです。エージェントと GenAI フレームワークにより、カスタムワークフローとモデルオーケストレーションを通じてデータを分析、生成、操作できるインテリジェントエージェントを構築できます。
Dataiku を CData Connect AI の組み込み MCP(Model Context Protocol)サーバーと統合することで、これらのエージェントはリアルタイムのAdobe Target のデータにセキュアにアクセスできるようになります。この統合により、Dataiku のエージェント実行環境と CData のガバナンスされたエンタープライズ接続レイヤーが橋渡しされ、すべてのクエリや指示が手動エクスポートやステージングなしで、承認されたデータソースに対して安全に実行されます。
この記事では、Connect AI での Adobe Target 接続の設定、MCP サポートを含む Dataiku の Python コード環境の準備、そして Dataiku 内から直接リアルタイムのAdobe Target のデータにクエリ・操作できるエージェントの作成方法を説明します。
ステップ 1:Dataiku 用の Adobe Target 接続を設定
Dataiku から Adobe Target への接続は、CData Connect AI のリモート MCP サーバーによって実現されます。Dataiku からAdobe Target のデータを操作するには、まず CData Connect AI で Adobe Target 接続を作成・設定します。
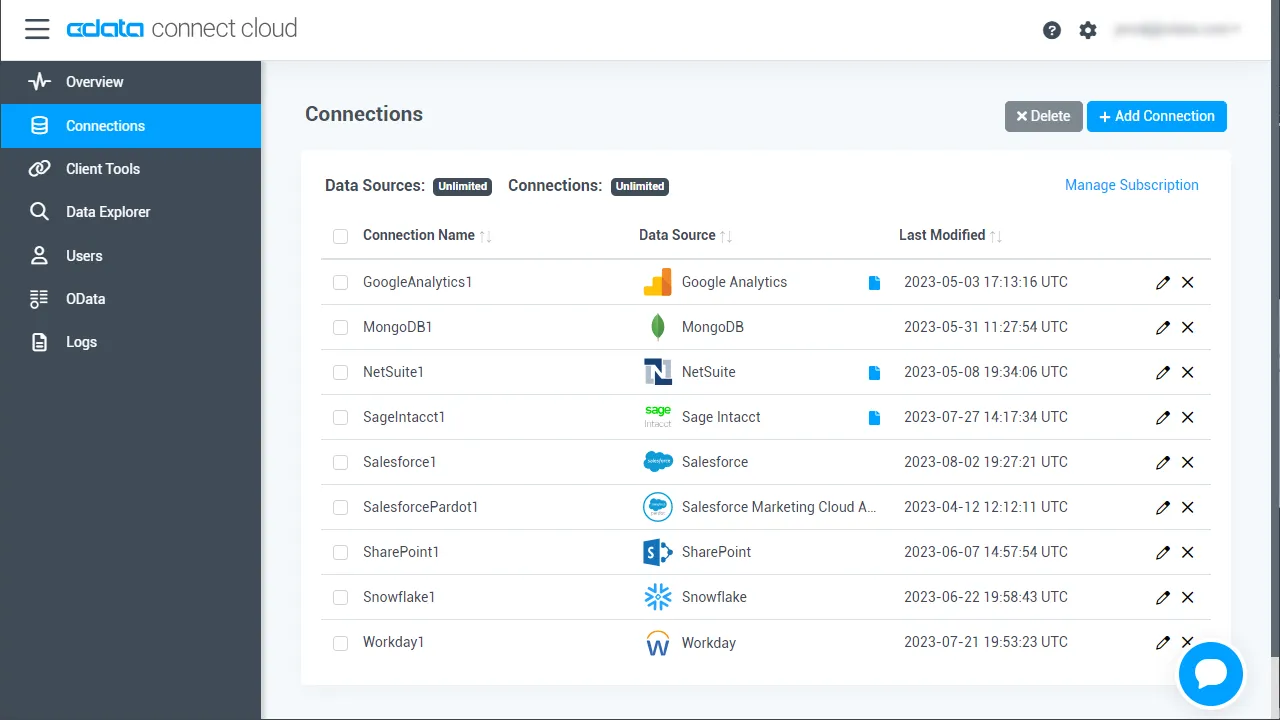
- Connect AI にログインし、Sources をクリック、次に Add Connection をクリック
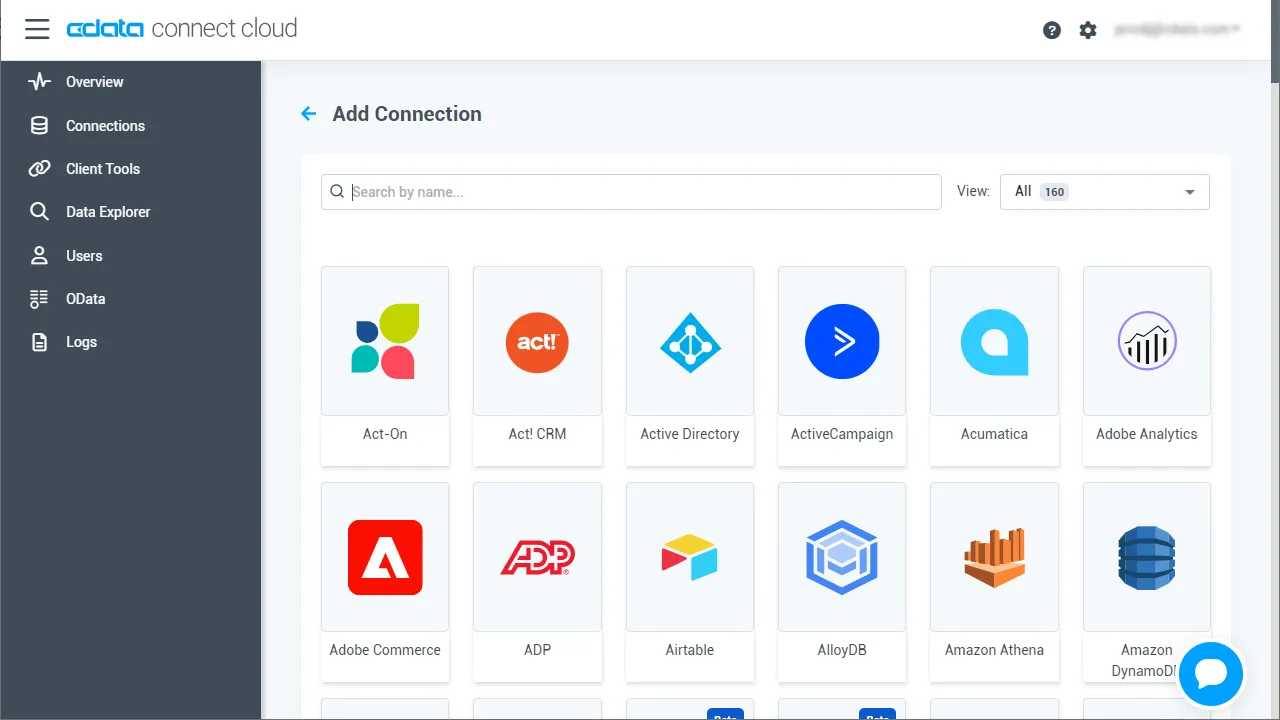
- Add Connection パネルから「Adobe Target」を選択
-
Adobe Target に接続するために必要な認証プロパティを入力します。
Adobe Target に接続するには、以下に記載されているOAuth 接続プロパティとともにTenant プロパティを指定する必要があります。他の接続プロパティは処理動作に影響を与える可能性がありますが、接続には影響しません。
以下のステップでTenant 名を確認できます。
- Adobe Experience にログインします。URL は「https://experience.adobe.com/#/@mycompanyname/preferences/general-section」です。
- 「/#/@」の後の値を抽出します。この例では「mycompanyname」です。
- Tenant 接続プロパティをその値に設定します。
ユーザーアカウント(OAuth)
すべてのユーザーアカウントフローでAuthScheme をOAuthClient に設定する必要があります。
注意:OAuth を介したAdobe 認証では、2週間ごとにトークンを更新する必要があります。
すべてのアプリケーション
CData では、OAuth 認証を簡素化する組み込みOAuth アプリケーションを提供しています。または、カスタムOAuth アプリケーションを作成することもできます。詳細については、ヘルプドキュメントの「カスタムOAuthアプリの作成」をご確認ください。
OAuth アクセストークンの取得
接続するには以下のプロパティを設定します:
- InitiateOAuth:GETANDREFRESH に設定して、OAuth 交換を自動的に実行し、必要に応じてOAuthAccessToken を更新します。
- OAuthClientId:アプリを登録した際に割り当てられたクライアントID に設定します。
- OAuthClientSecret:アプリを登録した際に割り当てられたクライアントシークレットに設定します。
- CallbackURL:アプリを登録した際に定義されたリダイレクトURI に設定します。例:https://localhost:3333
これらの設定により、CData 製品はAdobe Target からアクセストークンを取得し、それを使用してデータを要求します。OAuth値はOAuthSettingsLocation で指定された場所に保存され、接続間で確実に保持されます。
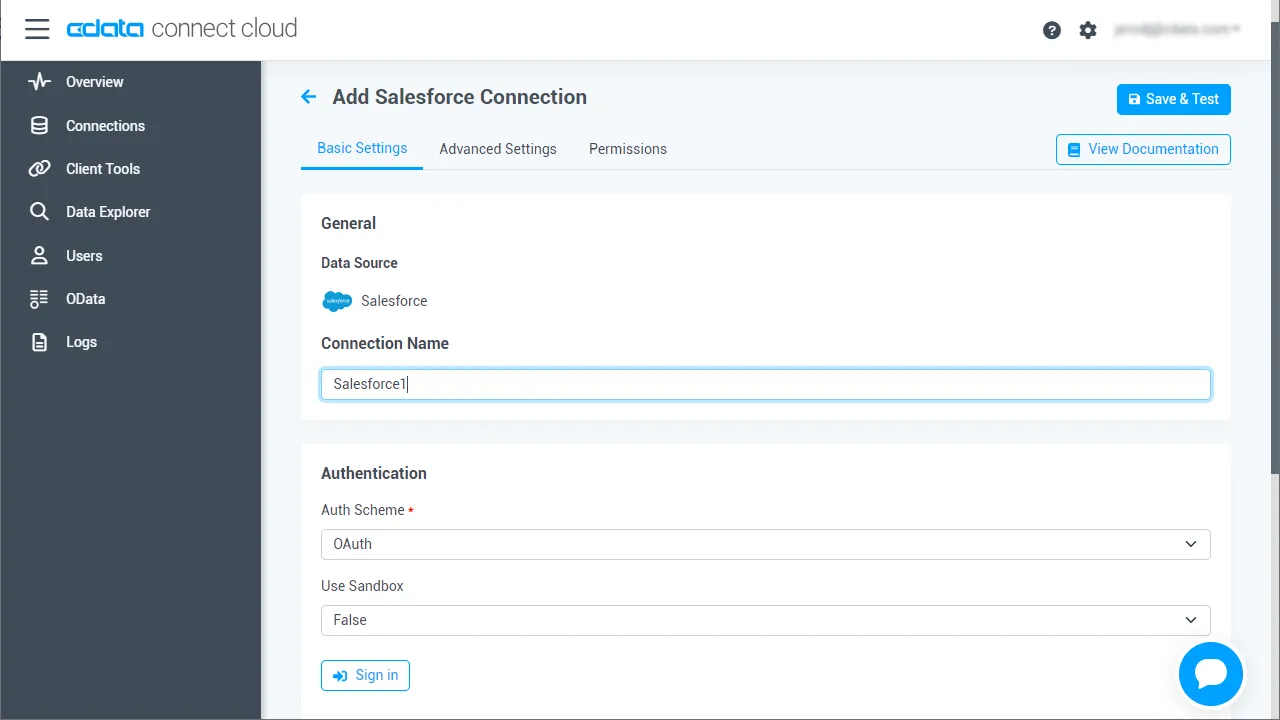
- Save & Test をクリック
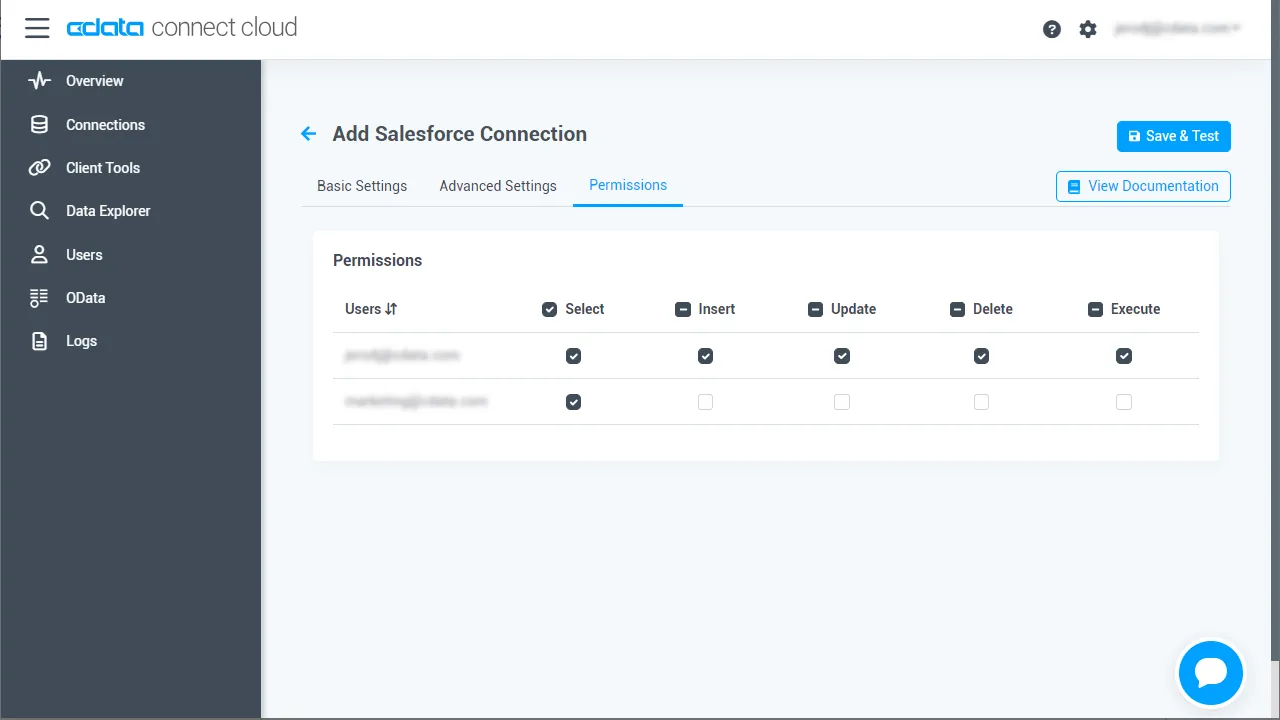
- Permissions タブを開き、ユーザーベースの権限を設定
Personal Access Token を追加
Personal Access Token(PAT)は、Dataiku から Connect AI への接続を認証するために使用されます。きめ細かいアクセス制御を維持するため、統合ごとに個別の PAT を作成することをお勧めします
- Connect AI アプリの右上にある歯車アイコン()をクリックして Settings を開く
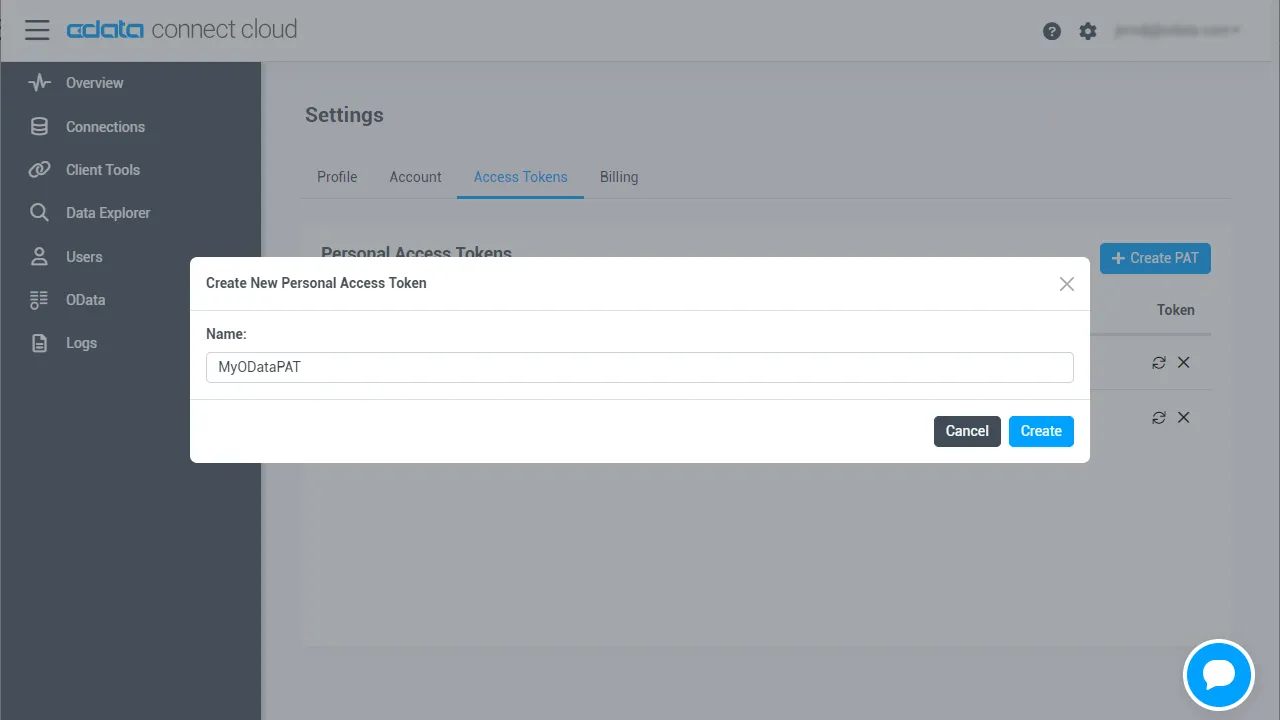
- Settings ページで Access Tokens セクションに移動し、 Create PAT をクリック
- PAT にわかりやすい名前を付けて Create をクリック
- トークンが表示されたらコピーして安全な場所に保存してください。再度表示されることはありません
Adobe Target 接続の設定と PAT の生成が完了したら、Dataiku から Connect AI 経由でAdobe Target のデータに接続できます。
ステップ 2:Dataiku とコード環境を準備
Dataiku の専用 Python コード環境が、MCP ベースの通信に必要なランタイムサポートを提供します。Dataiku エージェントを CData Connect AI に接続できるようにするには、Python 環境を作成し、エージェントとサーバー間の対話に必要な MCP クライアント依存関係をインストールします。
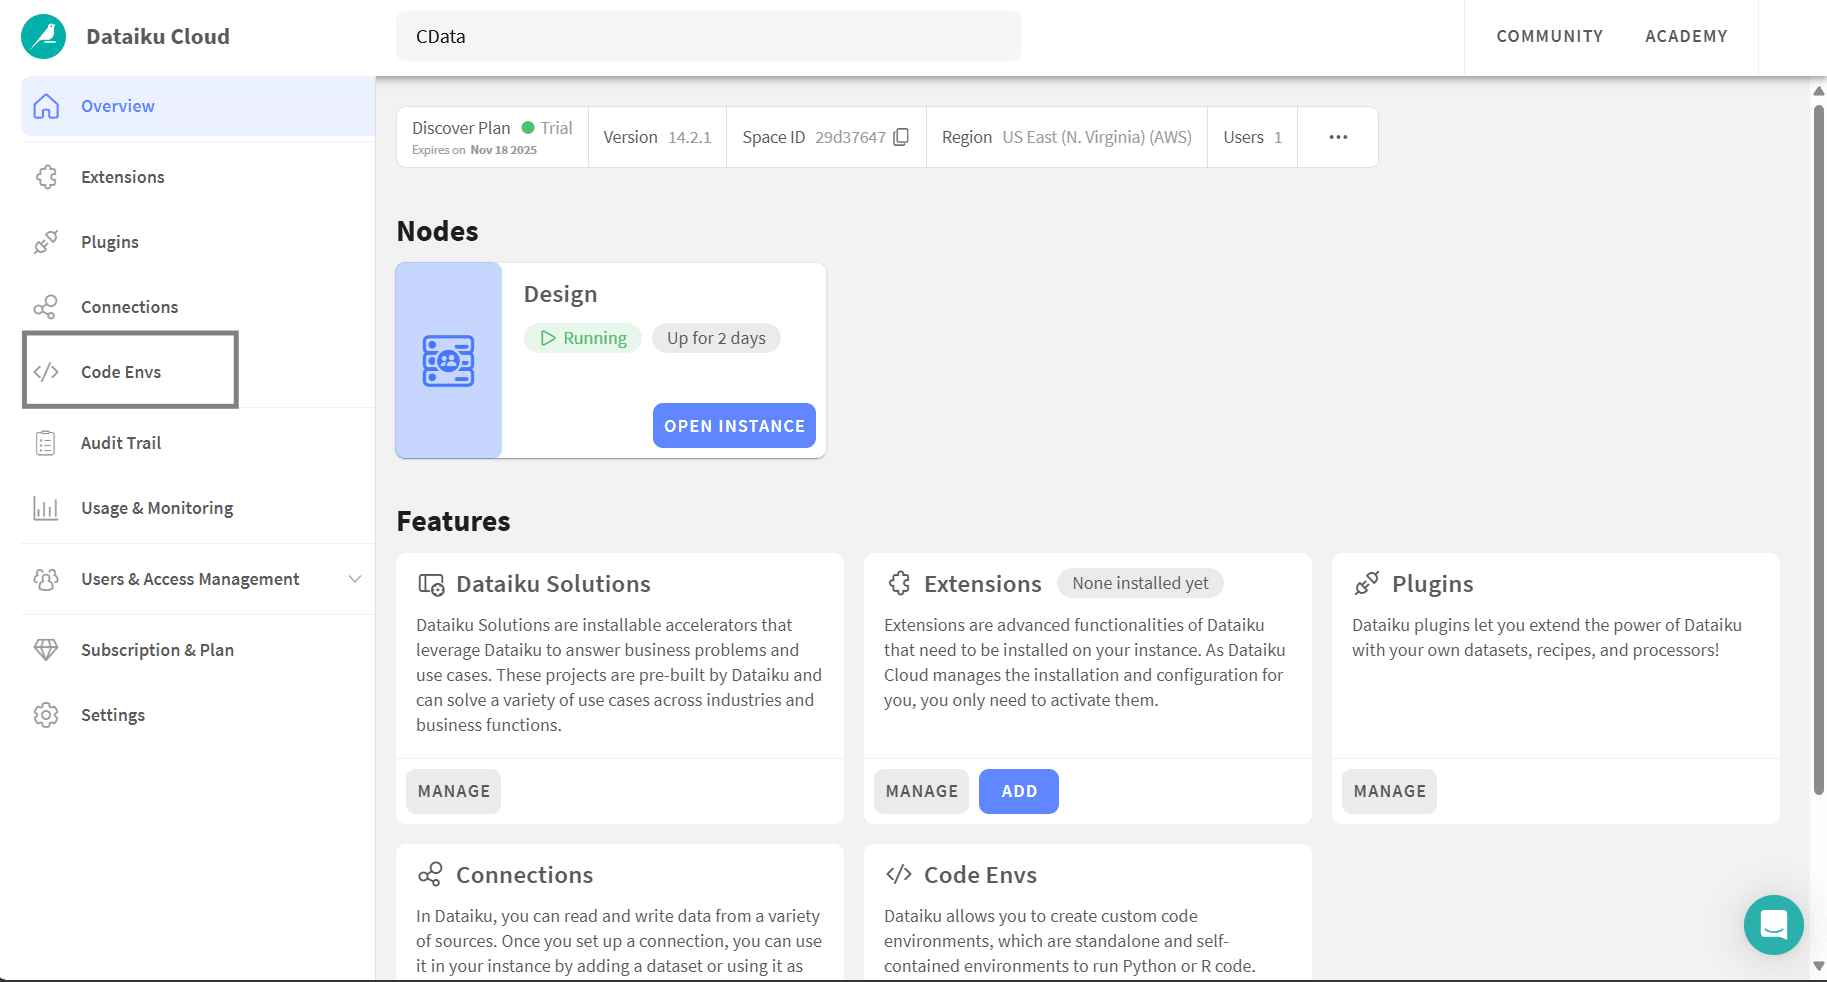
- Dataiku Cloud で Code Envs を開く
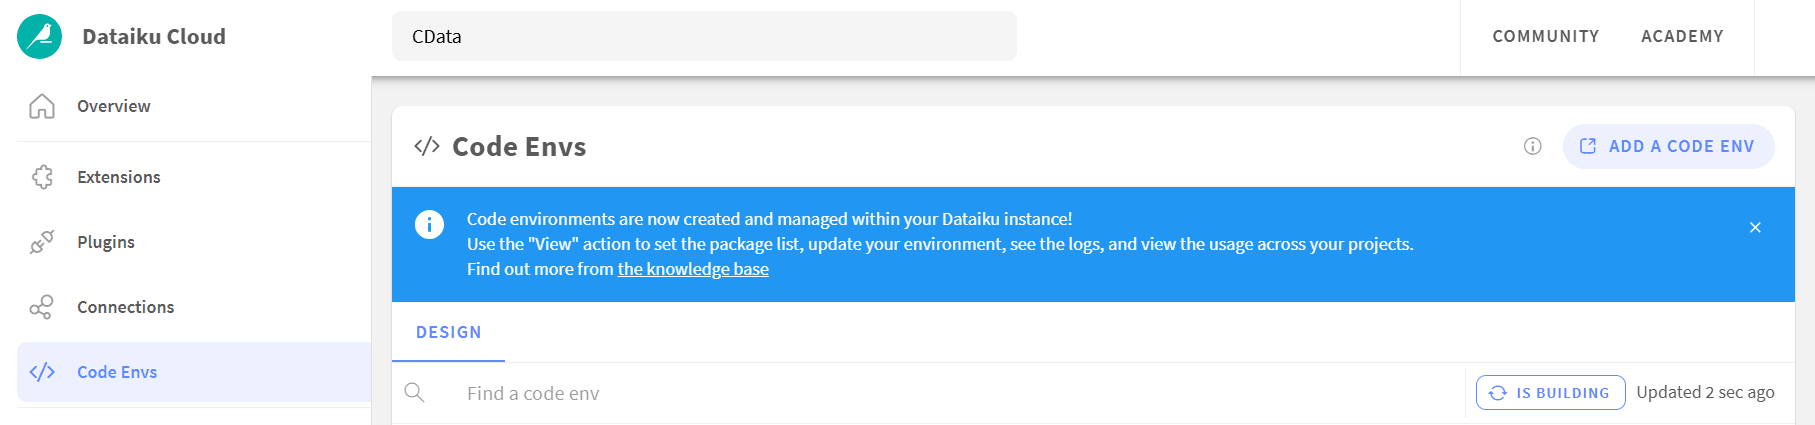
- Add a code env をクリックして DSS 設定ウィンドウを開く
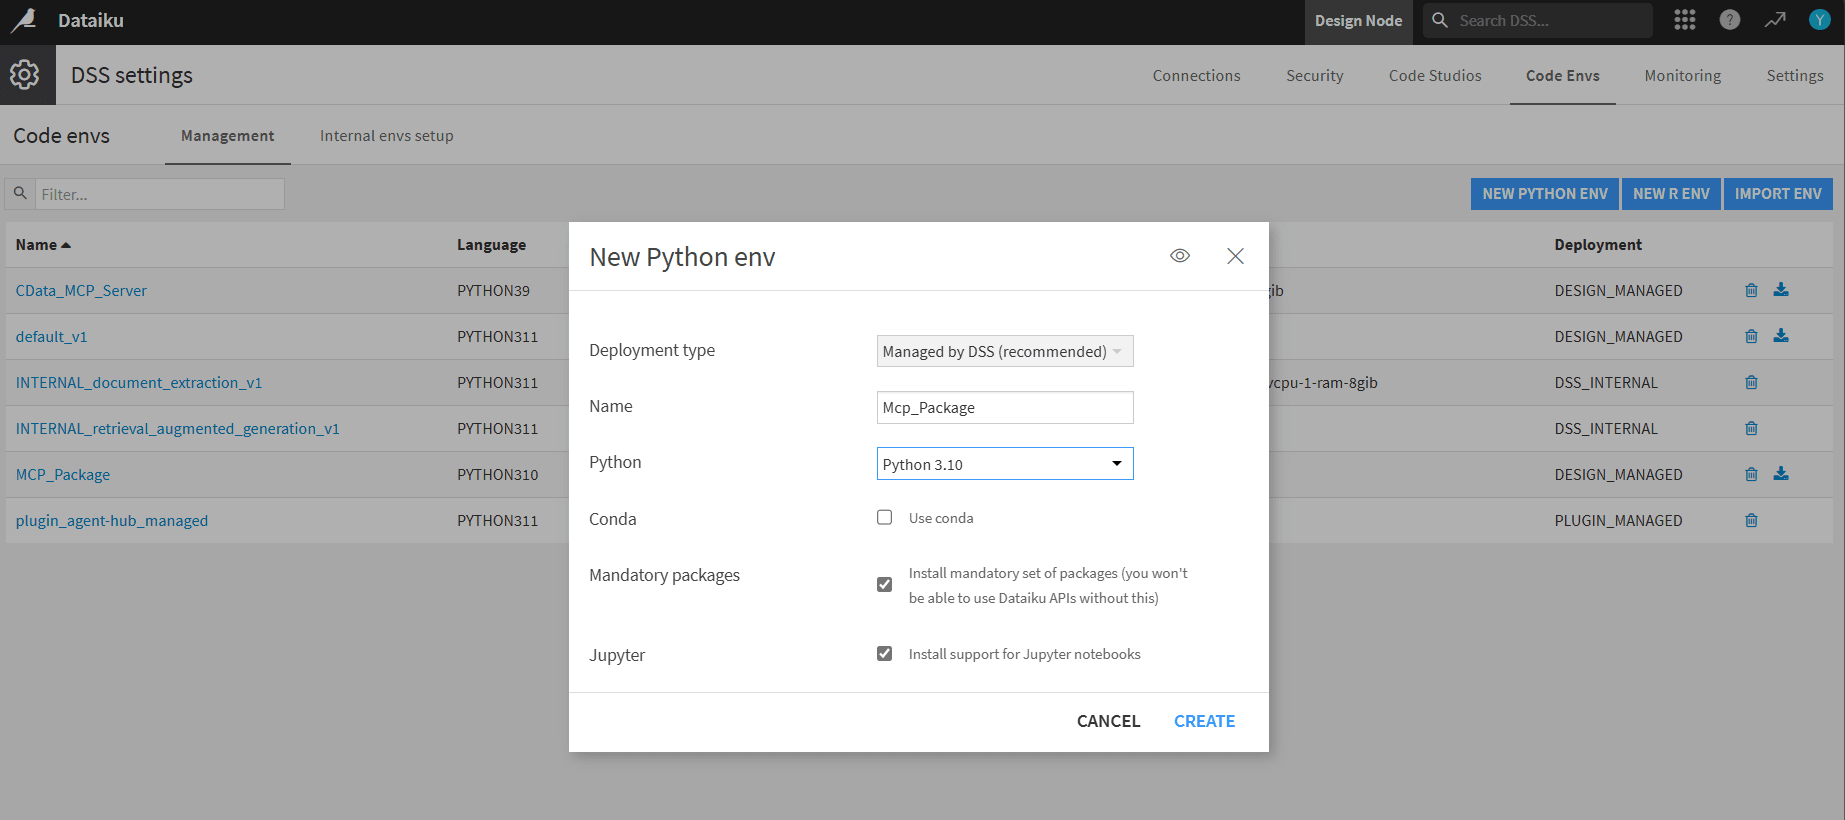
- DSS で New Python env をクリック。名前を付け(例:MCP_Package)、Python 3.10 を選択(3.10 から 3.13 がサポートされています)
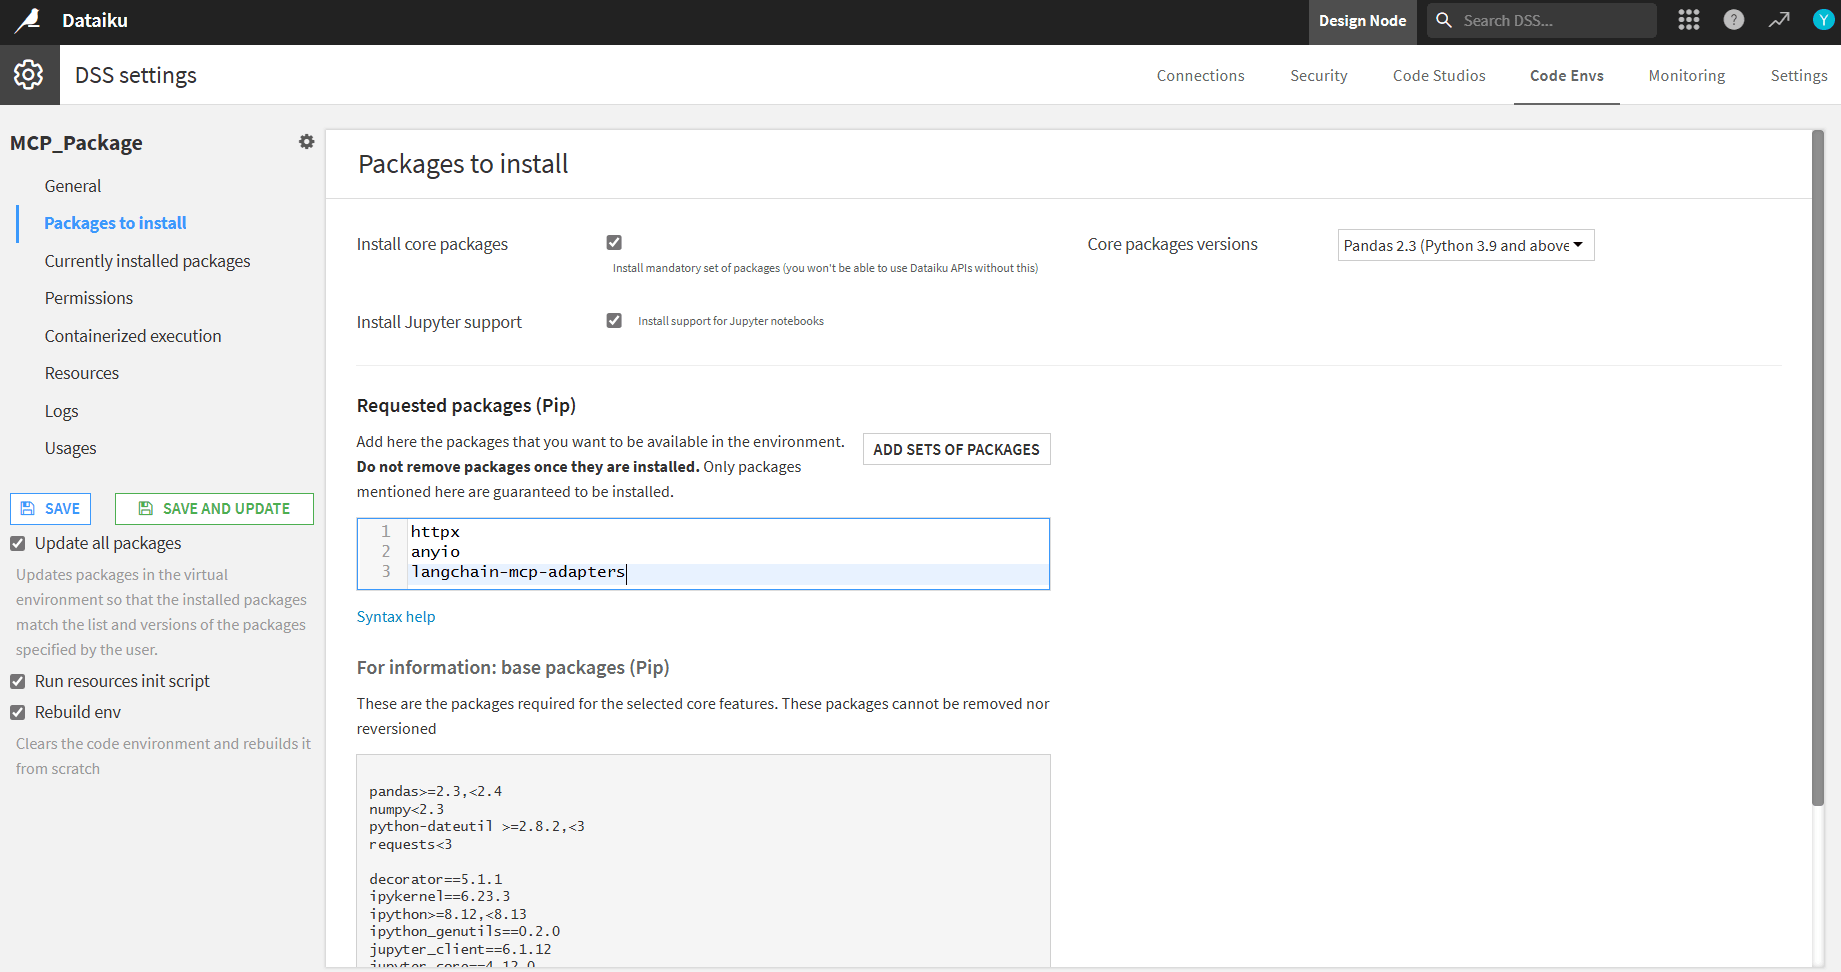
- Packages to install を開き、以下の pip パッケージを追加:
- httpx
- anyio
- langchain-mcp-adapters
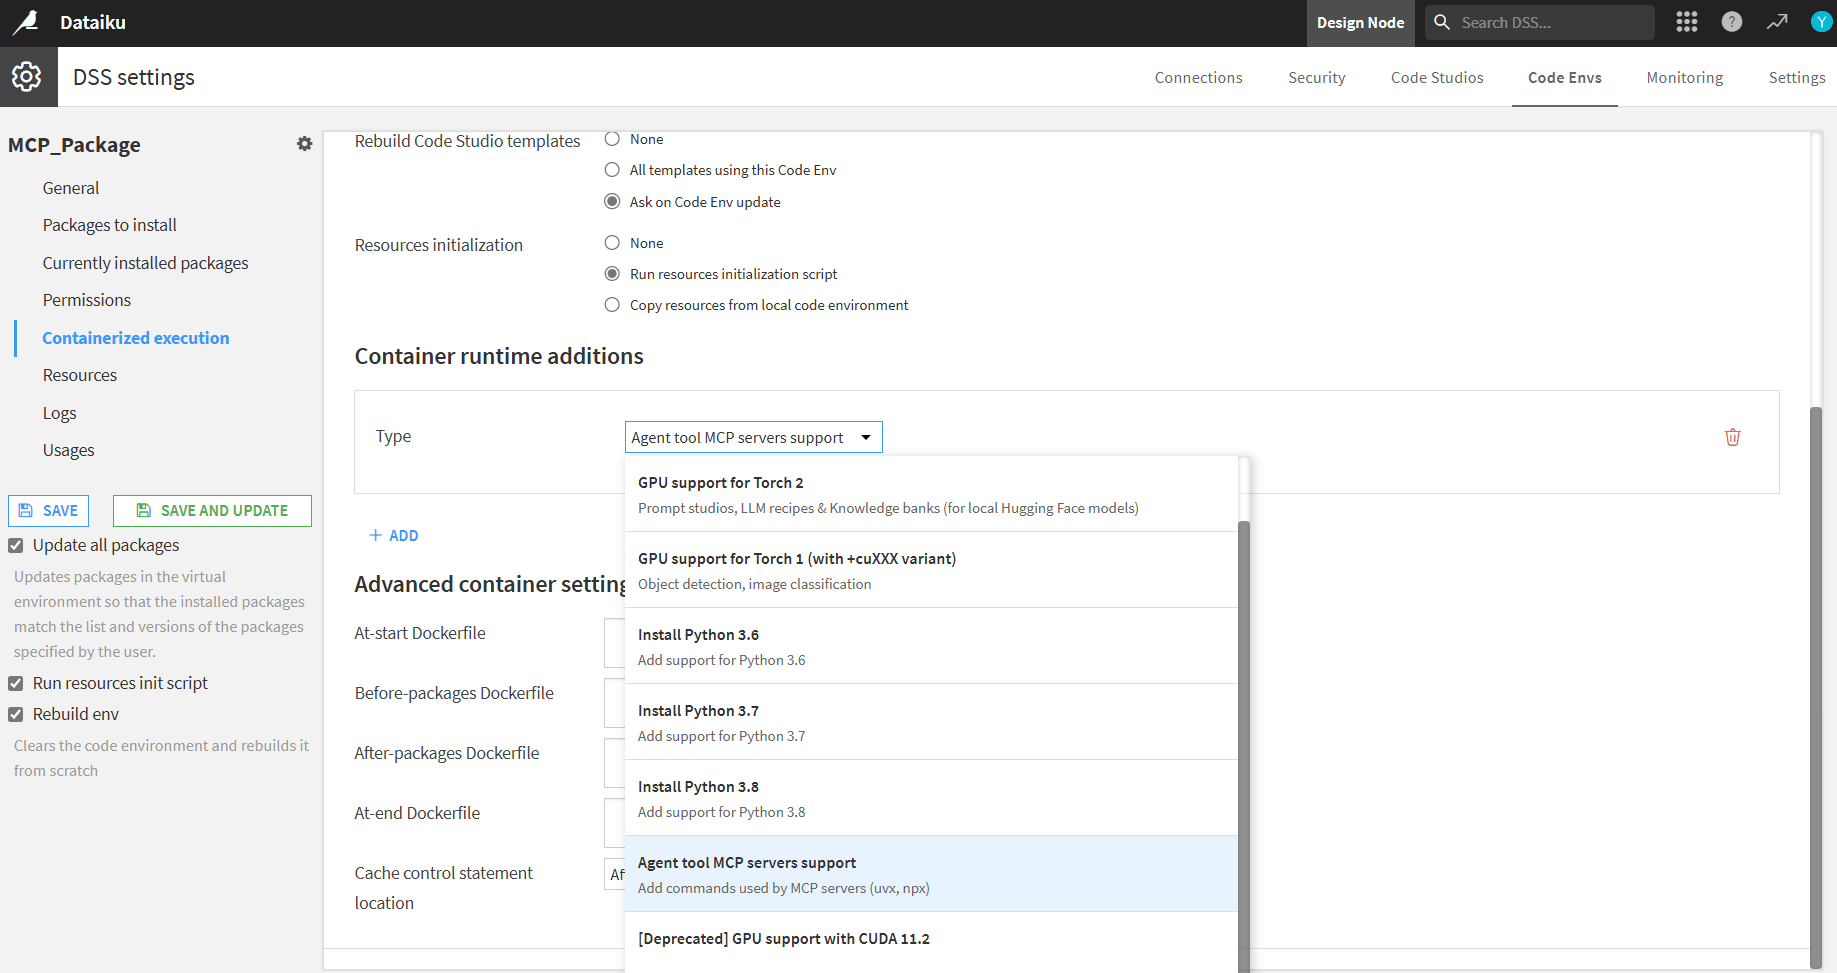
- Containerized execution を開き、Container runtime additions の下で Agent tool MCP servers support を選択
- Rebuild env をチェックし、Save and update をクリックしてパッケージをインストール
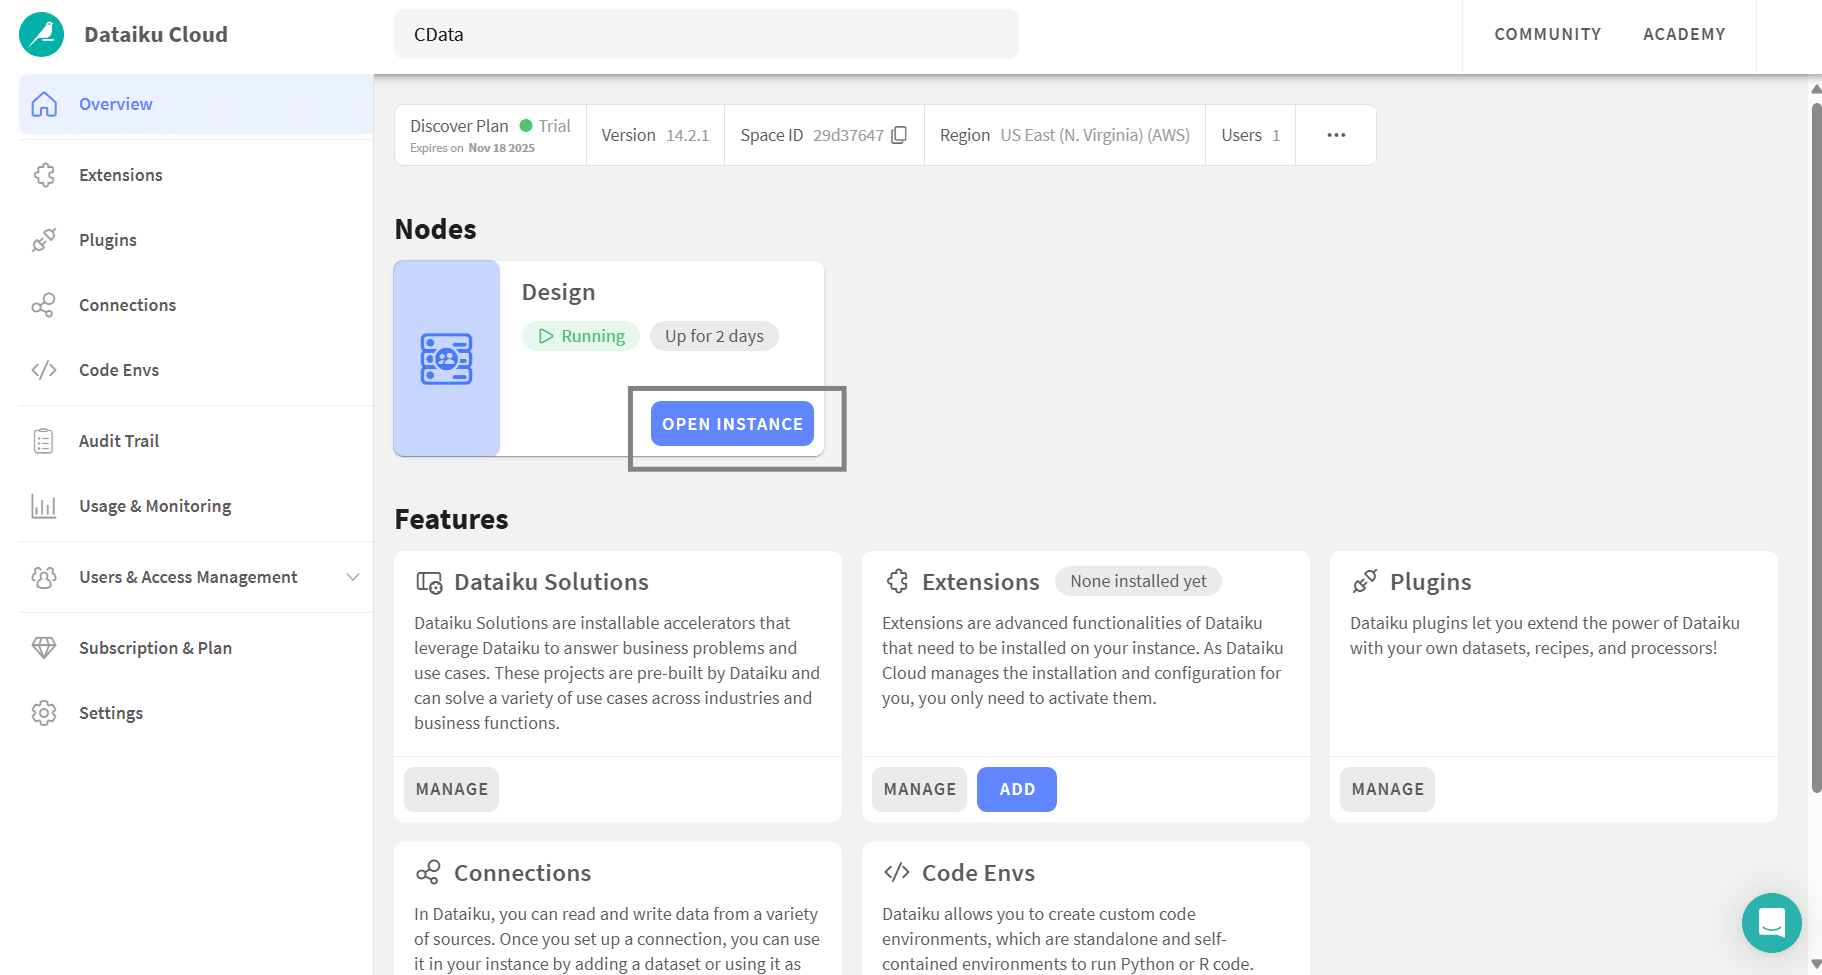
- Dataiku Cloud に戻り、Overview を開いて Open instance をクリック
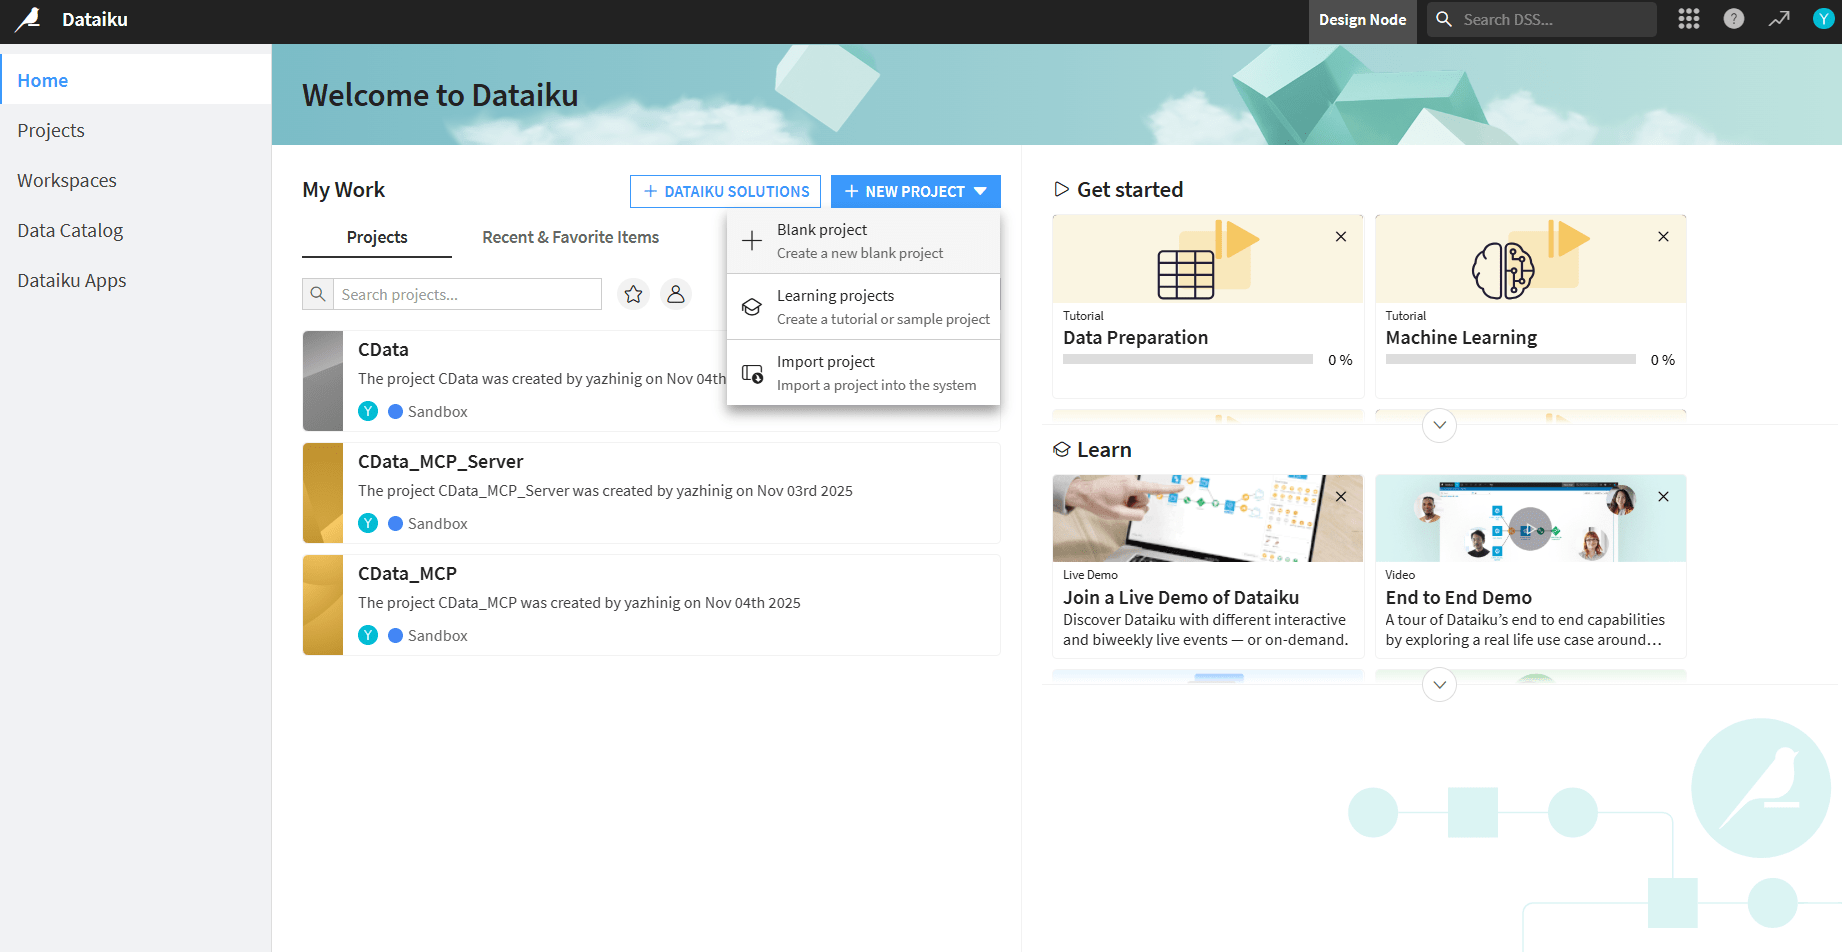
- + New project をクリックして Blank project を選択。プロジェクト名を入力
ステップ 3:Dataiku エージェントを作成して MCP サーバーに接続
Dataiku エージェントは、Dataiku ワークスペースと Connect AI 間のブリッジとして機能します。この接続を有効にするには、カスタムコードベースエージェントを作成し、設定した Python 環境を割り当て、Connect AI の認証情報を埋め込んで、エージェントがリアルタイムのAdobe Target のデータにクエリ・操作できるようにします。
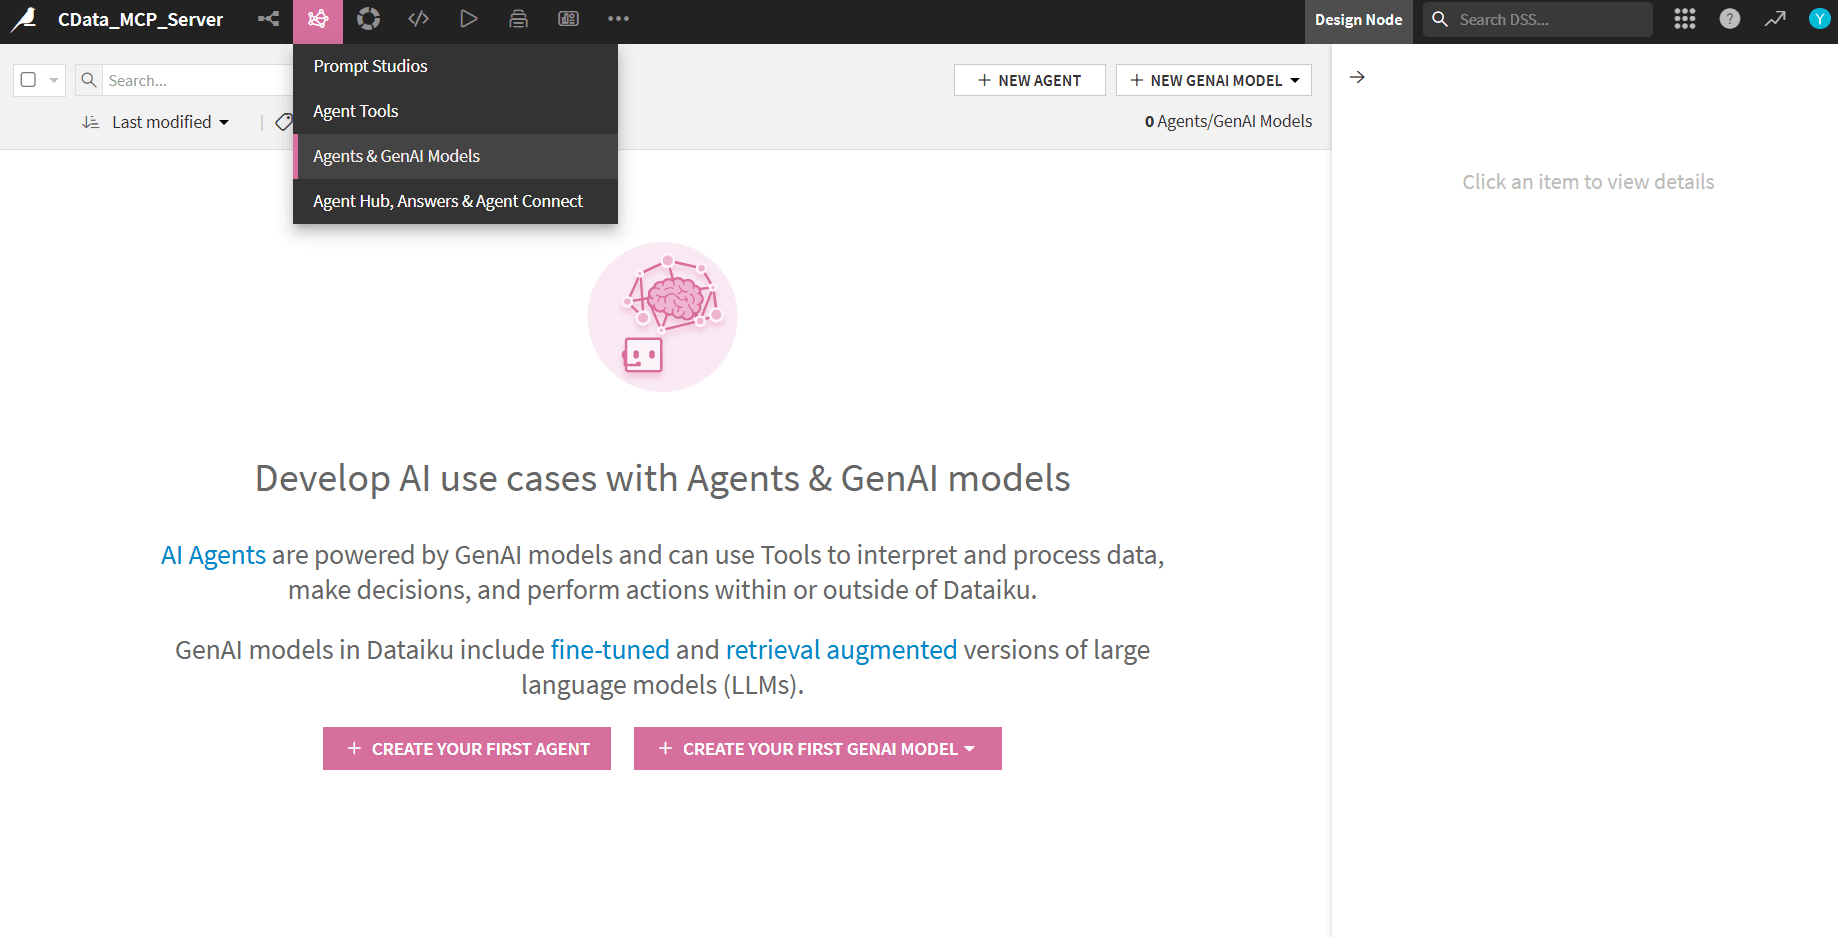
- Agents & GenAI Models に移動し、Create your first agent をクリック
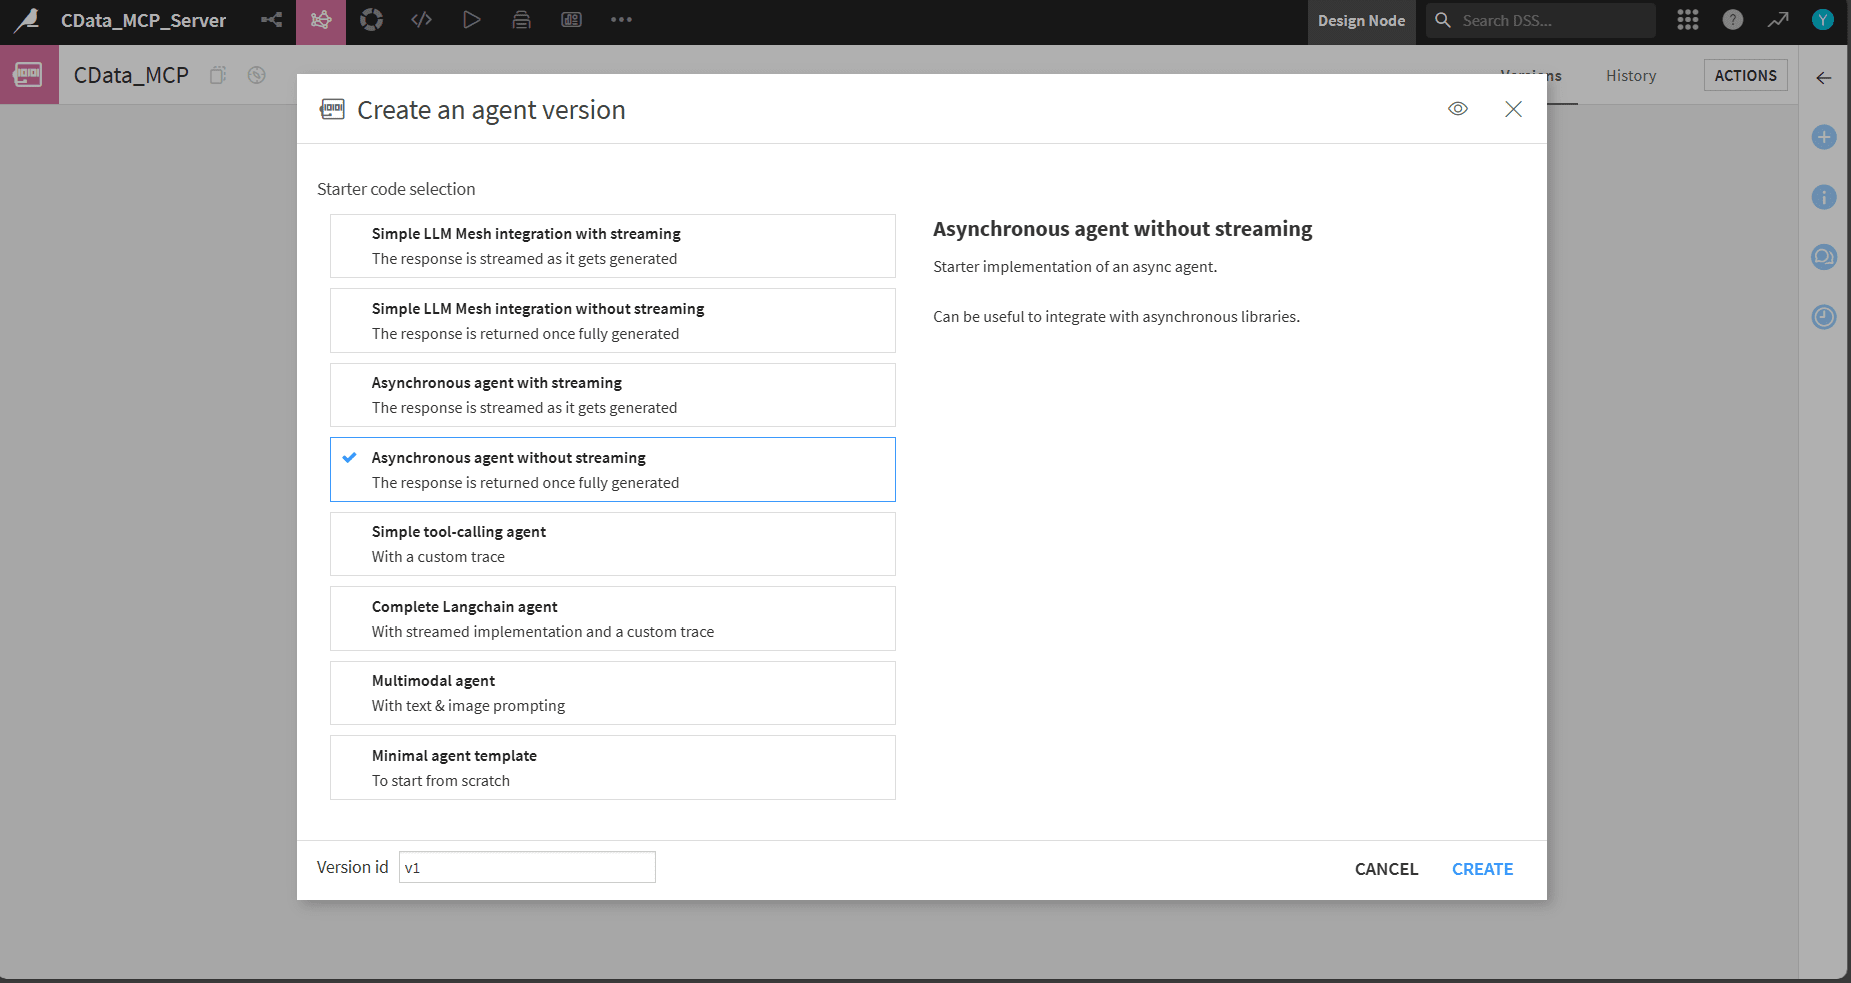
- Code agent を選択し、名前を付け、Agent version で Asynchronous agent without streaming を選択
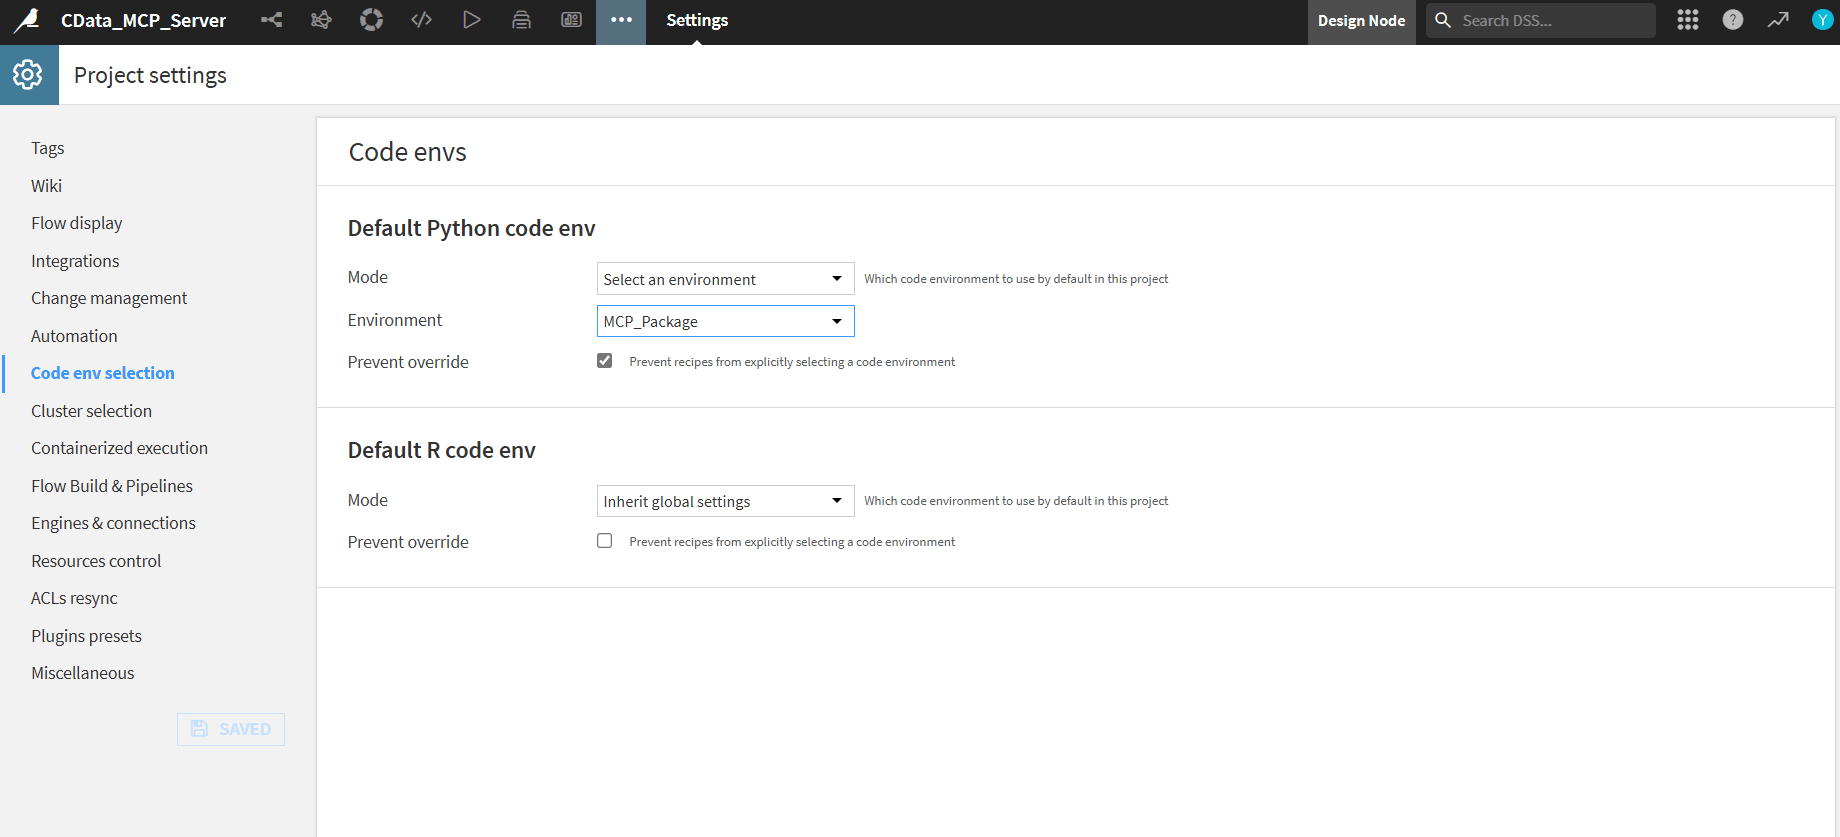
- 上部のタブから Settings を選択。Code env selection で Default Python code env を作成した環境(例:MCP_Package)に設定
- Agent の Design タブに戻り、以下のコードを貼り付けます。EMAIL と PAT を自分の値に置き換えてください
- 右側のパネルで Quick Test を開く
- JSON コードを貼り付けて Run test をクリック
import os
import base64
from typing import Dict, Any, List

from dataiku.llm.python import BaseLLM
from langchain_mcp_adapters.client import MultiServerMCPClient

# ---------- Persistent MCP client (cached between calls) ----------
_MCP_CLIENT = None

def _get_mcp_client() -> MultiServerMCPClient:
    """Create (or reuse) a MultiServerMCPClient to CData Cloud MCP."""
    global _MCP_CLIENT
    if _MCP_CLIENT is not None:
        return _MCP_CLIENT

    # Set creds via env/project variables ideally
    EMAIL = os.getenv("CDATA_EMAIL", "YOUR_EMAIL")
    PAT   = os.getenv("CDATA_PAT",   "YOUR_PAT")
    BASE_URL = "https://mcp.cloud.cdata.com/mcp"

    if not EMAIL or PAT == "YOUR_PAT":
        raise ValueError("Set CDATA_EMAIL and CDATA_PAT as env variables or inline in the code.")

    token = base64.b64encode(f"{EMAIL}:{PAT}".encode()).decode()
    headers = {"Authorization": f"Basic {token}"}

    _MCP_CLIENT = MultiServerMCPClient(
        connections={
            "cdata": {
                "transport": "streamable_http",
                "url": BASE_URL,
                "headers": headers,
            }
        }
    )
    return _MCP_CLIENT


def _pick_tool(tools, names: List[str]):
    L = [n.lower() for n in names]
    return next((t for t in tools if t.name.lower() in L), None)


async def _route(prompt: str) -> str:
    """
    Simple intent router:
      - 'list connections' / 'list catalogs' -> getCatalogs
      - 'sql: ...' or 'query: ...' -> queryData
      - otherwise -> help text
    """
    client = _get_mcp_client()
    tools = await client.get_tools()

    p = prompt.strip()
    low = p.lower()

    # 1) List connections (catalogs)
    if "list connections" in low or "list catalogs" in low:
        t = _pick_tool(tools, ["getCatalogs", "listCatalogs"])
        if not t:
            return "No 'getCatalogs' tool found on the MCP server."
        res = await t.ainvoke({})
        return str(res)[:4000]

    # 2) Run SQL
    if low.startswith("sql:") or low.startswith("query:"):
        sql = p.split(":", 1)[1].strip()
        t = _pick_tool(tools, ["queryData", "sqlQuery", "runQuery", "query"])
        if not t:
            return "No query-capable tool (queryData/sqlQuery) found on the MCP server."
        try:
            res = await t.ainvoke({"query": sql})
            return str(res)[:4000]
        except Exception as e:
            return f"Query failed: {e}"

    # 3) Help
    return (
        "Connected to CData MCP

"
        "Say **'list connections'** to view available sources, or run a SQL like:
"
        "  sql: SELECT * FROM [Salesforce1].[SYS].[Connections] LIMIT 5

"
        "Remember to use bracket quoting for catalog/schema/table names."
    )


class MyLLM(BaseLLM):
    async def aprocess(self, query: Dict[str, Any], settings: Dict[str, Any], trace: Any):
        # Extract last user message from the Quick Test payload
        prompt = ""
        try:
            prompt = (query.get("messages") or [])[-1].get("content", "")
        except Exception:
            prompt = ""

        try:
            reply = await _route(prompt)
        except Exception as e:
            reply = f"Error: {e}"

        # The template expects a dict with a 'text' key
        return {"text": reply}
クイックテストを実行
{
   "messages": [
      {
         "role": "user",
         "content": "list connections"
      }
   ],
   "context": {}
}
エージェントとチャット
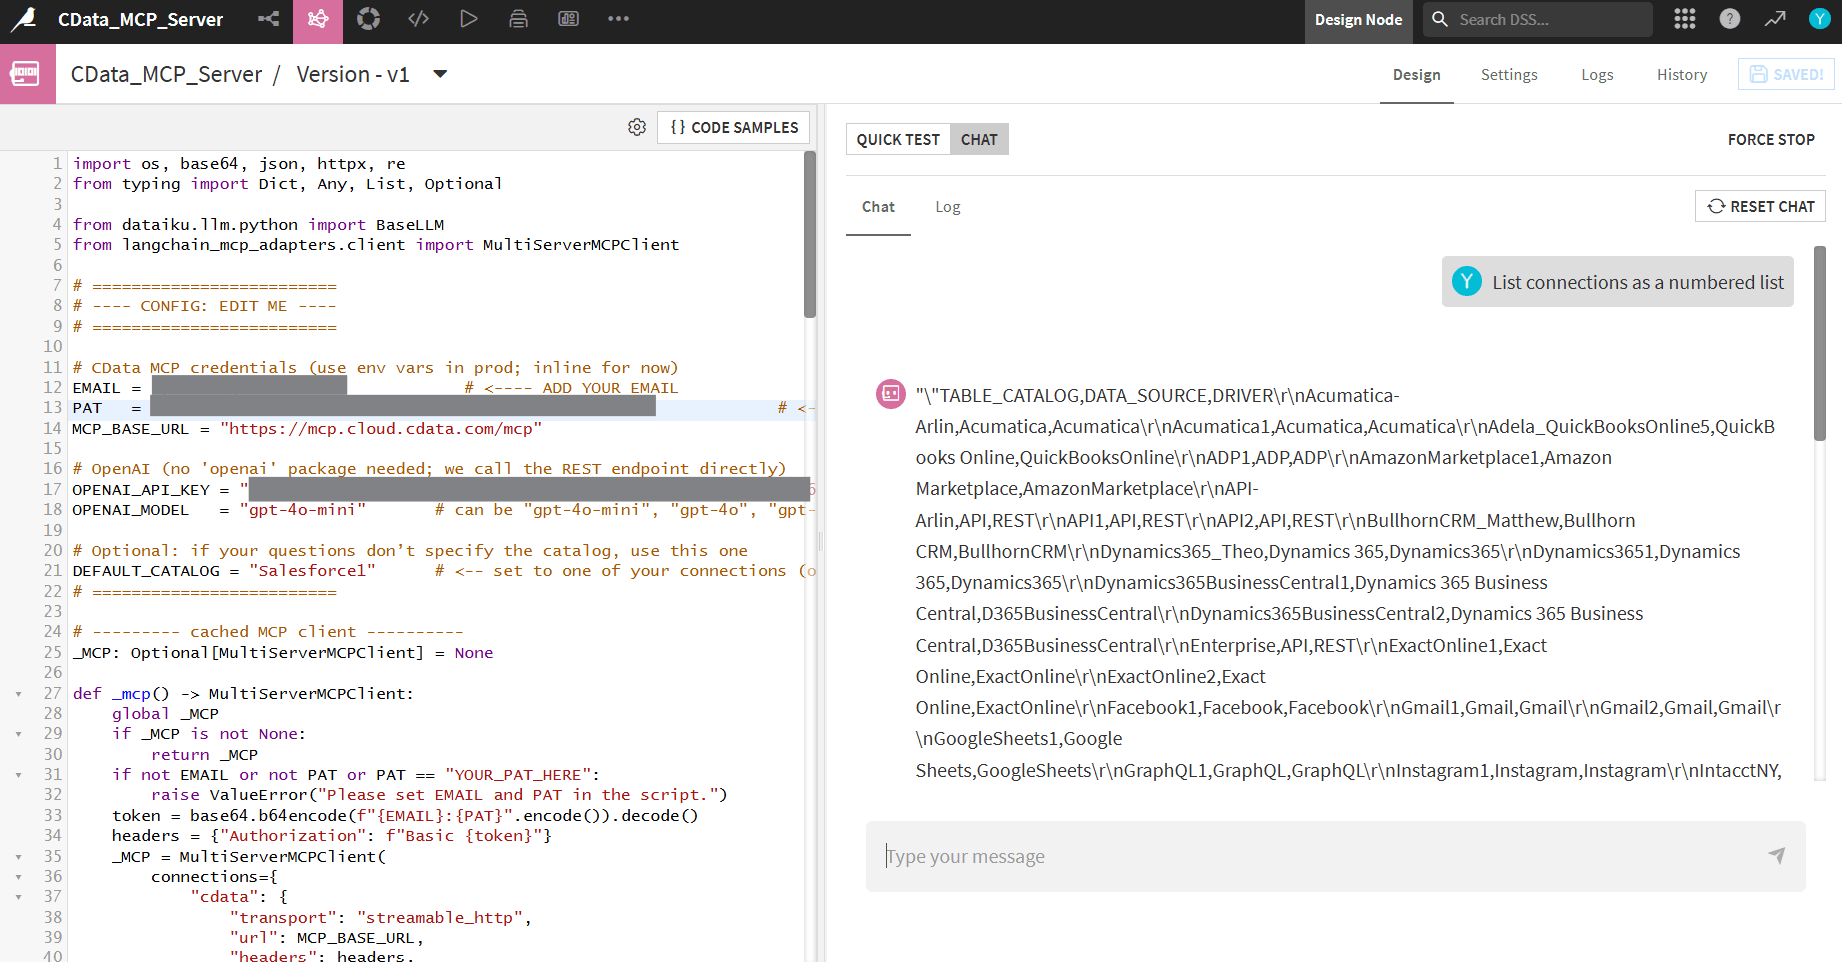
Chat タブに切り替えて、「List all connections」 のようなプロンプトを試してみてください。チャット出力に接続カタログの一覧が表示されます。
CData Connect AI を入手
AI エージェントから 数百種類の SaaS、ビッグデータ、NoSQL ソースにアクセスするには、CData Connect AI をお試しください。