

Google Cloud Data FusionでBitbucket のパイプラインを構築(Connect AI)
Google Cloud Data Fusion は、ビジュアルインターフェースを使用してさまざまなソースと同期先間でデータを接続、変換、移動できるため、データパイプラインの構築と管理を簡素化します。CData Connect AI と組み合わせることで、ELT/ETL データパイプラインの構築と管理にBitbucket のデータへのアクセスが可能になります。この記事では、CData Connect AI を使用して Bitbucket へのライブ接続を作成する方法と、Cloud Data Fusion プラットフォームからリアルタイムのBitbucket のデータに接続・アクセスする方法を説明します。
Cloud Data Fusion 用の Bitbucket 接続を設定
Cloud Data Fusion から Bitbucket への接続は、CData Connect AI によって実現されます。Cloud Data Fusion からBitbucket のデータを扱うには、まず Bitbucket 接続を作成・設定します。
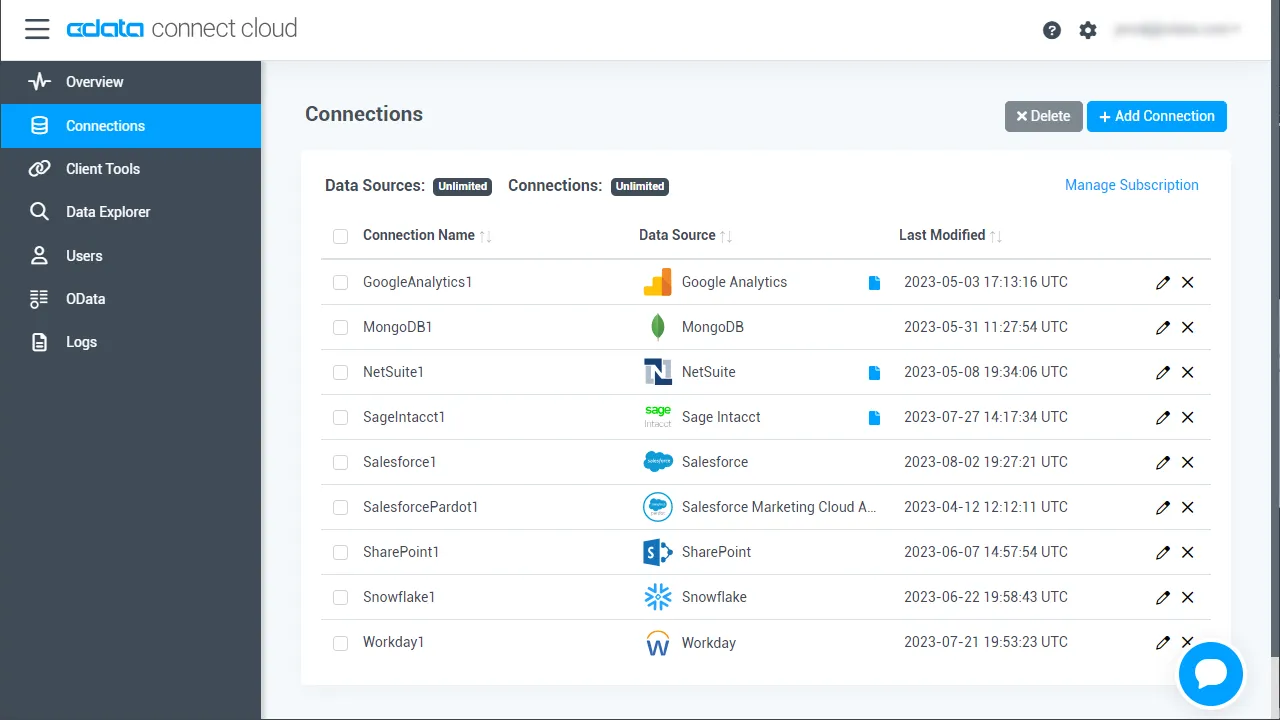
- Connect AI にログインし、Sources をクリック、次に Add Connection をクリック
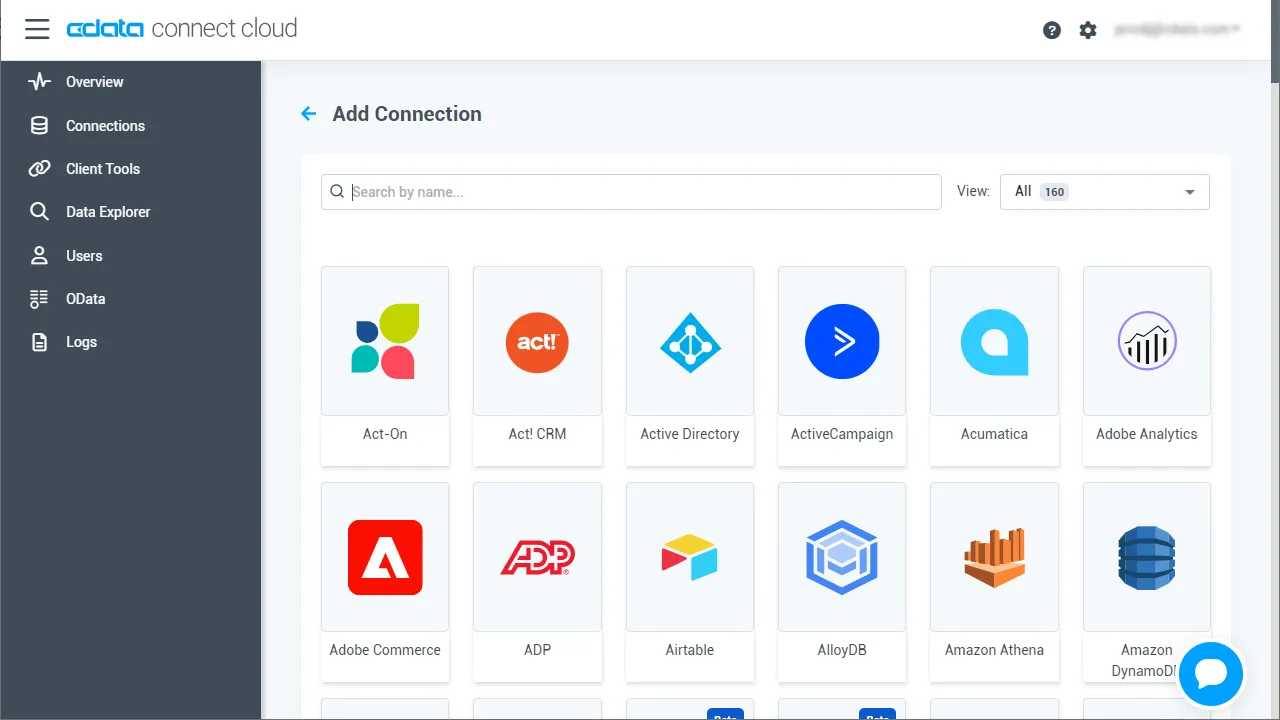
- Add Connection パネルから「Bitbucket」を選択
-
Bitbucket に接続するために必要な認証プロパティを入力します。
ほとんどのクエリでは、ワークスペースを設定する必要があります。唯一の例外は、Workspacesテーブルです。このテーブルはこのプロパティの設定を必要とせず、クエリを実行すると、Workspaceの設定に使用できるワークスペーススラッグのリストが提供されます。このテーブルにクエリを実行するには、スキーマを'Information'に設定し、SELECT * FROM Workspacesクエリを実行する必要があります。
Schemaを'Information'に設定すると、一般的な情報が表示されます。Bitbucketに接続するには、以下のパラメータを設定してください。
- Schema: ワークスペースのユーザー、リポジトリ、プロジェクトなどの一般的な情報を表示するには、これを'Information'に設定します。それ以外の場合は、クエリを実行するリポジトリまたはプロジェクトのスキーマに設定します。利用可能なスキーマの完全なセットを取得するには、sys_schemasテーブルにクエリを実行してください。
- Workspace: Workspacesテーブルにクエリを実行する場合を除き、必須です。Workspacesテーブルへのクエリにはこのプロパティは必要ありません。そのクエリはWorkspaceの設定に使用できるワークスペーススラッグのリストのみを返すためです。
Bitbucketでの認証
BitbucketはOAuth認証のみをサポートしています。すべてのOAuthフローからこの認証を有効にするには、カスタムOAuthアプリケーションを作成し、AuthSchemeをOAuthに設定する必要があります。
特定の認証ニーズ(デスクトップアプリケーション、Webアプリケーション、ヘッドレスマシン)に必要な接続プロパティについては、ヘルプドキュメントを必ず確認してください。
カスタムOAuthアプリケーションの作成
Bitbucketアカウントから、以下のステップを実行します。
- 設定(歯車アイコン)に移動し、ワークスペース設定を選択します。
- アプリと機能セクションで、OAuthコンシューマーを選択します。
- コンシューマーを追加をクリックします。
- カスタムアプリケーションの名前と説明を入力します。
- コールバックURLを設定します。
- デスクトップアプリケーションとヘッドレスマシンの場合、http://localhost:33333または任意のポート番号を使用します。ここで設定するURIがCallbackURLプロパティになります。
- Webアプリケーションの場合、信頼できるリダイレクトURLにコールバックURLを設定します。このURLは、ユーザーがアプリケーションにアクセスが許可されたことを確認するトークンを持って戻るWebの場所です。
- クライアント認証情報を使用して認証する予定の場合、これはプライベートコンシューマーですを選択する必要があります。ドライバーでは、AuthSchemeをclientに設定する必要があります。
- OAuthアプリケーションに与える権限を選択します。これにより、読み取りおよび書き込みできるデータが決まります。
- 新しいカスタムアプリケーションを保存するには、保存をクリックします。
- アプリケーションが保存された後、それを選択して設定を表示できます。アプリケーションのKeyとSecretが表示されます。これらを将来の使用のために記録してください。Keyを使用してOAuthClientIdを設定し、Secretを使用してOAuthClientSecretを設定します。
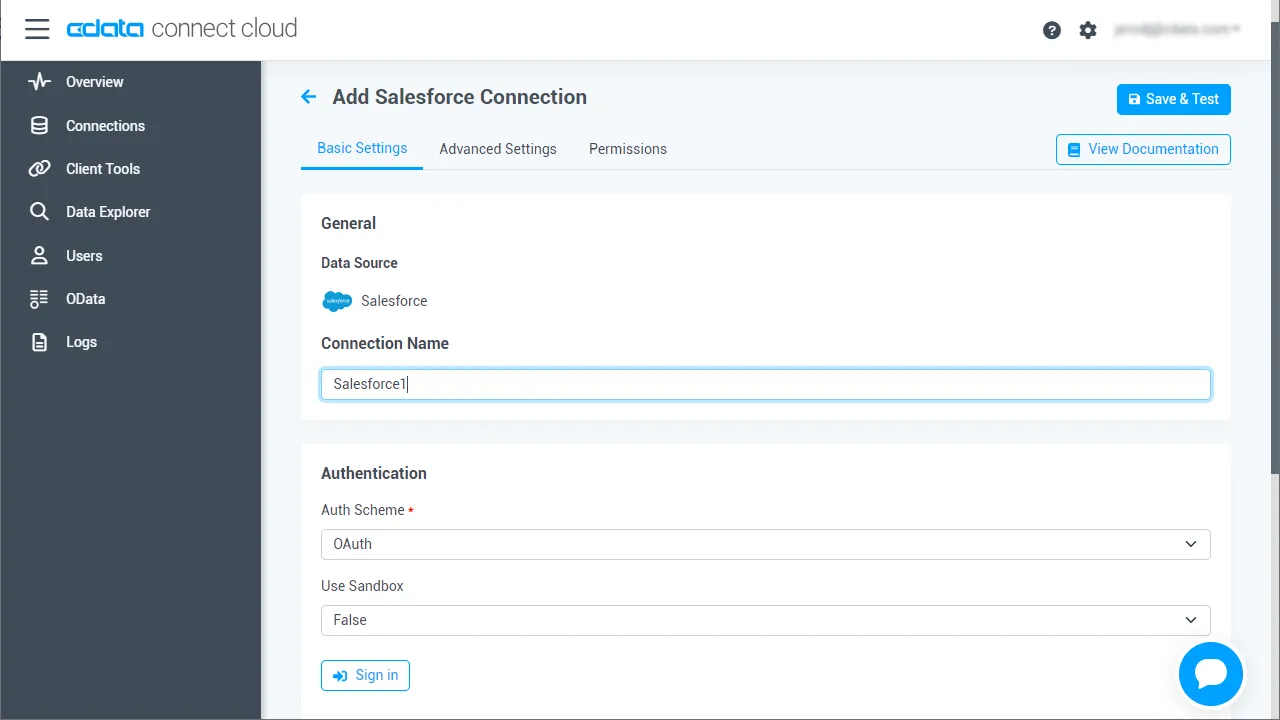
- Save & Test をクリック
-
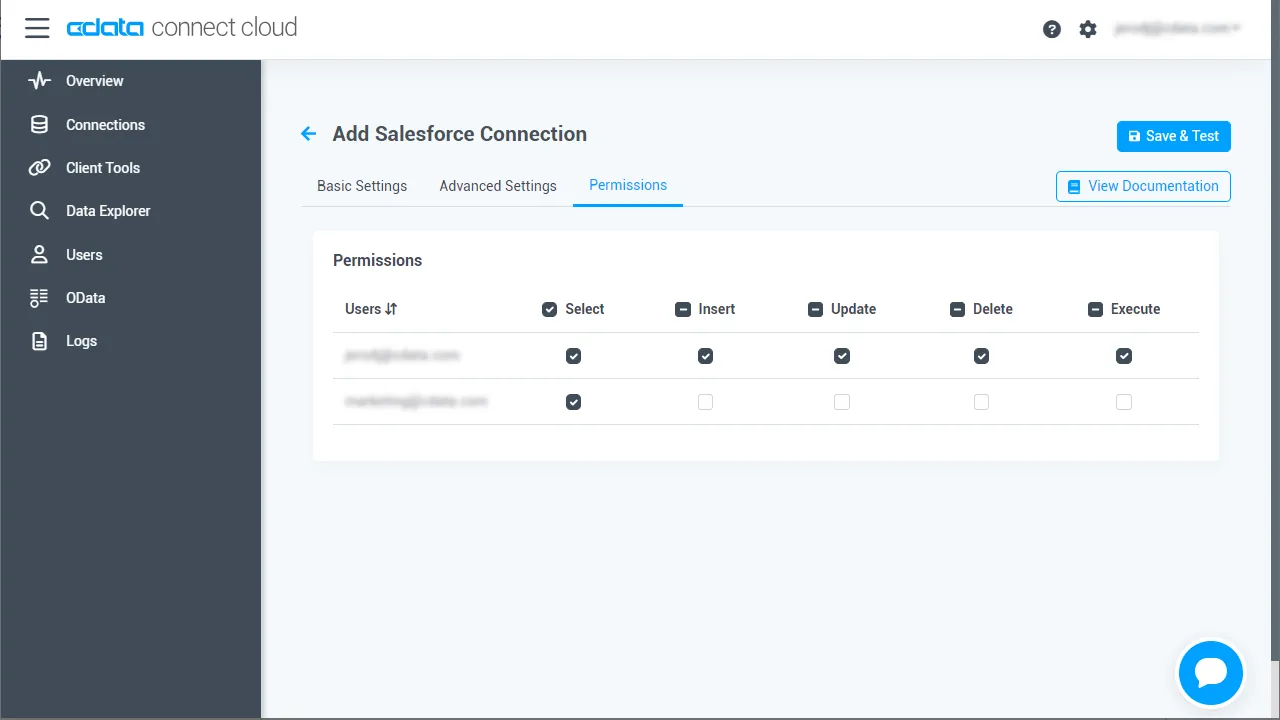
Add Bitbucket Connection ページで Permissions タブに移動し、ユーザーベースの権限を更新します。
Personal Access Token を追加
REST API、OData API、または仮想 SQL Server 経由で Connect AI に接続する場合、Personal Access Token(PAT)が Connect AI への接続認証に使用されます。アクセスの粒度を維持するため、サービスごとに個別の PAT を作成することをお勧めします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして Settings ページを開きます。
- Settings ページで Access Tokens セクションに移動し、 Create PAT をクリック。
-
PAT に名前を付けて Create をクリック。
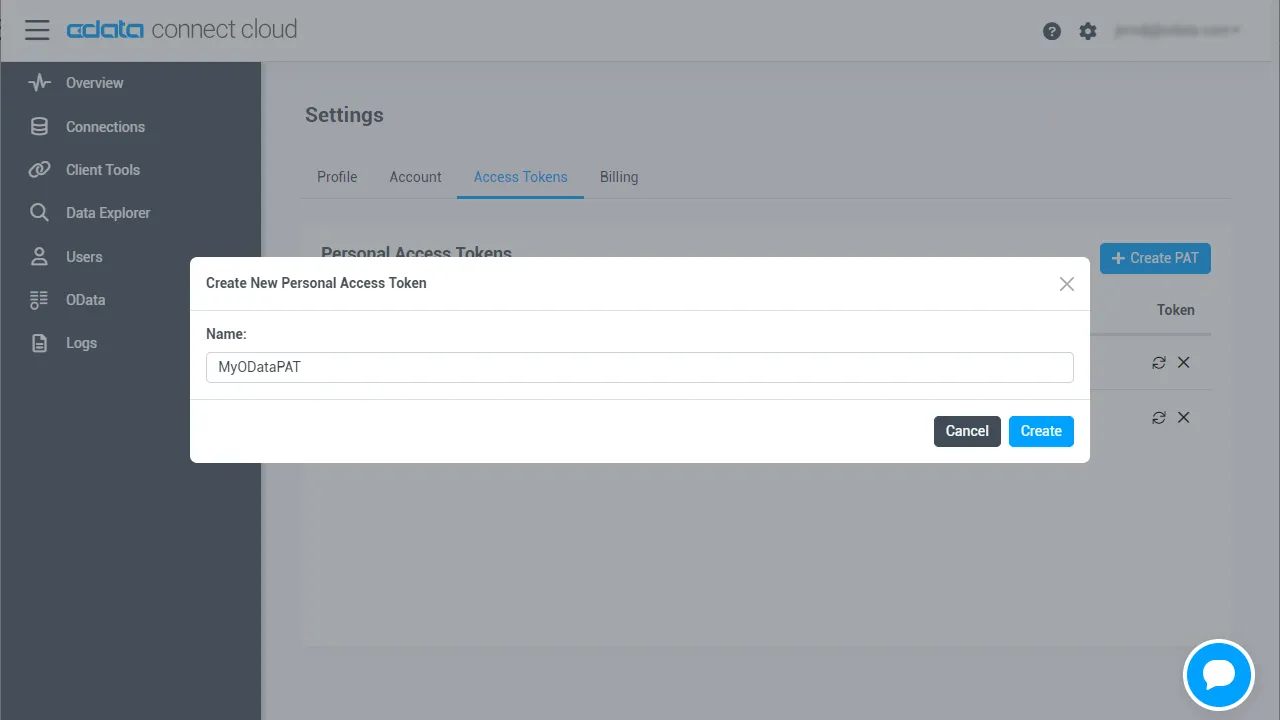
- Personal Access Token は作成時にのみ表示されるので、必ずコピーして安全な場所に保存してください。
接続の設定と PAT の生成が完了したら、Cloud Data Fusion からBitbucket のデータに接続する準備が整いました。
Cloud Data Fusion から Bitbucket に接続
以下の手順に従って、CData Connect AI JDBC ドライバーを介して Cloud Data Fusion から Bitbucket への接続を確立します:
- CData Connect AI JDBC ドライバーをダウンロード・インストール:
- CData Connect AI の Integrations ページを開きます。
- JDBC を検索・選択します。
- セットアップファイルをダウンロードして実行します。
- インストールが完了したら、インストールディレクトリ(例:C:\Program Files\CData\JDBC Driver for CData Connect\lib)から JAR ファイル(cdata.jdbc.connect.jar)をコピーします。
- Cloud Data Fusion にログイン。
- 右上の緑色の「+」ボタンをクリックしてエンティティを追加。
- Driver の下で Upload をクリック。
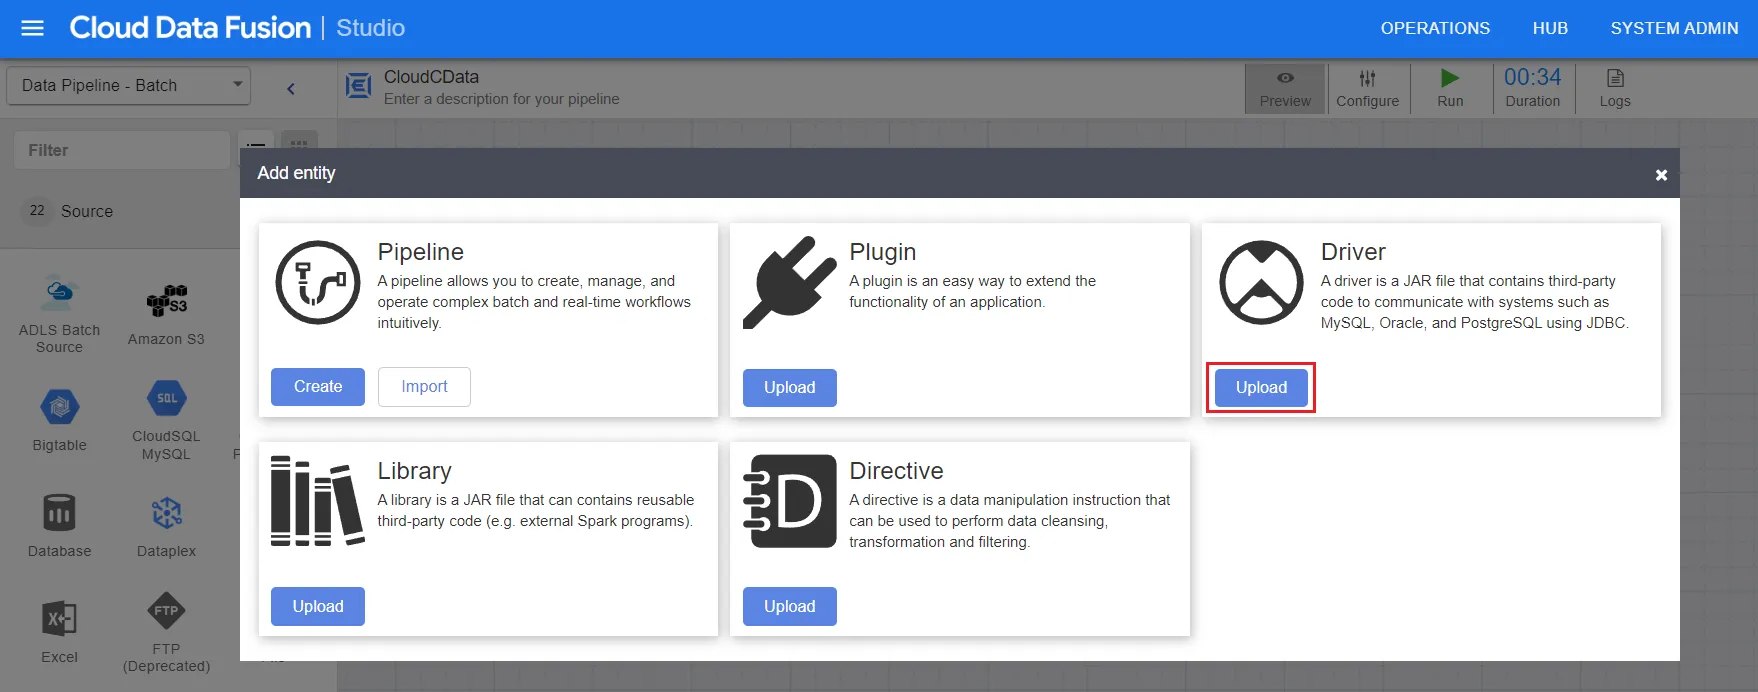
- CData Connect AI JDBC ドライバー(JAR ファイル)をアップロード。
- ドライバー設定を入力:
- Name:ドライバー名を入力
- Class name:「cdata.jdbc.connect.ConnectDriver」 と入力
- Version:ドライバーのバージョンを入力
- Description(オプション):ドライバーの説明を入力
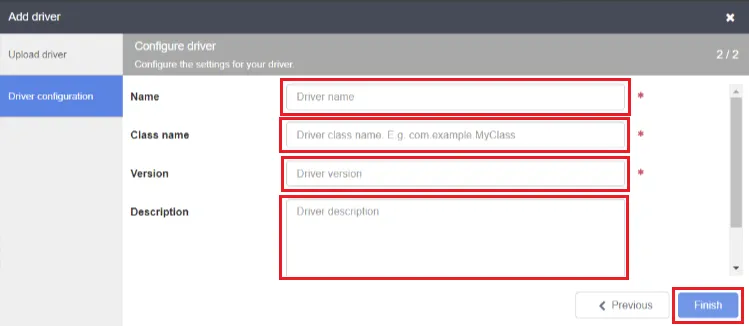
- Finish をクリック。
- ソース設定を入力:
- Label:接続を識別するための名前
- JDBC driver name:ステップ 6 で設定したドライバーを識別する JDBC ドライバー名を入力
- Connection string:JDBC 接続文字列を入力(例:
jdbc:connect:AuthScheme=Basic;user=username;password=PAT; - User:CData Connect AI のユーザー名(CData Connect AI インターフェースの右上に表示)を入力(例:「[email protected]」)
- Password:Settings ページで生成した PAT を入力
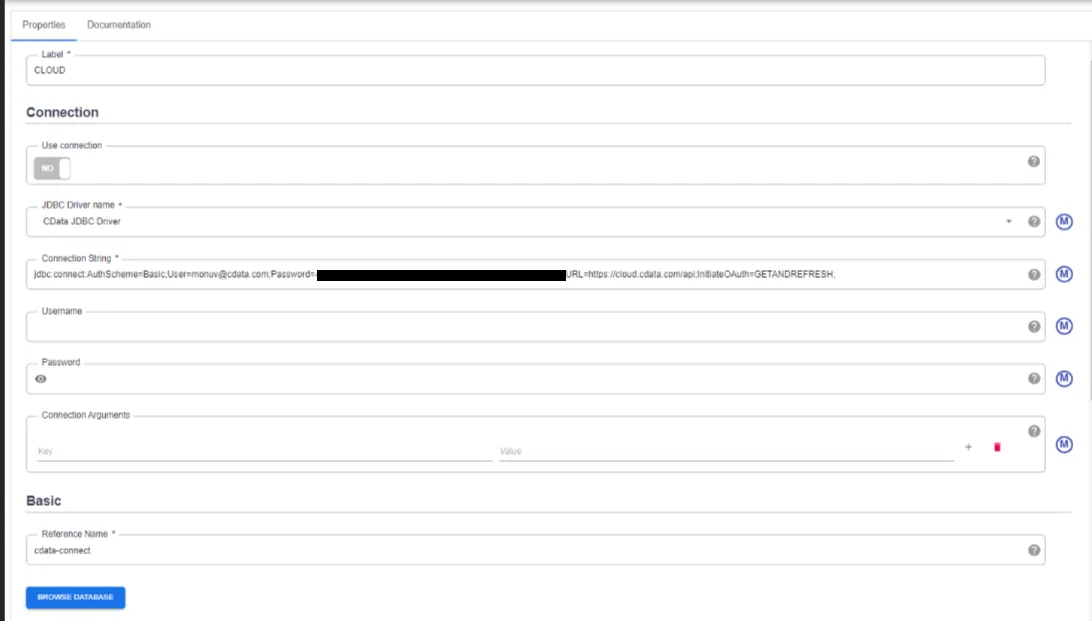
- 右上の Validate をクリック。
- 接続が成功したら、UI を通じてパイプラインを編集・管理できます。
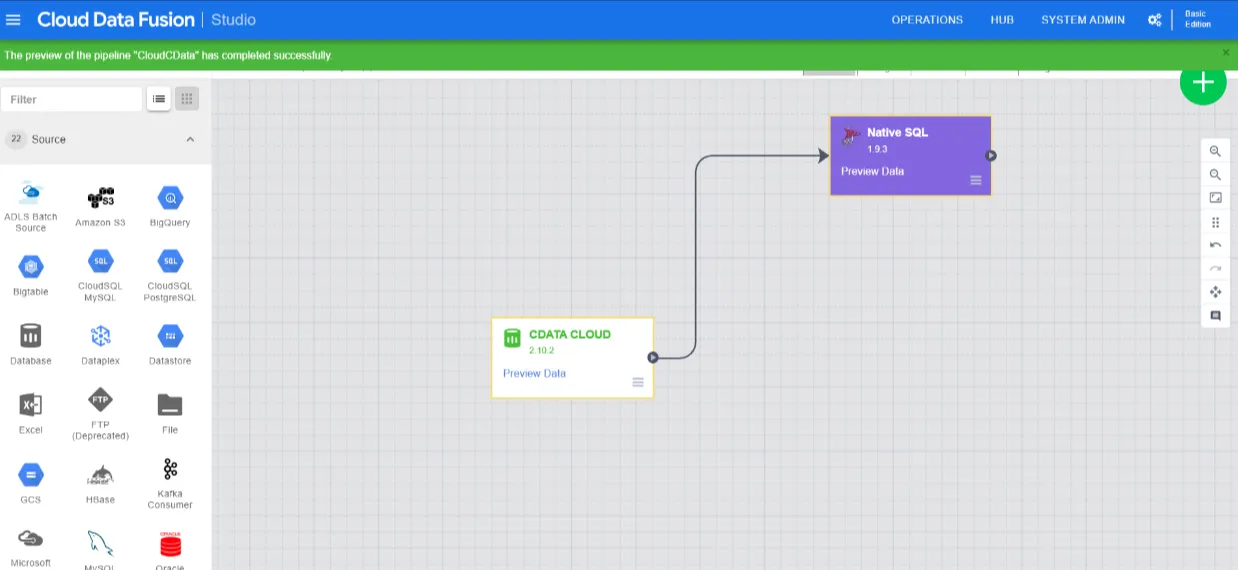
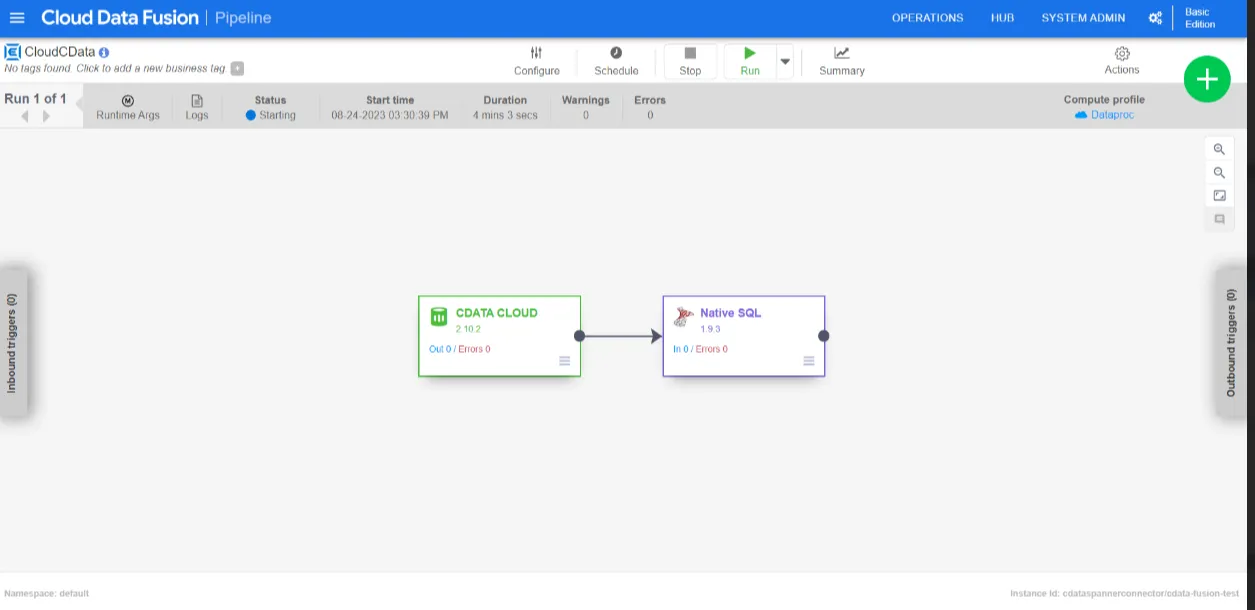
- 作成したパイプラインを実行。
トラブルシューティング
Cloud Data Fusion では、ソースデータの 「int」 型が自動的に 「long」 にキャストされる既知の問題があることにご注意ください。
クラウドアプリケーションから Bitbucket のデータ へのリアルタイムアクセス
これで、Google Cloud Data Fusion からリアルタイムのBitbucket のデータへの直接接続が確立されました。Bitbucket のデータ をレプリケーションすることなく、さまざまなソースと同期先間でデータをスムーズに移動できる接続を追加作成し、データ統合プロセスを効率化できます。
クラウドアプリケーションから Bitbucket を含む 数百種類の SaaS、ビッグデータ、NoSQL ソースへのリアルタイムデータアクセスについては、CData Connect AI をご覧ください。