

DataikuとConnect AIでHubDB のデータを統合
Dataiku は、チームがガバナンスされた環境内で機械学習や生成 AI プロジェクトを設計、デプロイ、管理できるコラボレーティブなデータサイエンス・AI プラットフォームです。エージェントと GenAI フレームワークにより、カスタムワークフローとモデルオーケストレーションを通じてデータを分析、生成、操作できるインテリジェントエージェントを構築できます。
Dataiku を CData Connect AI の組み込み MCP(Model Context Protocol)サーバーと統合することで、これらのエージェントはリアルタイムのHubDB のデータにセキュアにアクセスできるようになります。この統合により、Dataiku のエージェント実行環境と CData のガバナンスされたエンタープライズ接続レイヤーが橋渡しされ、すべてのクエリや指示が手動エクスポートやステージングなしで、承認されたデータソースに対して安全に実行されます。
この記事では、Connect AI での HubDB 接続の設定、MCP サポートを含む Dataiku の Python コード環境の準備、そして Dataiku 内から直接リアルタイムのHubDB のデータにクエリ・操作できるエージェントの作成方法を説明します。
ステップ 1:Dataiku 用の HubDB 接続を設定
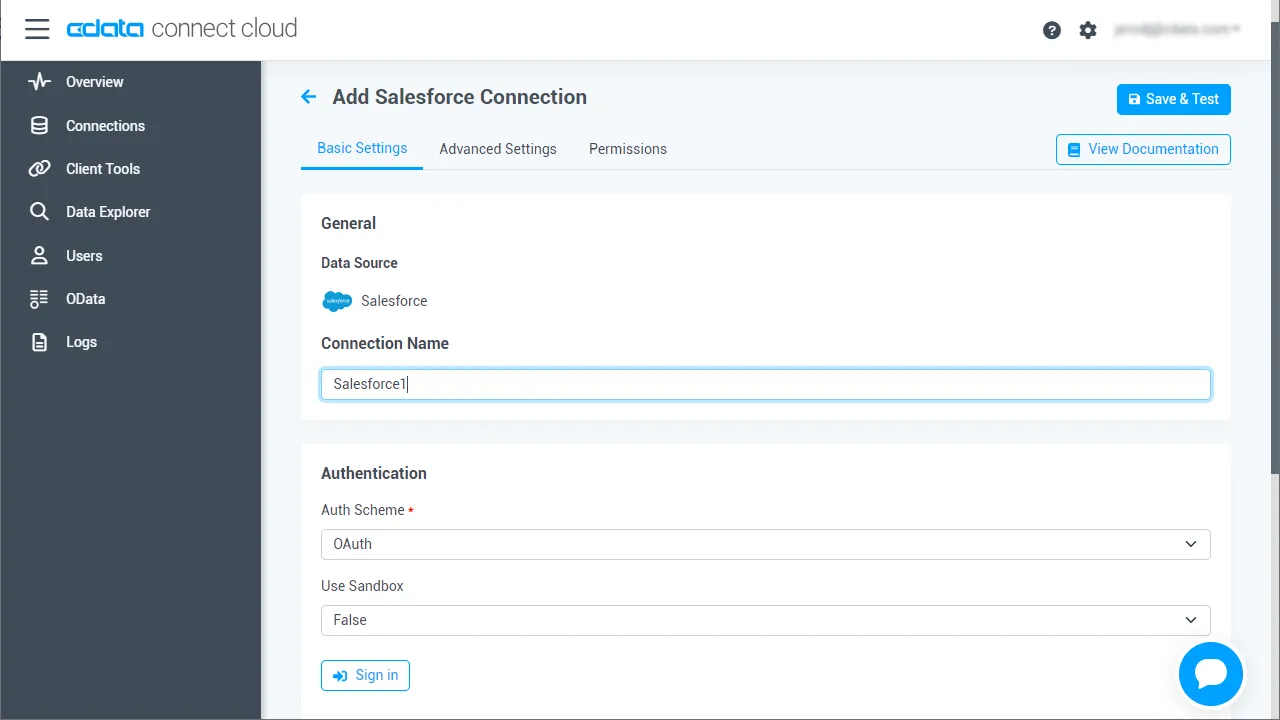
Dataiku から HubDB への接続は、CData Connect AI のリモート MCP サーバーによって実現されます。Dataiku からHubDB のデータを操作するには、まず CData Connect AI で HubDB 接続を作成・設定します。
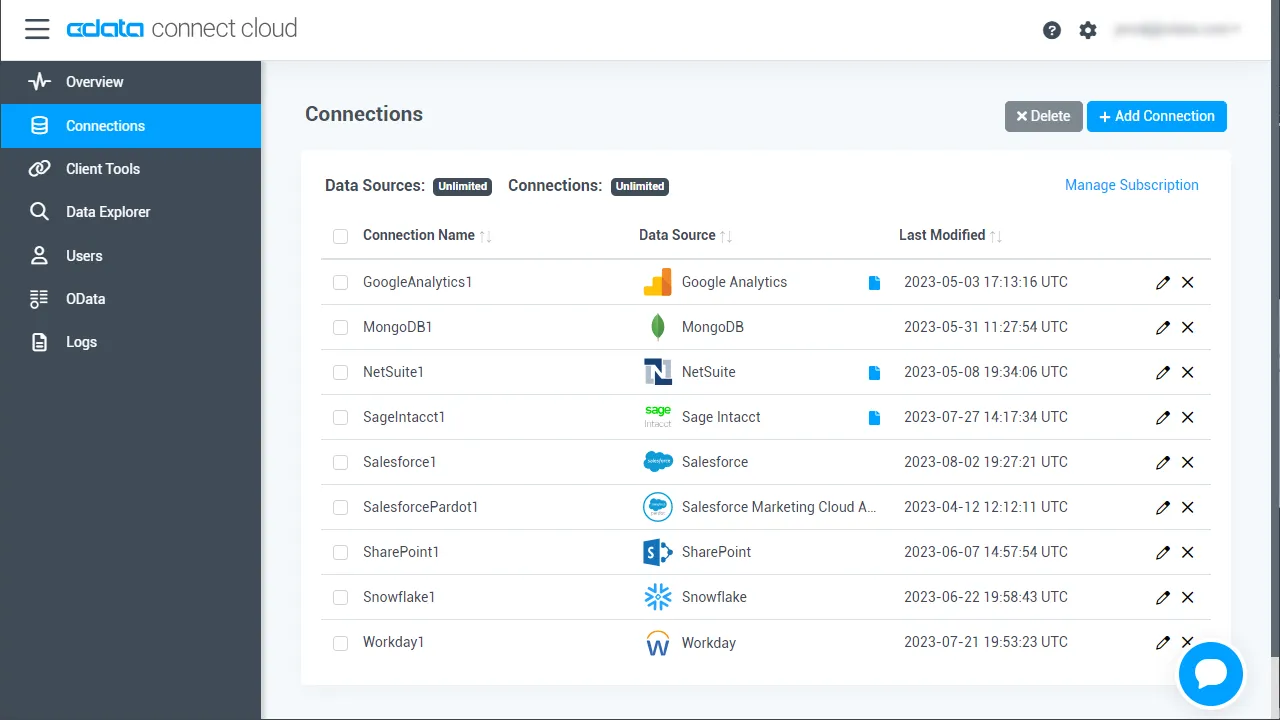
- Connect AI にログインし、Sources をクリック、次に Add Connection をクリック
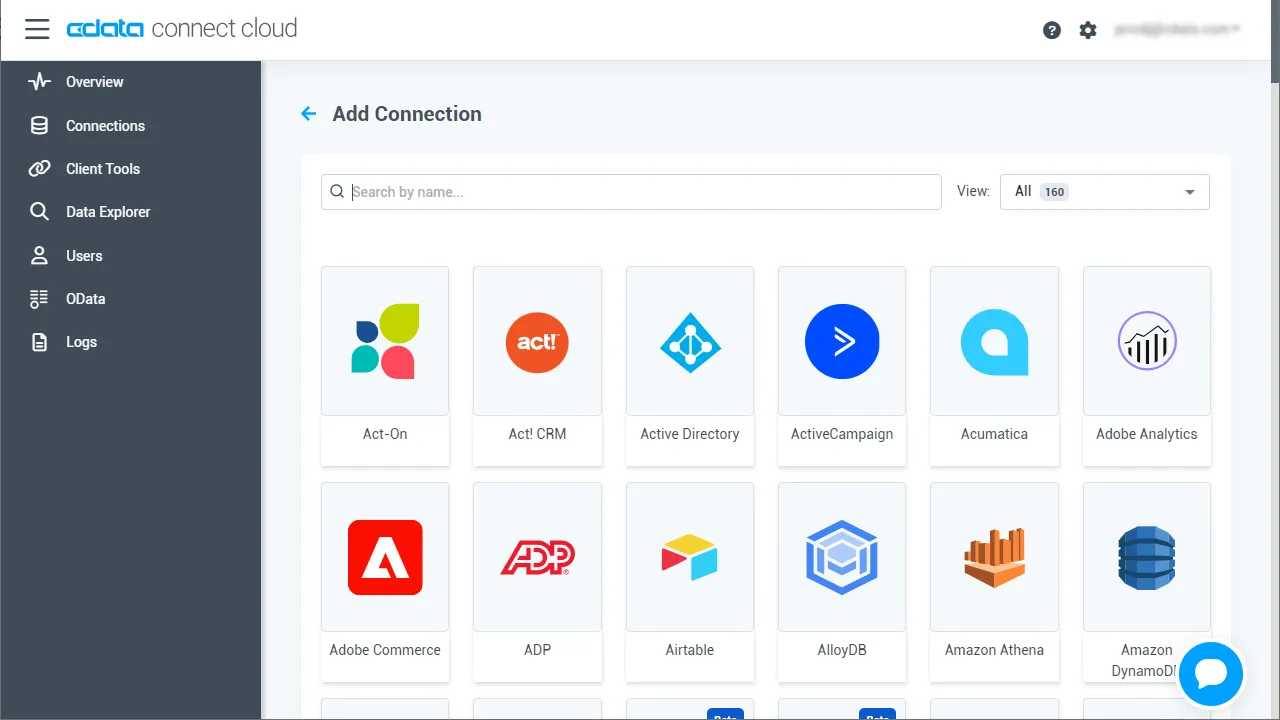
- Add Connection パネルから「HubDB」を選択
-
HubDB に接続するために必要な認証プロパティを入力します。
HubDBデータソースへの接続には、パブリックHubSpotアプリケーションを使用したOAuth認証とプライベートアプリケーショントークンを使用した認証の2つの方法があります。
カスタムOAuthアプリを使用する
すべてのOAuthフローでAuthSchemeを"OAuth"に設定する必要があります。特定の認証ニーズ(デスクトップアプリケーション、Webアプリケーション、ヘッドレスマシン)に必要な接続プロパティについては、ヘルプドキュメントを確認してください。
アプリケーションを登録し、OAuthクライアント認証情報を取得するには、以下の手順を実行してください。
- HubSpotアプリ開発者アカウントにログインします。
- アプリ開発者アカウントである必要があります。標準のHubSpotアカウントではパブリックアプリを作成できません。
- 開発者アカウントのホームページで、アプリタブをクリックします。
- アプリを作成をクリックします。
- アプリ情報タブで、ユーザーが接続する際に表示される値を入力し、必要に応じて変更します。これらの値には、パブリックアプリケーション名、アプリケーションロゴ、アプリケーションの説明が含まれます。
- 認証タブで、「リダイレクトURL」ボックスにコールバックURLを入力します。
- デスクトップアプリケーションを作成する場合は、http://localhost:33333のようなローカルにアクセス可能なURLに設定します。
- Webアプリケーションを作成する場合は、ユーザーがアプリケーションを承認した際にリダイレクトされる信頼できるURLに設定します。
- アプリを作成をクリックします。HubSpotがアプリケーションとそれに関連する認証情報を生成します。
- 認証タブで、クライアントIDとクライアントシークレットを確認します。これらは後でドライバーを設定する際に使用します。
スコープの下で、アプリケーションの意図する機能に必要なスコープを選択します。
テーブルにアクセスするには、最低限以下のスコープが必要です:
- hubdb
- oauth
- crm.objects.owners.read
- 変更を保存をクリックします。
- 統合に必要な機能にアクセスできる本番ポータルにアプリケーションをインストールします。
- 「インストールURL(OAuth)」の下で、完全なURLをコピーをクリックして、アプリケーションのインストールURLをコピーします。
- コピーしたリンクをブラウザで開きます。アプリケーションをインストールする標準アカウントを選択します。
- アプリを接続をクリックします。結果のタブは閉じて構いません。
プライベートアプリを使用する
HubSpotプライベートアプリケーショントークンを使用して接続するには、AuthSchemeプロパティを"PrivateApp"に設定します。
以下の手順に従ってプライベートアプリケーショントークンを生成できます:
- HubDBアカウントで、メインナビゲーションバーの設定アイコン(歯車)をクリックします。
- 左サイドバーメニューで、統合 > プライベートアプリに移動します。
- プライベートアプリを作成をクリックします。
- 基本情報タブで、アプリケーションの詳細(名前、ロゴ、説明)を設定します。
- スコープタブで、プライベートアプリケーションがアクセスできるようにしたい各スコープに対して読み取りまたは書き込みを選択します。
- テーブルにアクセスするには、最低限hubdbとcrm.objects.owners.readが必要です。
- アプリケーションの設定が完了したら、右上のアプリを作成をクリックします。
- アプリケーションのアクセストークンに関する情報を確認し、作成を続行をクリックし、その後トークンを表示をクリックします。
- コピーをクリックして、プライベートアプリケーショントークンをコピーします。
接続するには、PrivateAppTokenを取得したプライベートアプリケーショントークンに設定します。
- HubSpotアプリ開発者アカウントにログインします。
- Save & Test をクリック
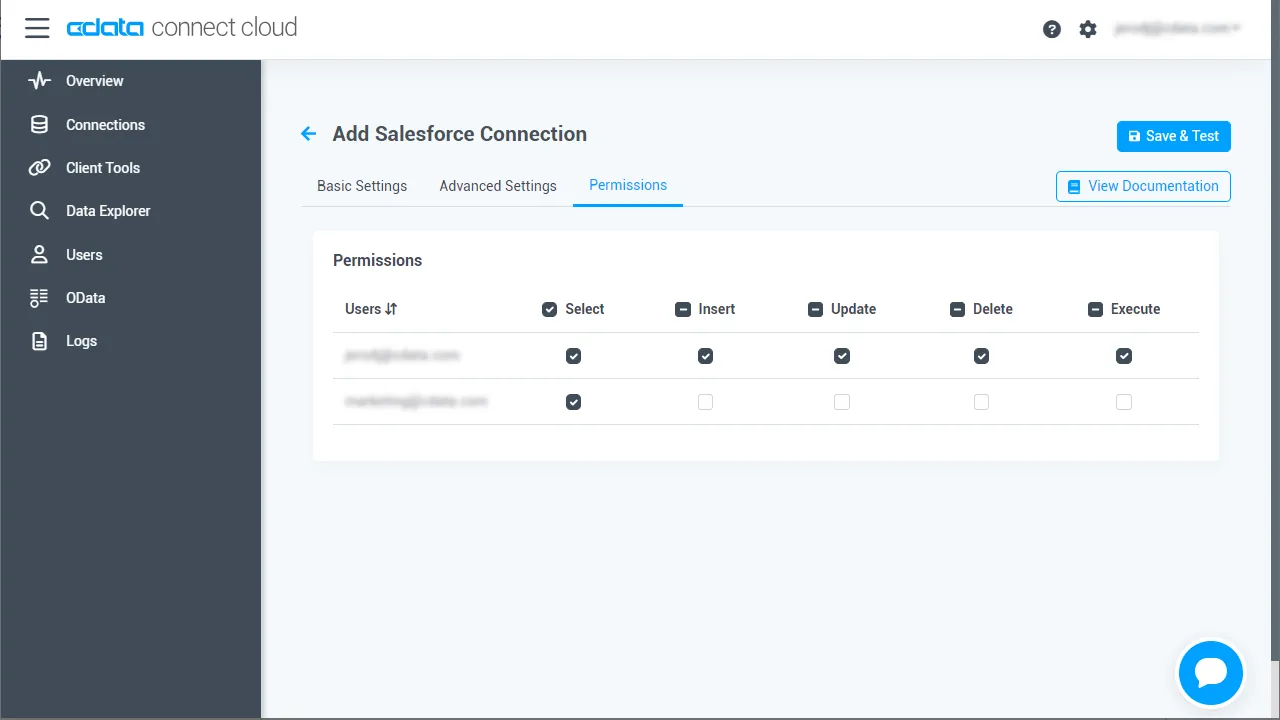
- Permissions タブを開き、ユーザーベースの権限を設定
Personal Access Token を追加
Personal Access Token(PAT)は、Dataiku から Connect AI への接続を認証するために使用されます。きめ細かいアクセス制御を維持するため、統合ごとに個別の PAT を作成することをお勧めします
- Connect AI アプリの右上にある歯車アイコン()をクリックして Settings を開く
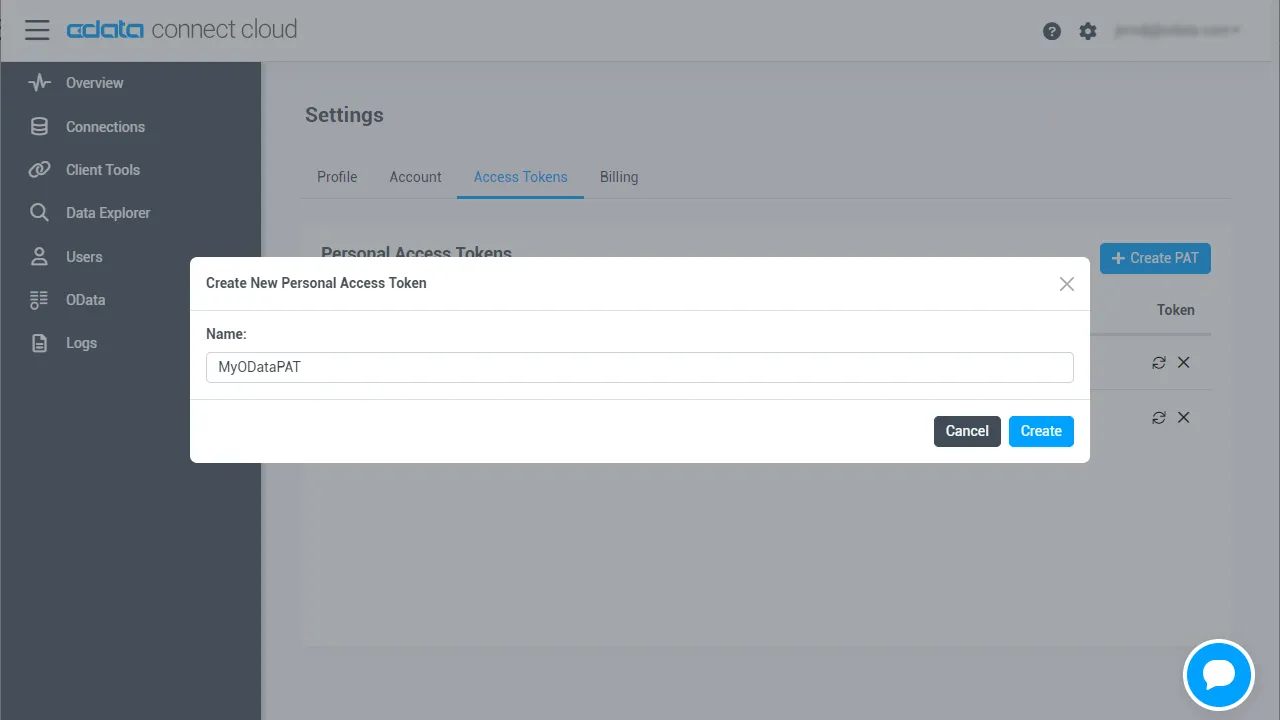
- Settings ページで Access Tokens セクションに移動し、 Create PAT をクリック
- PAT にわかりやすい名前を付けて Create をクリック
- トークンが表示されたらコピーして安全な場所に保存してください。再度表示されることはありません
HubDB 接続の設定と PAT の生成が完了したら、Dataiku から Connect AI 経由でHubDB のデータに接続できます。
ステップ 2:Dataiku とコード環境を準備
Dataiku の専用 Python コード環境が、MCP ベースの通信に必要なランタイムサポートを提供します。Dataiku エージェントを CData Connect AI に接続できるようにするには、Python 環境を作成し、エージェントとサーバー間の対話に必要な MCP クライアント依存関係をインストールします。
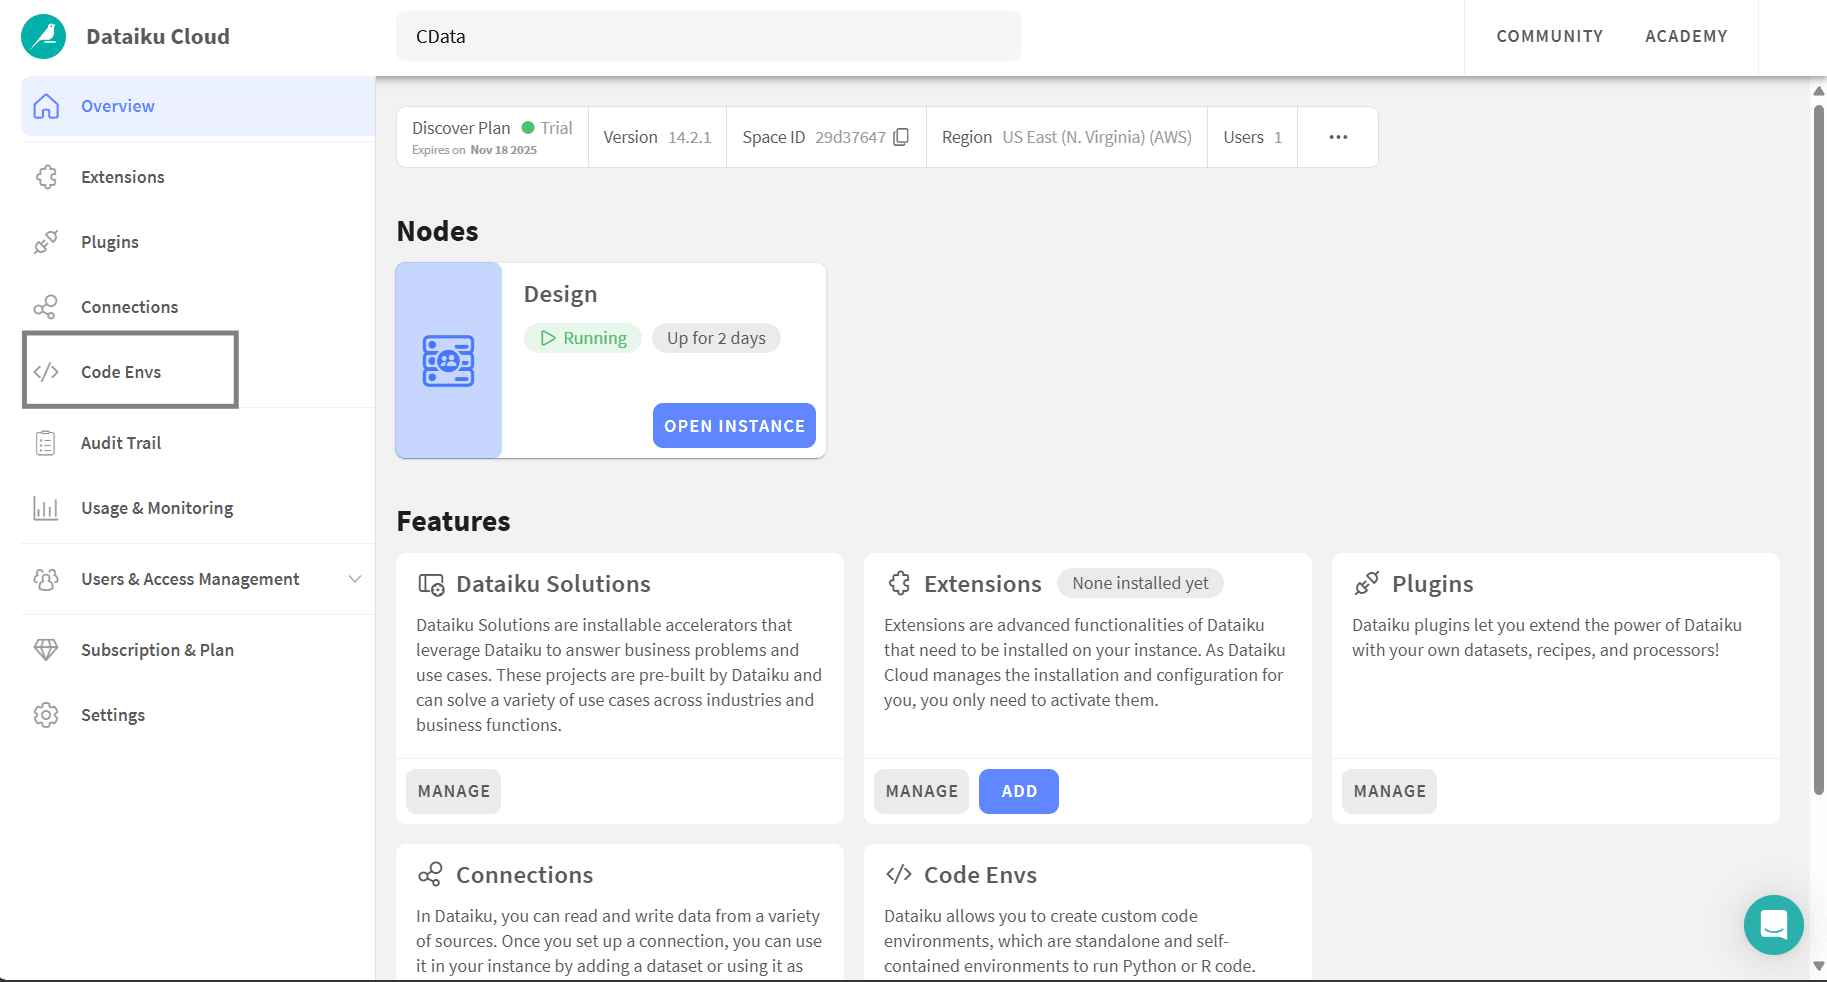
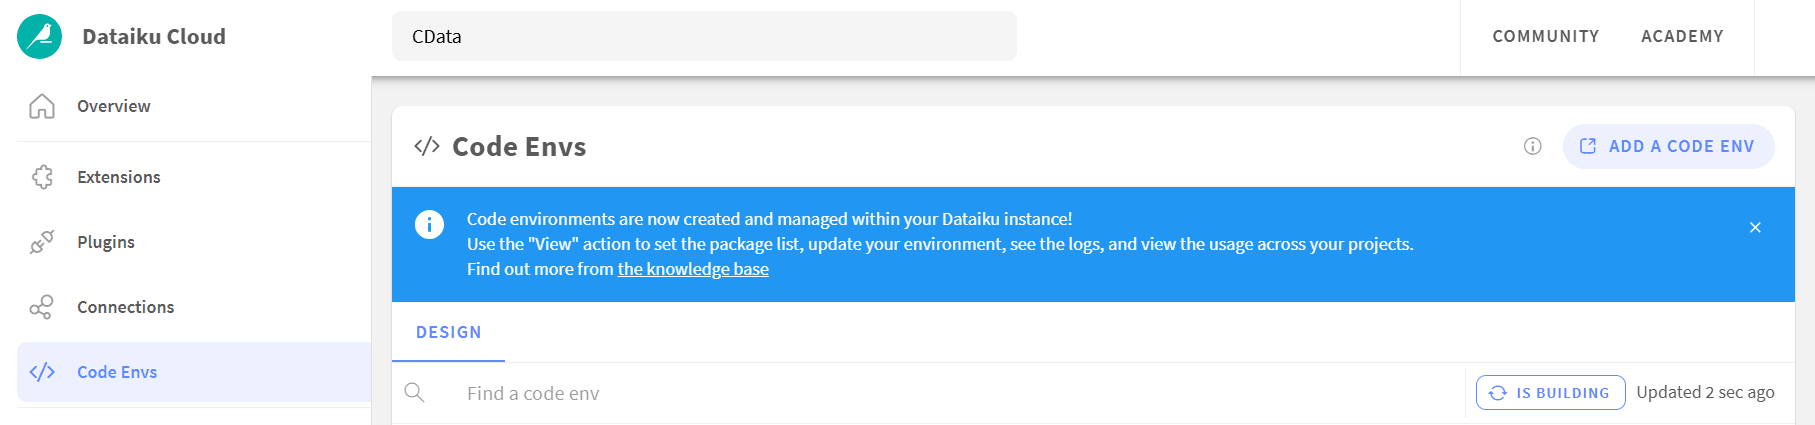
- Dataiku Cloud で Code Envs を開く
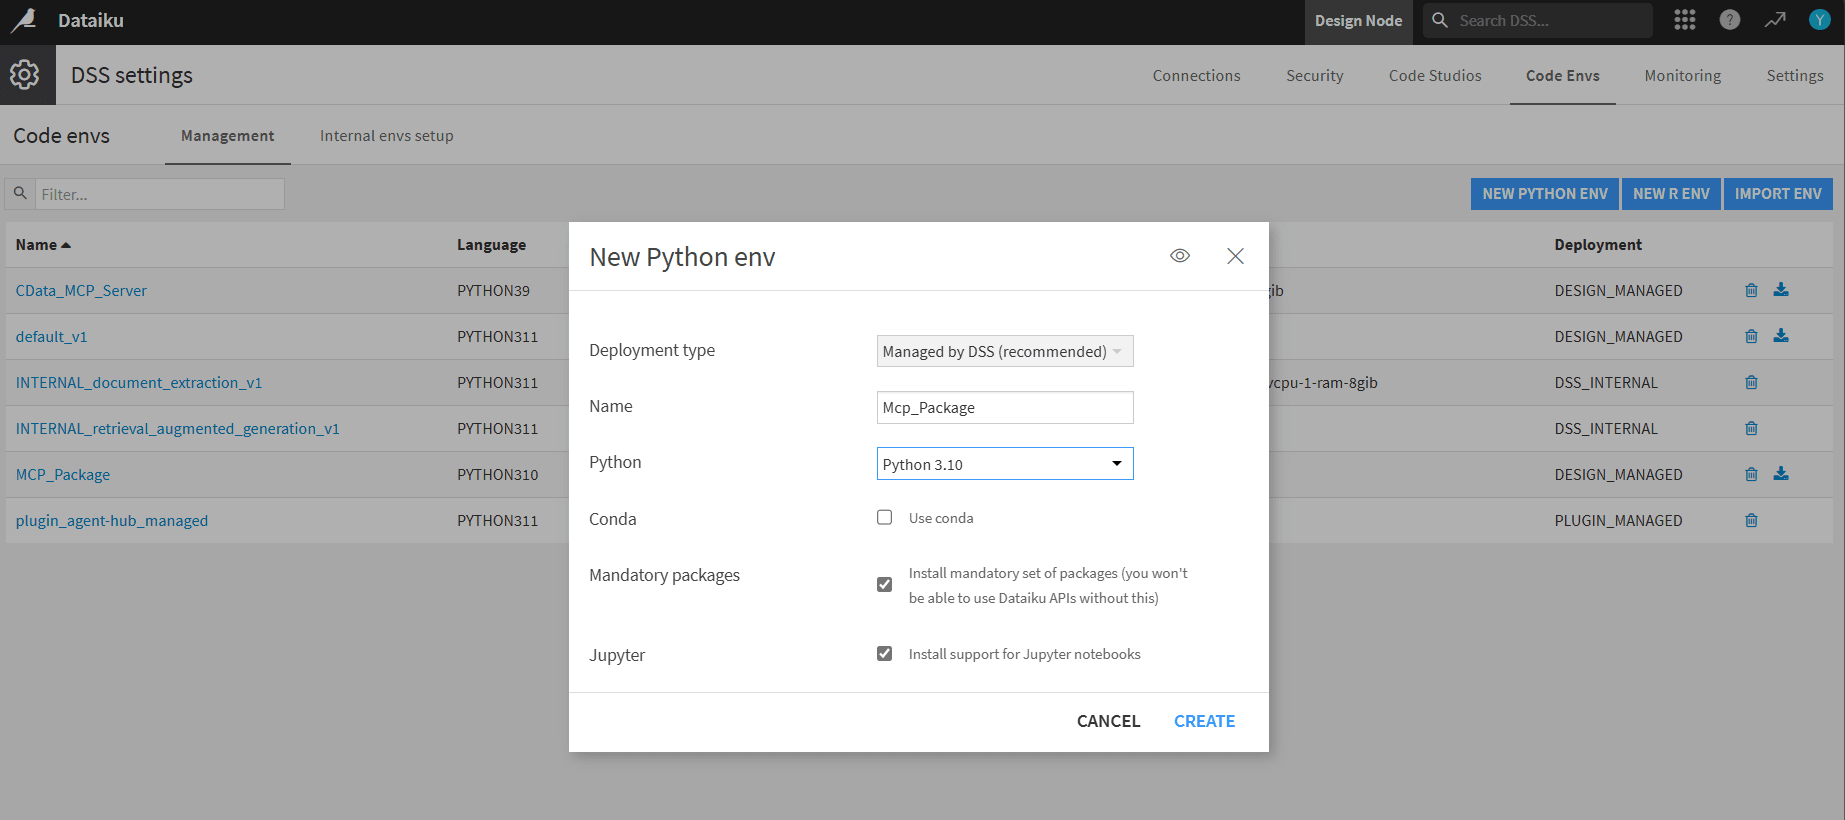
- Add a code env をクリックして DSS 設定ウィンドウを開く
- DSS で New Python env をクリック。名前を付け(例:MCP_Package)、Python 3.10 を選択(3.10 から 3.13 がサポートされています)
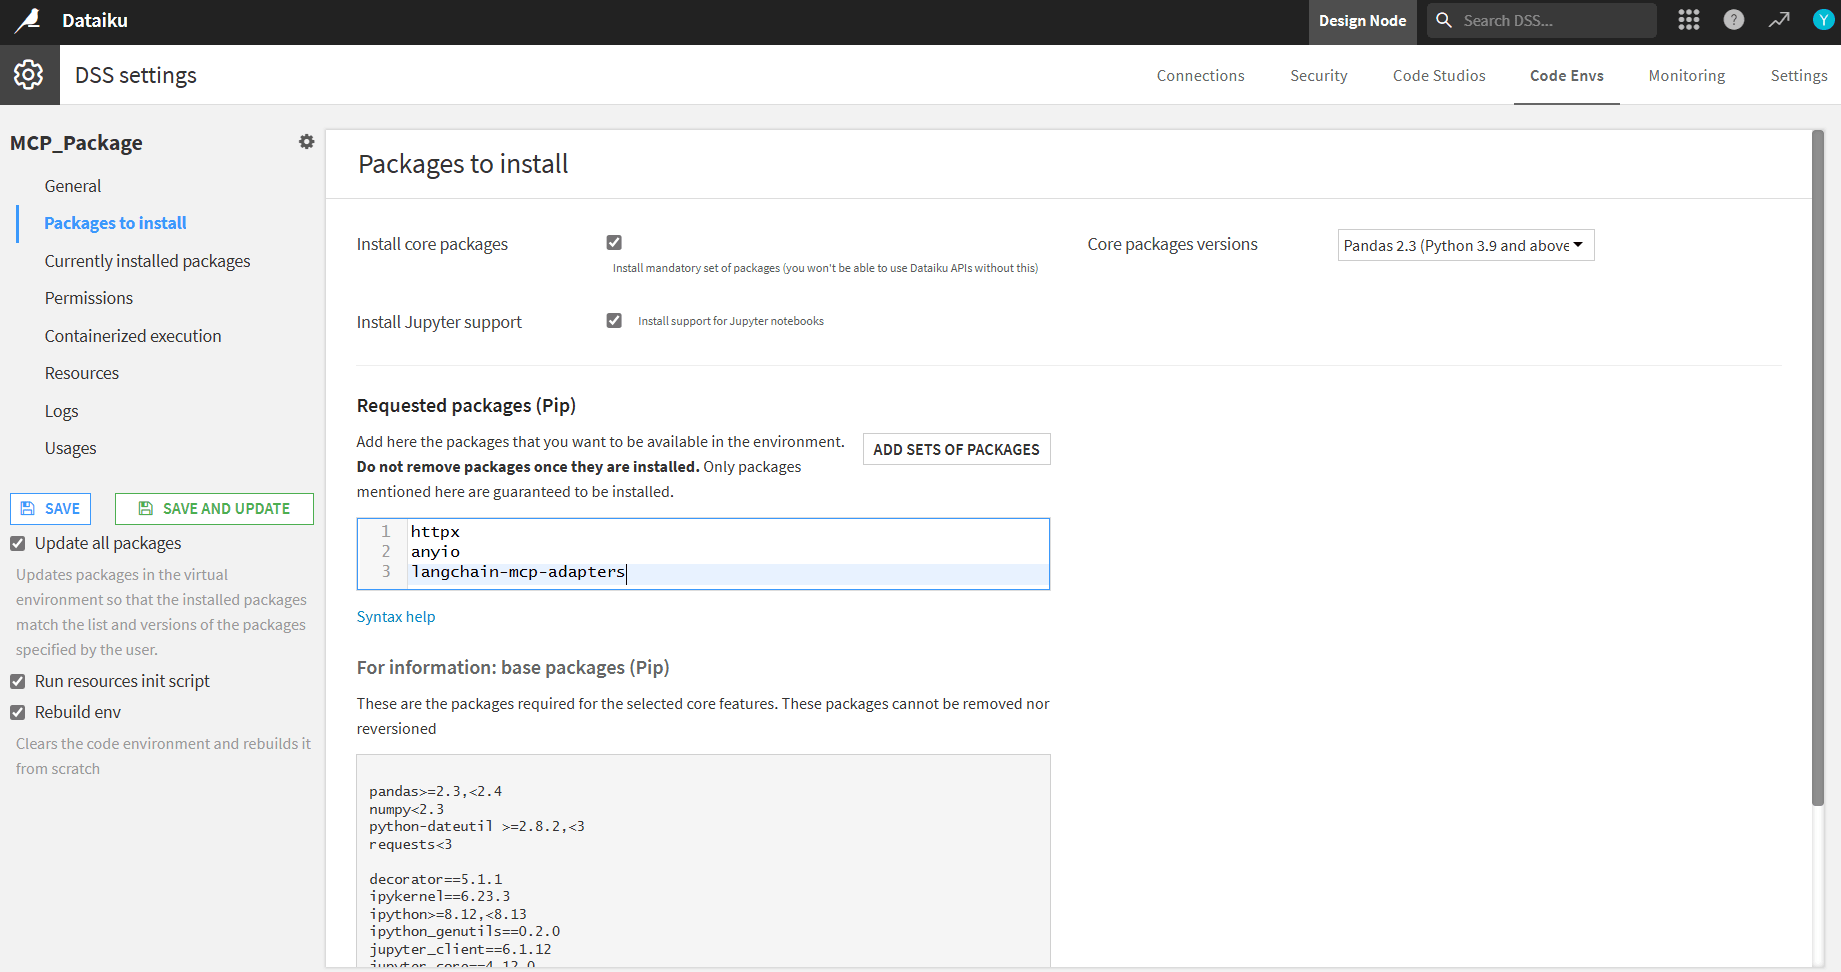
- Packages to install を開き、以下の pip パッケージを追加:
- httpx
- anyio
- langchain-mcp-adapters
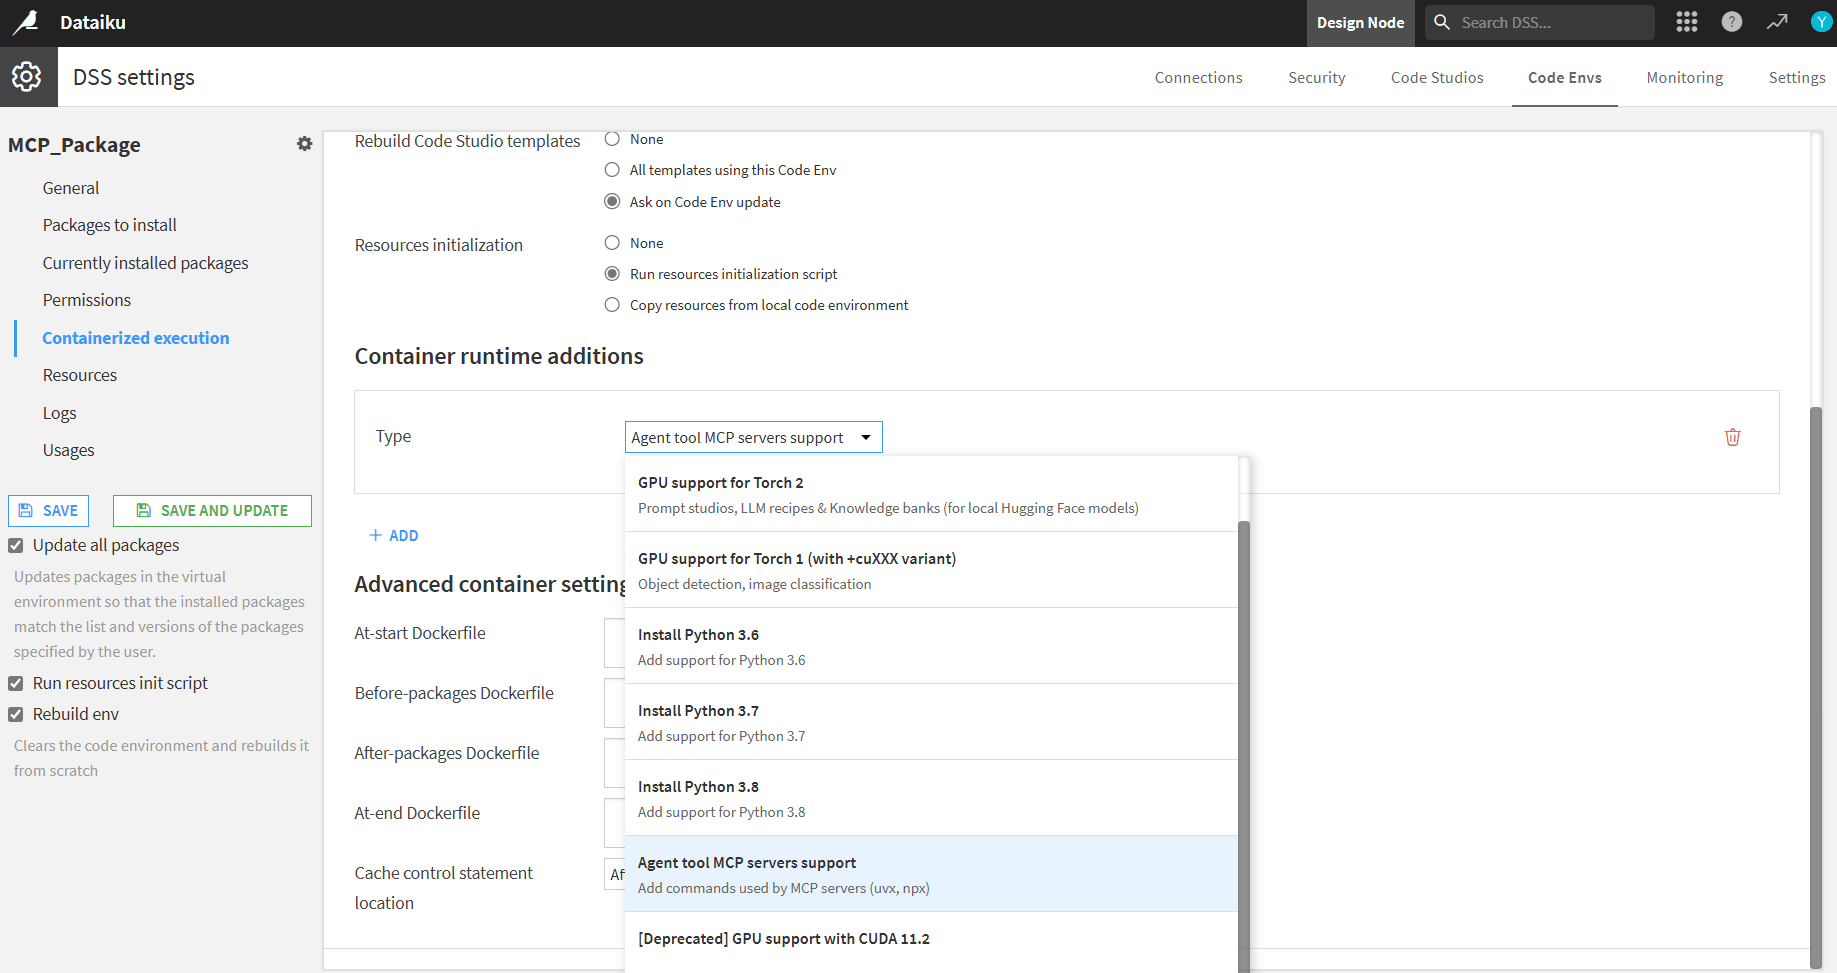
- Containerized execution を開き、Container runtime additions の下で Agent tool MCP servers support を選択
- Rebuild env をチェックし、Save and update をクリックしてパッケージをインストール
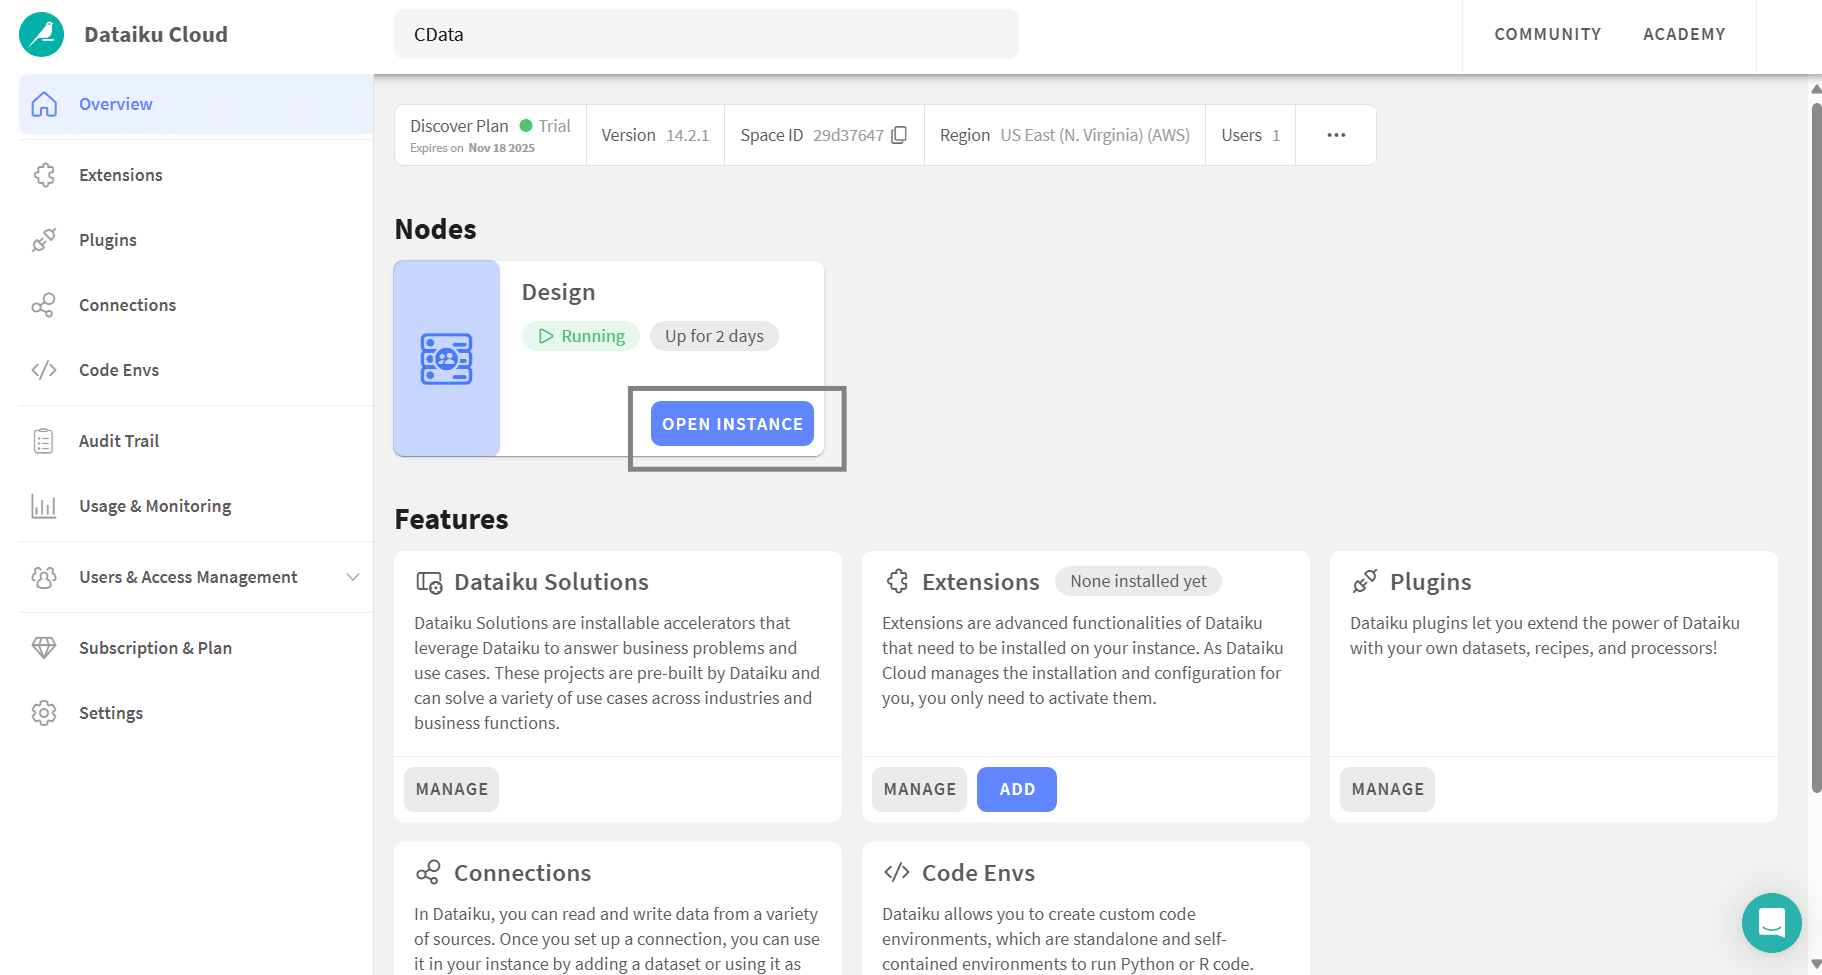
- Dataiku Cloud に戻り、Overview を開いて Open instance をクリック
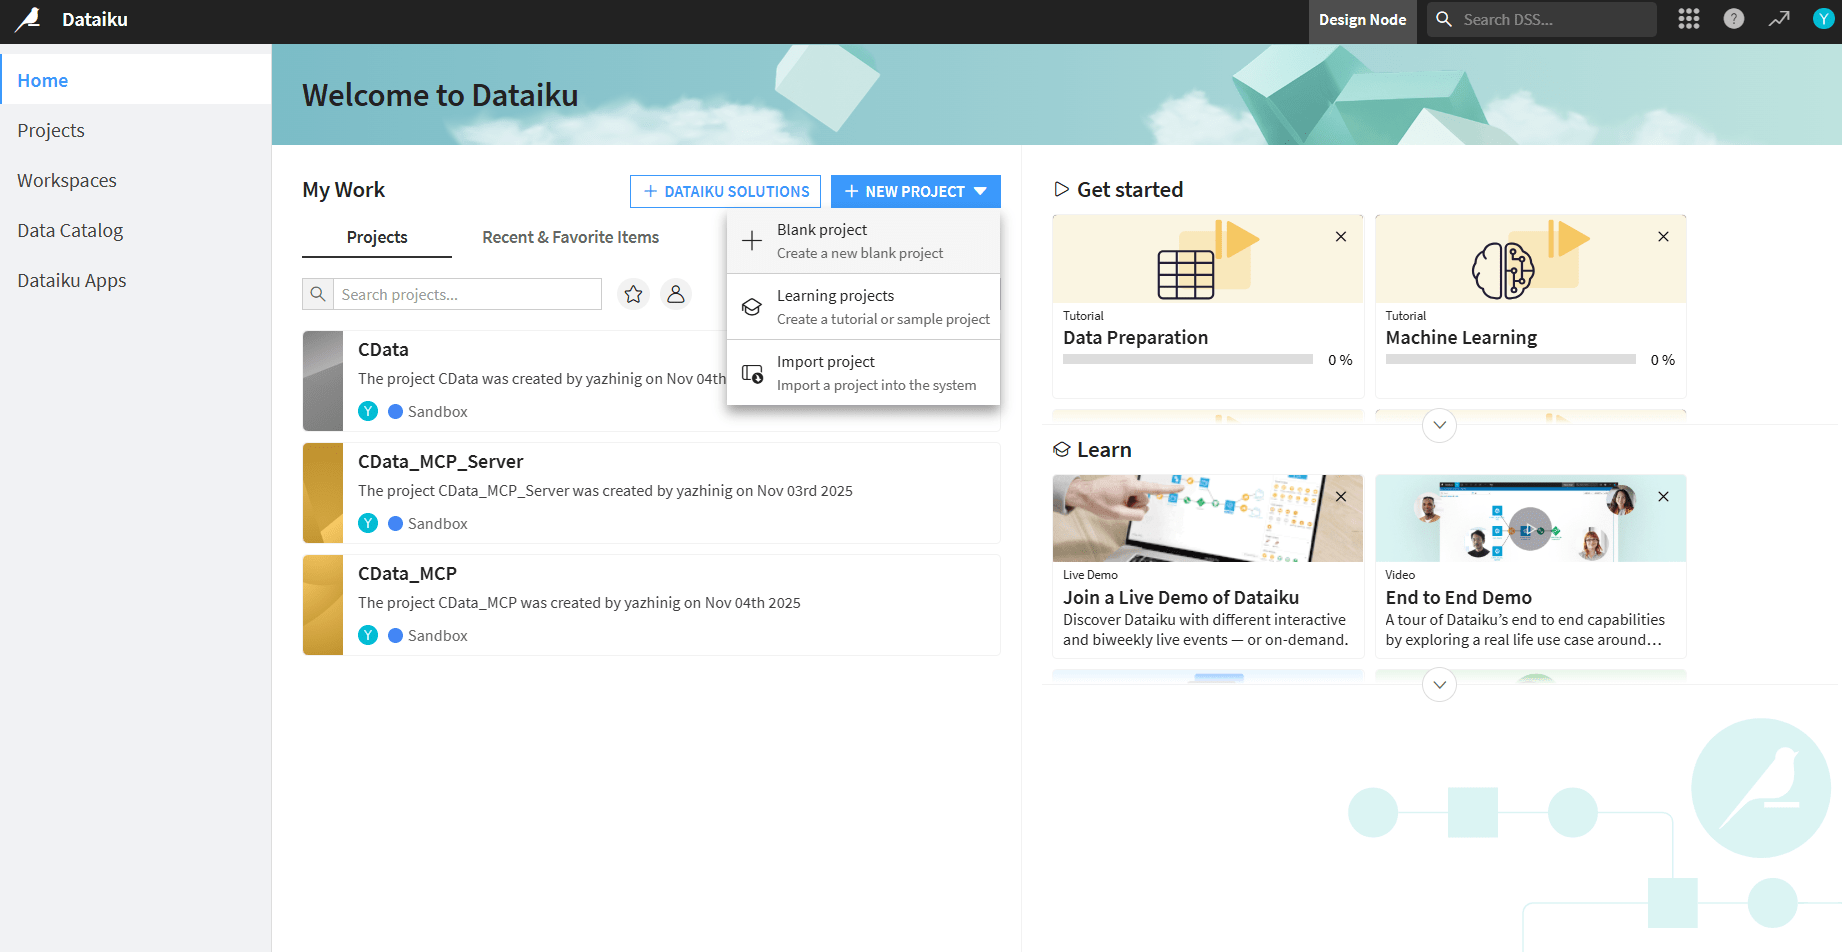
- + New project をクリックして Blank project を選択。プロジェクト名を入力
ステップ 3:Dataiku エージェントを作成して MCP サーバーに接続
Dataiku エージェントは、Dataiku ワークスペースと Connect AI 間のブリッジとして機能します。この接続を有効にするには、カスタムコードベースエージェントを作成し、設定した Python 環境を割り当て、Connect AI の認証情報を埋め込んで、エージェントがリアルタイムのHubDB のデータにクエリ・操作できるようにします。
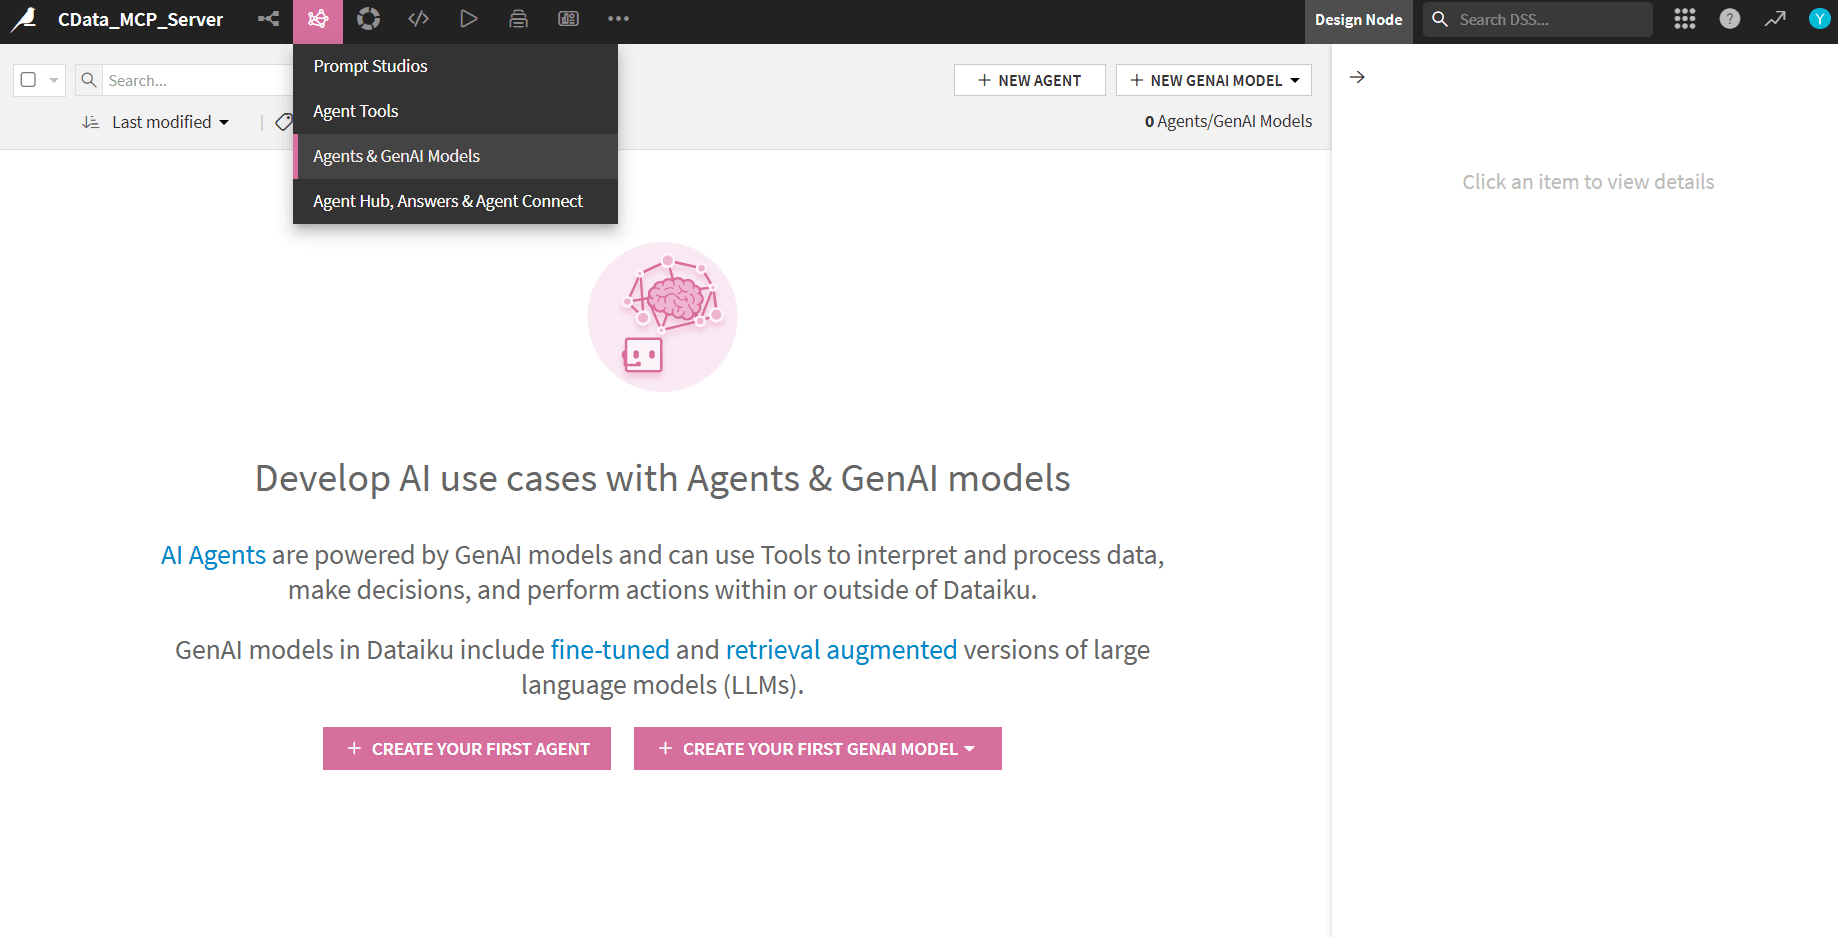
- Agents & GenAI Models に移動し、Create your first agent をクリック
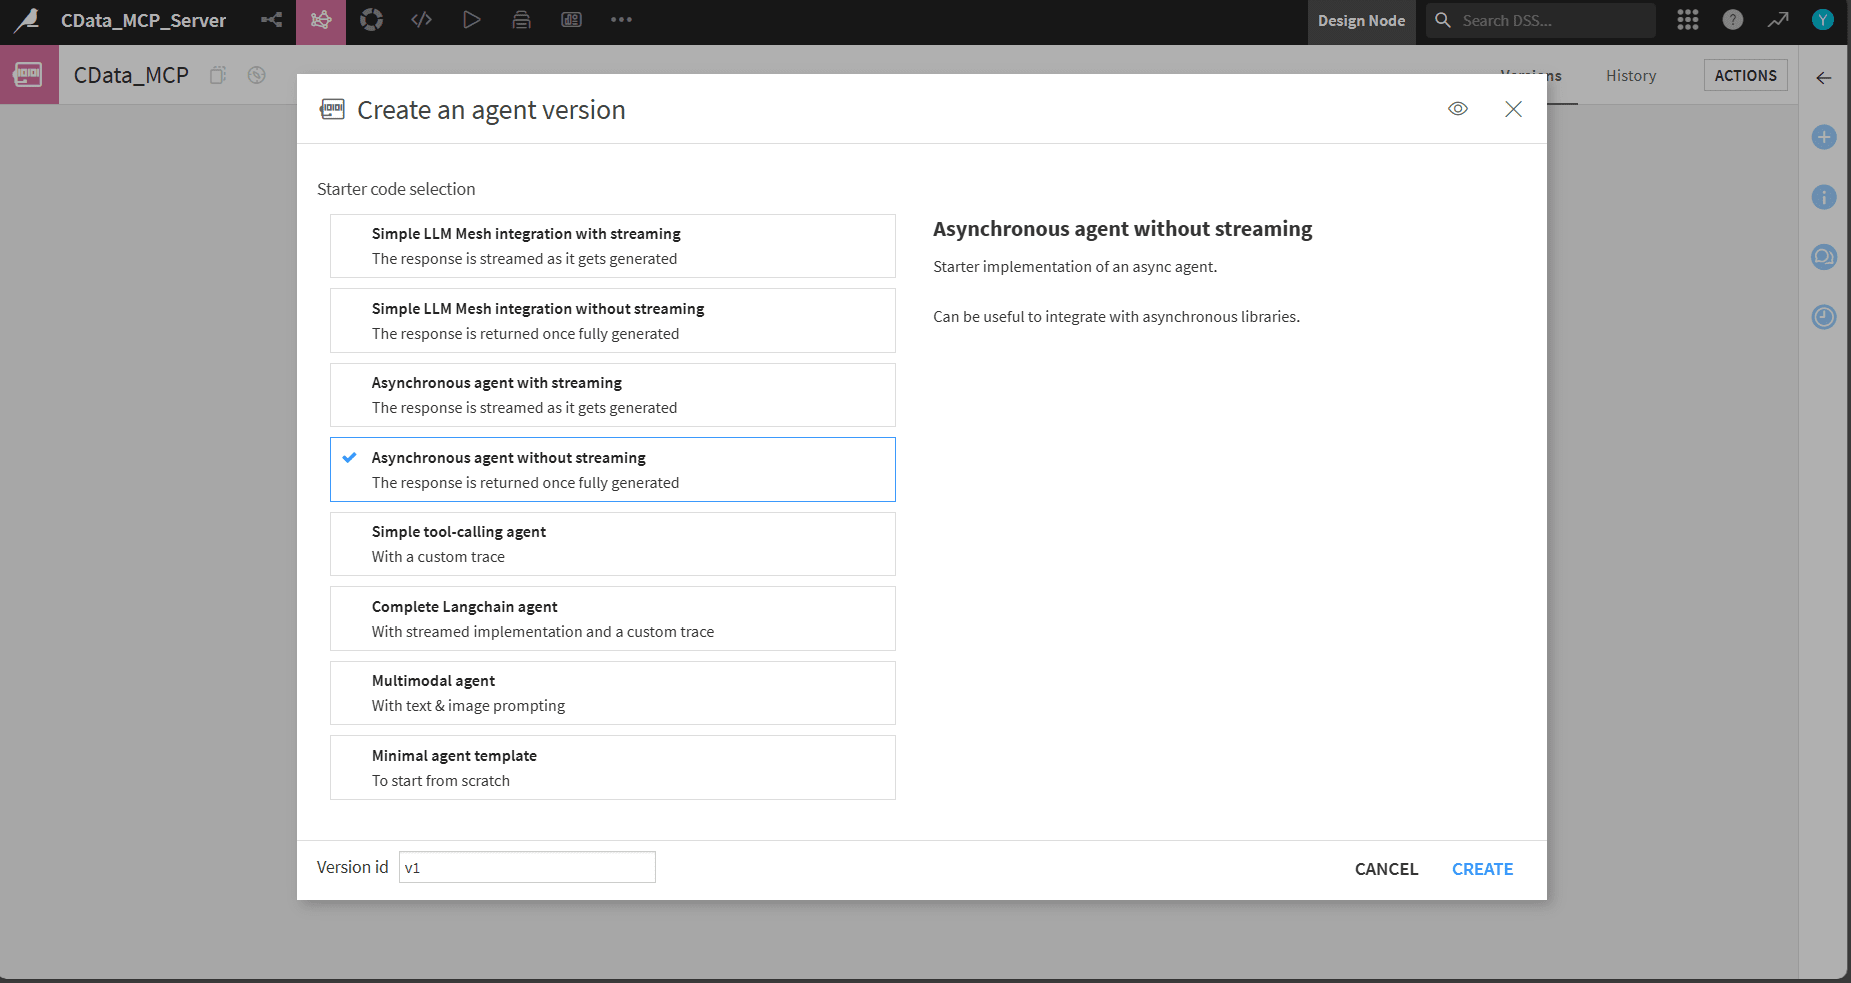
- Code agent を選択し、名前を付け、Agent version で Asynchronous agent without streaming を選択
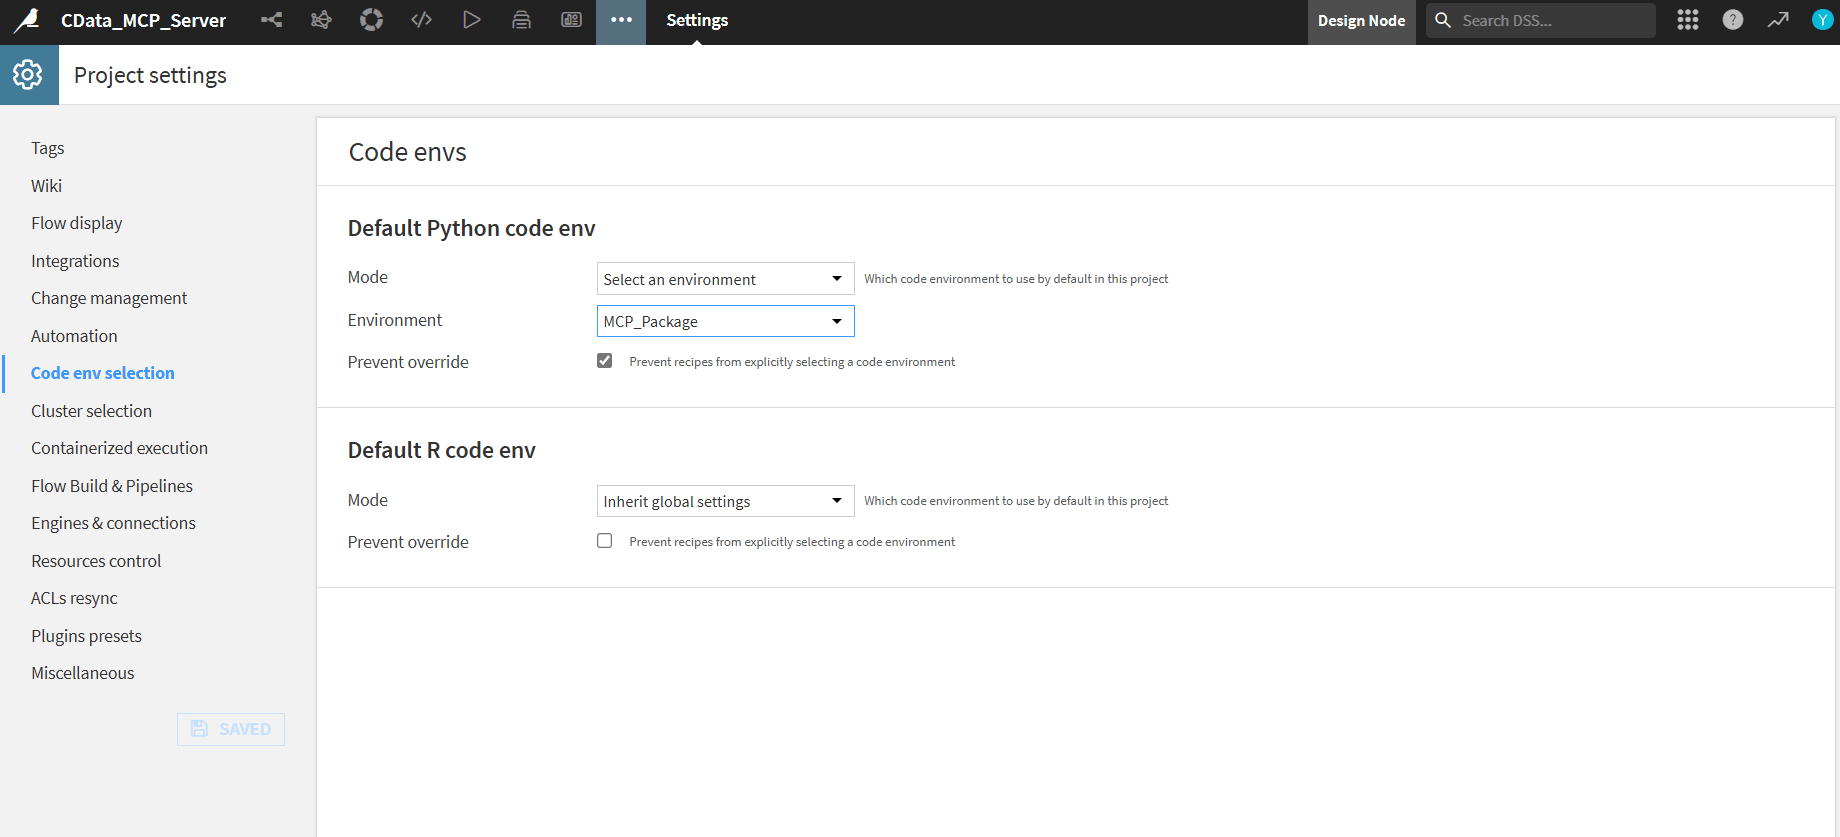
- 上部のタブから Settings を選択。Code env selection で Default Python code env を作成した環境(例:MCP_Package)に設定
- Agent の Design タブに戻り、以下のコードを貼り付けます。EMAIL と PAT を自分の値に置き換えてください
- 右側のパネルで Quick Test を開く
- JSON コードを貼り付けて Run test をクリック
import os
import base64
from typing import Dict, Any, List

from dataiku.llm.python import BaseLLM
from langchain_mcp_adapters.client import MultiServerMCPClient

# ---------- Persistent MCP client (cached between calls) ----------
_MCP_CLIENT = None

def _get_mcp_client() -> MultiServerMCPClient:
    """Create (or reuse) a MultiServerMCPClient to CData Cloud MCP."""
    global _MCP_CLIENT
    if _MCP_CLIENT is not None:
        return _MCP_CLIENT

    # Set creds via env/project variables ideally
    EMAIL = os.getenv("CDATA_EMAIL", "YOUR_EMAIL")
    PAT   = os.getenv("CDATA_PAT",   "YOUR_PAT")
    BASE_URL = "https://mcp.cloud.cdata.com/mcp"

    if not EMAIL or PAT == "YOUR_PAT":
        raise ValueError("Set CDATA_EMAIL and CDATA_PAT as env variables or inline in the code.")

    token = base64.b64encode(f"{EMAIL}:{PAT}".encode()).decode()
    headers = {"Authorization": f"Basic {token}"}

    _MCP_CLIENT = MultiServerMCPClient(
        connections={
            "cdata": {
                "transport": "streamable_http",
                "url": BASE_URL,
                "headers": headers,
            }
        }
    )
    return _MCP_CLIENT


def _pick_tool(tools, names: List[str]):
    L = [n.lower() for n in names]
    return next((t for t in tools if t.name.lower() in L), None)


async def _route(prompt: str) -> str:
    """
    Simple intent router:
      - 'list connections' / 'list catalogs' -> getCatalogs
      - 'sql: ...' or 'query: ...' -> queryData
      - otherwise -> help text
    """
    client = _get_mcp_client()
    tools = await client.get_tools()

    p = prompt.strip()
    low = p.lower()

    # 1) List connections (catalogs)
    if "list connections" in low or "list catalogs" in low:
        t = _pick_tool(tools, ["getCatalogs", "listCatalogs"])
        if not t:
            return "No 'getCatalogs' tool found on the MCP server."
        res = await t.ainvoke({})
        return str(res)[:4000]

    # 2) Run SQL
    if low.startswith("sql:") or low.startswith("query:"):
        sql = p.split(":", 1)[1].strip()
        t = _pick_tool(tools, ["queryData", "sqlQuery", "runQuery", "query"])
        if not t:
            return "No query-capable tool (queryData/sqlQuery) found on the MCP server."
        try:
            res = await t.ainvoke({"query": sql})
            return str(res)[:4000]
        except Exception as e:
            return f"Query failed: {e}"

    # 3) Help
    return (
        "Connected to CData MCP

"
        "Say **'list connections'** to view available sources, or run a SQL like:
"
        "  sql: SELECT * FROM [Salesforce1].[SYS].[Connections] LIMIT 5

"
        "Remember to use bracket quoting for catalog/schema/table names."
    )


class MyLLM(BaseLLM):
    async def aprocess(self, query: Dict[str, Any], settings: Dict[str, Any], trace: Any):
        # Extract last user message from the Quick Test payload
        prompt = ""
        try:
            prompt = (query.get("messages") or [])[-1].get("content", "")
        except Exception:
            prompt = ""

        try:
            reply = await _route(prompt)
        except Exception as e:
            reply = f"Error: {e}"

        # The template expects a dict with a 'text' key
        return {"text": reply}
クイックテストを実行
{
   "messages": [
      {
         "role": "user",
         "content": "list connections"
      }
   ],
   "context": {}
}
エージェントとチャット
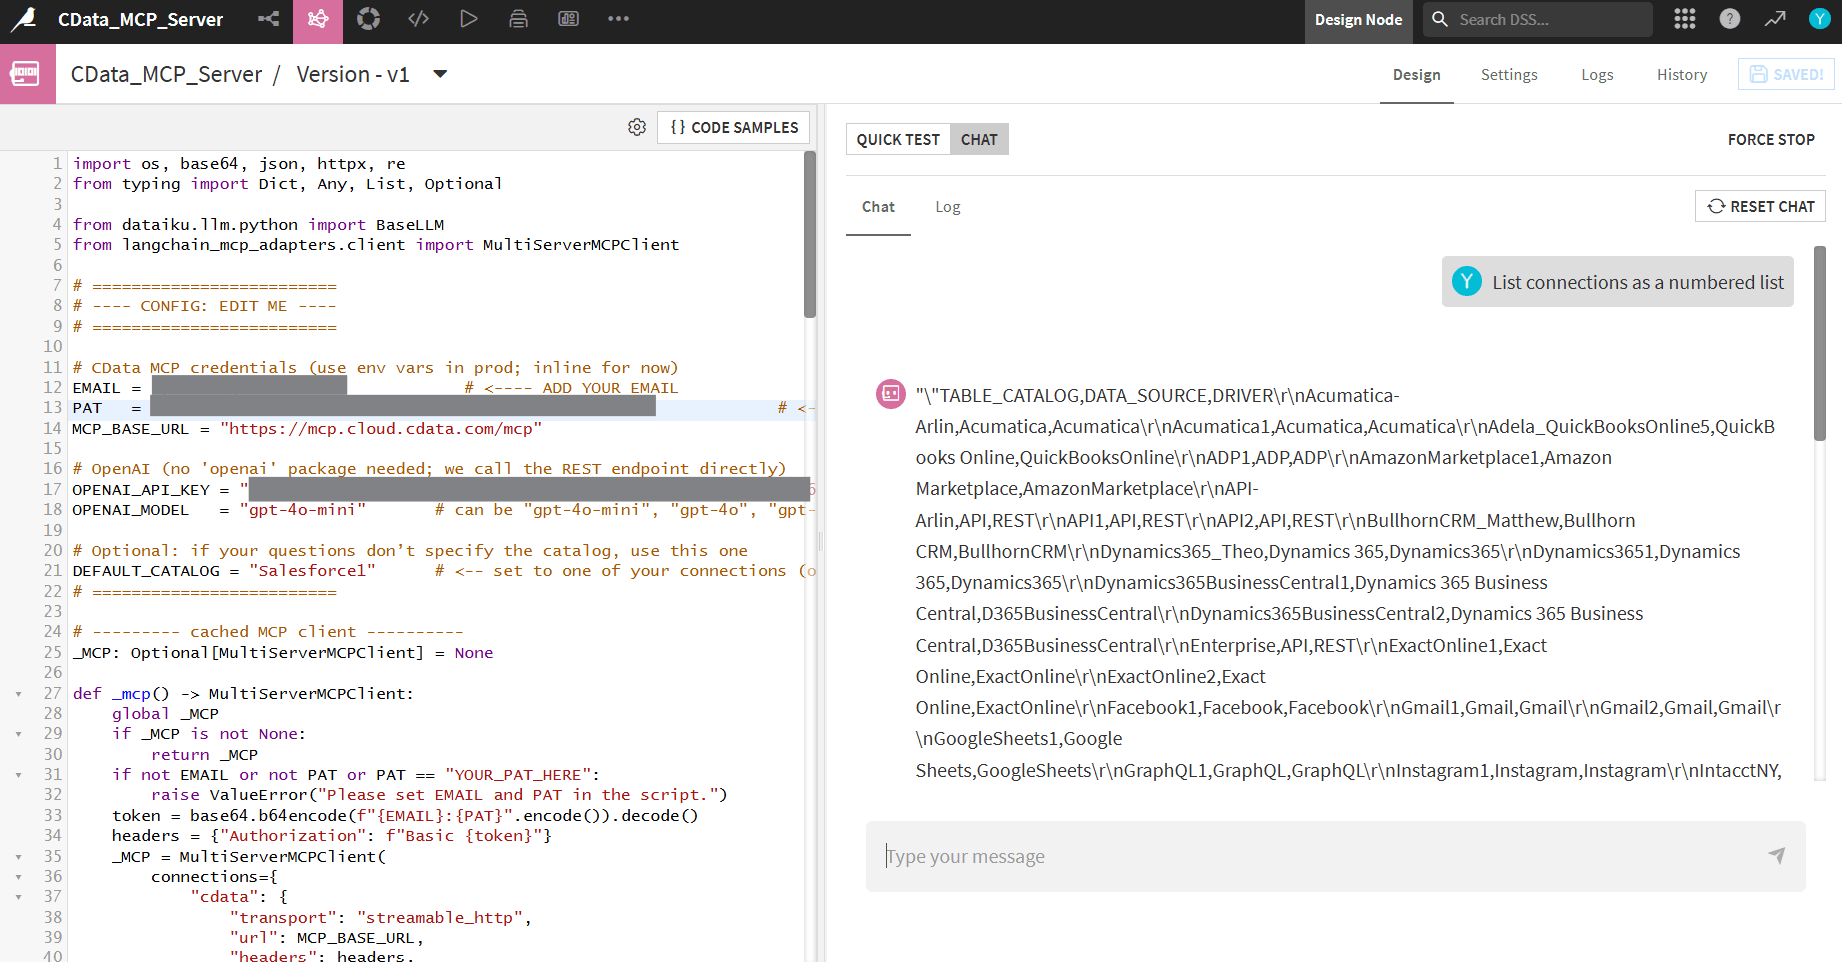
Chat タブに切り替えて、「List all connections」 のようなプロンプトを試してみてください。チャット出力に接続カタログの一覧が表示されます。
CData Connect AI を入手
AI エージェントから 数百種類の SaaS、ビッグデータ、NoSQL ソースにアクセスするには、CData Connect AI をお試しください。