



CData SSIS Components を使用して JD Edwards のデータを Google BigQuery にマイグレーション
Google BigQuery は、サーバーレスで高いスケーラビリティとコスト効率を備えたデータウェアハウスであり、組織がビッグデータを実用的なインサイトに変換できるよう設計されています。
CData SSIS Components は、SQL Server Integration Services を拡張し、さまざまなソースやデスティネーションからデータを簡単にインポート・エクスポートできるようにします。
この記事では、BigQuery へのエクスポート時のデータ型マッピングの考慮事項を確認し、CData SSIS Components for JD Edwards と BigQuery を使用してJD Edwards のデータを Google BigQuery にマイグレーションする方法を説明します。
データ型マッピング
| Google BigQuery スキーマ | CData スキーマ |
|---|---|
|
STRING, GEOGRAPHY, JSON, INTERVAL |
string |
|
BYTES |
binary |
|
INTEGER |
long |
|
FLOAT |
double |
|
NUMERIC, BIGNUMERIC |
decimal |
|
BOOLEAN |
bool |
|
DATE |
date |
|
TIME |
time |
|
DATETIME, TIMESTAMP |
datetime |
|
STRUCT |
下記参照 |
|
ARRAY |
下記参照 |
STRUCT 型と ARRAY 型
Google BigQuery は、1 つの行に複合値を格納するための STRUCT と ARRAY という 2 種類の型をサポートしています。Google BigQuery の一部では、これらは RECORD 型および REPEATED 型としても知られています。
STRUCT は、名前でアクセスでき、異なる型を持つことができる固定サイズの値のグループです。コンポーネントは struct をフラット化し、ドット表記の名前でフィールドにアクセスできるようにします。これらのドット表記の名前は引用符で囲む必要があることに注意してください。
ARRAY は、同じ型の値で任意のサイズを持つことができるグループです。コンポーネントは配列を単一の複合値として扱い、JSON 集約として報告します。これらの型は組み合わせることができ、STRUCT 型が ARRAY フィールドを含んだり、ARRAY フィールドが STRUCT 値のリストになったりする場合があります。
特別な考慮事項
- Google BigQuery には、DATETIME(タイムゾーンなし)と TIMESTAMP(タイムゾーンあり)の両方のデータ型があり、CData SSIS Components はローカルマシンのタイムゾーンに基づいて datetime にマッピングします。
- Google BigQuery では、NUMERIC 型は 38 桁の精度と小数点以下最大 9 桁をサポートし、BIGNUMERIC 型は 76 桁の精度と小数点以下最大 38 桁をサポートします。CData SSIS Components for Google BigQuery は精度/スケールを自動検出しますが、Destination コンポーネントでは高精度カラムを手動でマッピングできます。
-
INTERVAL データ型:
-
コンポーネントは INTERVAL 型を文字列として表現します。クエリで INTERVAL 型が必要な場合は、BigQuery SQL の INTERVAL フォーマットを使用して INTERVAL を指定する必要があります:
YEAR-MONTH DAY HOUR:MINUTE:SECOND.FRACTION -
例えば、「5 年と 11 ヶ月、マイナス 10 日と 3 時間と 2.5 秒」という値は正しいフォーマットでは以下のようになります:
5-11 -10 -3:0:0.2.5
-
コンポーネントは INTERVAL 型を文字列として表現します。クエリで INTERVAL 型が必要な場合は、BigQuery SQL の INTERVAL フォーマットを使用して INTERVAL を指定する必要があります:
前提条件
- Visual Studio 2022
- Visual Studio 2022 用 SQL Server Integration Services Projects 拡張機能
- CData SSIS Components for Google BigQuery
- CData SSIS Components for JD Edwards
プロジェクトの作成とコンポーネントの追加
-
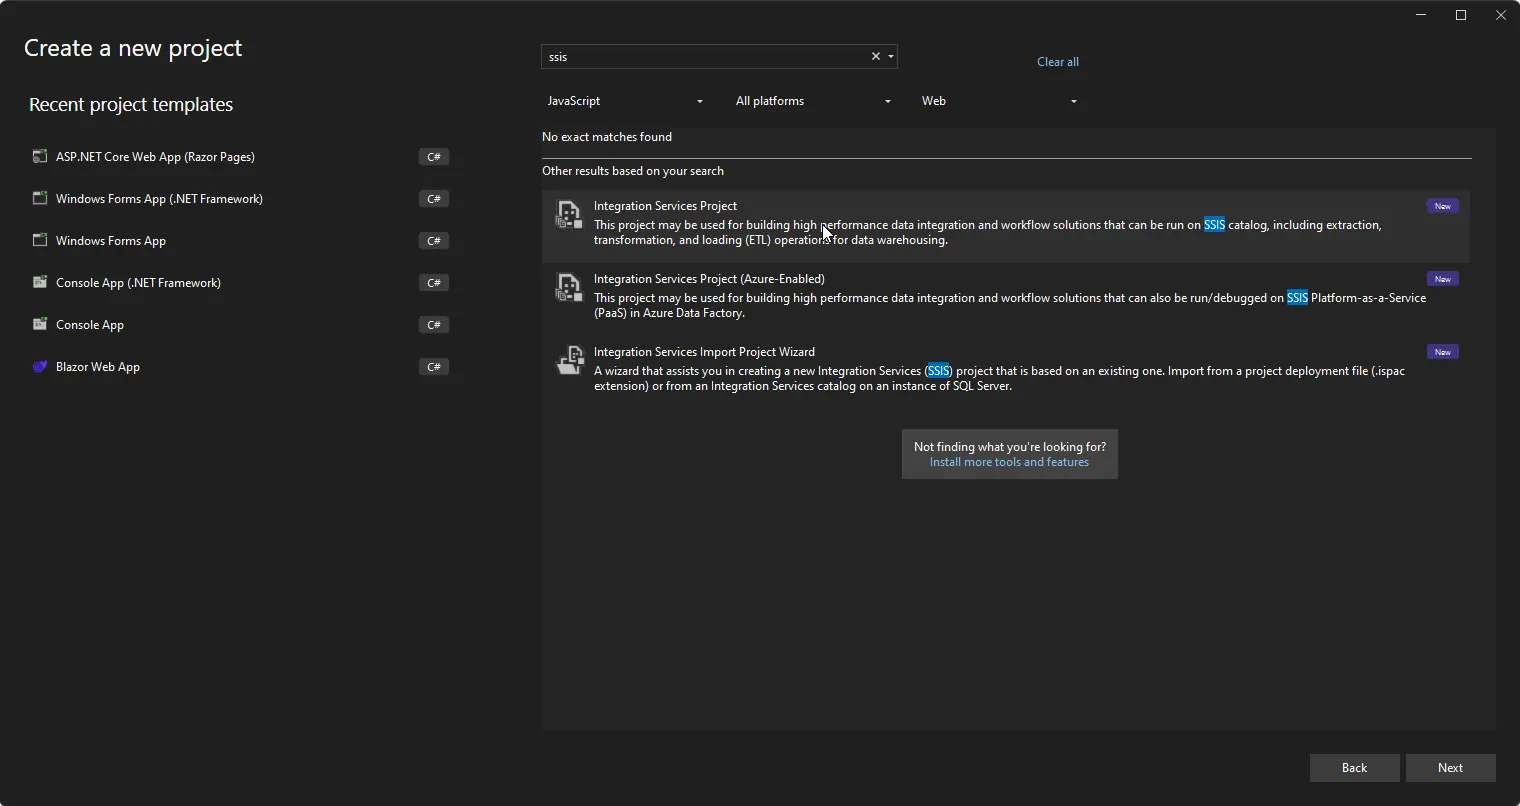
Visual Studio を開き、新しい Integration Services プロジェクトを作成します。
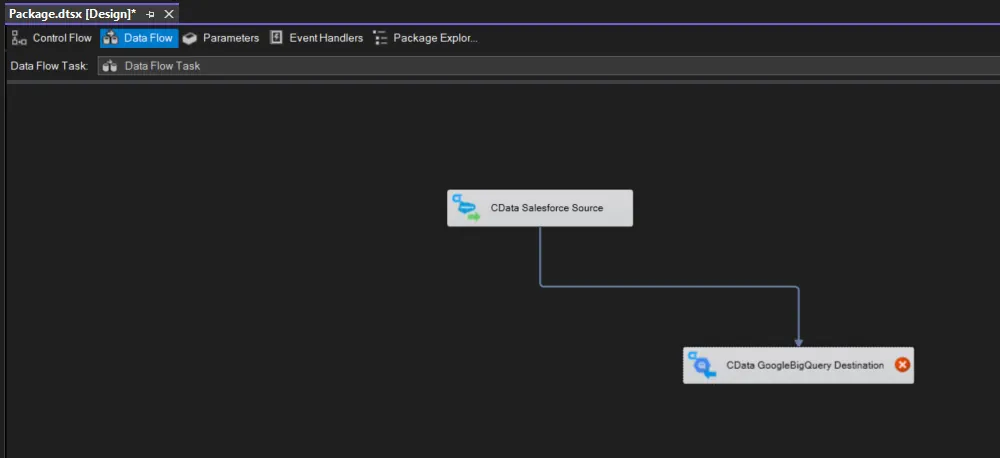
- Control Flow 画面に新しい Data Flow Task を追加し、Data Flow Task を開きます。
-
Data Flow Task に CData JD Edwards Source コントロールと CData GoogleBigQuery Destination コントロールを追加します。
JD Edwards ソースの設定
以下の手順に従って、JD Edwards への接続に必要なプロパティを指定します。
-
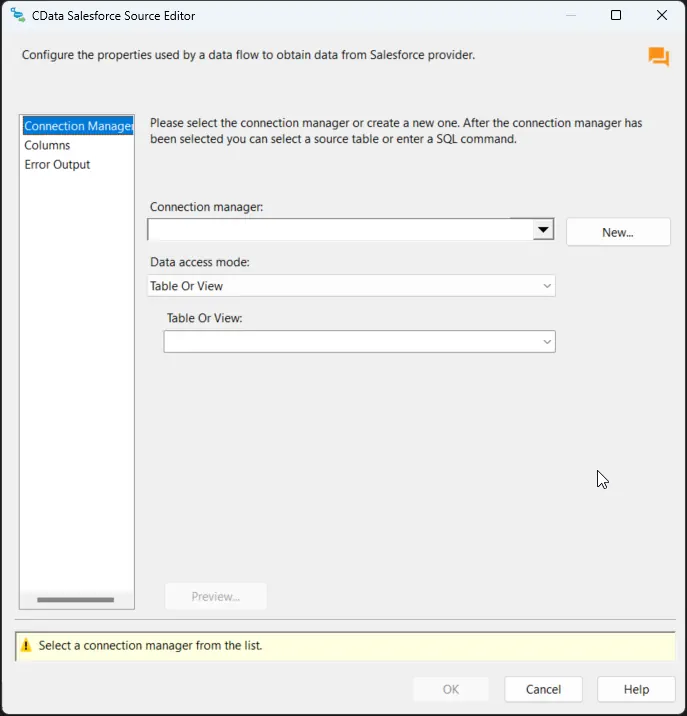
CData JD Edwards Source をダブルクリックしてソースコンポーネントエディタを開き、新しい接続を追加します。
-
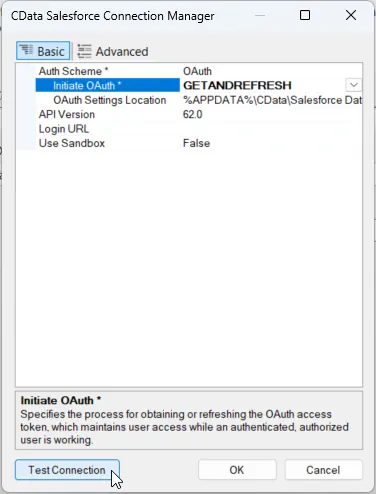
CData JD Edwards Connection Manager で接続プロパティを設定し、接続をテストして保存します。
ドライバーは Application Interface Services(AIS)Server を経由して JD Edwards に接続します。以下の接続プロパティを設定します。
- URL:AIS Server のベース HTTPS URL(例:https://jde-ais.example.com:8300)。
- User:JD Edwards のユーザー名。
- Password:JD Edwards のパスワード。
- Environment(オプション):使用する JD Edwards の環境(例:本番環境なら PD920、開発環境なら DV920)。指定しない場合は、AIS Server のデフォルト環境が使用されます。
- Role(オプション):セッションで使用する JD Edwards のロール。指定しない場合は、AIS Server のデフォルトロールが使用されます。
- DeviceName(オプション):接続元のデバイスまたはアプリケーションの識別子。AIS Server での監査やログ記録に使用されます。
- Jasserver(オプション):リクエストのルーティング先となる Java Application Server(JAS)インスタンス。クラスタ環境で便利です。
公開するデータの選択
JD Edwards ではテーブルとビジネスビューが System Code ごとに整理されており、ドライバーは各 System Code をそれぞれ個別のスキーマとして公開します。利用できるスキーマは、以下のプロパティで制御できます。
- DataModel:System Code をスキーマとして公開する ERP モジュール(カンマ区切りで複数指定可)。接続先インスタンスのすべての System Code を公開する場合は All を指定します。デフォルトは FinancialManagement です。
- SystemCodes:DataModel の System Code に加えて公開したい System Code のカンマ区切りリスト(例:42,43)。
接続時、ドライバーは認証情報を AIS Server に送信してセッショントークンを取得し、キャッシュします。セッションの有効期限が切れる前に、新しいトークンが自動でリクエストされます。
-
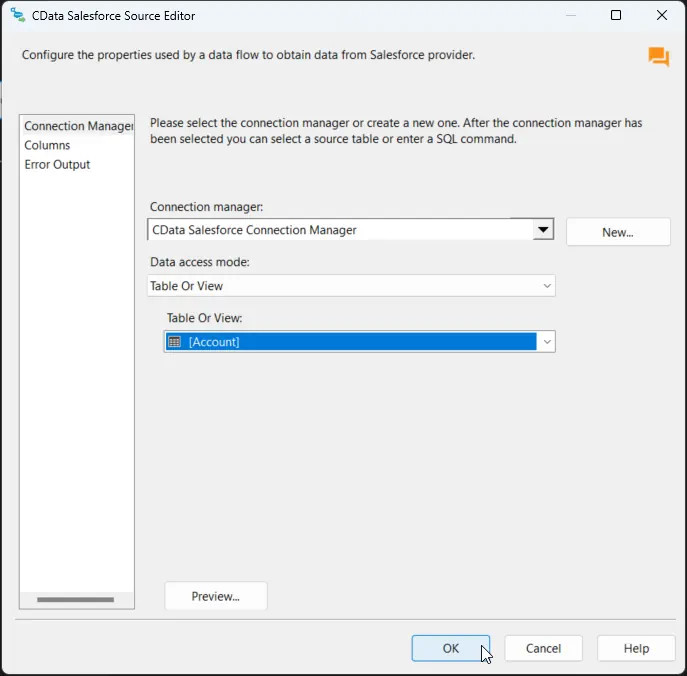
接続を保存後、「Table or view」を選択し、Google BigQuery にエクスポートするテーブルまたはビューを選択して、CData JD Edwards Source Editor を閉じます。
Google BigQuery デスティネーションの設定
JD Edwards Source を設定したら、Google BigQuery 接続を設定してカラムをマッピングします。
-
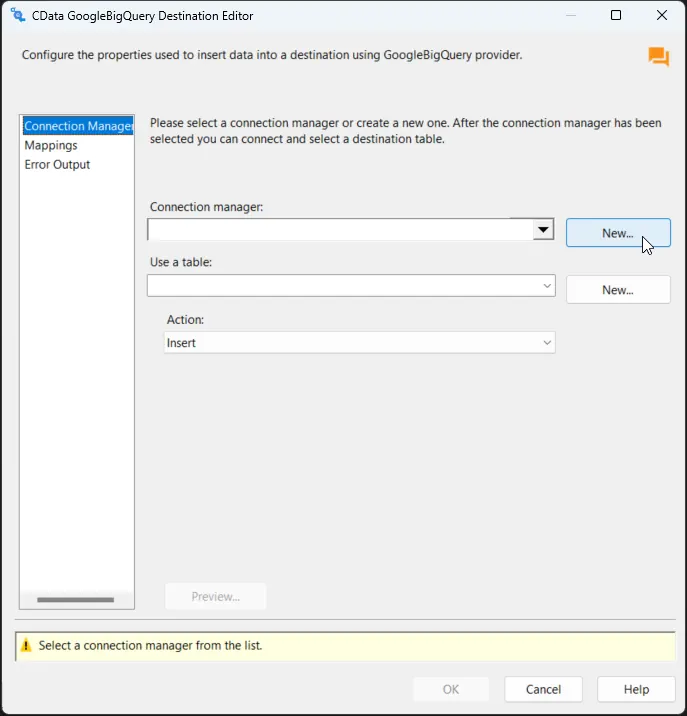
CData Google BigQuery Destination をダブルクリックしてデスティネーションコンポーネントエディタを開き、新しい接続を追加します。
-
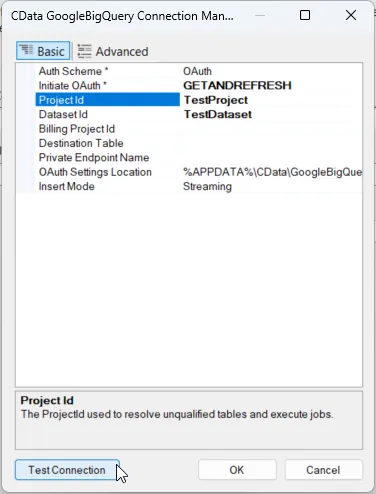
CData GoogleBigQuery Connection Manager で接続プロパティを設定し、接続をテストして保存します。
- Google は OAuth 認証標準を使用しています。個々のユーザーに代わって Google API にアクセスするには、埋め込み資格情報を使用するか、独自の OAuth アプリを登録できます。 OAuth を使用すると、サービスアカウントを使用して Google Apps ドメイン内のユーザーに代わって接続することもできます。サービスアカウントで認証するには、アプリケーションを登録して OAuth JWT 値を取得します。 OAuth 値に加えて、DatasetId と ProjectId を指定します。OAuth の使用ガイドについては、ヘルプドキュメントの「Getting Started」章を参照してください。
便利な接続プロパティ
- QueryPassthrough: True に設定すると、クエリは Google BigQuery に直接渡されます。
- ConvertDateTimetoGMT: True に設定すると、コンポーネントはローカルマシンの時刻ではなく、日時値を GMT に変換します。
- FlattenObjects: デフォルトでは、コンポーネントは STRUCT カラムの各フィールドを独自のカラムとして報告し、STRUCT カラム自体は非表示にします。False に設定すると、トップレベルの STRUCT は展開されず、独自のカラムとして残ります。このカラムの値は JSON 集約として報告されます。
- SupportCaseSensitiveTables: このプロパティを true に設定すると、同じ名前で大文字小文字が異なるテーブルは、すべてメタデータで報告されるように名前が変更されます。デフォルトでは、プロバイダーはテーブル名を大文字小文字を区別しないものとして扱うため、複数のテーブルが同じ名前で大文字小文字が異なる場合、メタデータでは 1 つだけが報告されます。
-
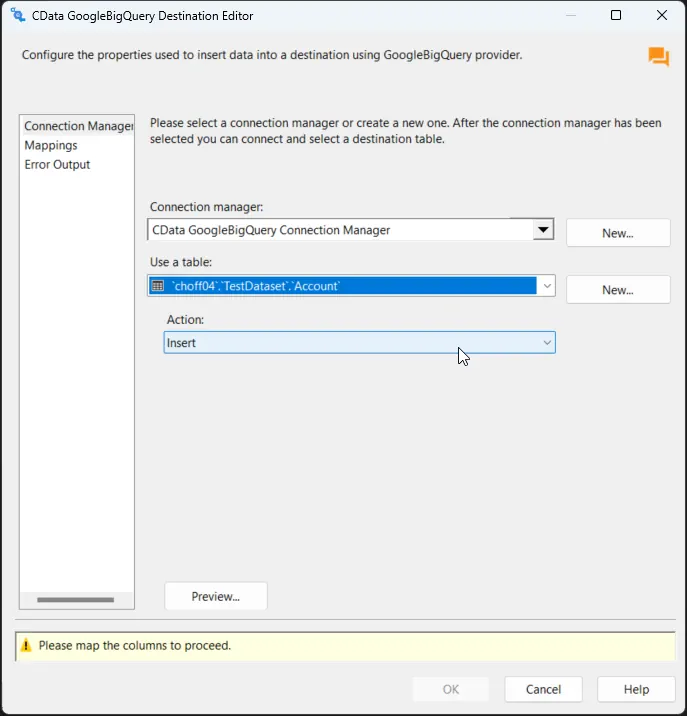
接続を保存後、Use a Table メニューでテーブルを選択し、Action メニューで Insert を選択します。
-
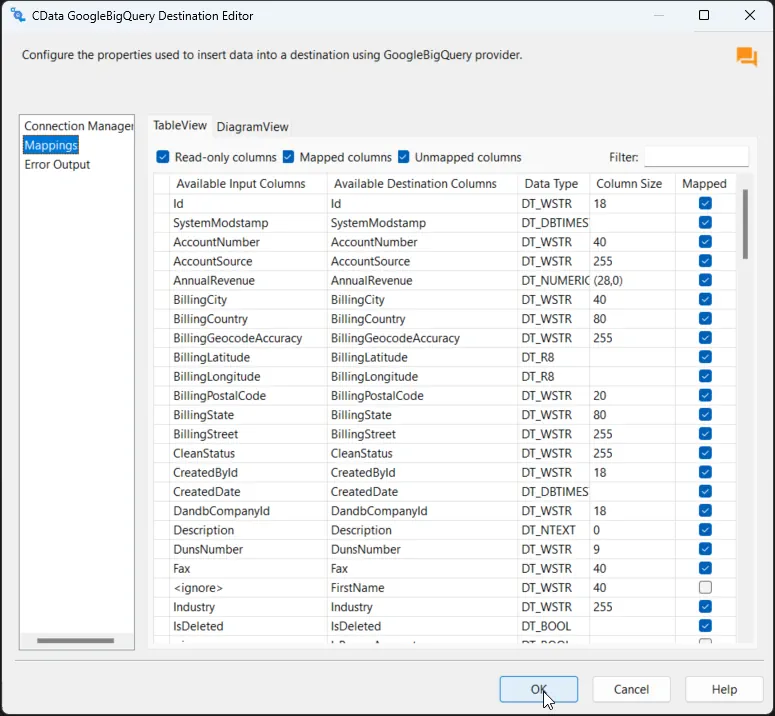
Column Mappings タブで、入力カラムからデスティネーションカラムへのマッピングを設定します。
プロジェクトの実行
これでプロジェクトを実行できます。SSIS Task の実行が完了すると、SQL テーブルのデータが選択したテーブルにエクスポートされます。
はじめる準備はできましたか?
JD Edwards SSIS Component の無料トライアルをダウンロードしてお試しください:
ダウンロード詳細:
 JD Edwards SSIS Components
SSIS ソースコンポーネントは、SQL Server SSIS のワークフロー内で簡単にJD Edwards データにリアルタイム接続できるパワフルなツールです。
データフロー内のJD Edwards コンポーネントを使ってAccountLedger、ProposalofPayment、ContractRevenueSummary、EmployeeEnrollment、RentIncreaseAmounts などを同期できます。データ同期、ローカルバックアップ、ワークフローの自動化などに最適!