

DatabricksからConnect AI経由でPingOne に接続・クエリ
Databricks は、データエンジニアリング、機械学習、アナリティクスを大規模に統合する AI クラウドネイティブプラットフォームです。 データウェアハウスのパフォーマンスとデータレイクの柔軟性を兼ね備えた強力なデータレイクハウスアーキテクチャを提供しています。 Databricks を CData Connect AI と統合すると、 複雑な ETL パイプラインやデータの複製を必要とせず、PingOne のデータ にリアルタイムでアクセスでき、 運用の効率化とインサイトまでの時間短縮を実現できます。
この記事では、CData Connect AI を使用して Databricks から PingOne へのセキュアなライブ接続を設定する方法を説明します。 設定が完了すると、標準 SQL を使用して Databricks ノートブックから直接PingOne のデータにアクセスでき、 データエコシステム全体でリアルタイム分析を統合できます。
概要
シンプルなステップの概要は以下のとおりです:
- ステップ 1 - 接続と設定: CData Connect AI で PingOne ソースへの接続を作成し、ユーザー権限を設定して、 Personal Access Token(PAT)を生成します。
- ステップ 2 - Databricks からクエリ: Databricks に CData JDBC ドライバーをインストールし、ノートブックに接続情報を設定して、 SQL クエリでリアルタイムのPingOne のデータにアクセスします。
前提条件
始める前に、以下を準備してください:
- アクティブな PingOne アカウント
- CData Connect AI アカウント。ログインまたは 無料トライアルにサインアップできます。
- Databricks アカウント。こちらからサインアップまたはログインできます。
ステップ 1:CData Connect AI で PingOne 接続を設定
1.1 PingOne への接続を追加
CData Connect AI は、利用可能なデータソースに接続するためのシンプルなポイント&クリックインターフェースを提供しています。
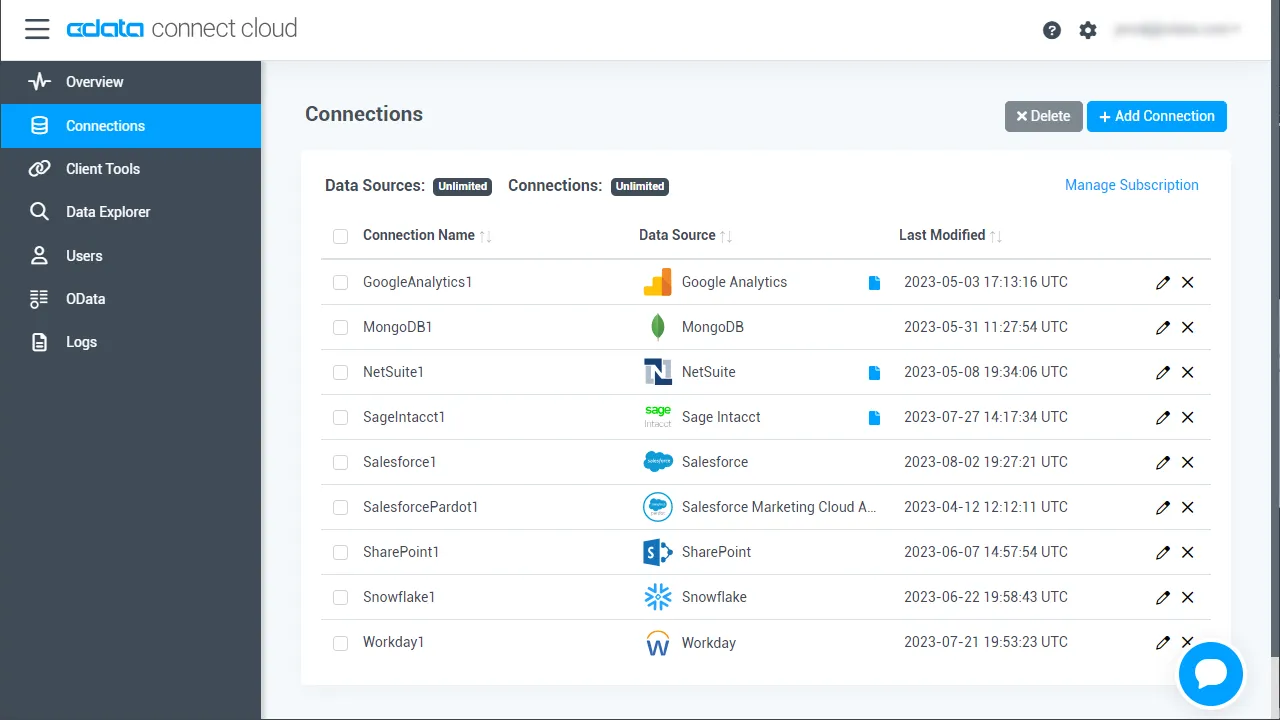
- Connect AI にログインし、左側の Sources をクリックして、 右上の Add Connection をクリック
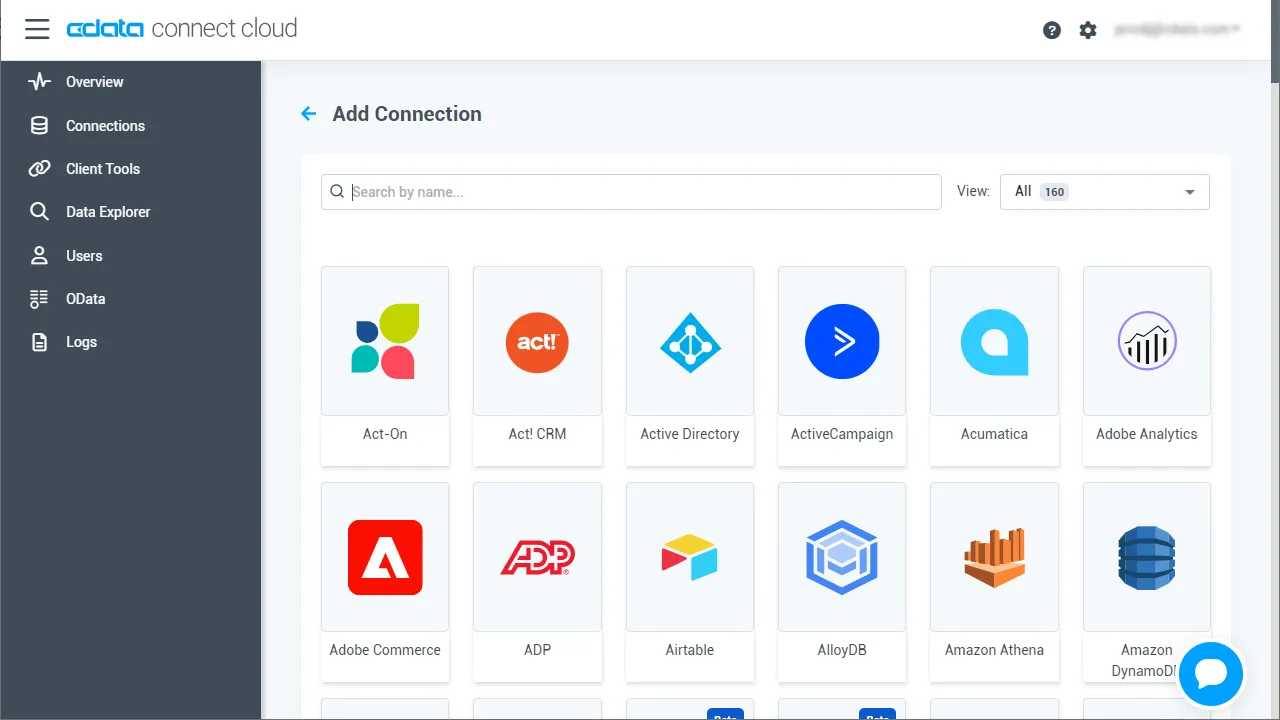
- Add Connection パネルから 「PingOne」 を選択
-
PingOne に接続するために必要な認証プロパティを入力します。
PingOne に接続するには以下のプロパティを設定します。
- Region:自身のPingOne 組織のデータがホスティングされている地域。
- AuthScheme:PingOne に接続する際に使用する認証の種類。
- WorkerAppEnvironmentId (デフォルトのPingOne ドメインを使用する場合に必要)、またはAuthorizationServerURL のいずれかで、下で説明するように設定します。
WorkerAppEnvironmentId の設定
WorkerAppEnvironmentId は、Worker アプリケーションが存在するPingOne 環境のID です。 このパラメータは、環境がデフォルトのPingOne ドメイン(auth.pingone)を利用している場合のみ使用されます。 これは、ヘルプドキュメントのカスタムOAuth アプリケーションの作成で説明するように、PingOne への認証に使用するカスタムOAuth アプリケーションを作成した後に設定します。
はじめに、このプロパティの値を見つけます。
- 自身のPingOne 組織のホームページからナビゲーションサイドバーに移動し、Environments をクリックします。
- OAuth / Worker のカスタムアプリケーションを作成した環境(通常はAdministrators)を見つけ、Manage Environment をクリックします。 環境のホームページが表示されます。
- 環境のホームページのナビゲーションサイドバーで、Applications をクリックします。
- リストから、OAuth またはWorker アプリケーションの詳細を見つけます。
-
Environment ID フィールドの値をコピーします。
以下の例に似たものになるはずです:
WorkerAppEnvironmentId='11e96fc7-aa4d-4a60-8196-9acf91424eca'
次に、WorkerAppEnvironmentId をEnvironment ID フィールドの値に設定します。
AuthorizationServerURL の設定
AuthorizationServerURL は、お使いのアプリケーションが配置されている環境のPingOne 認可サーバーのベースURL です。 このプロパティは、PingOne プラットフォームAPI ドキュメントで説明されているように、環境にカスタムドメインを設定した場合にのみ使用されます。 Custom Domains を参照してください。
OAuth でのPingOne への認証
PingOne はOAuth とOAuthClient 認証の両方をサポートしています。 上述の設定手順に加え、OAuth またはOAuthCliet 認証をサポートするために、さらに2つの手順を完了する必要があります。
- ヘルプドキュメントのカスタムOAuth アプリケーションの作成で説明するように、カスタムOAuth アプリケーションを作成して設定します。
- ドライバーがデータモデル内のエンティティにアクセスできるようにするには、ヘルプドキュメントのAdministrator Roles での説明のとおり、使用するアドミンユーザー / ワーカーアプリケーションに対して正しいロールを設定していることを確認してください。
- 以下のサブセクションで説明されているように、選択した認証スキームと認証フローに適切なプロパティを設定します。
OAuth(認可コードグラント)
AuthScheme をOAuth に設定します。
デスクトップアプリケーション
OAuth アクセストークンの取得およびリフレッシュ
以下を設定して、接続してください。
- InitiateOAuth:GETANDREFRESH。繰り返しOAuth の交換を行ったり、手動でOAuthAccessToken を設定する必要をなくすには、InitiateOAuth を使用します。
- OAuthClientId:カスタムOAuth アプリケーションを作成した際に取得したClient ID。
- OAuthClientSecret:カスタムOAuth アプリケーションを作成した際に取得したClient Secret。
- CallbackURL:カスタムOAuth アプリケーションの登録時に定義したリダイレクトURI。例:https://localhost:3333
接続すると、CData 製品 はデフォルトブラウザでPingOne のOAuth エンドポイントを開きます。ログインして、アプリケーションにアクセス許可を与えます。 ドライバーはこれでOAuth プロセスを完了します。
- ドライバーはPingOne からアクセストークンを取得し、それを使ってデータをリクエストします。
- OAuth 値はOAuthSettingsLocation で指定された場所に保存され、接続間で永続化されるようにします。
ドライバーはアクセストークンの期限が切れると自動的にリフレッシュします。
Web アプリケーションやヘッドレスマシン、クライアントクレデンシャルグラントを含むその他のOAuth メソッドについては、ヘルプドキュメントを参照してください。
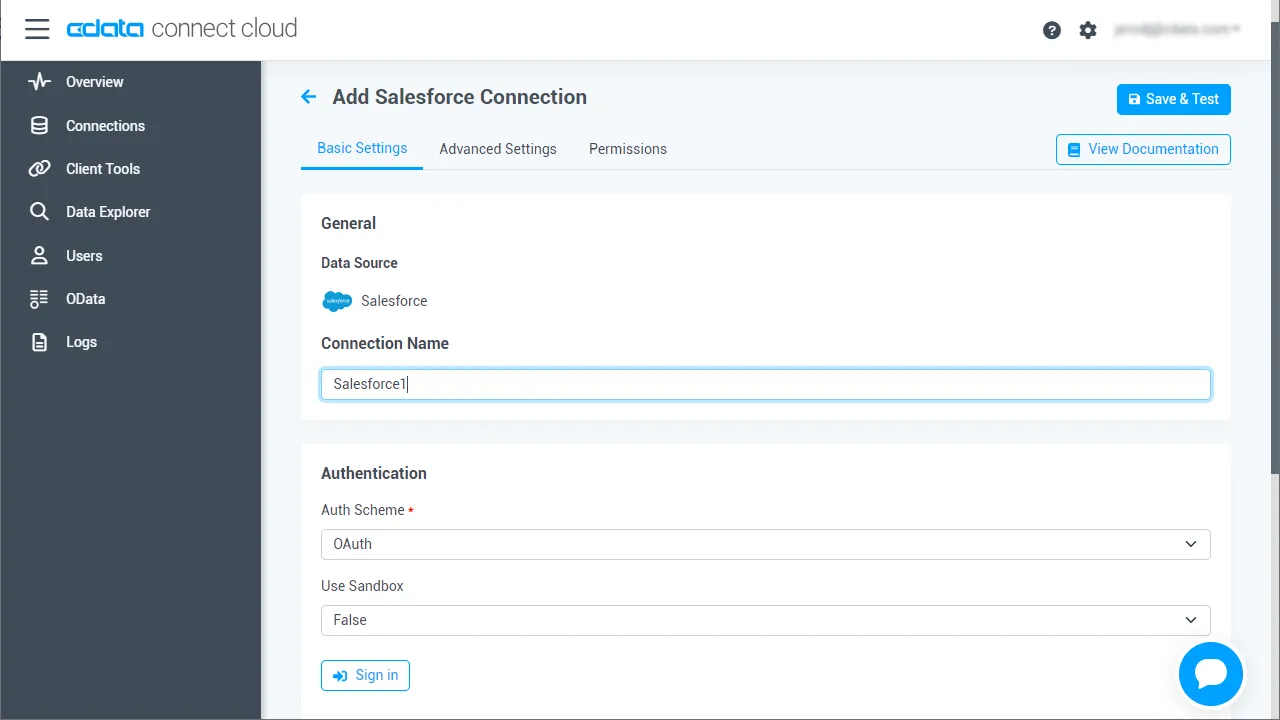
- 右上の Save & Test をクリック
-
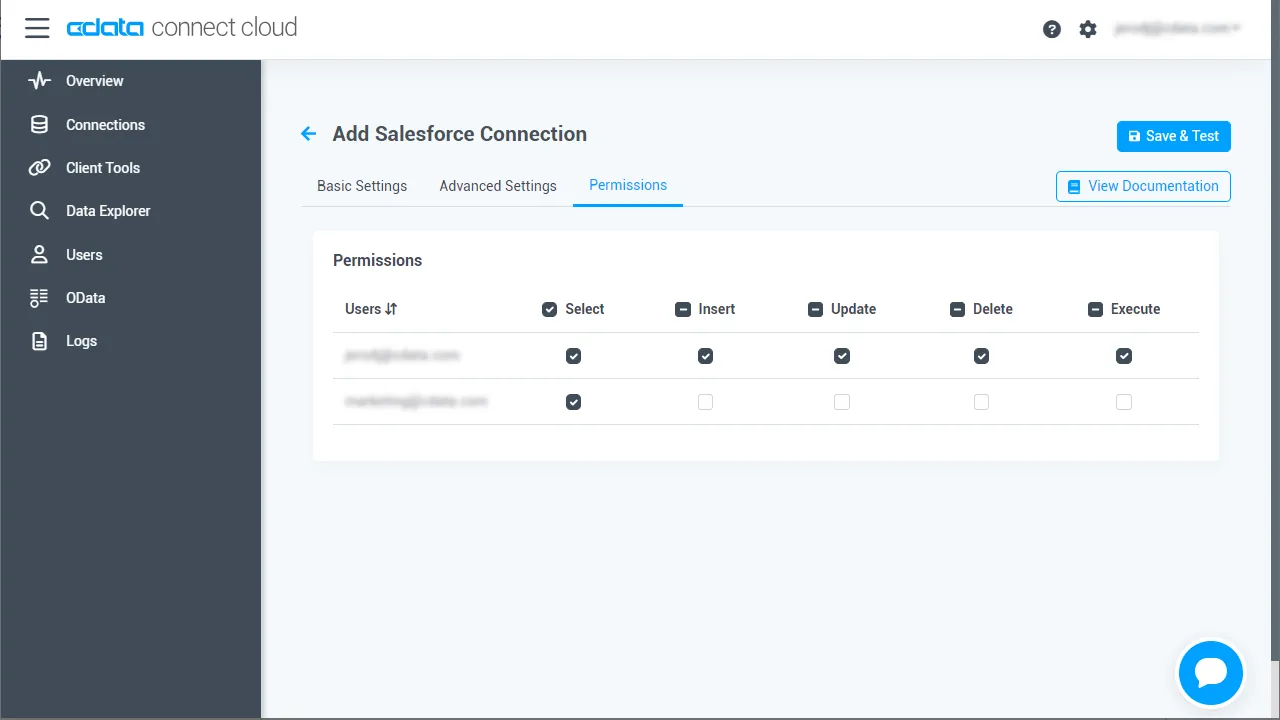
PingOne Connection ページで Permissions タブに移動し、
お好みに応じてユーザーベースの権限を更新します。
1.2 Personal Access Token(PAT)を生成
REST API、OData API、または仮想 SQL Server 経由で Connect AI に接続する場合、 Personal Access Token(PAT)が Connect AI への接続認証に使用されます。PAT は、セキュアなトークンベースの認証として ログイン認証情報の代わりに機能します。アクセスの粒度を維持するため、 サービスごとに個別の PAT を作成することをお勧めします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして Settings ページを開く
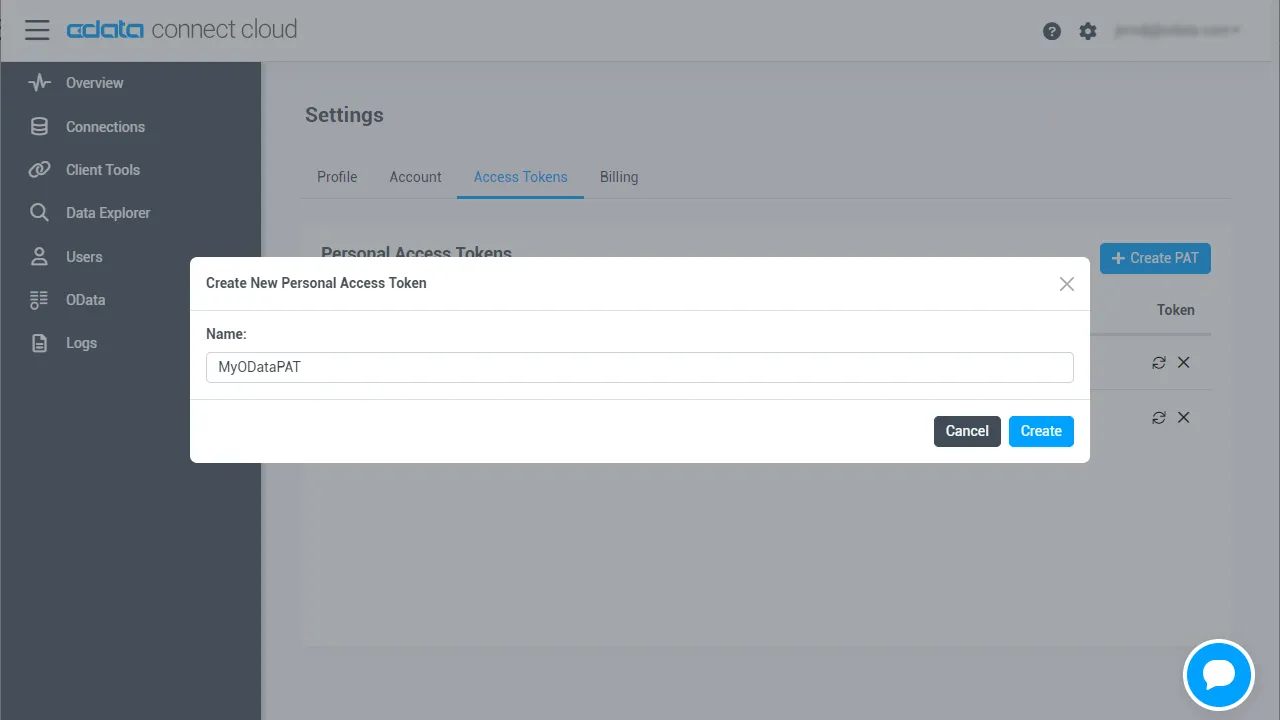
- Settings ページで Access Tokens セクションに移動し、 Create PAT をクリック
-
PAT に名前を付けて Create をクリック
- 注意:Personal Access Token は作成時にのみ表示されるので、必ずコピーして安全な場所に保存してください。
ステップ 2:Databricks で PingOne データに接続・クエリ
以下の手順に従って、Databricks から PingOne への接続を確立します。 CData JDBC Driver for Connect AI をインストールし、JAR ファイルをクラスターに追加して、ノートブックを設定し、 SQL クエリでリアルタイムのPingOne のデータにアクセスします。
2.1 CData JDBC Driver for Connect AI をインストール
- CData Connect AI で、左側の Integrations ページをクリック。 JDBC または Databricks を検索し、Download をクリックして、 お使いの OS 用のインストーラーを選択します。
-
ダウンロード後、インストーラーを実行して指示に従います:
- Windows の場合:セットアップファイルを実行し、インストールウィザードに従います。
- Mac/Linux の場合:アーカイブを解凍し、フォルダを /opt または /Applications に移動します。実行権限があることを確認してください。
-
インストール後、インストールディレクトリで JAR ファイルを見つけます:
- Windows:
C:\Program Files\CData\CData JDBC Driver for Connect AI\lib\cdata.jdbc.connect.jar - Mac/Linux:
/Applications/CData/CData JDBC Driver for Connect AI/lib/cdata.jdbc.connect.jar
- Windows:
2.2 Databricks に JAR ファイルをインストール
-
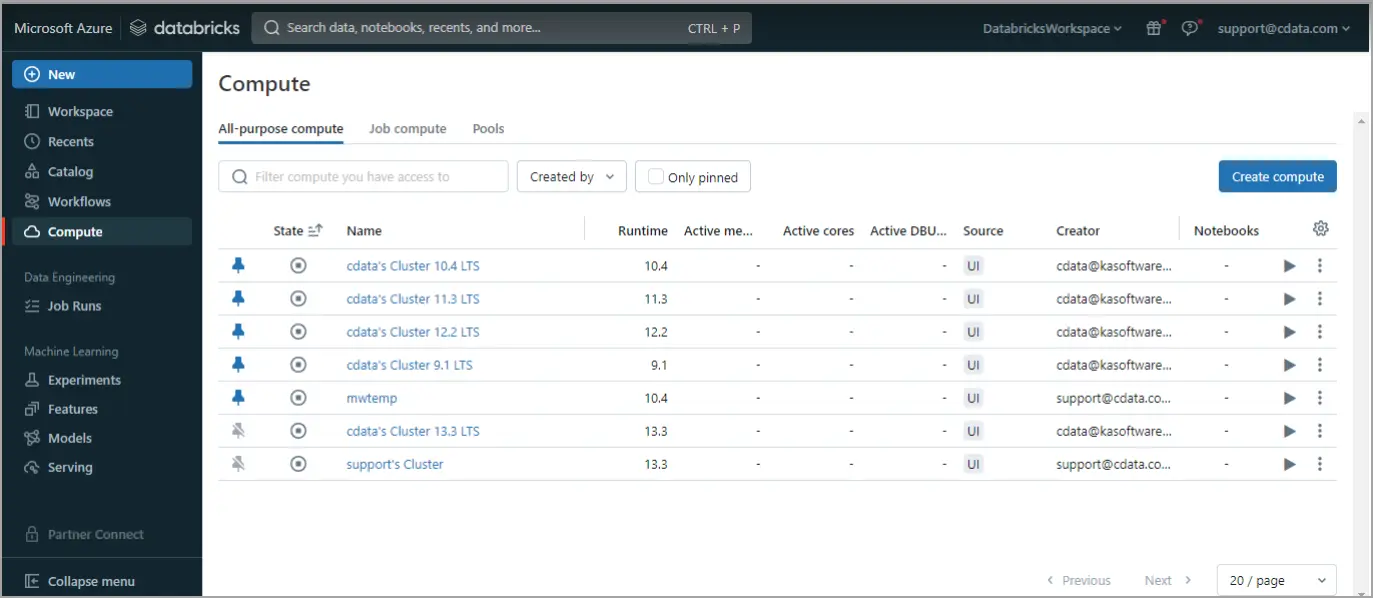
Databricks にログイン。左側のナビゲーションペインで Compute をクリック。コンピュートクラスターを開始または作成します。
-
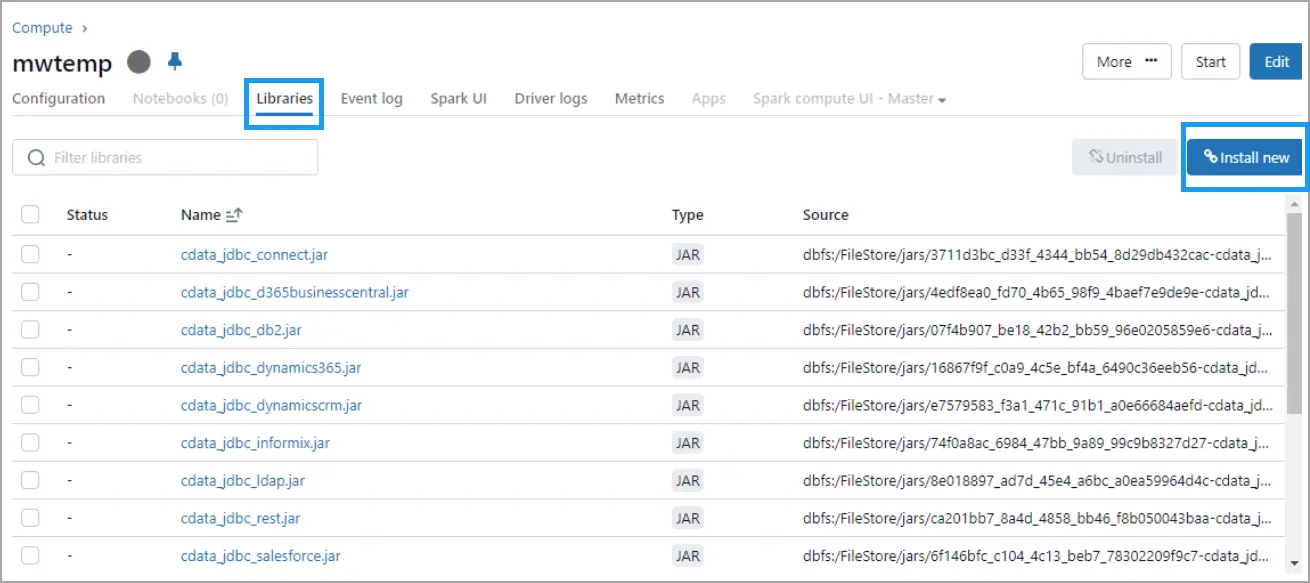
実行中のクラスターをクリックし、Libraries タブに移動して、右上の Install New をクリック。
-
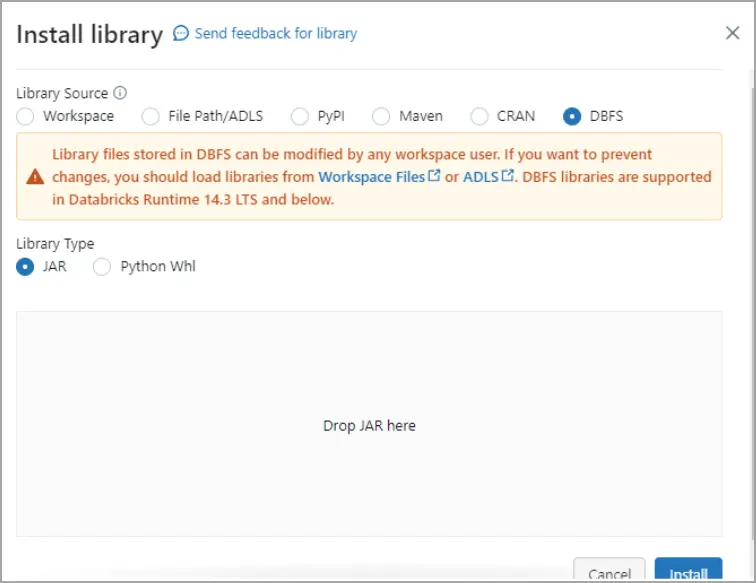
Install Library ダイアログで DBFS を選択し、
cdata.jdbc.connect.jar ファイルをドラッグ&ドロップ。Install をクリック。
2.3 Databricks ノートブックで PingOne データをクエリ
ノートブックスクリプト 1 - JDBC 接続を定義:
- 以下のスクリプトをノートブックセルに貼り付けます:
driver = "cdata.jdbc.connect.ConnectDriver"
url = "jdbc:connect:AuthScheme=Basic;User=your_username;Password=your_pat;URL=https://cloud.cdata.com/api/;DefaultCatalog=Your_Connection_Name;"
- 以下を置き換えます:
- your_username - CData Connect AI のユーザー名
- your_pat - CData Connect AI の Personal Access Token(PAT)
- Your_Connection_Name - Sources ページの Connect AI データソース名
- スクリプトを実行します。
ノートブックスクリプト 2 -PingOne のデータから DataFrame を読み込み:
- 2 番目のスクリプト用に新しいセルを追加します。ノートブック右側のメニューから Add cell below をクリック。
- 以下のスクリプトを新しいセルに貼り付けます:
remote_table = spark.read.format("jdbc") \
  .option("driver", "cdata.jdbc.connect.ConnectDriver") \
  .option("url", "jdbc:connect:AuthScheme=Basic;User=your_username;Password=your_pat;URL=https://cloud.cdata.com/api/;DefaultCatalog=Your_Connection_Name;") \
  .option("dbtable", "YOUR_SCHEMA.YOUR_TABLE") \
  .load()
- 以下を置き換えます:
- your_username - CData Connect AI のユーザー名
- your_pat - CData Connect AI の Personal Access Token(PAT)
- Your_Connection_Name - Sources ページの Connect AI データソース名
- YOUR_SCHEMA.YOUR_TABLE - スキーマとテーブル名(例:PingOne.[CData].[Administrators].Users)
- スクリプトを実行します。
ノートブックスクリプト 3 - カラムをプレビュー:
- 同様に、3 番目のスクリプト用に新しいセルを追加します。
- 以下のスクリプトを新しいセルに貼り付けます:
display(remote_table.select("ColumnName1", "ColumnName2"))
- ColumnName1 と ColumnName2 を PingOne 構造の実際のカラム名に置き換えます(例:Id、Username など)。
- スクリプトを実行します。
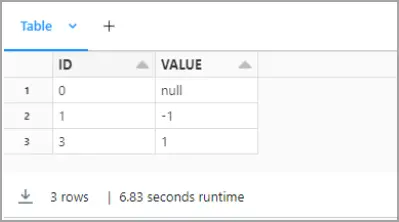
これで、バックエンド API の複雑さを意識することなく、またPingOne のデータをレプリケーションすることなく、 Databricks ノートブック内で直接リアルタイムの PingOne のデータ を探索、結合、分析できるようになりました。
CData Connect AI を 14 日間無料でお試しください
PingOne のデータへのリアルタイムアクセスを簡素化する準備はできましたか? CData Connect AI の 14 日間無料トライアルを今すぐ開始して、 Databricks から PingOne へのシームレスなライブ接続を体験してください。
ローコード、インフラ不要、レプリケーション不要 - 重要なデータとインサイトへの シームレスでセキュアなアクセスを実現します。