



エンタープライズサーチのNeuron にClaude Compliance のデータを取り込んで検索利用

ブレインズテクノロジー社のNeuron は、先端OSS 技術(Apache Solr)を活用したエンタープライズサーチ(企業内検索エンジン)サービスです。Apache Solr は、エンタープライズサーチ機能をAPI として提供してくれますが、Neuron はApache Solr に企業ユーザーがデータを探索するためのシンプルかつ使いやすいユーザーインターフェースと管理画面・運用機能を提供してくれます。これによりエンドユーザーが簡単にエンタープライズサーチを利用することができます。管理画面では、ファイルやデータのクローリング設定がUI で行えるようになっています。この記事では、Neuron に備わっているJDBC インターフェース経由で、CData JDBC Driver for ClaudeCompliance を利用することでNeuron にClaude Compliance のデータを取り込んで検索で利用できるようにします。
Neuron にCData JDBC Driver for ClaudeCompliance データをロード
CData JDBC Driver for ClaudeCompliance のインストールと.jar ファイルの配置
- CData JDBC Driver for ClaudeCompliance をNeuron と同じマシンにインストールします。
-
以下のパスにJDBC Driver がインストールされます。
C:\Program Files\CData\CData JDBC Driver for ClaudeCompliance 20xxJ\lib\cdata.jdbc.claudecompliance.jar
-
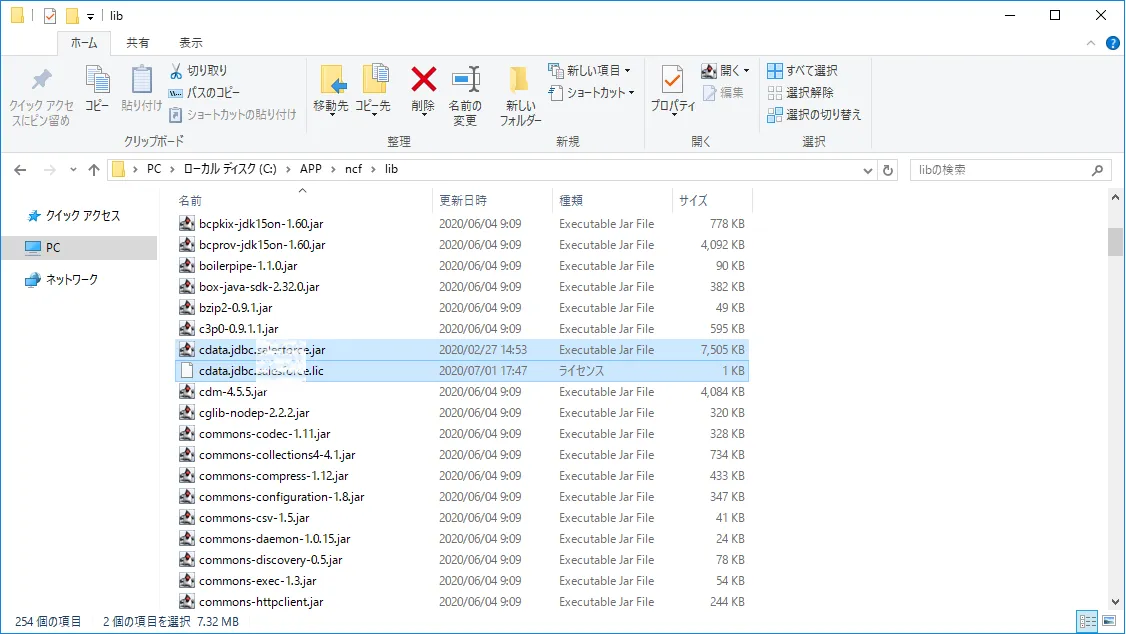
このcdata.jdbc.claudecompliance.jar とcdata.jdbc.claudecompliance.lic ファイルをコピーして、Neuron のC:\APP
cf\lib フォルダに配置します。
Neuron CF でのClaude Compliance のデータを扱うリポジトリの作成
-
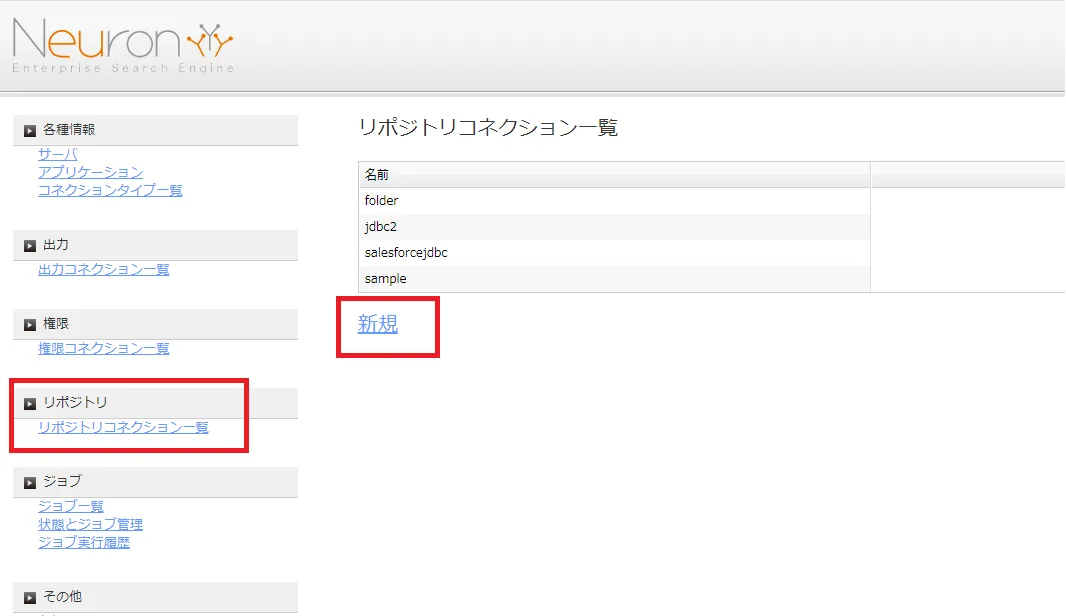
Neuron CF でクローラーの設定をGUI で行います。JDBC を読み取るためのリポジトリを作成します。Neuron の管理画面にログインし、[リポジトリ]→[リポジトリコレクション一覧]→[新規]をクリックします。
-
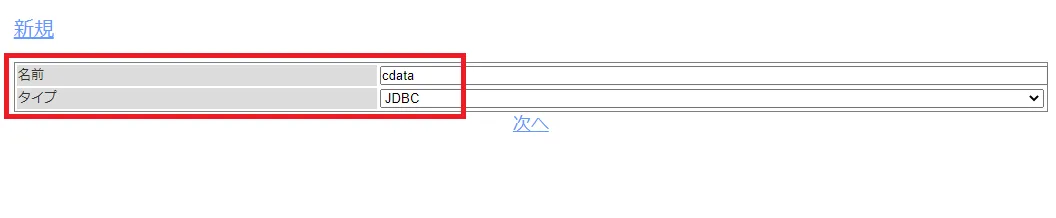
任意のリポジトリ名を入力します。タイプは[JDBC]を選択します。
-
次に、ドライバーのクラス名とJDBC 接続文字列でClaude Compliance への接続を行います。
ドライバーは Compliance Access Key を使用して Claude Compliance に接続します(サポートされている認証方式はこれのみです)。以下の接続プロパティを設定します。
- APIKey:作成した Compliance Access Key。
Compliance Access Key の作成
- 組織で Compliance API を有効にします。
- Primary Owner または Organization Owner として claude.ai にサインインし、Organization settings > API > Keys を開きます。
- Create Key を選択し、連携に必要なスコープのみを割り当てます。
- read:compliance_activities:Activities および各種アクティビティビュー用。
- read:compliance_org_data:組織、ロール、グループ、設定用。
- read:compliance_user_data:ユーザー、チャット、ファイル、プロジェクト、ダウンロード用。
- delete:compliance_user_data:明示的な Delete ストアドプロシージャ用。
- キーを作成し、表示されたらすぐにコピーします。キーは sk-ant-api01- で始まり、一度しか表示されません。
必要に応じて OrganizationUUID を設定すると、組織スコープのビュー(OrganizationUsers や ComplianceRoles など)を、リンクされた特定の 1 組織に限定できます。空欄の場合、これらのビューはデフォルトで最初に利用可能な組織を対象とし、リンクされたすべての組織のデータは含まれません。
ドライバクラス名:cdata.jdbc.claudecompliance.ClaudeComplianceDriver
接続文字列:jdbc:claudecompliance:APIKey=your_compliance_access_key;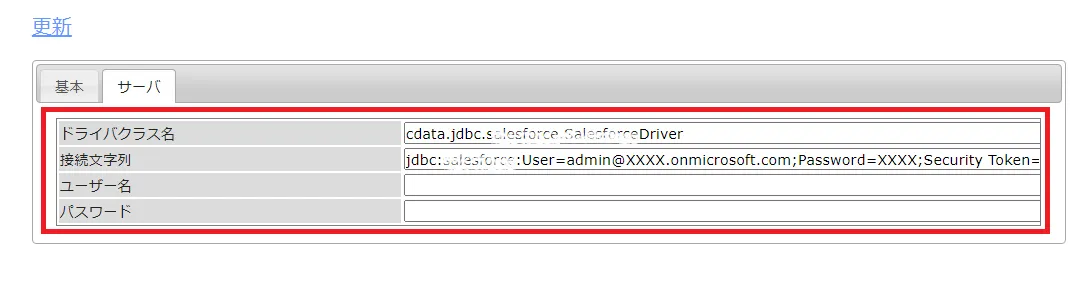
- [更新]をクリックして、Claude Compliance に接続するリポジトリコレクションができました。
Neuron でClaude Compliance のデータをクローリングするジョブを作成
続いて、Claude Compliance のどのデータをどのようにクローリングするのかをジョブで定義していきます。
-
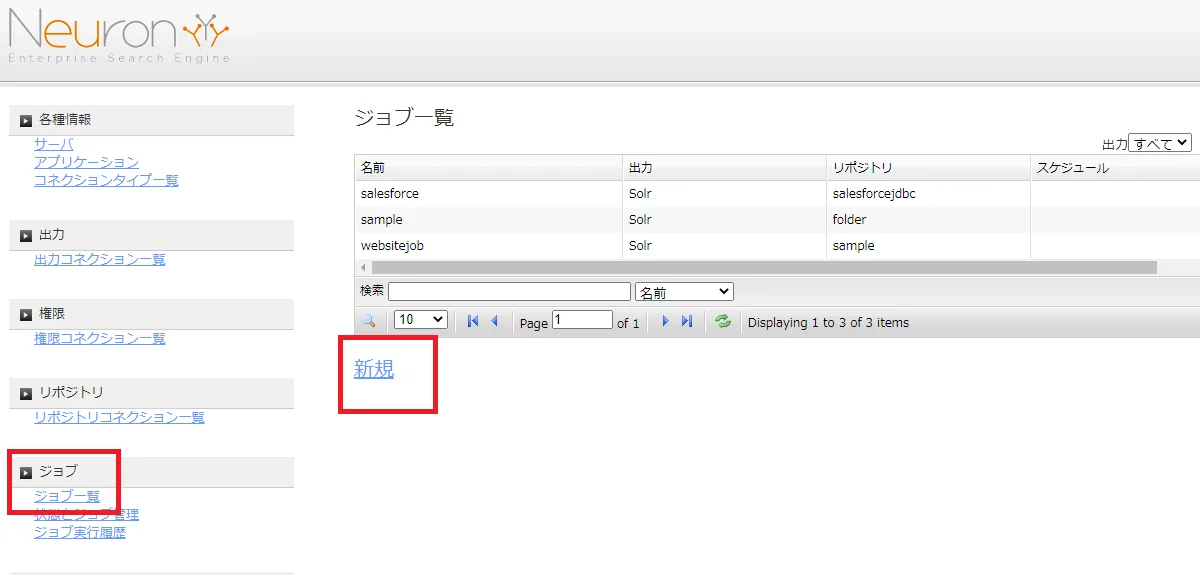
管理画面で[ジョブ]→[ジョブ一覧]→[新規]とクリックします。
-
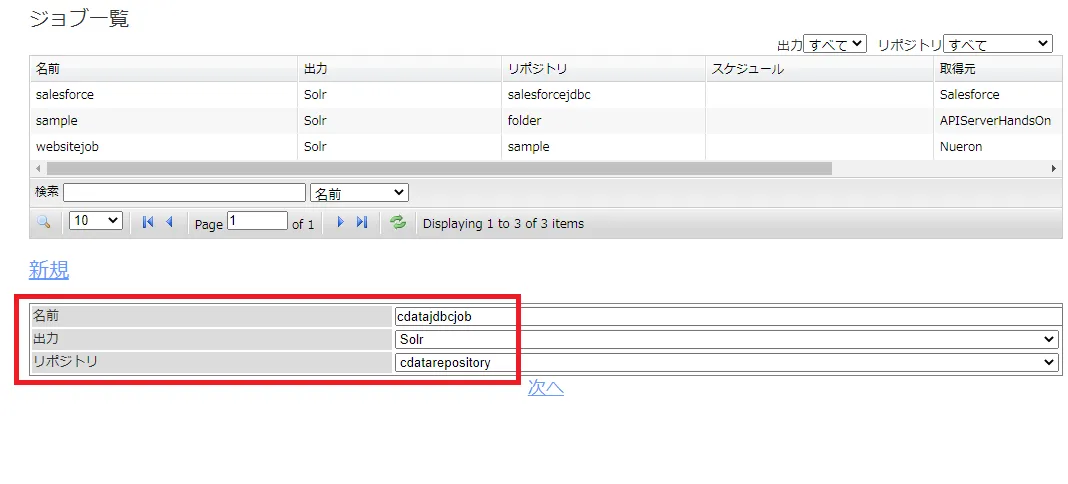
任意のジョブ名を入力します。出力先にはSolr を選択します。リポジトリは先ほど作成したClaude Compliance に接続するリポジトリコレクションを選びます。
-
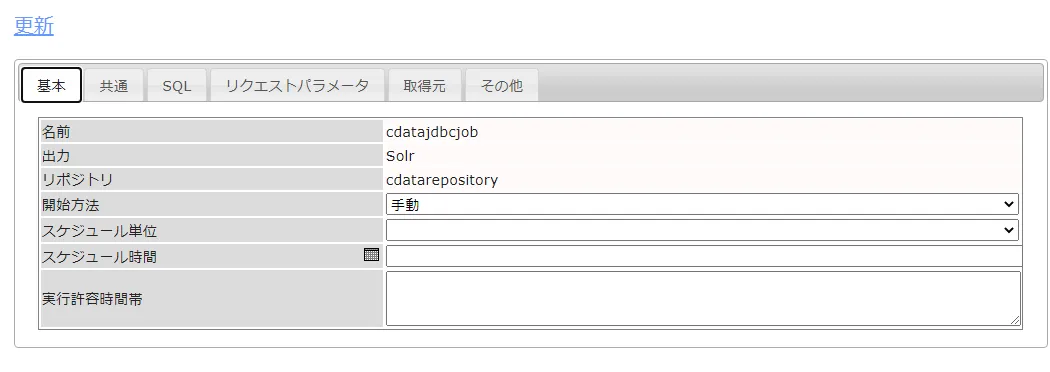
次に基本タブからジョブ実行を手動にするか、定期実行するかを自由に設定します。
-
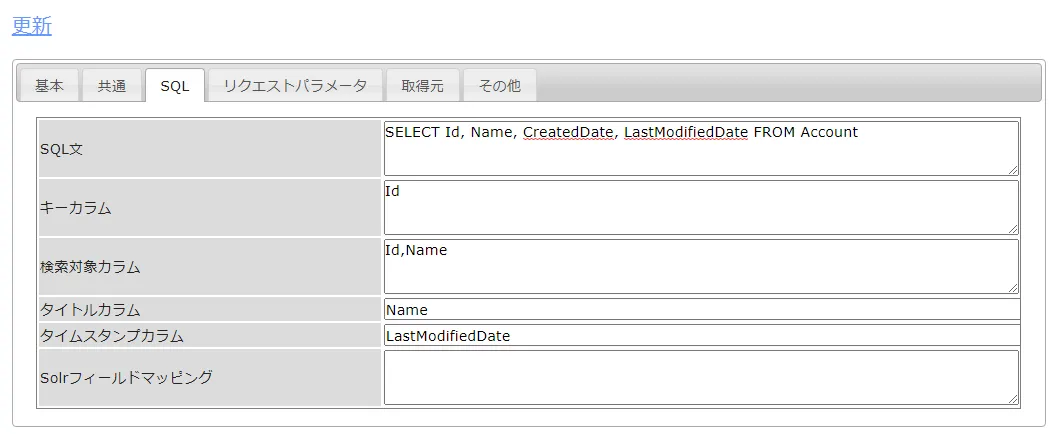
SQL タブでは、どんなデータを取得するのか、テーブル名やカラム、フィルタリング条件などを設定できます。CData JDBC ドライバがClaude Compliance のデータをテーブルにモデル化しているので、標準SQL でClaude Compliance をクエリすることができます。
- SQL文:SELECT Id, Name FROM Projects
- キーカラム:Id など取得テーブルのキーとなるカラム
- 検索対象カラム:検索の対象とするカラム
- タイトルカラム:検索結果のタイトルとするカラム
- タイムスタンプカラム:タイムスタンプとなるカラムがあれば、ここで指定します
- リクエストパラメータでは、検索結果レコードのURL (があれば)を設定することもできます。URL を表示できると表示された検索結果からレコードに簡単に移動できます。
- 取得元では、ラベルを設定しておきます。[更新]をクリックして、クローラージョブの設定を完了します。
Neuron でClaude Compliance のデータをクロールするジョブを実行
実際にNeuron で作成したジョブを実行します。[ジョブ]→[状態とジョブ管理]をクリックし、作成したジョブの[Start]をクリックします。
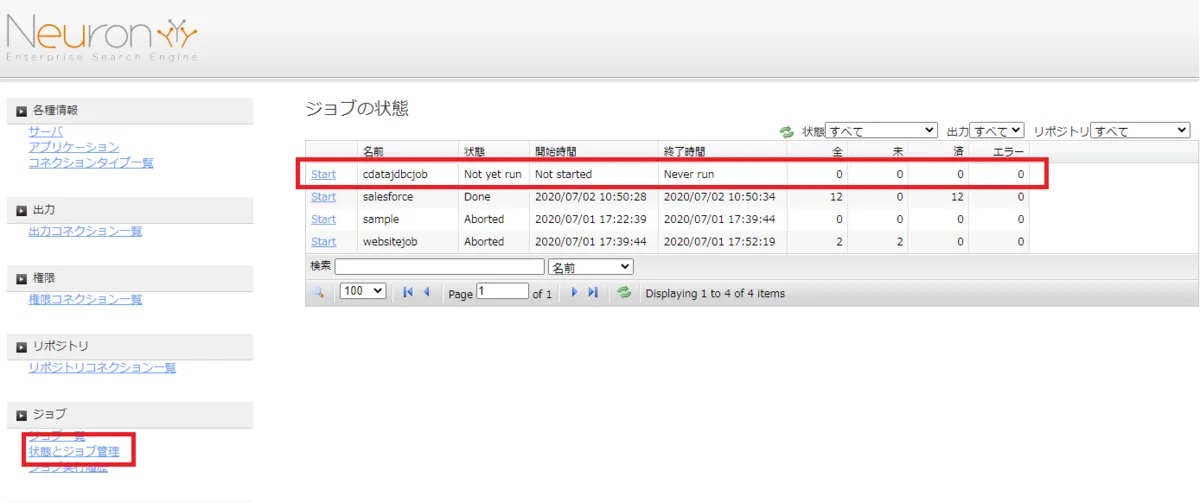
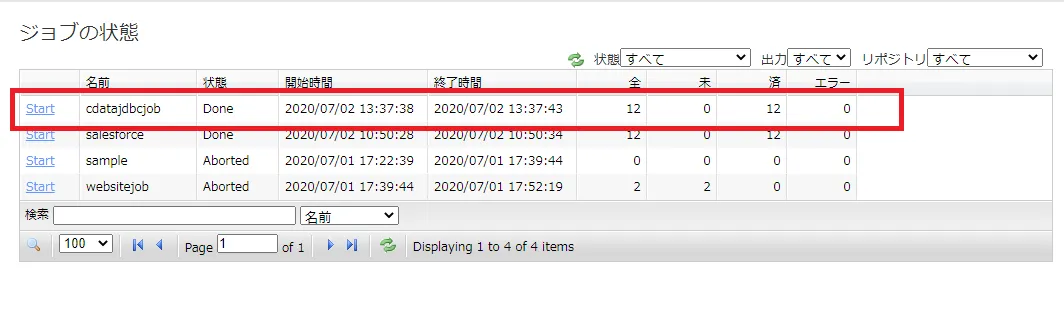
ジョブが正常完了すると、[Done]がステータスとして表示されます。
Neuron 上でのClaude Compliance のデータの検索の実施
実際にNeuron 上で検索ができるか確認してみます。取得元を絞り込むこと、内容やファイル名での検索、ファイルサイズやファイル更新日の絞り込み、部分一致や全部一致で検索が可能です。 検索をかけてみると、以下のようにデータを取得できました。
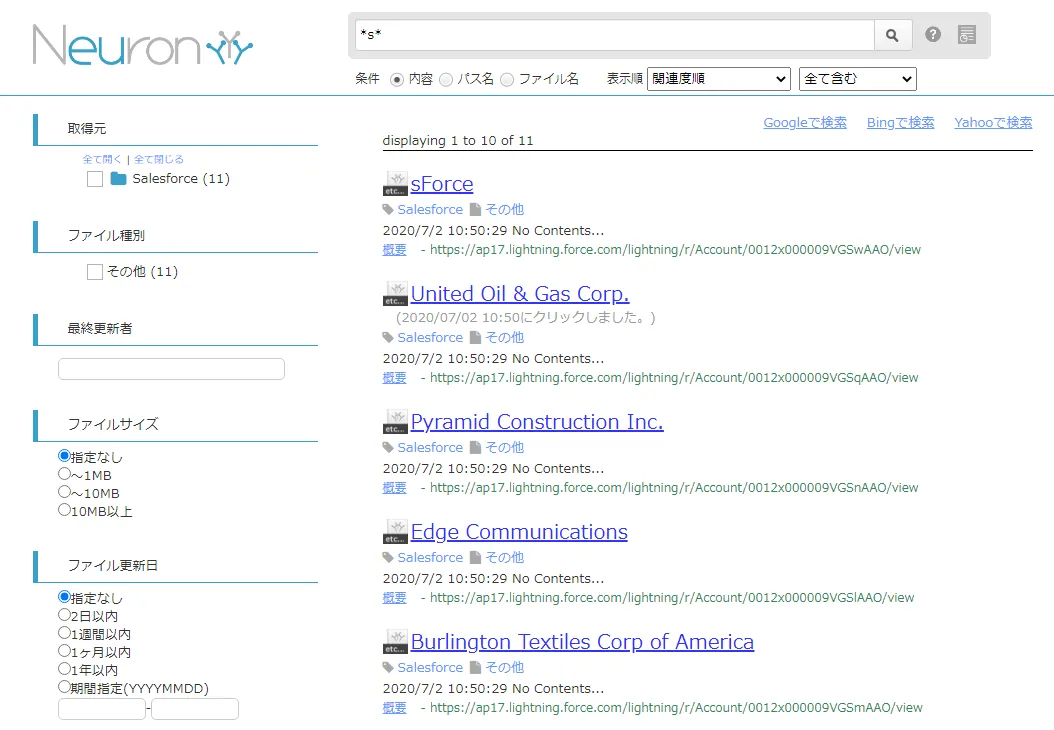
CData JDBC Driver for ClaudeCompliance をNeuron で使うことで、Claude Compliance コネクタとして機能し、簡単にデータを取得して同期することができました。ぜひ、30日の無償評価版をお試しください。
はじめる準備はできましたか?
Claude Compliance Driver の無料トライアルをダウンロードしてお試しください:
ダウンロード