



Google Data Fusion で Sage X3 Cloud に連携した ETL プロセスを作成
Google Data Fusion を使用すると、セルフサービス型のデータ連携を行い、異なるデータソースを統合できます。CData JDBC Driver for Sage X3 Cloud をアップロードすることで、Google Data Fusion のパイプライン内から Sage X3 Cloud のデータ にリアルタイムでアクセスできるようになります。CData JDBC Driver を使用すると、Sage X3 Cloud のデータ を Google Data Fusion でネイティブにサポートされている任意のデータソースにパイプできますが、この記事では、Sage X3 Cloud から Google BigQuery へデータをパイプする方法を説明します。
CData JDBC Driver for Sage X3 Cloud を Google Data Fusion にアップロード
CData JDBC Driver for Sage X3 Cloud を Google Data Fusion インスタンスにアップロードして、Sage X3 Cloud のデータ にリアルタイムでアクセスしましょう。Google Data Fusion では JDBC ドライバーの命名規則に制限があるため、JAR ファイルを driver-version.jar という形式に合わせてコピーまたはリネームしてください。例:cdatasagex3cloud-2020.jar
- Google Data Fusion インスタンスを開きます
- をクリックしてエンティティを追加し、ドライバーをアップロードします
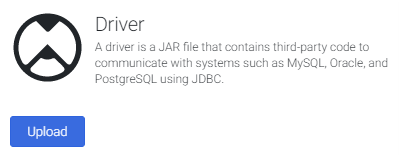
- "Upload driver" タブで、リネームした JAR ファイルをドラッグまたは参照します。
- "Driver configuration" タブで以下を設定します:
- Name: ドライバーの名前(cdata.jdbc.sagex3cloud)を作成し、メモしておきます
- Class name: JDBC クラス名を設定します:(cdata.jdbc.sagex3cloud.SageX3CloudDriver)
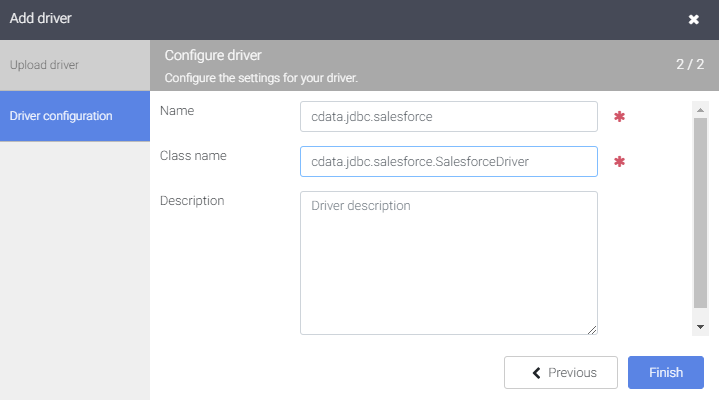
- "Finish" をクリックします
Google Data Fusion で Sage X3 Cloud のデータ に接続
JDBC Driver をアップロードしたら、Google Data Fusion のパイプラインで Sage X3 Cloud のデータ にリアルタイムでアクセスできます。
- Pipeline Studio に移動して、新しいパイプラインを作成します
- "Source" オプションから "Database" をクリックして、JDBC Driver 用のソースを追加します
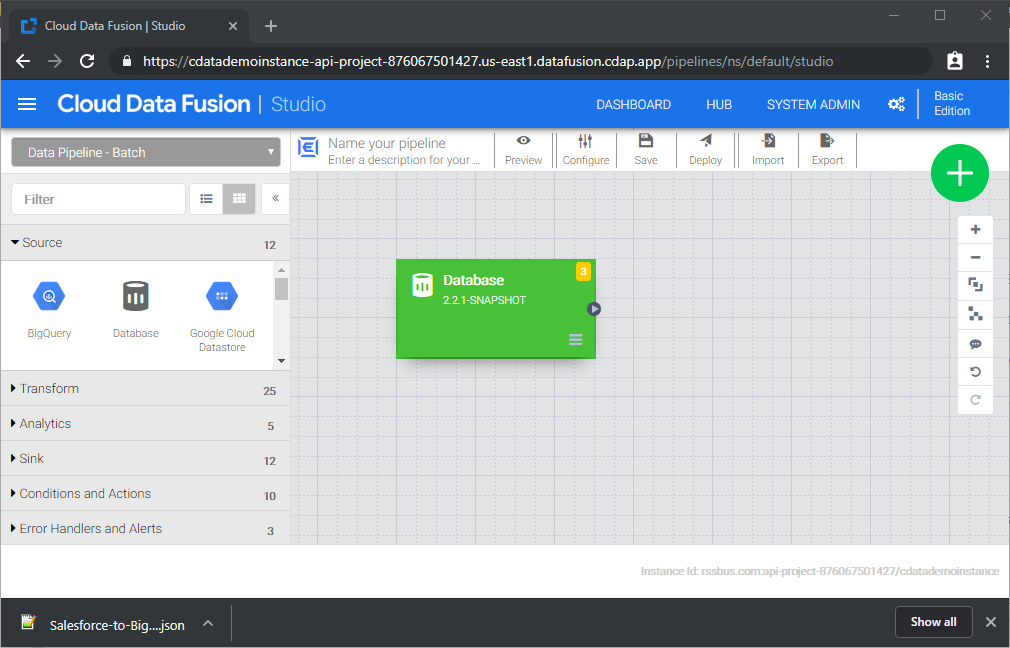
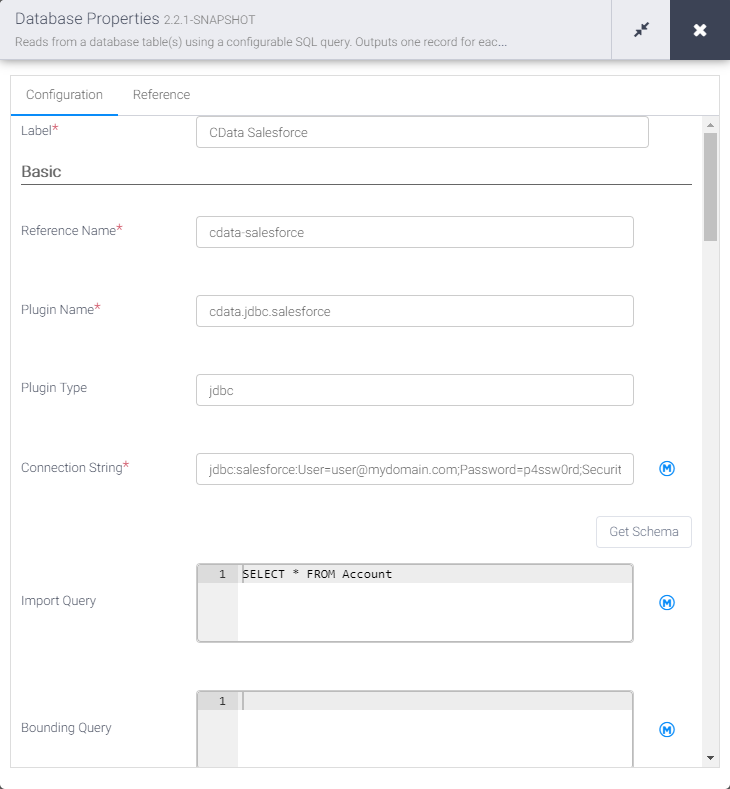
- Database ソースの "Properties" をクリックしてプロパティを編集します
NOTE:Google Data Fusion で JDBC Driver を使用するには、ライセンス(製品版またはトライアル)とランタイムキー(RTK)が必要です。ライセンス(またはトライアル)の取得については、CData までお問い合わせください。
- Label を設定します
- Reference Name を将来の参照用の値に設定します(例:cdata-sagex3cloud)
- Plugin Type を "jdbc" に設定します
- Connection String を Sage X3 Cloud の JDBC URL に設定します。例:
jdbc:sagex3cloud:RTK=5246...;AuthScheme=OAuth;URL=https://x3server/;OAuthAccessTokenUrl=https://auth-domain/oauth/token;OAuthClientId=your_client_id;OAuthClientSecret=your_client_secret;Audience=https://api-audience;XAPIKey=your_api_key;Folder=SEED;Sage X3 Cloud では OAuth 2.0 の Client Credentials フローを使用し、API へのアクセスには X-API-Key も必要です。AuthScheme を OAuth に設定し、以下の接続プロパティを指定します。
- URL:Sage X3 Cloud インスタンスのベース URL。
- OAuthAccessTokenUrl:OAuth トークンエンドポイント(例:https://your-auth-domain/oauth/token)。
- OAuthClientId:OAuth アプリケーションのクライアント ID。
- OAuthClientSecret:OAuth アプリケーションのクライアントシークレット。
- Audience:トークンリクエストで使用する API の Audience 値。
- XAPIKey:Sage X3 Cloud の管理者から提供された X-API-Key。
- Folder:Sage X3 のフォルダ名(例:SEED)。このフォルダがデフォルトのスキーマとして使用されます。
- Folders(オプション):Sage X3 フォルダのカンマ区切りリスト(例:SEED,PERF)。各フォルダが個別のスキーマとして公開されるため、Schema.Table 構文でフォルダをまたいだクエリを実行できます。
ドライバーは Client Credentials フローでアクセストークンを取得し、すべての API リクエストで X-API-Key とあわせて送信します。InitiateOAuth を GETANDREFRESH(デフォルト)に設定しておけば、トークンの取得と更新は自動で行われます。
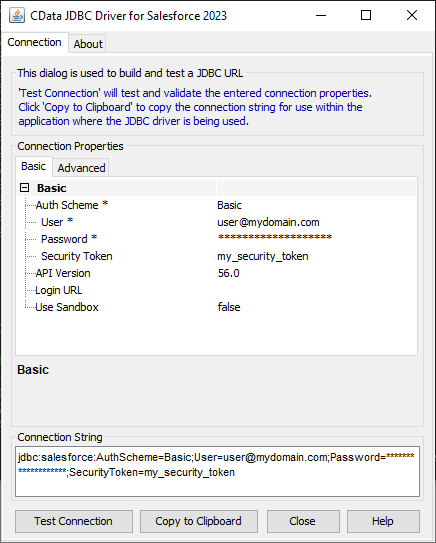
ビルトイン接続文字列デザイナー
JDBC URL の作成には、Sage X3 Cloud JDBC Driver に組み込まれている接続文字列デザイナーを使用できます。JAR ファイルをダブルクリックするか、コマンドラインから JAR ファイルを実行してください。
java -jar cdata.jdbc.sagex3cloud.jar接続プロパティを入力し、接続文字列をクリップボードにコピーします。
- Import Query を Sage X3 Cloud から取得したいデータを抽出する SQL クエリに設定します。例:
SELECT * FROM BPCUSTOMER
- "Sink" タブから、同期先シンクを追加します(この例では Google BigQuery を使用します)
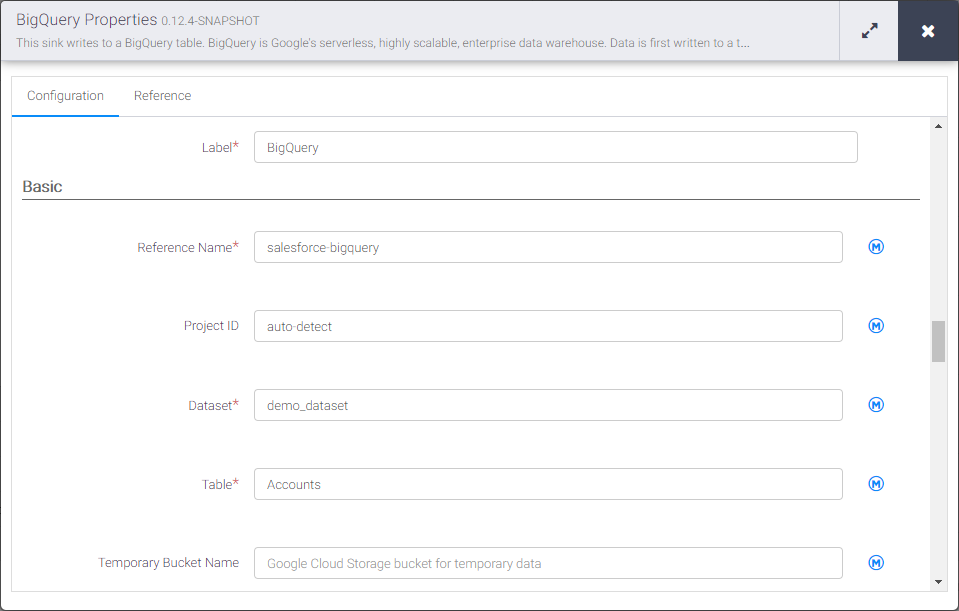
- BigQuery シンクの "Properties" をクリックしてプロパティを編集します
- Label を設定します
- Reference Name を sagex3cloud-bigquery のような値に設定します
- Project ID を特定の Google BigQuery プロジェクト ID に設定します(またはデフォルトの "auto-detect" のままにします)
- Dataset を特定の Google BigQuery データセットに設定します
- Table を Sage X3 Cloud のデータ を挿入するテーブル名に設定します
Source と Sink を設定すると、Sage X3 Cloud のデータ を Google BigQuery にパイプする準備が整います。パイプラインを保存してデプロイしてください。パイプラインを実行すると、Google Data Fusion が Sage X3 Cloud からリアルタイムデータをリクエストし、Google BigQuery にインポートします。
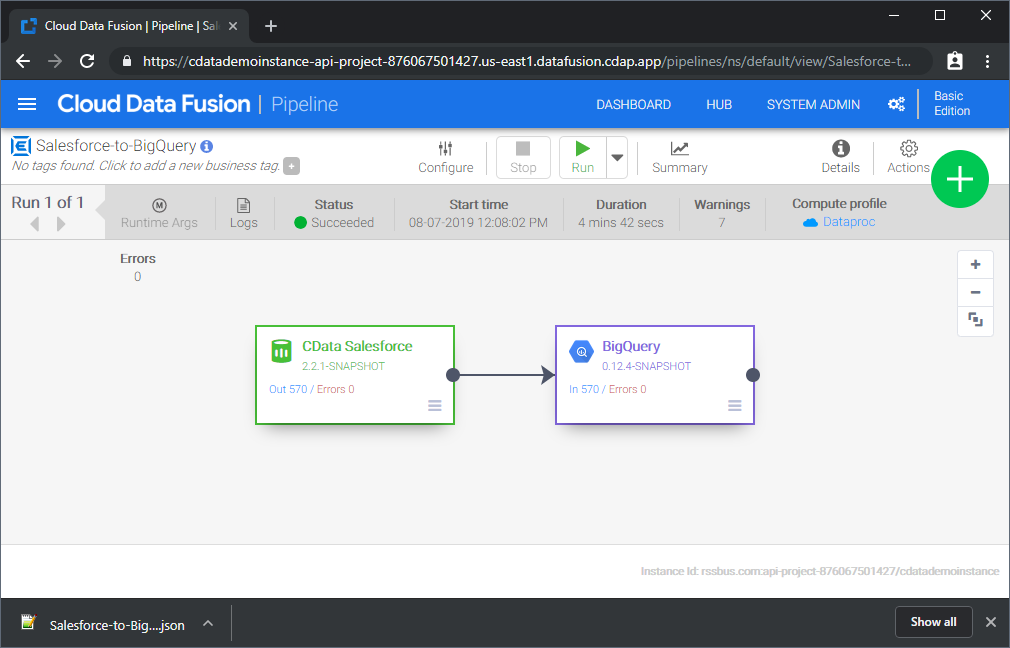
これはシンプルなパイプラインの例ですが、変換、分析、条件などを使用してより複雑な Sage X3 Cloud パイプラインを作成できます。CData JDBC Driver for Sage X3 Cloud の 30日間の無償トライアルをダウンロードして、今すぐ Google Data Fusion で Sage X3 Cloud のデータ をリアルタイムで活用しましょう。
はじめる準備はできましたか?
Sage X3 Cloud Driver の無料トライアルをダウンロードしてお試しください:
ダウンロード