



Google Cloud Data FusionでJD Edwards のパイプラインを構築(Connect AI)
Google Cloud Data Fusion は、ビジュアルインターフェースを使用してさまざまなソースと同期先間でデータを接続、変換、移動できるため、データパイプラインの構築と管理を簡素化します。CData Connect AI と組み合わせることで、ELT/ETL データパイプラインの構築と管理にJD Edwards のデータへのアクセスが可能になります。この記事では、CData Connect AI を使用して JD Edwards へのライブ接続を作成する方法と、Cloud Data Fusion プラットフォームからリアルタイムのJD Edwards のデータに接続・アクセスする方法を説明します。
Cloud Data Fusion 用の JD Edwards 接続を設定
Cloud Data Fusion から JD Edwards への接続は、CData Connect AI によって実現されます。Cloud Data Fusion からJD Edwards のデータを扱うには、まず JD Edwards 接続を作成・設定します。
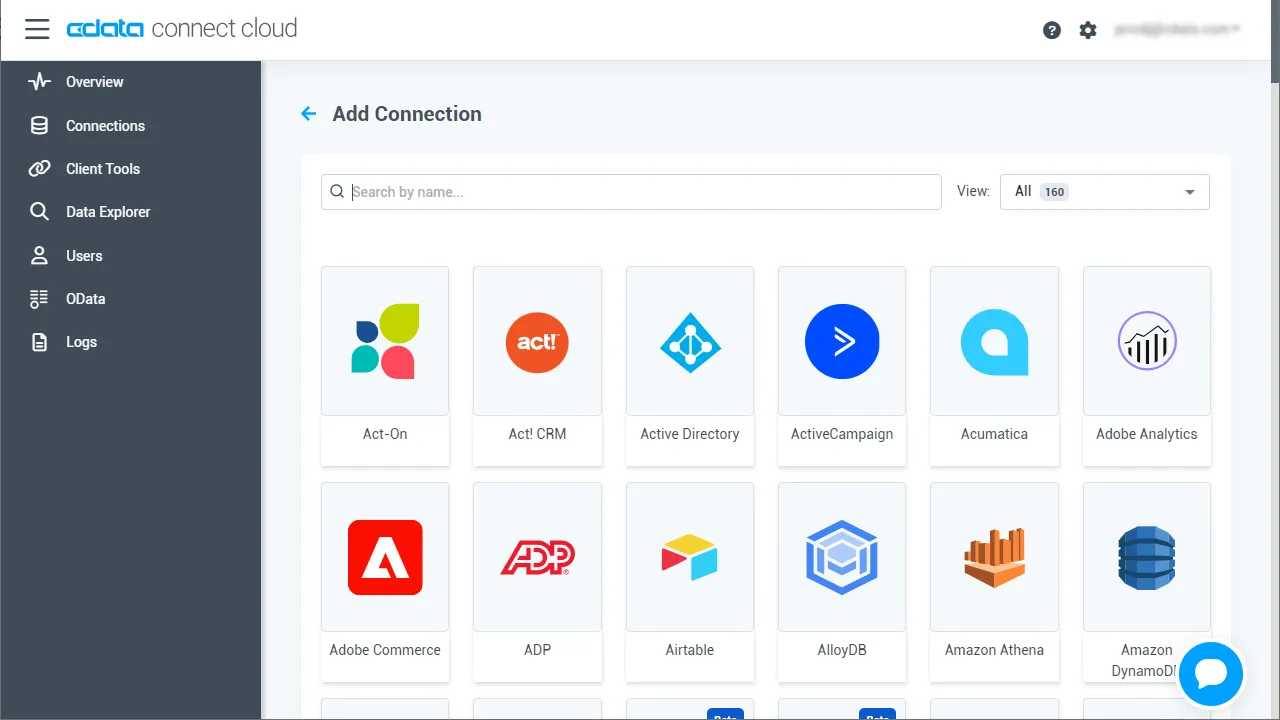
- Connect AI にログインし、Sources をクリック、次に Add Connection をクリック
- Add Connection パネルから「JD Edwards」を選択
-
JD Edwards に接続するために必要な認証プロパティを入力します。
ドライバーは Application Interface Services(AIS)Server を経由して JD Edwards に接続します。以下の接続プロパティを設定します。
- URL:AIS Server のベース HTTPS URL(例:https://jde-ais.example.com:8300)。
- User:JD Edwards のユーザー名。
- Password:JD Edwards のパスワード。
- Environment(オプション):使用する JD Edwards の環境(例:本番環境なら PD920、開発環境なら DV920)。指定しない場合は、AIS Server のデフォルト環境が使用されます。
- Role(オプション):セッションで使用する JD Edwards のロール。指定しない場合は、AIS Server のデフォルトロールが使用されます。
- DeviceName(オプション):接続元のデバイスまたはアプリケーションの識別子。AIS Server での監査やログ記録に使用されます。
- Jasserver(オプション):リクエストのルーティング先となる Java Application Server(JAS)インスタンス。クラスタ環境で便利です。
公開するデータの選択
JD Edwards ではテーブルとビジネスビューが System Code ごとに整理されており、ドライバーは各 System Code をそれぞれ個別のスキーマとして公開します。利用できるスキーマは、以下のプロパティで制御できます。
- DataModel:System Code をスキーマとして公開する ERP モジュール(カンマ区切りで複数指定可)。接続先インスタンスのすべての System Code を公開する場合は All を指定します。デフォルトは FinancialManagement です。
- SystemCodes:DataModel の System Code に加えて公開したい System Code のカンマ区切りリスト(例:42,43)。
接続時、ドライバーは認証情報を AIS Server に送信してセッショントークンを取得し、キャッシュします。セッションの有効期限が切れる前に、新しいトークンが自動でリクエストされます。
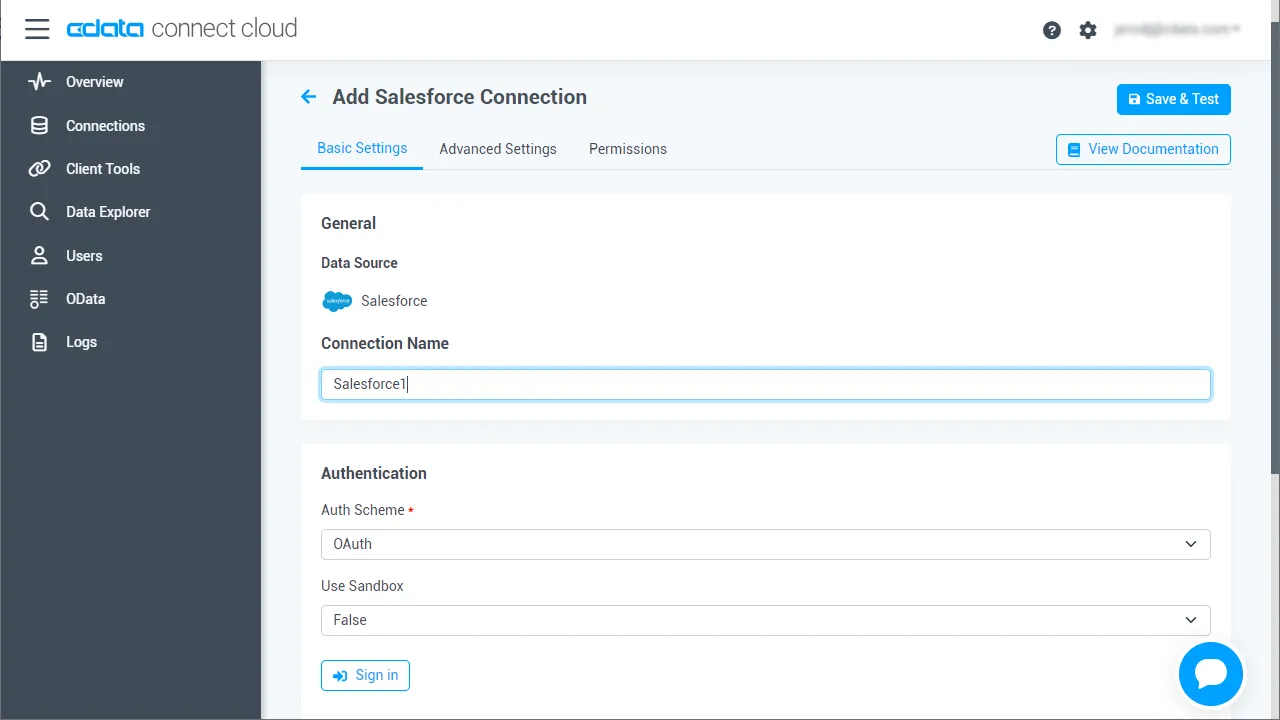
- Save & Test をクリック
-
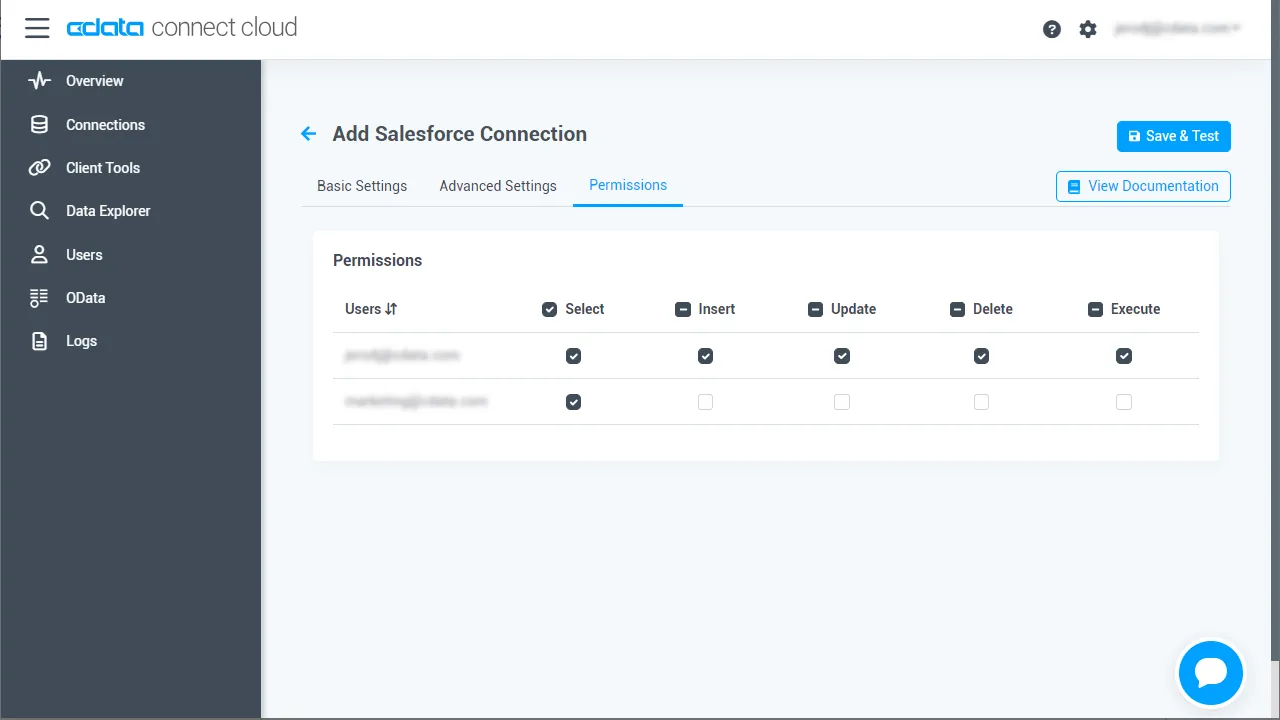
Add JD Edwards Connection ページで Permissions タブに移動し、ユーザーベースの権限を更新します。
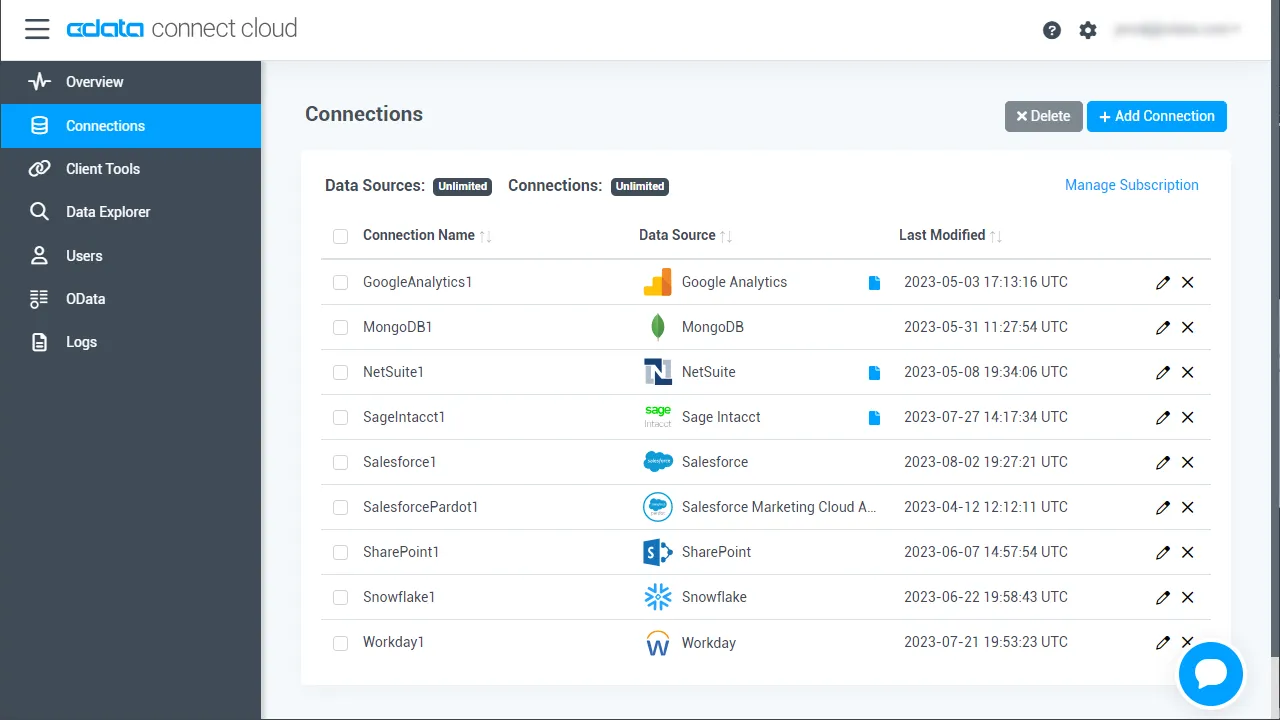
Personal Access Token を追加
REST API、OData API、または仮想 SQL Server 経由で Connect AI に接続する場合、Personal Access Token(PAT)が Connect AI への接続認証に使用されます。アクセスの粒度を維持するため、サービスごとに個別の PAT を作成することをお勧めします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして Settings ページを開きます。
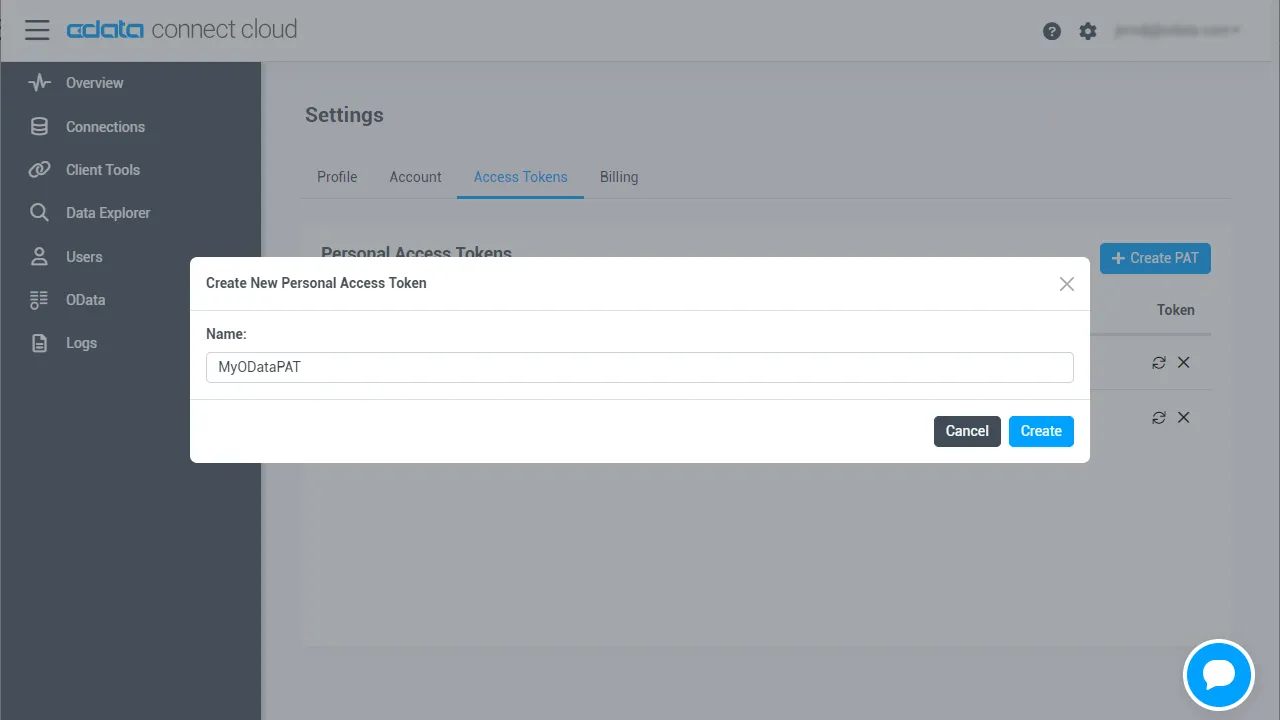
- Settings ページで Access Tokens セクションに移動し、 Create PAT をクリック。
-
PAT に名前を付けて Create をクリック。
- Personal Access Token は作成時にのみ表示されるので、必ずコピーして安全な場所に保存してください。
接続の設定と PAT の生成が完了したら、Cloud Data Fusion からJD Edwards のデータに接続する準備が整いました。
Cloud Data Fusion から JD Edwards に接続
以下の手順に従って、CData Connect AI JDBC ドライバーを介して Cloud Data Fusion から JD Edwards への接続を確立します:
- CData Connect AI JDBC ドライバーをダウンロード・インストール:
- CData Connect AI の Integrations ページを開きます。
- JDBC を検索・選択します。
- セットアップファイルをダウンロードして実行します。
- インストールが完了したら、インストールディレクトリ(例:C:\Program Files\CData\JDBC Driver for CData Connect\lib)から JAR ファイル(cdata.jdbc.connect.jar)をコピーします。
- Cloud Data Fusion にログイン。
- 右上の緑色の「+」ボタンをクリックしてエンティティを追加。
- Driver の下で Upload をクリック。
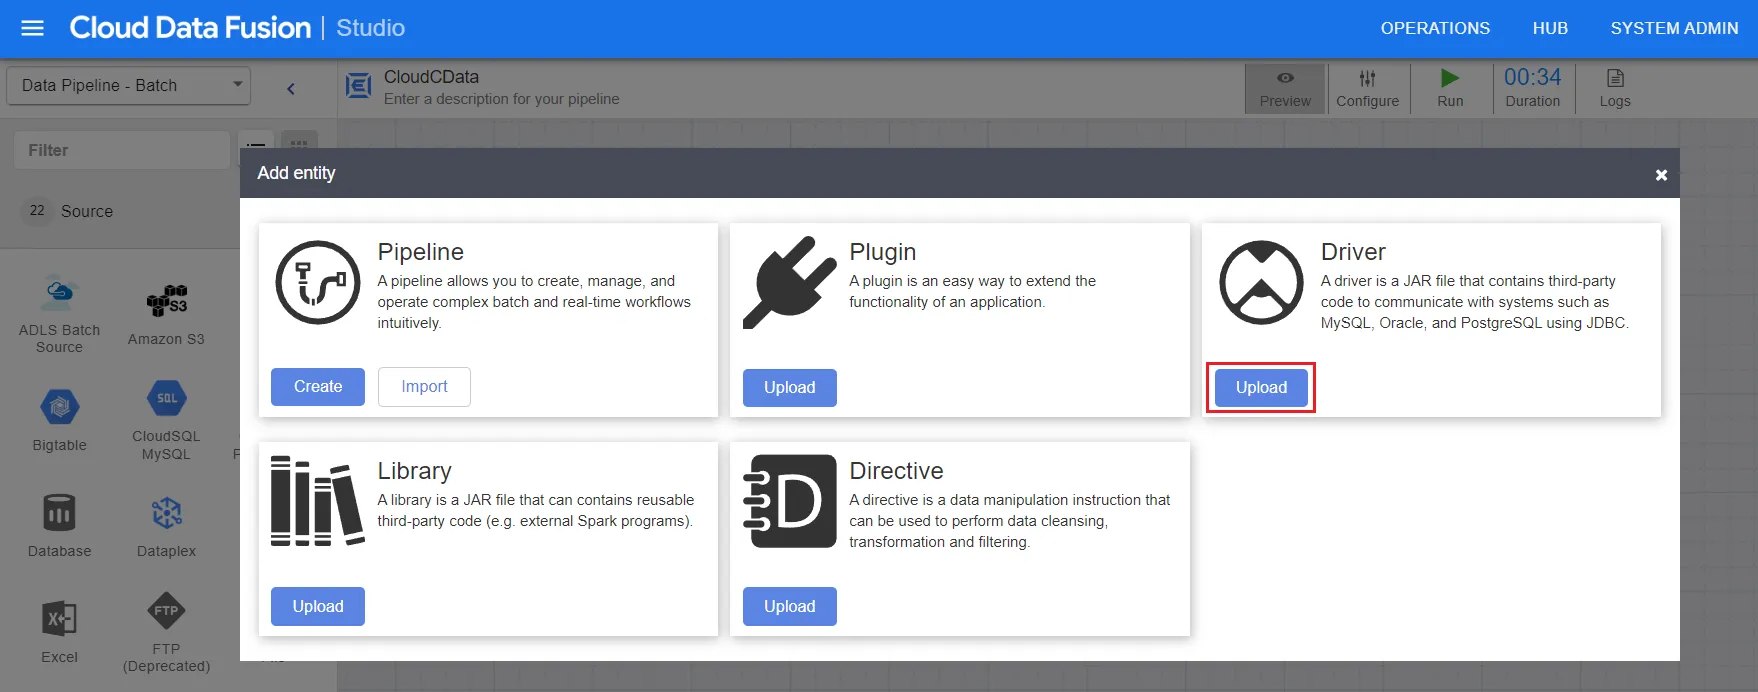
- CData Connect AI JDBC ドライバー(JAR ファイル)をアップロード。
- ドライバー設定を入力:
- Name:ドライバー名を入力
- Class name:「cdata.jdbc.connect.ConnectDriver」 と入力
- Version:ドライバーのバージョンを入力
- Description(オプション):ドライバーの説明を入力
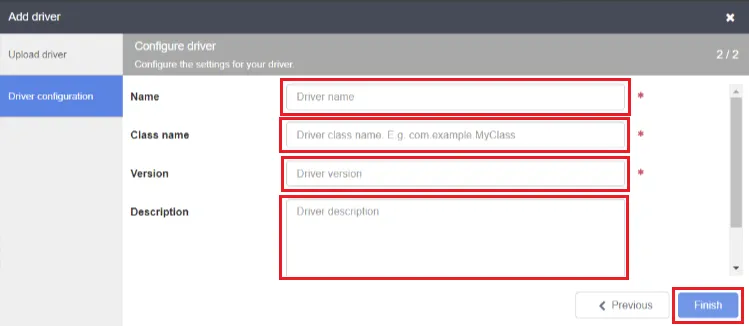
- Finish をクリック。
- ソース設定を入力:
- Label:接続を識別するための名前
- JDBC driver name:ステップ 6 で設定したドライバーを識別する JDBC ドライバー名を入力
- Connection string:JDBC 接続文字列を入力(例:
jdbc:connect:AuthScheme=Basic;user=username;password=PAT; - User:CData Connect AI のユーザー名(CData Connect AI インターフェースの右上に表示)を入力(例:「[email protected]」)
- Password:Settings ページで生成した PAT を入力
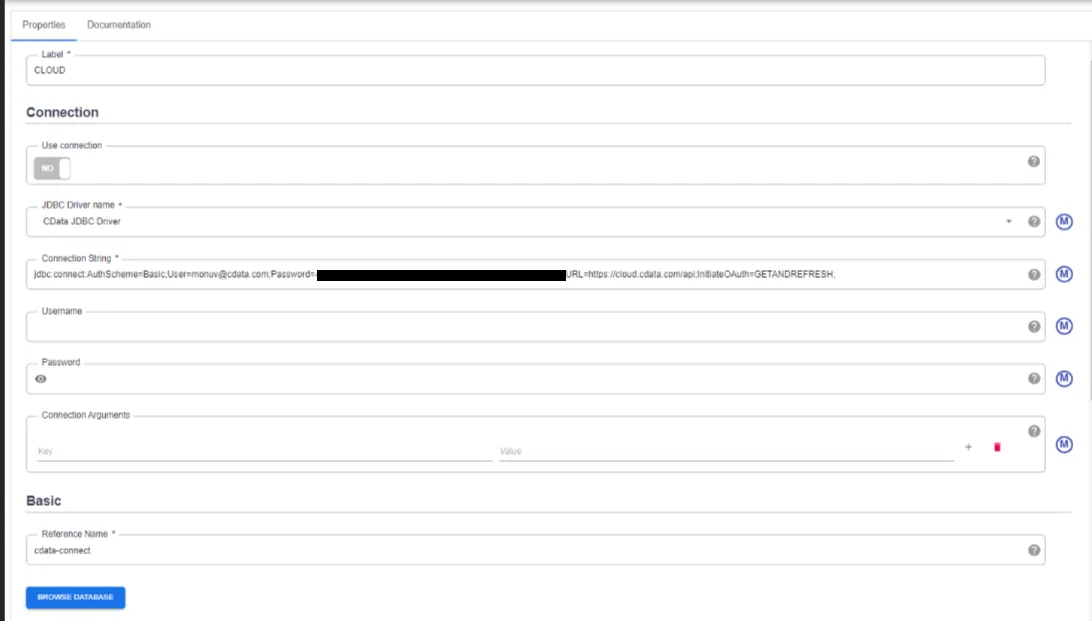
- 右上の Validate をクリック。
- 接続が成功したら、UI を通じてパイプラインを編集・管理できます。
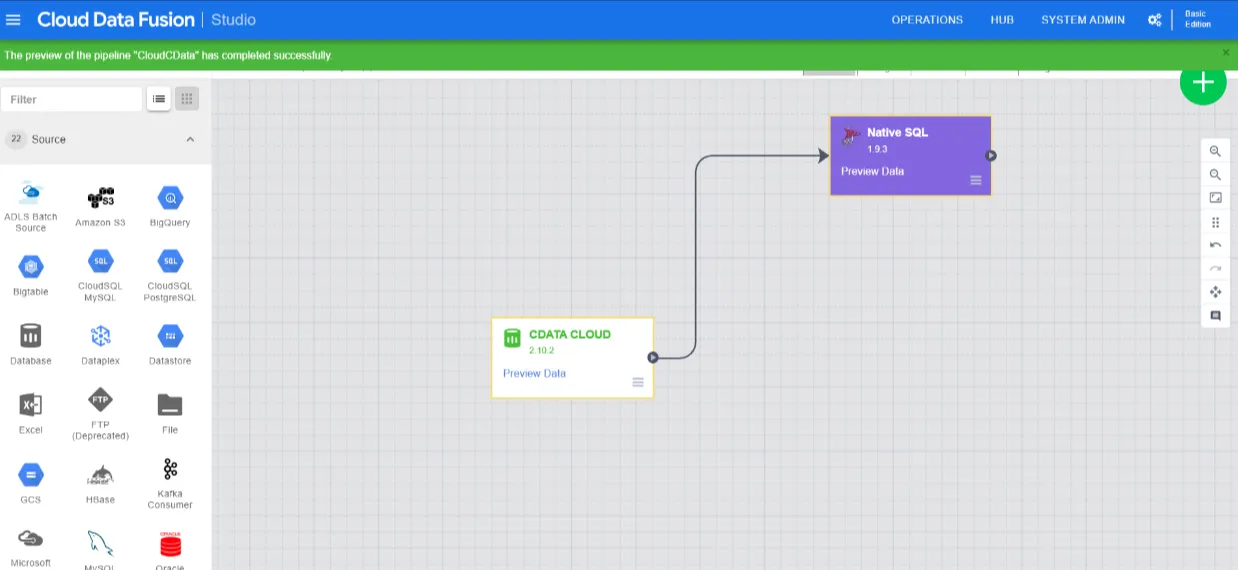
- 作成したパイプラインを実行。
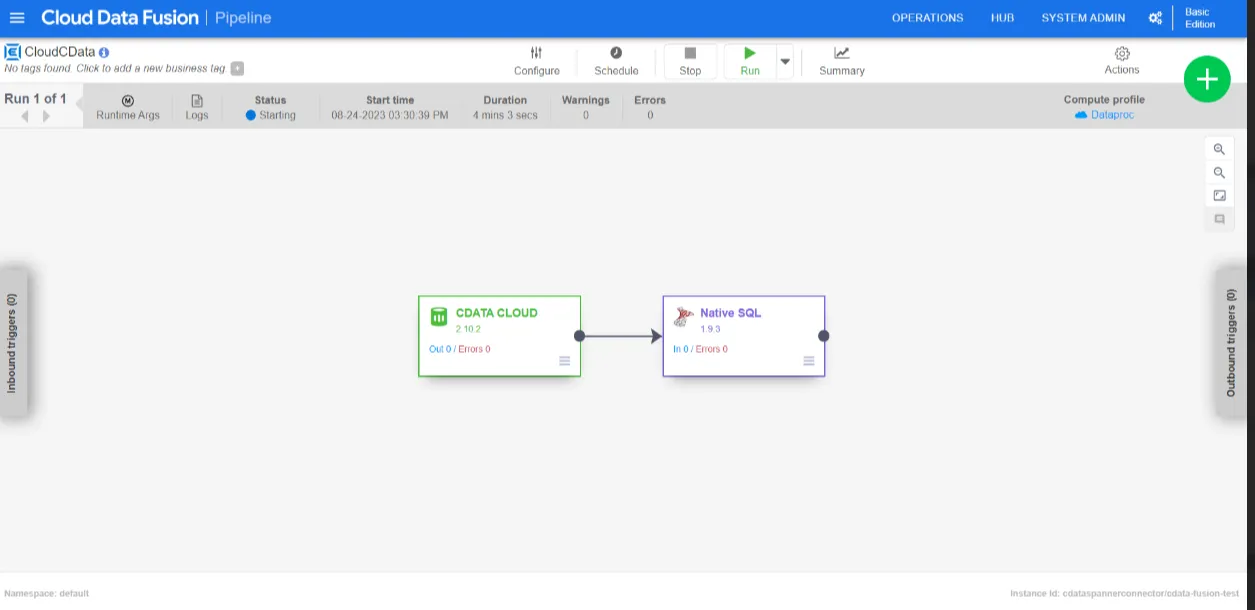
トラブルシューティング
Cloud Data Fusion では、ソースデータの 「int」 型が自動的に 「long」 にキャストされる既知の問題があることにご注意ください。
クラウドアプリケーションから JD Edwards のデータ へのリアルタイムアクセス
これで、Google Cloud Data Fusion からリアルタイムのJD Edwards のデータへの直接接続が確立されました。JD Edwards のデータ をレプリケーションすることなく、さまざまなソースと同期先間でデータをスムーズに移動できる接続を追加作成し、データ統合プロセスを効率化できます。
クラウドアプリケーションから JD Edwards を含む 数百種類の SaaS、ビッグデータ、NoSQL ソースへのリアルタイムデータアクセスについては、CData Connect AI をご覧ください。