



JD Edwards のデータにPythonで接続する方法|CData Connect AI SDK
CData Connect AI Python SDK を使うと、標準的なDB-API 2.0のPythonコードでJD Edwards のデータをそのまま読み書きできます。プログラミング不要の他ツールと異なり、pandasやpetlなど既存のPythonエコシステムにそのまま組み込めます。パッケージのインストールからクエリ実行まで3ステップで完了します。
CData Connect AI Python SDK(cdata-connect-ai)は DB-API 2.0(PEP 249)に準拠したクライアントで、標準的な Python のデータベースコードでリアルタイムのJD Edwards のデータを取得・操作できます。接続まわりは Connect AI が引き受けてくれるので、パッケージを1つインストールしてパーソナルアクセストークンで認証するだけで、JD Edwards(および Connect AI に接続済みのその他すべてのソース)にクエリを実行できます。しかも sqlite3 や psycopg2 といったライブラリでおなじみの connect() / cursor() / fetchall() という同じパターンをそのまま使えます。
この記事では、Connect AI で JD Edwards に接続し、パーソナルアクセストークンを生成して SDK をインストールし、リアルタイムのJD Edwards のデータを読み取る(対応している場合は書き込む)までの流れをご紹介します。
事前準備
- CData Connect AI のアカウント
- Python 3.8 以降
- 有効な認証情報を持つアクティブな JD Edwards アカウント
Connect AI で JD Edwards に接続する方法は?
CData Connect AI では、直感的なクリック操作ベースのインターフェースでデータソースに接続できます。
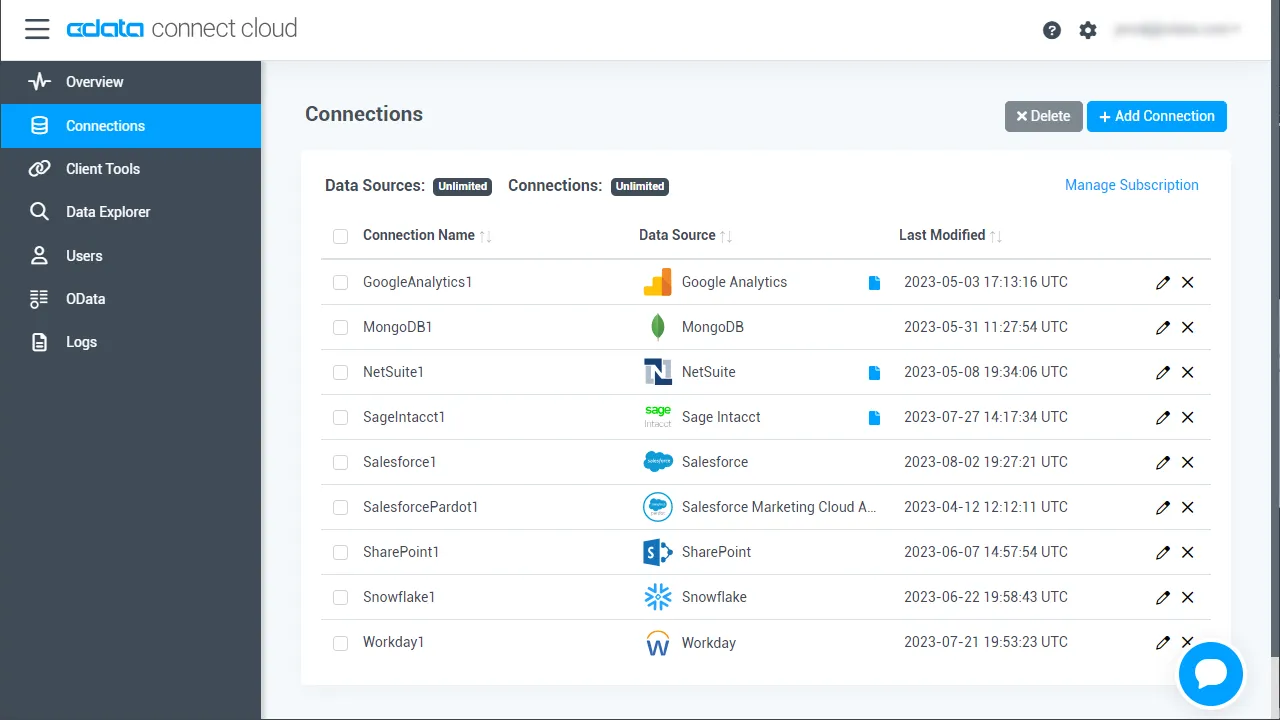
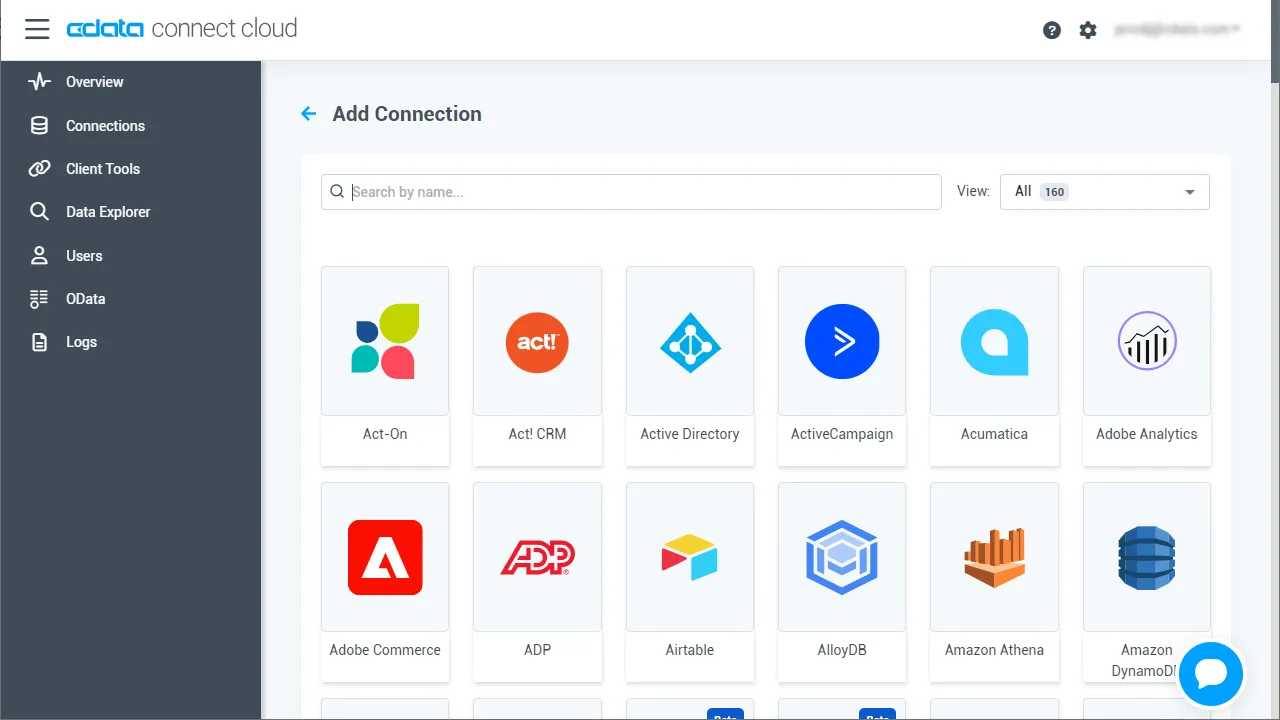
- Connect AI にログインし、Sources をクリックして、 Add Connection をクリックします
- 「Add Connection」パネルから「JD Edwards」を選択します
-
JD Edwards に接続するために必要な認証プロパティを入力します。
ドライバーは Application Interface Services(AIS)Server を経由して JD Edwards に接続します。以下の接続プロパティを設定します。
- URL:AIS Server のベース HTTPS URL(例:https://jde-ais.example.com:8300)。
- User:JD Edwards のユーザー名。
- Password:JD Edwards のパスワード。
- Environment(オプション):使用する JD Edwards の環境(例:本番環境なら PD920、開発環境なら DV920)。指定しない場合は、AIS Server のデフォルト環境が使用されます。
- Role(オプション):セッションで使用する JD Edwards のロール。指定しない場合は、AIS Server のデフォルトロールが使用されます。
- DeviceName(オプション):接続元のデバイスまたはアプリケーションの識別子。AIS Server での監査やログ記録に使用されます。
- Jasserver(オプション):リクエストのルーティング先となる Java Application Server(JAS)インスタンス。クラスタ環境で便利です。
公開するデータの選択
JD Edwards ではテーブルとビジネスビューが System Code ごとに整理されており、ドライバーは各 System Code をそれぞれ個別のスキーマとして公開します。利用できるスキーマは、以下のプロパティで制御できます。
- DataModel:System Code をスキーマとして公開する ERP モジュール(カンマ区切りで複数指定可)。接続先インスタンスのすべての System Code を公開する場合は All を指定します。デフォルトは FinancialManagement です。
- SystemCodes:DataModel の System Code に加えて公開したい System Code のカンマ区切りリスト(例:42,43)。
接続時、ドライバーは認証情報を AIS Server に送信してセッショントークンを取得し、キャッシュします。セッションの有効期限が切れる前に、新しいトークンが自動でリクエストされます。
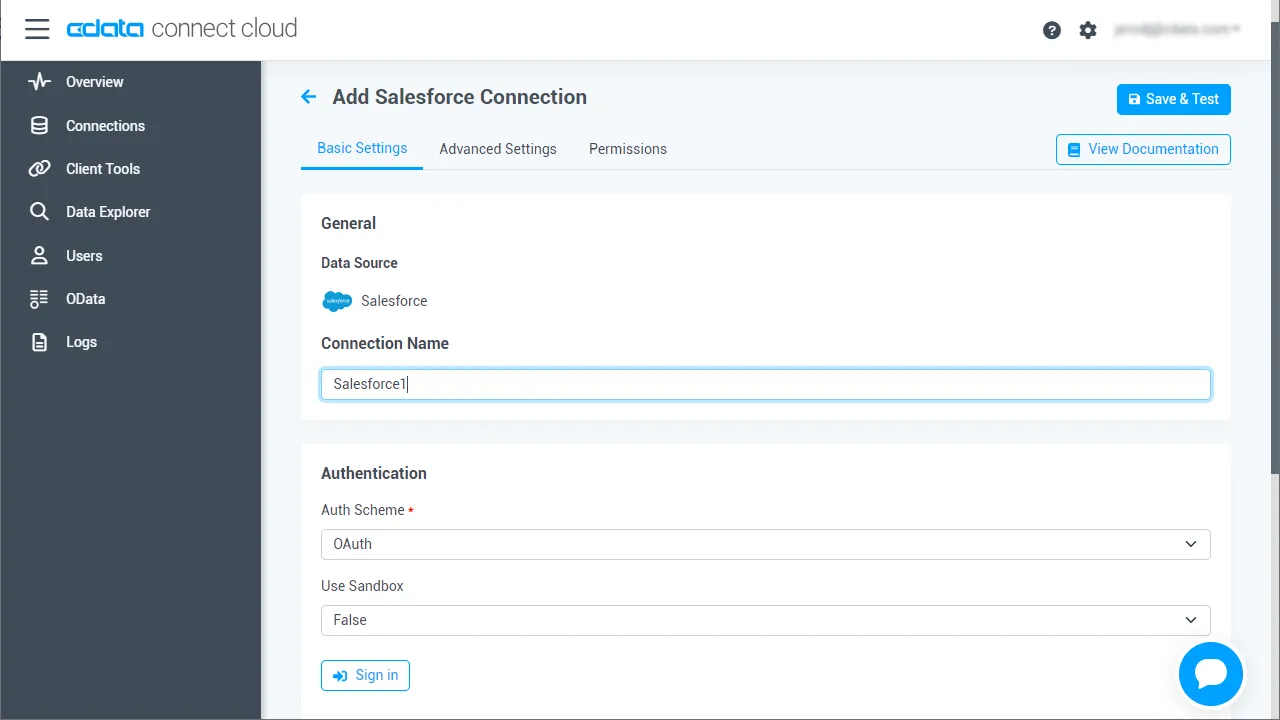
- 「Save & Test」をクリックします
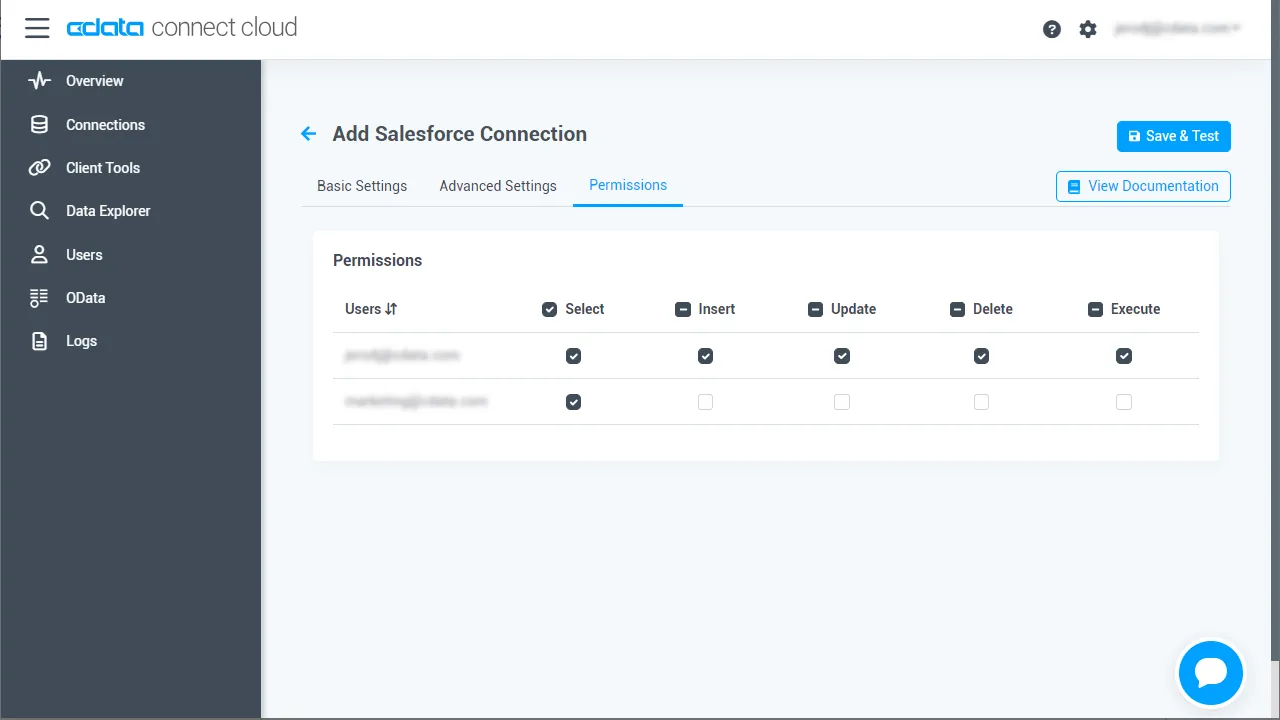
- 「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークン(PAT)を生成する
Python SDK は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使って Connect AI に認証します。アクセスの粒度を保つために、アプリケーションごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
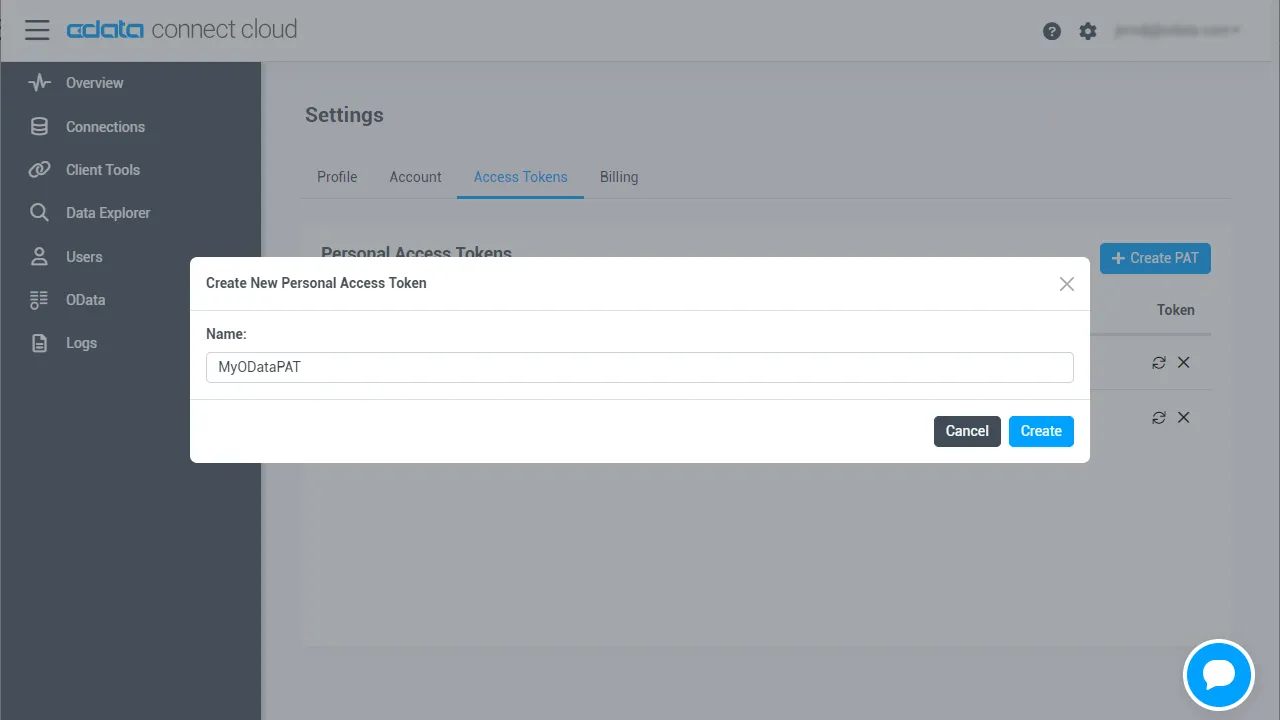
- 設定ページの Access Tokens セクションに移動し、 Create PAT をクリックします。
- PAT に名前を付けて Create をクリックします。
- パーソナルアクセストークンは作成時にのみ表示されます。必ずコピーして安全な場所に保管してください。
SDK をインストールする
pip を使って PyPI から SDK をインストールします。
pip install cdata-connect-ai
接続して最初のクエリを実行する
アカウントのメールアドレスと PAT で接続したら、sys_tables にクエリを実行して、接続済みのソース全体で利用可能なテーブルを確認してみましょう。Connect AI の識別子は <Connection>.<Schema>.<Table> という3つの部分で構成されており、接続名はデフォルトでソース名(例:JDEdwards1)になります。
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)
cur = conn.cursor()

# Discover what's available across your connected sources
cur.execute("SELECT CatalogName, SchemaName, TableName FROM sys_tables LIMIT 25")

for row in cur.fetchall():
    print(row)
結果から任意のテーブルを選び、直接クエリを実行してみましょう。
cur.execute(
    "SELECT DocumentNumber, Amount "
    "FROM [JDEdwards1].[JDEdwards].[AccountsPayable.AccountLedger] "
    "LIMIT 10"
)

for row in cur.fetchall():
    print(row)
JD Edwards は Connect AI では読み取り専用のソースのため、SDK はクエリには対応していますが、INSERT、UPDATE、DELETE には対応していません。作業が終わったら接続を閉じましょう。
conn.close()
これがワークフローのすべてです。パッケージが1つ、PAT、そして標準的な DB-API 呼び出しだけ。SDK は通常の DB-API 接続を返すので、Python のデータエコシステムのほかのツールにもそのまま組み込めます。ここから先は、この同じ接続を使って、JD Edwards のデータを pandas に読み込んだり、petl で ETL パイプラインを構築したり、Dash の Web アプリを動かしたりできます。
関連情報と無料トライアル
これで、CData Connect AI Python SDK を通じて Python からリアルタイムのJD Edwards のデータをクエリできるようになりました。JD Edwards(および数百種類のその他のデータソース)への接続について詳しくは、Connect AI のページをご覧ください。
CData Connect AI の詳細、または無料トライアルにお申し込みください: