



Apache Spark でSage X3 Cloud のデータをSQL で操作する方法

Apache Spark は大規模データ処理のための高速エンジンです。CData JDBC Driver for SageX3Cloud と組み合わせると、Spark はリアルタイムでSage X3 Cloud のデータに連携して処理ができます。本記事では、Spark シェルに接続してSage X3 Cloud をクエリする方法について解説します。
CData JDBC Driver は、最適化されたデータ処理がドライバーに組み込まれているため、リアルタイムSage X3 Cloud と対話するための高いパフォーマンスを提供します。Sage X3 Cloud に複雑なSQL クエリを発行すると、ドライバーはフィルタや集計など、サポートされているSQL操作を直接Sage X3 Cloud にプッシュし、組込みSQL エンジンを使用してサポートされていない操作(SQL 関数やJOIN 操作)をクライアント側で処理します。組み込みの動的メタデータクエリを使用すると、ネイティブデータ型を使用してSage X3 Cloud を操作して分析できます。
CData JDBC Driver for SageX3Cloud をインストール
まずは、本記事右側のサイドバーからSageX3Cloud JDBC Driver の無償トライアルをダウンロード・インストールしてください。30日間無償で、製品版の全機能が使用できます。
Spark Shell を起動してSage X3 Cloud のデータに接続
- ターミナルを開き、Spark shell でCData JDBC Driver for SageX3Cloud JAR file をjars パラメータに設定します:
$ spark-shell --jars /CData/CData JDBC Driver for SageX3Cloud/lib/cdata.jdbc.sagex3cloud.jar - Shell でJDBC URL を使ってSage X3 Cloud に接続し、SQL Context load() function でテーブルを読み込みます。
Sage X3 Cloud では OAuth 2.0 の Client Credentials フローを使用し、API へのアクセスには X-API-Key も必要です。AuthScheme を OAuth に設定し、以下の接続プロパティを指定します。
- URL:Sage X3 Cloud インスタンスのベース URL。
- OAuthAccessTokenUrl:OAuth トークンエンドポイント(例:https://your-auth-domain/oauth/token)。
- OAuthClientId:OAuth アプリケーションのクライアント ID。
- OAuthClientSecret:OAuth アプリケーションのクライアントシークレット。
- Audience:トークンリクエストで使用する API の Audience 値。
- XAPIKey:Sage X3 Cloud の管理者から提供された X-API-Key。
- Folder:Sage X3 のフォルダ名(例:SEED)。このフォルダがデフォルトのスキーマとして使用されます。
- Folders(オプション):Sage X3 フォルダのカンマ区切りリスト(例:SEED,PERF)。各フォルダが個別のスキーマとして公開されるため、Schema.Table 構文でフォルダをまたいだクエリを実行できます。
ドライバーは Client Credentials フローでアクセストークンを取得し、すべての API リクエストで X-API-Key とあわせて送信します。InitiateOAuth を GETANDREFRESH(デフォルト)に設定しておけば、トークンの取得と更新は自動で行われます。
組み込みの接続文字列デザイナー
JDBC 接続文字列URL の作成には、Sage X3 Cloud JDBC Driver にビルトインされたデザイナを使用できます。JAR ファイルをダブルクリックするか、コマンドラインでJAR ファイルを実行するとデザイナが開きます。
java -jar cdata.jdbc.sagex3cloud.jar接続プロパティを入力し、接続文字列をクリップボードにコピーします。
scala> val sagex3cloud_df = spark.sqlContext.read.format("jdbc").option("url", "jdbc:sagex3cloud:AuthScheme=OAuth;URL=https://x3server/;OAuthAccessTokenUrl=https://auth-domain/oauth/token;OAuthClientId=your_client_id;OAuthClientSecret=your_client_secret;Audience=https://api-audience;XAPIKey=your_api_key;Folder=SEED;").option("dbtable","BPCUSTOMER").option("driver","cdata.jdbc.sagex3cloud.SageX3CloudDriver").load() - 接続が完了し、データがロードされたら、テーブルスキーマが表示されます。
Sage X3 Cloud をテンポラリーテーブルとして登録します:
scala> sagex3cloud_df.registerTable("bpcustomer")-
データに対して、次のようなカスタムSQL クエリを実行します。
scala> sagex3cloud_df.sqlContext.sql("SELECT BPCNUM, BPCNAM FROM BPCUSTOMER WHERE BPCNUM = MARTIN").collect.foreach(println)コンソールで、次のようなSage X3 Cloud のデータを取得できました!これでSage X3 Cloud との連携は完了です。
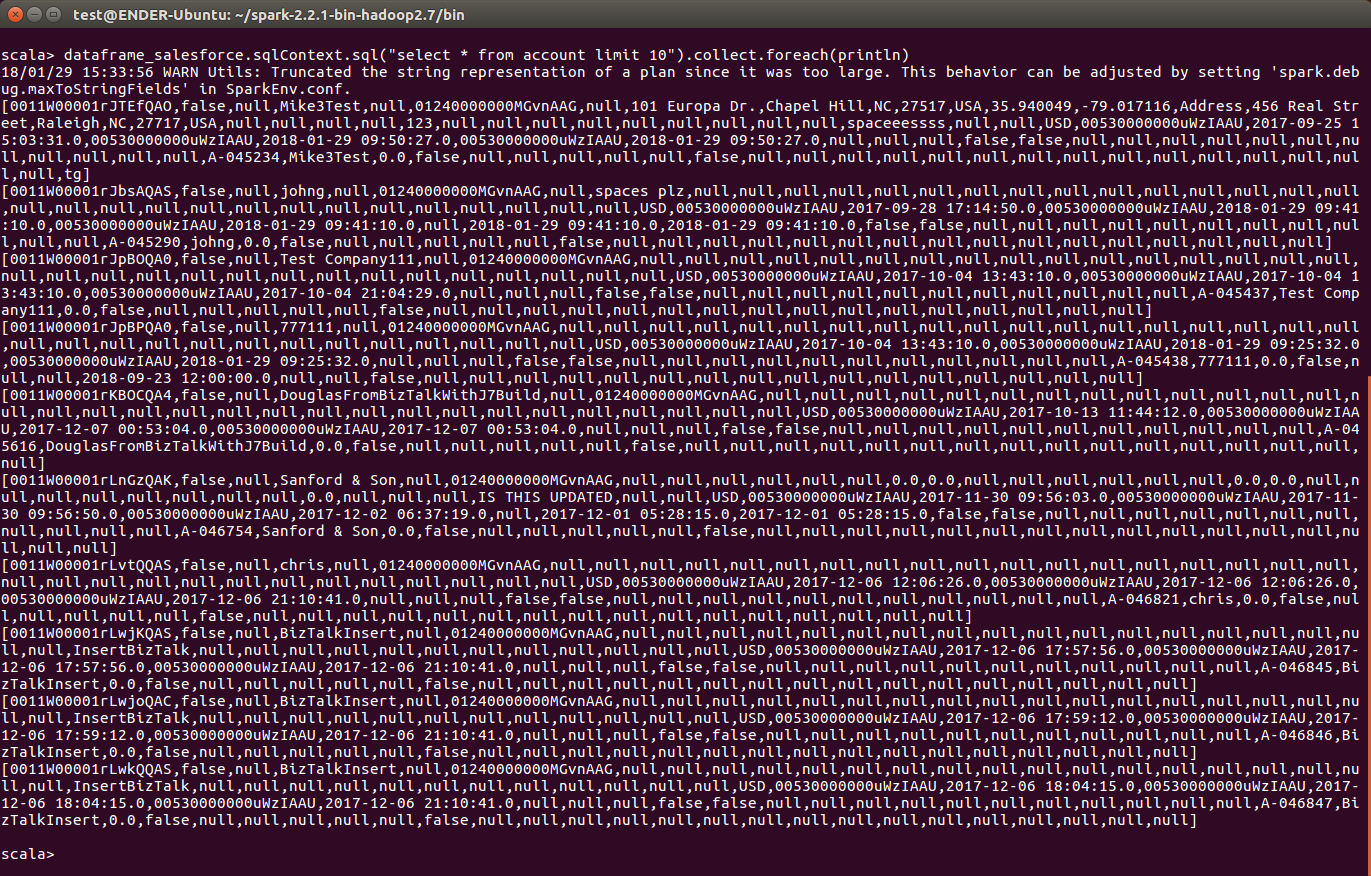
CData JDBC Driver for SageX3Cloud をApache Spark で使って、Sage X3 Cloud に対して、複雑かつハイパフォーマンスなクエリを実行できます。30日の無償評価版 をダウンロードしてぜひお試しください。
Apache Spark の設定
はじめる準備はできましたか?
Sage X3 Cloud Driver の無料トライアルをダウンロードしてお試しください:
ダウンロード