はじめに
こんにちは!コンテンツチームの加藤です。
突然ですが、「ETL」という言葉を耳にしたことはありますか?データの統合と管理はデータ活用・分析の基盤となる部分ですが、ETL(Extract = 抽出、Transform = 変換、Load = ロード)は、データ統合の際に欠かせない処理の1つです。データ(分析)基盤構築において最も重要なプロセスであり、企業のデータ活用を成功に導く鍵となります。この記事では、ETL の仕組みから代表的なツールの比較、ELT との違いや使い分け、業界別の導入事例など、ETL の包括的な理解にかかせないトピックを初心者の方にもわかりやすく解説していきます!
この記事で分かること
ETLとは?基本概念を理解しよう
ETLとは、複数のデータソースからデータを抽出(Extract)し、分析や業務に適した形式に変換(Transform)したうえで、データウェアハウスなどの統合基盤に格納(Load)する処理です。SaaSやデータベースなど複数システムに散らばるデータを一か所にまとめ、BIツールでの分析やレポーティングに使える状態にします。
ETLは単なるデータ移行ツールではなく、生データをデータアナリストやデータサイエンティストが活用できる状態にする上で重要な役割を果たすデータ統合の中心となる技術です。企業がデータドリブンな意思決定を行うためには、このETLプロセスが不可欠となります。たとえば、ETLで整備したデータマートをもとに経営指標をリアルタイムで可視化するBIダッシュボードを構築すれば、意思決定のスピードを大きく高められます。CData SyncはTableauやPower BIなど主要なBIツールとの連携実績も豊富です。
なぜ今ETLが注目されているのか?
業務でのデータ活用が浸透し、企業が扱うデータ量は爆発的に増加しています。各部門が使うさまざまなシステムやアプリケーションから生成されるデータを効率的に統合し、分析可能な形に変換するためには、効果的なETL プロセスが必要不可欠です。ETL を適切に実装することで、企業は以下のような恩恵を受けることができます。
複数のデータソースからの情報を一元管理
データの品質と一貫性の確保
データ分析・活用の効率化
データに基づいた迅速な意思決定
こうしたデータ統合そのものの意義や導入メリットをさらに詳しく知りたい方は、データ統合とは?導入メリットを事例つきで解説もあわせてご覧ください。それでは、実際にETL の仕組みを紐解いていきましょう!
ETLの歴史:バッチ処理からELTの登場まで
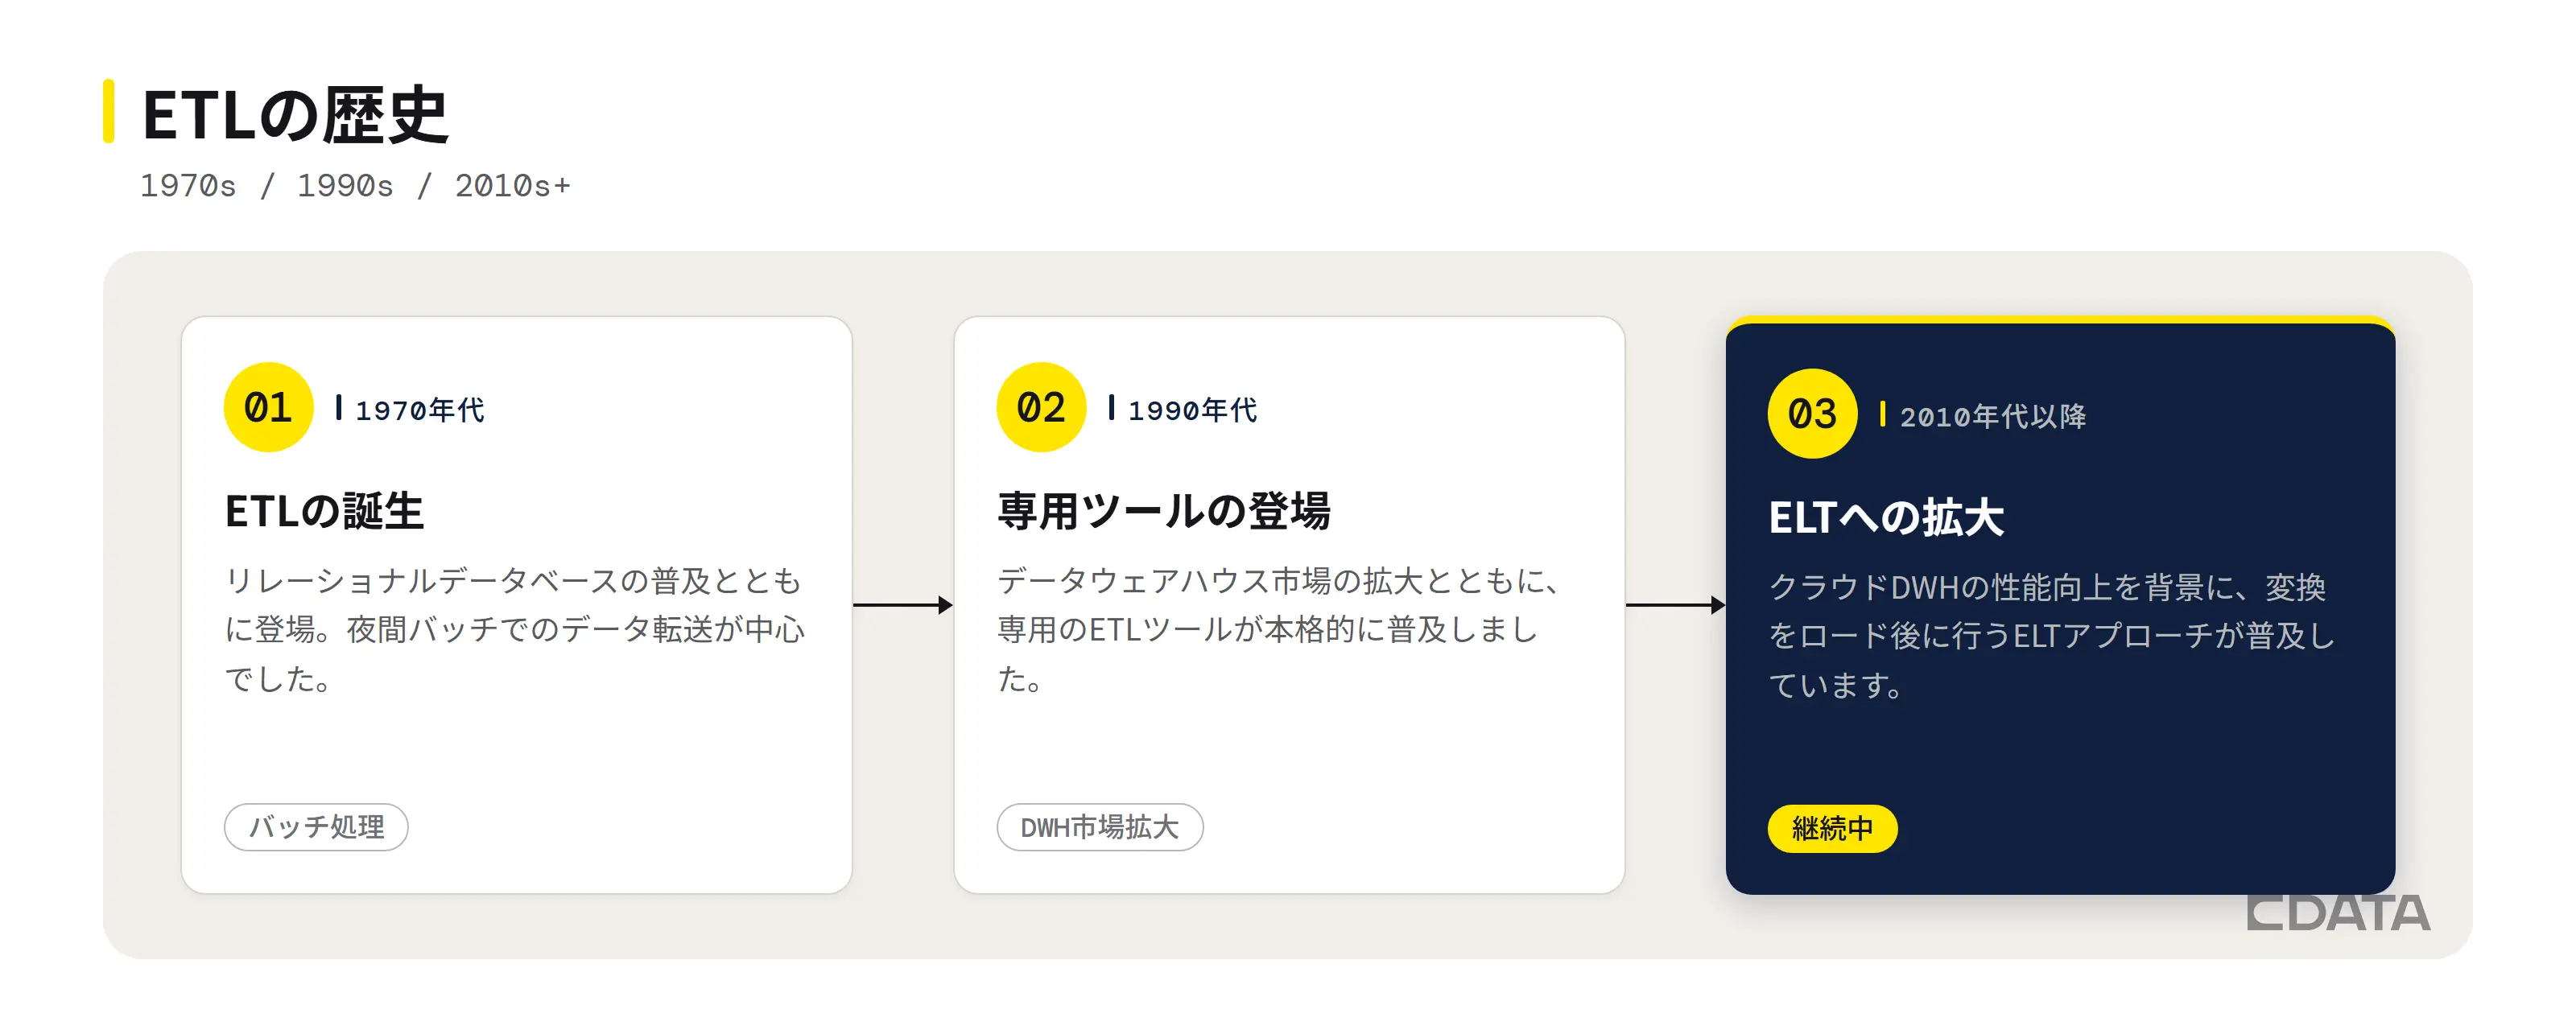
ETLという概念自体は、1970年代にリレーショナルデータベースが普及し始めた頃から存在します。当初は夜間バッチでのデータ転送が中心でしたが、専用のETLツールが本格的に登場したのは1990年代のデータウェアハウス市場拡大以降です。
2010年代以降はクラウドデータウェアハウスの処理性能向上を背景に、変換をロード後に行うELTアプローチが急速に普及しました。現在では、企業の要件に応じてETLとELTを使い分ける、あるいは組み合わせる運用が一般的になっています。CData Sync のようなノーコードツールの登場により、こうした変遷がもたらす恩恵を専門知識がなくても享受できるようになりました。
ETLの仕組み:3つのステップで理解する
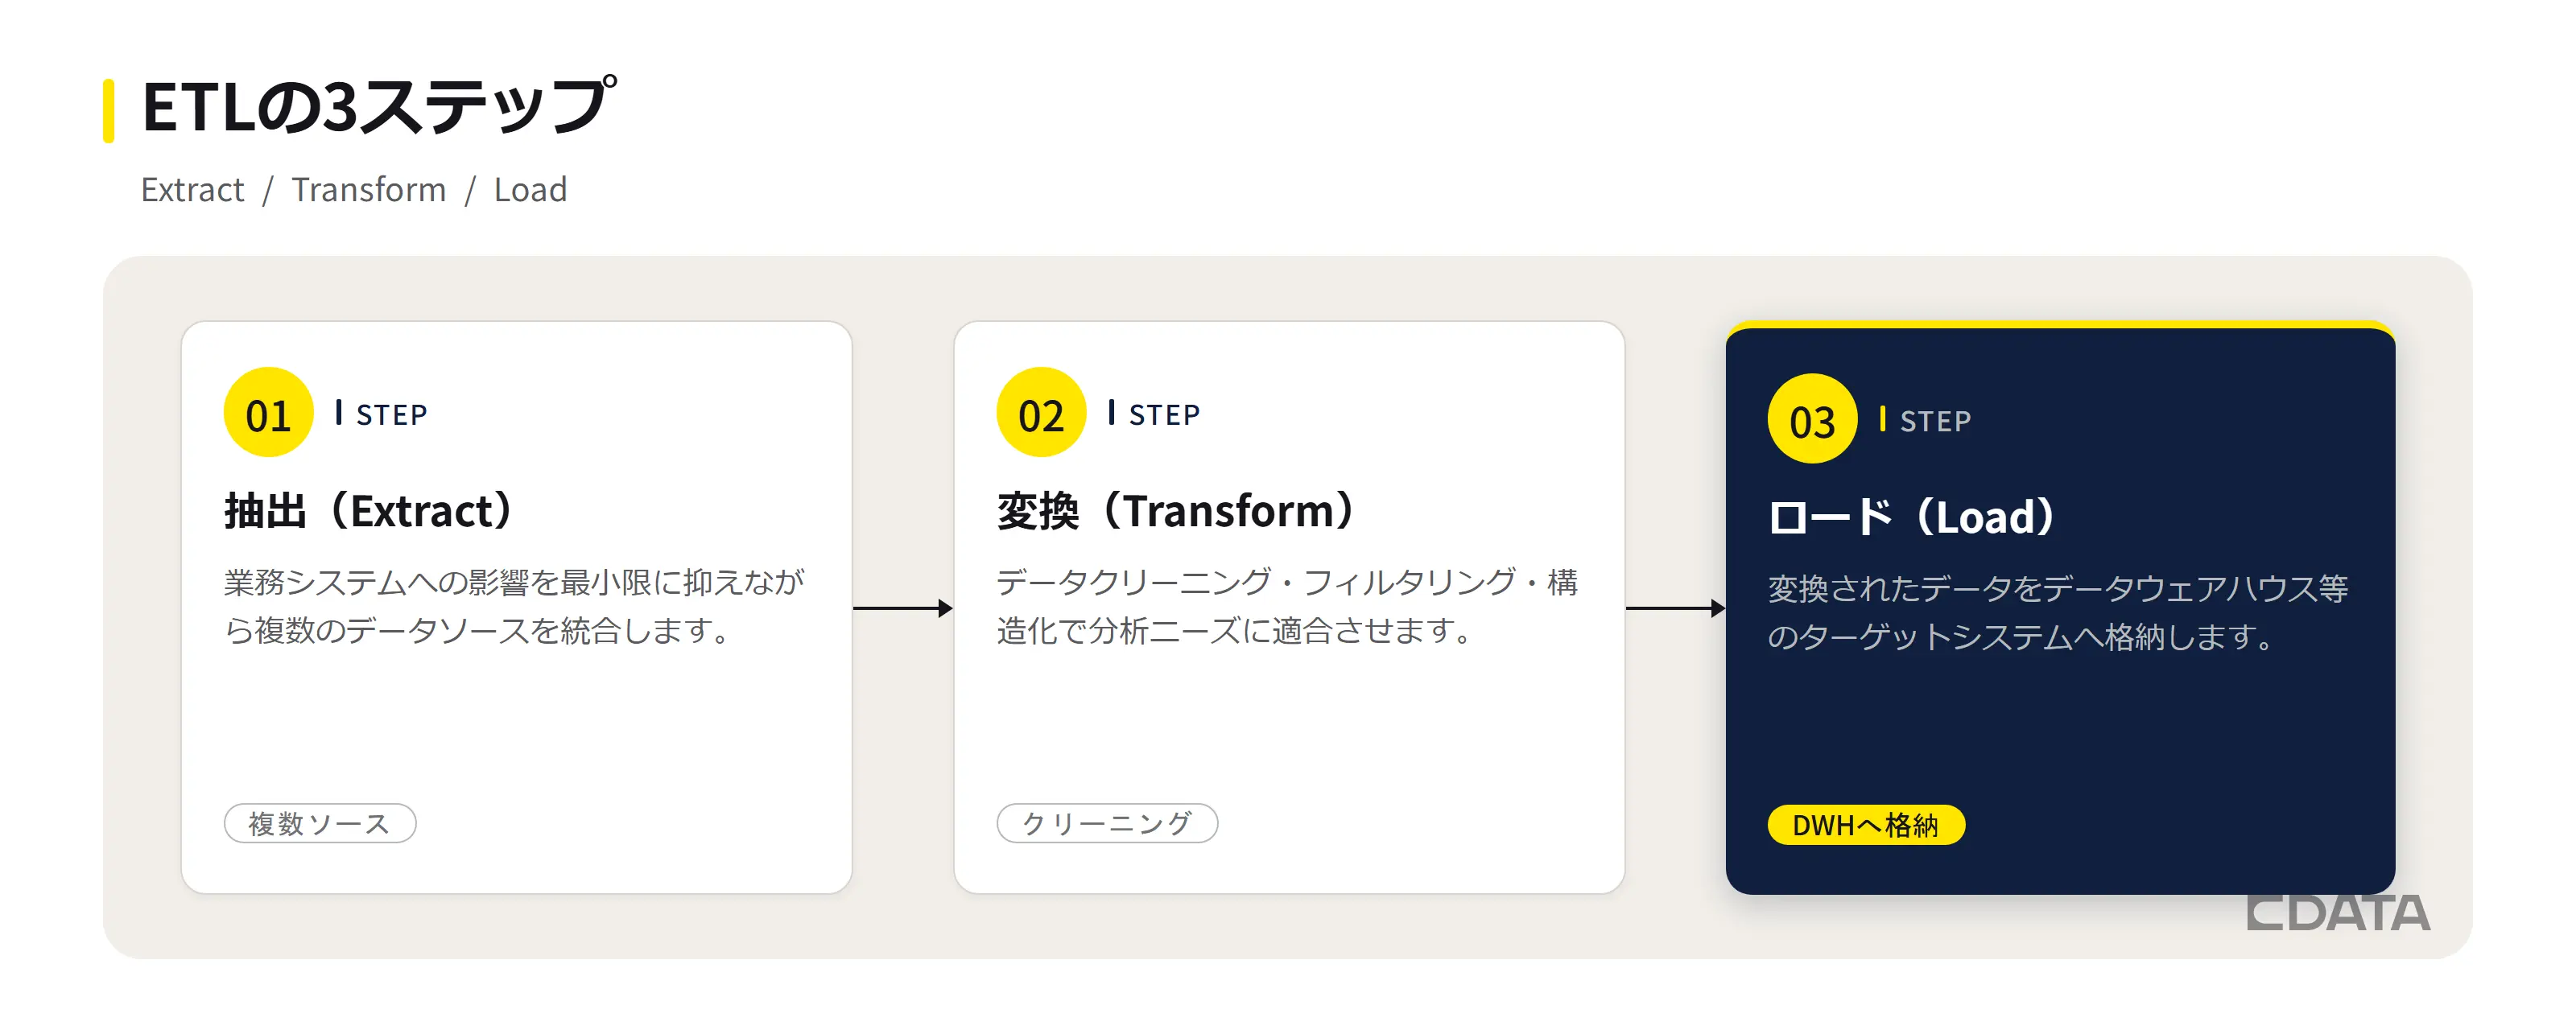
ETL(ETLパイプライン)はデータパイプラインの一種であり、以下の3ステップでデータを移動します。両者の関係や違いを整理したい場合はデータパイプラインとETLの違いも参考になります。ここではETLの3ステップについて解説していきます。
1. 抽出(Extract)
抽出ステップの目的は、業務システムへの影響を最小限に抑えながら複数のデータソースのデータを統合することです。企業では通常複数のSaaS やDB を併用しているため、それぞれのAPI 仕様やプロトコルに合わせた抽出処理をスクラッチで作成するには大きなコストがかかります。
【抽出元の主なデータソース】
リレーショナルデータベース(RDB)
CRMなどの業務システム
アクティビティログ
CSV・Parquet・Excelなどのファイル
社内システムのAPI
2. 変換(Transform)
生データを分析ニーズやビジネス要件に適合するようにクリーニング、フィルタリング、フォーマッティングするのが変換の目的です。
【主な変換タスク】
変換によってデータの一貫性が確保され、アプリケーションでの使いやすさが向上します。
データ変換についてさらに詳しくはこちら >>
3. ロード(Load)
最後のステップはロードです。変換されたデータをデータウェアハウス、クラウドストレージなどの同期先に格納します。
【ロードの主な方式】
このステップでは、差分更新を活用することで同期のパフォーマンスを大きく高速化できます。
差分更新・変更データキャプチャ(CDC)についてさらに詳しくはこちら >>
【ここまでの重要ポイント】
ETLはデータ統合・管理のための重要処理
生データを分析やビジネス活用しやすい形に変換
差分更新でパフォーマンス向上が可能
ETL導入で得られる7つのメリットとは?
さて、ETL の概要は以上で紹介したとおりです。では、ETL を導入することでどのようなビジネスメリットがあるのでしょうか?ここでは特に重要な7つをご紹介します。実際にETL を活用してこうした成果を達成した例を導入事例の章で紹介しています。
1. データの扱いやすさとユーザビリティの向上
異なるデータセットを統一されたフォーマットに統合したり、業務や分析ニーズに適した形に整形することでデータへのアクセスと分析が簡単になり、各部門が迅速に情報に基づいた意思決定を行えます。このようにしてユーザーがすぐに活用できるよう整形されたテーブルを含むデータベースを、データマートと呼びます。
2. 作業時間の短縮
ETL処理の自動化により、手作業の手間を減らしてより迅速なデータ提供と意思決定が可能になります。財務報告や不正検知などのユースケースでは、ほぼリアルタイムでインサイトが得られます。
3. データエラーと重複の削減
データの標準化・クリーニングにより、不整合を最小化し高品質のデータセットを実現します。重複顧客レコードや不完全なレコードは変換フェーズで特定・解決できます。
4. データセキュリティの強化
ETL処理には、転送中の機密データを保護するための暗号化、マスキング、コンプライアンス対策を導入できます。ヘルスケアや金融など規制の厳しい業界では特に重要です。
5. コスト削減
データパイプラインの合理化により業務上のオーバーヘッドが削減され、手作業を減らせます。データワークフローを自動化することで、リソースを戦略的イニシアティブに再配分できます。
6. スケーラビリティの向上
最新のETL プラットフォームは、増大するデータ量に対応し、ビジネスの拡大に伴うスケーラビリティを確保します。新市場進出や新デジタルイニシアチブでは、ETLによりデータインフラが需要増加に対応できます。
7. ストレージの最適化と業務効率向上
ETLは関連性のある構造化データのみを保存し、データの「信頼できる唯一の情報源」を提供することで、部門間のコラボレーションを促進します。
ETLのセキュリティ対策とコンプライアンス対応は?
ETL のビジネスメリットの中でも、データセキュリティとコンプライアンスの確保は特に重要なポイントです。ETL は単なるデータ移動ツールではなく、企業のデータガバナンス戦略の重要な一部です。
ETL 処理で考慮すべきセキュリティ要素
データ転送時の暗号化:ETL 処理中のデータ転送は、SSL/TLS プロトコルを使用して暗号化する
アクセス制御:ETL 処理には、適切なIAM(Identity and Access Management)ポリシーを実装し、認証されたユーザーのみがデータにアクセスできるようにする
センシティブデータの保護:PII(個人を特定できる情報)は、マスキングや匿名化などの技術を使用して保護する
監査ログ:ETL 処理の各ステップを詳細に記録し、監査可能にします。これにより、データアクセスやデータ変更の履歴を追跡できます。
コンプライアンス対応としてのETL
ETL 処理は、GDPR や日本国内の個人情報保護法のコンプライアンス要件を満たすための重要な手段となります。ETL処理で適切なデータマスキングやデータ変換を実装することで、これらの規制要件を満たしながらデータ活用を進めることができます。なお、本節はETLの一般的な活用方法についての情報提供を目的としたものであり、法的助言を目的とするものではありません。個別のコンプライアンス要件への適合可否は、個人情報保護委員会が公開するガイドライン等の一次情報を参照のうえ、自社の法務・コンプライアンス部門にご確認ください。
ETLにおけるデータガバナンス実装のベストプラクティス
データカタログの維持:ETL 処理で処理されるすべてのデータセットを文書化
データリネージの追跡:データの出所と変換履歴を記録
品質チェックの自動化:ETL パイプラインにデータ品質検証ステップを組み込む
セキュリティポリシーの一元管理:企業全体でのETL セキュリティポリシーの標準化
ETL 導入のハードル
このようにETL の導入にはさまざまなメリットがありますが、自社で導入する際には開発・運用コストが大きなハードルになります。ETL 処理をスクラッチで用意して安定稼働させるには専門のデータエンジニアリングチームが必要になるためです。
次に紹介するようなETL ツールを活用することで、こうした開発・運用のハードルを回避できます。
ETL ツールとは?自社に最適なソリューションの選び方
ETL ツールは、ETL 処理を自動化するソフトウェアです。ETL ツールを利用することで、開発・運用のコストを最小限に抑えてデータパイプラインを構築できます。
ETLツールの処理性能とスケーラビリティの壁
多くのETLツールは、処理性能の強化が機能拡張の中で後回しにされがちです。データ量が急増したり同期の頻度を高めたりすると変換処理がボトルネックとなり、データベース側に処理を逃がすなどの非効率な回避策が必要になるケースも少なくありません。
CData Syncは、変更データキャプチャ(CDC)による差分同期や並列処理に対応しており、大量データや高頻度の同期でもこうした処理性能の壁に直面しにくい設計です。ツールを選定する際は、カタログスペックだけでなく、自社のデータ量・同期頻度を想定した実際のパフォーマンスを確認することが重要です。
主要ETL ツール比較表
ETL ツールといっても、それぞれに特徴を持つ多くの製品が存在します。こうしたツールは、データ同期の自動化、高いパフォーマンス、リアルタイム処理のサポートなど、企業でデータ基盤を運用する際に欠かせない機能を提供します。ここでは主なETL ツールをまとめて比較・ご紹介します。
ツール名 | 特徴・利用シーン | 価格帯目安 |
Airbyte | カスタマイズ可能なコネクタを備えたオープンソースのETL ツールで、独自の統合ニーズを持つ企業に最適です。 | 無料(OSS) |
Apache Airflow | 開発者がPython を使用してプログラムでETL 処理を定義できる、ワークフローオーケストレーションツールです。 | 無料(OSS) |
AWS Glue | S3 やRedshift を含むAWS(アマゾン ウェブ サービス)エコシステムと密接に連携するフルマネージドETL サービスです。 | 有償(従量課金) |
Azure Data Factory | Microsoft Azure 用に設計されたスケーラブルなデータ統合ツールで、ハイブリッドデータワークフローをサポートします。 | 有償(従量課金) |
Google Cloud Dataflow | Google Cloud ユーザーに最適なリアルタイムおよびバッチデータ処理のためのマネージドサービスです。 | 有償(従量課金) |
Hadoop | MapReduce を使用して大規模なETL を実行できる、分散ストレージおよび処理フレームワークです。 | 無料(OSS) |
Hevo | 最小限のセットアップでリアルタイムデータ統合をサポートする、ノーコードのETL プラットフォームです。 | 有償 |
IBM Infosphere DataStage | メインフレームを含む大規模システムからのデータ統合用に設計された、エンタープライズ仕様のツールです。 | エンタープライズ |
インフォマティカ | 複雑なデータ環境を管理し、自動化と高度な分析を提供する包括的なETL ソリューションです。 | エンタープライズ |
Matillion | Snowflake、Redshift、BigQuery などのデータウェアハウスに最適化されたクラウドネイティブETL ツールです。 | 有償 |
Microsoft SSIS | SQL Server Integration Servicesの略称で、Microsoft 環境向けの信頼性の高いETL ツールです。 | 有償(SQL Server同梱) |
Oracle Data Integrator | Oracle データベースやその他のデータシステム向けに特別に設計されたエンタープライズグレードのETL ソリューションです。 | エンタープライズ |
Stitch | セットアップが簡単な軽量ETL プラットフォームで、スタートアップやスモールビジネスに最適です。 | 有償 |
Talend Open Studio | 広範なカスタマイズ機能と統合機能を提供するオープンソースのETL ツールです。 | 無料(OSS) |
CData Sync | オンプレミス・クラウドの400種類以上の業務システムをサポートします。あらかじめ組み込まれたコネクタで各システムとスムーズに接続でき、CDC によるニアリアルタイムでのデータ同期を強力にサポートします。 | 有償(無料トライアルあり) |
このように多種多様なETL ツールが提供されているため、ツール選定の際には自社の要件を明確にした上で各ツールを比較することが重要です。
ETLツール選定の5つのポイント
対応しているデータソースの種類:自社で使用している業務システムやデータベースに対応しているか
処理性能:(ニア)リアルタイム処理の必要性と処理データ量に合わせて選定しましょう。CDC やストリーミングなどの機能に対応しているかも重要なポイントです。また、データ量が急増した際にスケールできるか、大規模データセットで処理時間が想定以上に増加しないかも事前に確認しておくと安心です。
操作性:プログラミング知識の必要性、GUI の使いやすさ
コスト:初期費用、ランニングコスト、ROI の検討
サポート体制:技術サポートの充実度、(外資製品であれば)日本語のサポートが存在するか
さらに詳しくは以下の記事をご確認ください。
ETL ツール選定の際のポイントはこちら >>
また、近年では企業のSaaS 使用数や扱うデータ量の増加、企業に求められるコンプライアンス体制の厳格化などに伴いETL ツールに求められる要件も変化しています。モダンなデータパイプラインの構築に欠かせない機能については以下の記事も参考にしていただけます。
モダンなデータパイプラインに求められる6つの機能とは? >>
ETL ツールを使ったデータパイプラインの構築を体験
CData では、400種類以上の業務システムやデータベース向けにノーコードで使えるETL / ELT ツール『CData Sync』を使ったデータパイプライン作成に役立つチュートリアルを公開しています。実際にデータパイプラインを作ってみたい!という方はぜひ参考にしてみてください。

ETLとELTはどう違う?
近年データ活用の場面では、従来のETL(Extract-Transform-Load)に加えて、ELT(Extract-Load-Transform)アプローチも注目されています。それぞれの特徴と使いどころを以下にまとめました。
ETL とELT の基本的な違い
特徴 | ETL | ELT |
処理の順序 | 抽出→変換→ロード | 抽出→ロード→変換 |
変換の場所 | ステージングエリア、ミドルウェア | データウェアハウス内 |
適したデータ量 | 中~小規模 | 大規模(ビッグデータ) |
実装の複雑さ | 高い(スクリプトなどでの処理が多い) | 低い(DWH 内でのSQL ベースの処理が多い) |
コスト | 処理サーバーのコスト | DWH ストレージとクエリ実行のコスト |
ETL とELT はそれぞれメリット・デメリットがあり、使用するべき場面が異なります。
ETLが適している状況
データの前処理や品質管理が特に重要な場合
センシティブデータの匿名化や削除が必要な場合
最終的なデータ量を削減したい場合
レガシーシステムとの連携が多い場合
ELTが適している状況
自社のデータ特性、セキュリティ要件、分析ニーズに応じて最適なアプローチをご検討ください。
データ仮想化との違い
ETL・ELTはデータを物理的に複製し、データウェアハウスなどに格納します。一方、データ仮想化は元のデータソースに接続したまま、仮想的な統合ビューを通じてデータを参照する手法です。データの複製を最小限に抑えられる一方、大量データへの頻繁なアクセスでは元システムへの負荷や処理速度の面で制約が生じます。
頻繁に参照する大量データの分析にはETL/ELTでデータウェアハウスに集約し、鮮度が最優先されるアドホックな照会にはデータ仮想化を使うなど、目的に応じた使い分けが重要です。どちらが自社に適しているか迷う場合は、データ仮想化とデータ統合、あなたに最適な選択肢は?も判断材料になります。
ETL とELT の違いについてさらに詳しくはこちら >>
ETLツールとEAIツールはどう違う?
ETLと混同されやすい技術にEAI(Enterprise Application Integration)があります。両者はデータ統合に関わる技術ですが、目的とアーキテクチャが異なります。
比較項目 | ETLツール | EAIツール |
|---|
主な目的 | データの抽出・変換・格納 | アプリケーション間のリアルタイム連携 |
処理方式 | バッチ処理が中心 | イベント駆動・リアルタイム処理 |
データの流れ | ソース → DWH(一方向が基本) | アプリ間の双方向通信 |
変換の深さ | 複雑な変換・クレンジングが可能 | 軽量なデータマッピングが中心 |
主な用途 | データ分析基盤の構築、レポーティング | 業務プロセスの自動化、システム間連携 |
代表的なツール | CData Sync, Informatica, Talend | MuleSoft, Dell Boomi, IBM App Connect |
分析基盤へのデータ統合にはETL、業務システム間のリアルタイム連携にはEAIと、目的によって使い分けるのが一般的です。両方を組み合わせて運用しているケースも多くあります。ETL・iPaaS・EAI それぞれのアプローチをさらに詳しく比較したい方は、ETL?iPaaS?EAI?データ連携のアプローチを比較解説もご覧ください。
業界別ETL 導入事例
ここまではETL の概要をお話してきました。このセクションでは、実際にETL ツールを活用してデータ活用を加速されている各社の事例をご紹介します。皆さんの企業でのデータ活用促進に役立つ事例が見つかればうれしいです。
データ分析基盤の構築
教育機関のグロービス経営大学院では、MA(Adobe Marketo Engage、以下Marketo) / CRM(Salesforce)の導入によりデータ活用が活発になりました。その反面、部分最適化や「データの揺らぎ」が顕在化し、経営の課題になっていました。この課題を解決するために曖昧さを排除して「見るべき指標の定義」を行い、データ・ガバナンスを実現されました。CData Sync は、そのデータ分析基盤を支えています。

成果
データ分析基盤構築の事例記事はこちら
クラウド移行
ある金融機関では、レガシーシステムからクラウドプラットフォームへトランザクションレコードを移行する際にETLを活用し、コンプライアンスを遵守しながらデータの民主化を加速しています。メインフレームなど基幹系からのクラウド移行でETLツールを選ぶ際のポイントは、メインフレームのクラウド移行に最適なETLツールの選び方で詳しく解説しています。
成果
基幹システムへのデータ統合
酒造メーカーの菊正宗酒造株式会社では、同社が運営する酒造記念館の物販用レジとして導入しているスマレジの売上データや、見積・請求・振込業務の承認ワークフローに使うコラボフロー、出退勤管理のKING OF TIMEなど、多様なクラウドサービスのデータを社内のSQL Serverに同期しています。これにより、基幹システムへのデータの自動連携やポータルサイト、BIツールでのデータ活用を実現されました。

成果
スマレジの売上データについて、API接続に必要なトークン情報をセットするだけで簡単に取得することが出来た
スマレジでCSVファイルのダウンロードから売上データの発行までの作業に、30分以上掛かっていたが1分以内に発行できるようになった
スマレジだけでなく社内で活用している他のクラウドサービスのデータもCData Syncひとつでデータを取得でき画期的と感じた
ジョブのスケジュール機能で手間をかけずにデータ同期を自動化することが出来た
基幹システムへのデータ統合の事例記事はこちら
機械学習とAI
ある医療機関では、ETLを使用して電子カルテ(EHR)や画像データを処理し、AIモデルによる患者の予後予測や治療計画の最適化を実現しています。
成果
マーケティングデータの収集と統合
あるマーケティングチームは、ETL を活用してWeb サイトの行動データとCRM の顧客情報を組み合わせて顧客セグメントを作成し、パーソナライズされたキャンペーンを展開しています。
成果
CDC によるニアリアルタイムに統合
電子部品メーカーのNGK Electronics Devicesでは、DX 推進活動の一環として、製造品質における歩留まり等の分析に向けたデータ収集・統合作業の自動化をCData Sync で実現しました。これにより、ニアリアルタイムでのきめ細やかな品質改善活動が可能になりました。

成果
CDC によるニアリアルタイムの統合の事例記事はこちら
データベースのレプリケーション
ETL は、システム間でデータをコピー・同期することでデータベースのレプリケーションをサポートし、環境間の一貫性を確保するのにも有効です。バックアップ、ディザスタリカバリや高可用性が求められるアプリケーションの開発時に特に重要なポイントです。
あるEC プラットフォームは、ETL を使用してトランザクションデータを複数のシステムに複製し、買い物の最繁忙期でもサービスが中断されないようにしています。
データレプリケーションについてさらに詳しくはこちら >>
その他の業界固有のアプリケーション
他にも、ETL には業界のニーズに合わせた応用例が多く存在します。
保険:ETL は保険金請求データと契約者記録を統合し、不正行為の検出とリスク評価を可能に
教育:教育機関はETL を使用してさまざまなプラットフォームから学生の成績データを統合し、パーソナライズされた学習体験を実現
ヘルスケア:ETL パイプラインで研究および集団健康調査のために患者記録、検査結果、画像診断データを集約
このように、ETL を活用することであらゆる業種において企業のデータ活用を加速し、データの持つ価値を最大化できます。
ETLは生成AI活用にそのまま使える?
生成AIエージェントやRAG(検索拡張生成)の活用が広がるにつれ、ETLに求められる役割にも変化が生じています。ここでは、従来のETLと「AI活用を前提としたデータ基盤」の違いを整理します。
従来のETLとAI-Readyなデータ基盤の違い
従来のETLは、定期的なバッチ処理でデータウェアハウスへ集約し、人がBIツールなどを介して参照することを想定して設計されてきました。一方、AIエージェントは必要な瞬間にリアルタイムでデータを参照し、そのまま判断や実行に反映させることを前提とします。バッチ処理を中心に設計されたETLパイプラインだけでは、この鮮度や接続性の要件を満たせない場合があります。
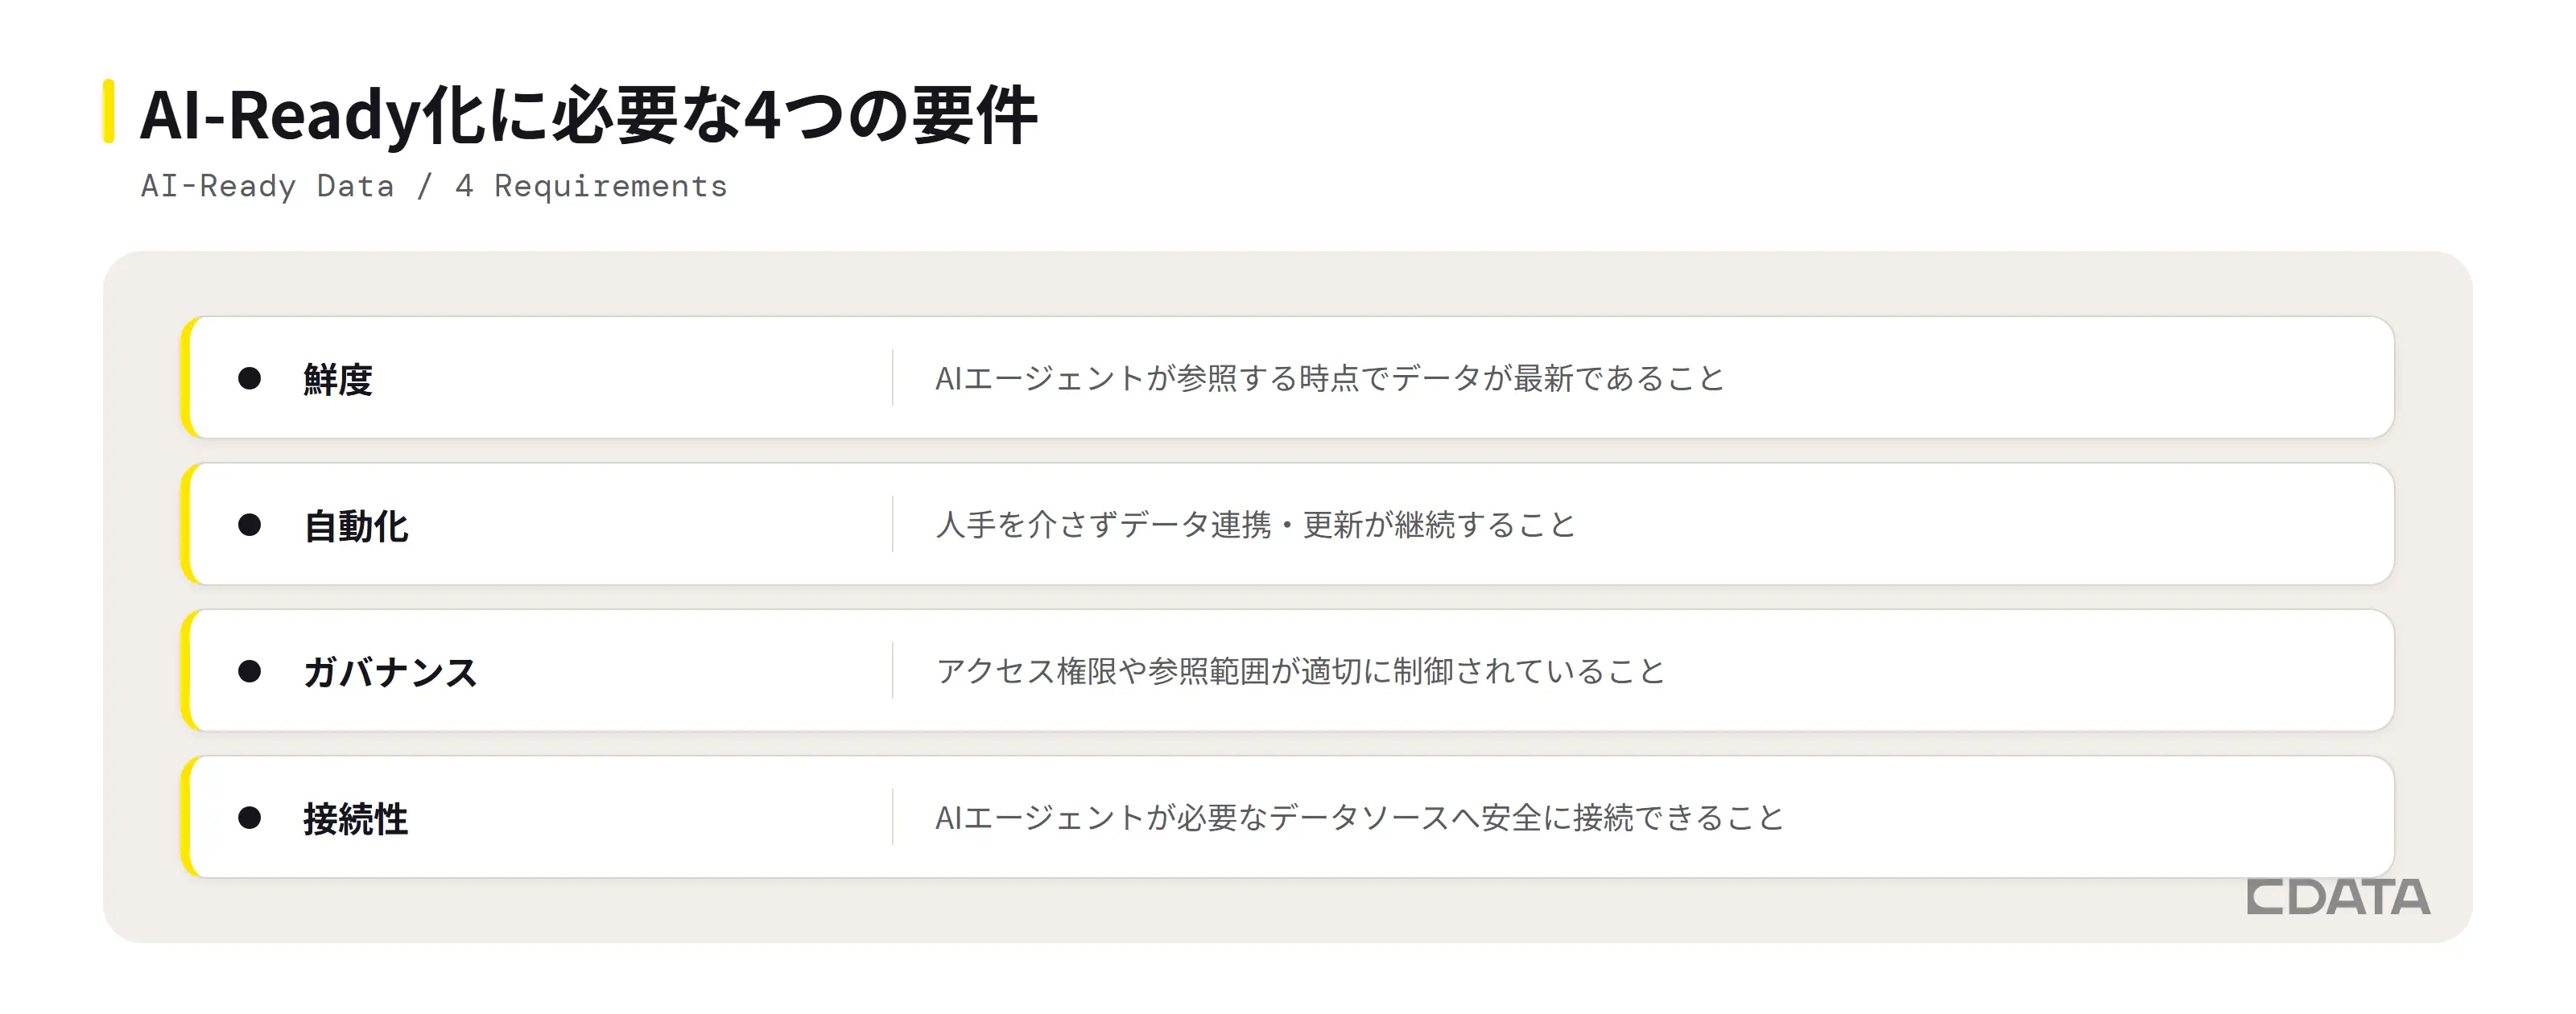
AI-Ready化に必要な4つの要件
鮮度:AIエージェントが参照する時点でデータが最新であること
自動化:人手を介さずデータ連携・更新が継続すること
ガバナンス:アクセス権限や参照範囲が適切に制御されていること
接続性:AIエージェントが必要なデータソースへ安全に接続できること
ETLで構築したデータ基盤をそのままAIエージェントに開放するのではなく、これら4条件を満たしているかを見直すことが生成AI活用を実運用に載せる第一歩になります。詳しくはAI-Readyなデータ基盤とは?AI活用を加速するデータ基盤の要件で解説しています。
おわりに:ETL でデータ活用を一歩先へ
ETLの重要性は、データの収集から活用までの処理を効率化し、企業のデータ戦略を強化する点にあります。適切なETLツールを導入することで、データ統合の課題を解決し、社内のデータ活用をさらに促進できます。ETL を導入する際には、以下のようなロードマップで段階的に導入していくとよいでしょう。
現状のデータフローとニーズを分析する
適切なETLツールを選定する
段階的に導入・拡張していく
継続的に改善・最適化する
CData Sync をはじめとするETL ツールを活用すれば、多様なデータソースと簡単に連携してデータベースやDWH への統合をスタートできるため、データ活用の可能性がさらに広がります。 今後のデータ活用において、ETL およびETL ツールの導入をぜひ検討してみてください。
CData Sync についての参考記事はこちら >>
よくある質問(FAQ)
ETLとETLツールは何が違う?
ETLは複数のデータソースからデータを抽出・変換・格納する処理そのものを指す概念です。一方ETLツールは、その抽出・変換・格納の一連の処理を自動化するソフトウェア製品を指します。ETLをスクラッチで実装する代わりに、CData SyncのようなETLツールを使うことで、開発・運用コストを抑えながらデータパイプラインを構築できます。
ETLとELTどちらを選ぶべき?
データ量や分析ニーズによって適した方式が異なります。データの前処理や品質管理を重視する場合、またはセンシティブデータの匿名化が必要な場合はETLが適しています。一方、大量の未加工データを保持したい場合やクラウドデータウェアハウスを活用する場合はELTが向いています。多くの企業は両方を使い分けたり組み合わせたりして運用しています。
無料で使えるETLツールはある?
Airbyte や Apache Airflow、Talend Open Studio のようなオープンソースのETLツールは無料で利用できます。ただし運用・保守を自社で行う必要があるため、商用ツールの無料トライアル(CData Syncの無料トライアルなど)を使って導入負荷を比較検討するのもおすすめです。
ETL導入の壁をCData Syncで解消
ETLをスクラッチで構築するには専門チームが必要ですが、CData Syncなら400種類以上の業務システムに対応したノーコードETL/ELTツールで、CDCによるニアリアルタイム同期もすぐ始められます。
CData Syncの14日間無料トライアルを今すぐ開始して、貴社のデータ統合を数分で体感してください。