


Azure Data Catalog のデータをPythonのpetlでETL処理する方法|CData Connect AI
CData Connect AI の Python SDK と petl フレームワークを使うと、Azure Data Catalog のデータをローカルにドライバーをインストールすることなく、Pythonで直接抽出・変換・ロードするETLパイプラインを構築できます。パーソナルアクセストークンで接続し、数行のコードで設定完了です。
Python は豊富なモジュールのエコシステムを備えているため、素早く作業に取りかかり、システムをより効果的に連携できます。CData Connect AI Python SDK と petl フレームワークを使えば、Azure Data Catalog のデータを抽出・変換して CSV などに出力する Azure Data Catalog 連携のアプリケーションやパイプラインを構築できます。この記事では、Connect AI に接続し、petl を使ってAzure Data Catalog のデータを抽出・変換し、CSV ファイルに書き出す方法をご紹介します。
Connect AI Python SDK(cdata-connect-ai)は DB-API 2.0(PEP 249)に準拠したクライアントなので、petl は etl.fromdb を使って SDK の接続から直接読み取れます。ソースごとにドライバーをインストールする必要はありません。パーソナルアクセストークンで接続して、パイプラインを構築しましょう。
Python + petl でできること
Azure Data Catalog データの定期抽出パイプライン構築
SQL クエリで取得した Azure Data Catalog のレコードを petl の etl.fromdb で抽出し、etl.sort などの変換処理をはさんでから CSV に書き出す、軽量な ETL パイプラインを構築できます。
複数データソースとの統合分析
DB-API 2.0 準拠のクライアントなので、同じコードパターンで Azure Data Catalog 以外のデータソースにも接続でき、petl 上で結合・整形してから任意の出力先にロードできます。
Azure Data Catalog への書き戻し処理の自動化
書き込みに対応した権限を持つ PAT で接続していれば、cursor.executemany を使ったバッチ INSERT により、変換済みデータを Azure Data Catalog に自動で書き戻す処理を組み込めます。
Connect AI で Azure Data Catalog に接続する方法は?
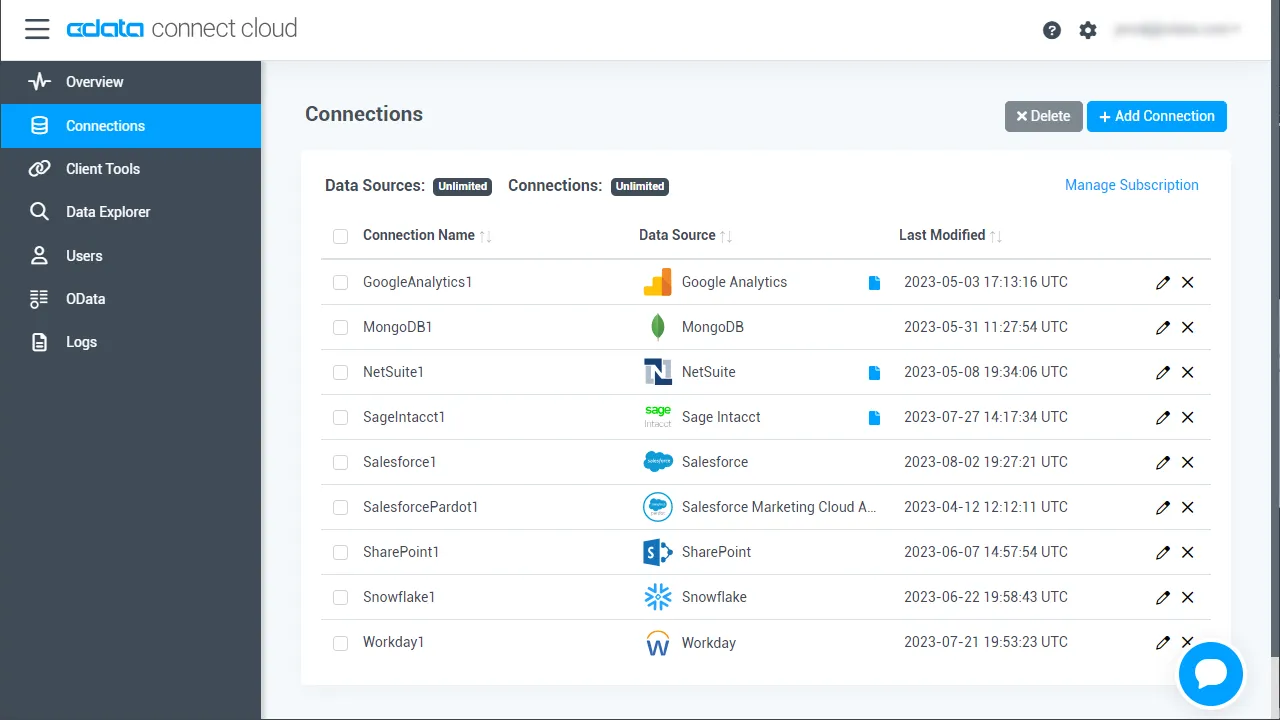
CData Connect AI では、直感的なクリック操作ベースのインターフェースでデータソースに接続できます。
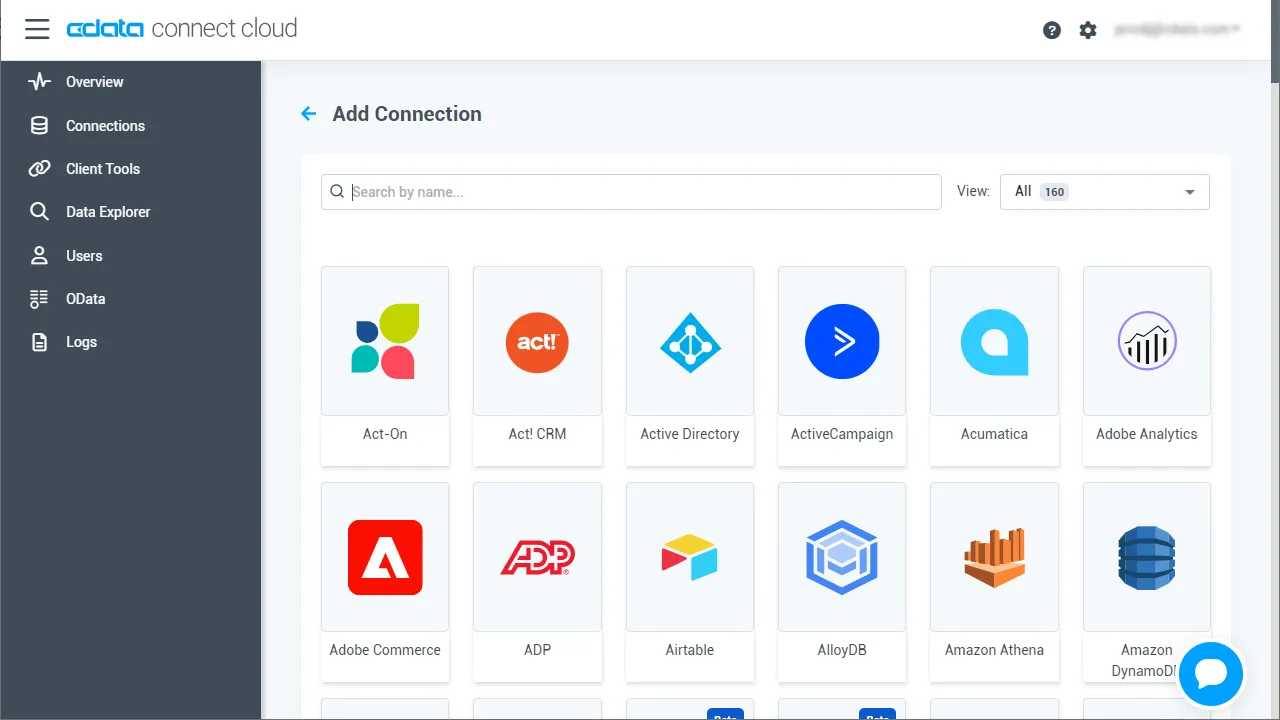
- Connect AI にログインし、Sources をクリックして、 Add Connection をクリックします
- 「Add Connection」パネルから「Azure Data Catalog」を選択します
-
Azure Data Catalog に接続するために必要な認証プロパティを入力します。
Azure Data Catalog 接続プロパティの取得・設定方法
OAuth 認証で接続
Azure Data Catalog の認証にはOAuth を使用します。CData 製品では組込みOAuth が利用できるので、接続プロパティを設定することなく接続を試行するだけで、ブラウザ経由でAzure Data Catalog に認証できます。詳しい設定方法については、ヘルプドキュメントの「Azure Data Catalog への認証」セクションを参照してください。
設定は任意ですが、CatalogName プロパティを設定することでAzure Data Catalog から返されるカタログデータを明示的に指定できます。
CatalogName:Azure Data Catalog に紐づいているカタログ名に設定。空のままにすると、デフォルトのカタログが使用されます。カタログ名は、「Azure Portal」->「データカタログ」->「カタログ名」から取得できます。
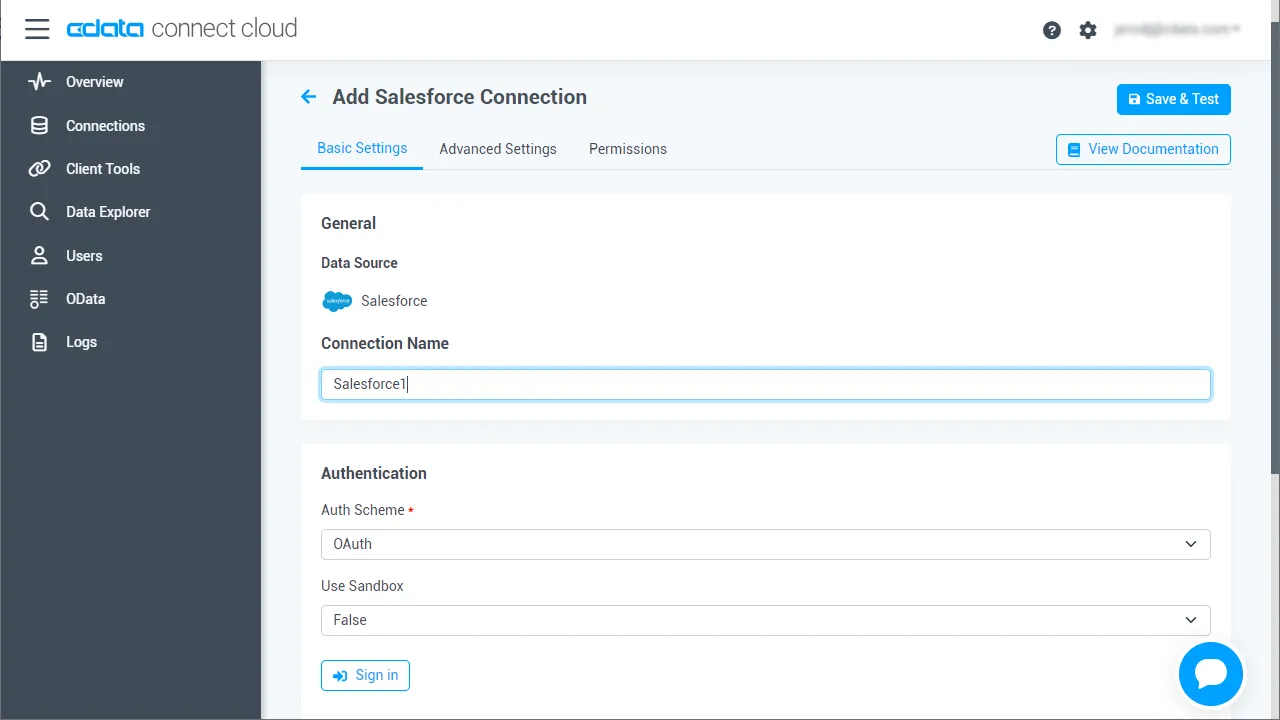
- 「Save & Test」をクリックします
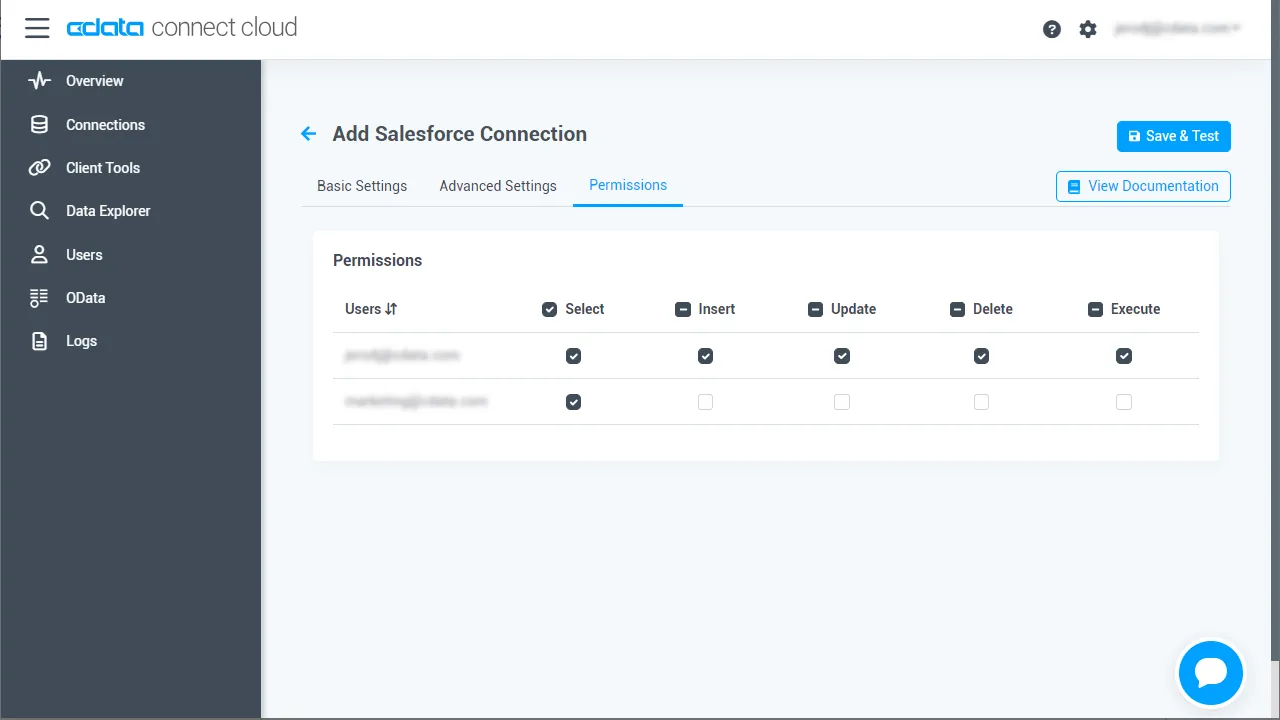
- 「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークン(PAT)を生成する
Python SDK は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使って Connect AI に認証します。アクセスの粒度を保つために、アプリケーションごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
- 設定ページの Access Tokens セクションに移動し、 Create PAT をクリックします。
- PAT に名前を付けて Create をクリックします。
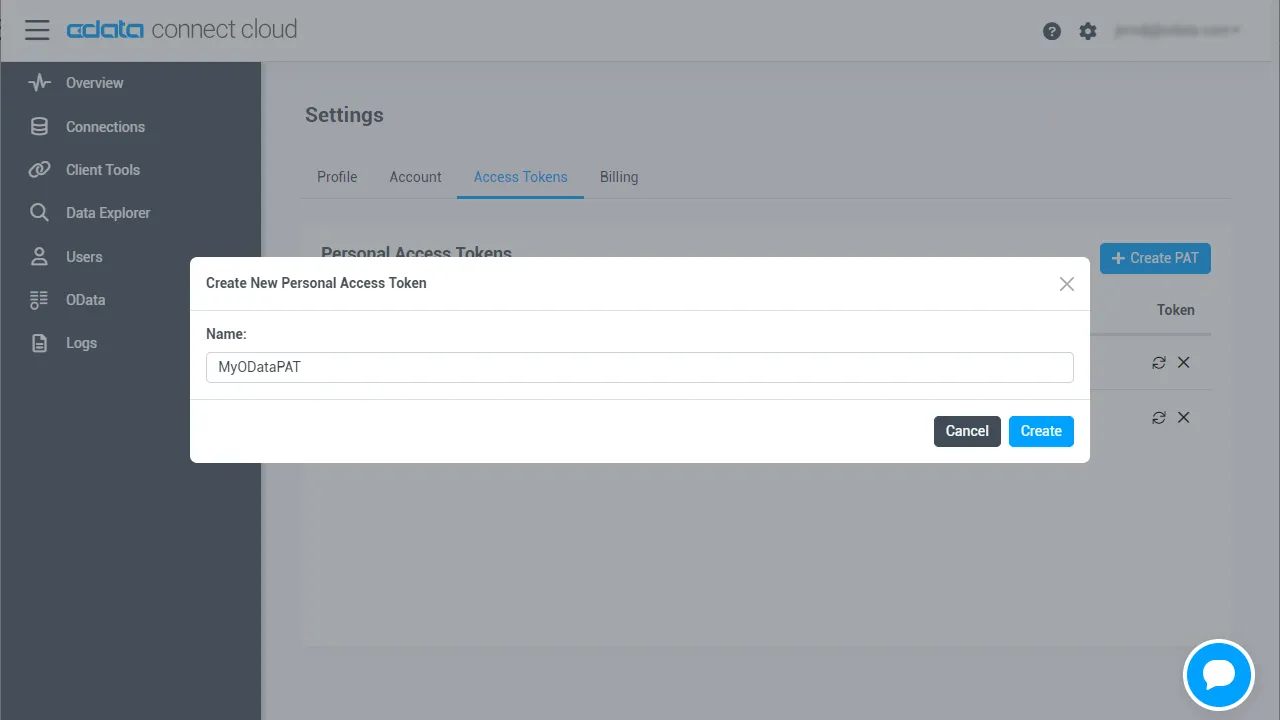
- パーソナルアクセストークンは作成時にのみ表示されます。必ずコピーして安全な場所に保管してください。
必要なモジュールをインストールする方法は?
pip ユーティリティを使って、SDK と petl フレームワークをインストールします。
pip install cdata-connect-ai
pip install petl
Python で Azure Data Catalog のデータの ETL アプリを構築する方法は?
必要なモジュールをインストールしたら、ETL アプリを構築する準備は完了です。以下にコードスニペットを紹介しますが、完全なソースコードは記事の末尾に掲載しています。
まずモジュールをインポートし、アカウントのメールアドレスと PAT で Connect AI に接続します。
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)
Azure Data Catalog をクエリする SQL ステートメントを作成する方法は?
SQL を使って、Azure Data Catalog をクエリするステートメントを作成します。この記事では、Tables エンティティからデータを読み取ります。識別子は <Connection>.<Schema>.<Table> という3つの部分で構成されており、接続名はデフォルトでソース名(例:AzureDataCatalog1)になります。
sql = (
    "SELECT DslAddressDatabase, Type "
    "FROM [AzureDataCatalog1].[AzureDataCatalog].[Tables] "
    "WHERE Name = 'FactProductInventory'"
)
Azure Data Catalog のデータの抽出・変換・ロードを実装する方法は?
接続とクエリが準備できたら、petl を使ってAzure Data Catalog のデータを抽出・変換・ロードします。この例では、Azure Data Catalog のデータを抽出し、Type カラムでデータを並べ替えて、CSV ファイルにロードします。
table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'Type')

etl.tocsv(table2, 'tables_data.csv')
Azure Data Catalog は Connect AI では読み取り専用のソースのため、このパイプラインではAzure Data Catalog のデータの抽出と変換はできますが、行の書き戻しはできません。抽出が完了したら接続を閉じましょう。
conn.close()
CData Connect AI Python SDK を使えば、petl のような ETL パッケージでのデータへの直接アクセスも含め、通常のデータベースと同じようにAzure Data Catalog のデータを扱えます。
関連情報と無料トライアル
これで、CData Connect AI Python SDK を使って、petl でリアルタイムのAzure Data Catalog のデータをパイプライン処理できるようになりました。Azure Data Catalog(および数百種類のその他のデータソース)への接続について詳しくは、Connect AI のページをご覧ください。
CData Connect AI の詳細、または無料トライアルにお申し込みください:
完全なソースコード
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)

sql = (
    "SELECT DslAddressDatabase, Type "
    "FROM [AzureDataCatalog1].[AzureDataCatalog].[Tables] "
    "WHERE Name = 'FactProductInventory'"
)

table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'Type')

etl.tocsv(table2, 'tables_data.csv')
conn.close()