


CData Connect AI 経由でPostgreSQL インターフェースからリアルタイムの HDFS のデータに接続
インターネット上には数多くのPostgreSQL クライアントがあります。PostgreSQL はデータアクセスのための一般的なインターフェースです。PostgreSQL をCData Connect AI と組み合わせることで、PostgreSQL からリアルタイムのHDFS のデータにデータベースのようにアクセスできます。この記事では、Connect AI でHDFS のデータに接続し、TDS foreign data wrapper(FDW)を使用してConnect AI とPostgreSQL 間の接続を確立するプロセスを説明します。
CData Connect AI は HDFS 専用のSQL Server インターフェースを提供し、ネイティブでサポートされているデータベースにデータをレプリケートすることなく HDFS のデータをクエリできます。最適化されたデータ処理を標準で使用し、CData Connect AI はサポートされているすべてのSQL 操作(フィルター、JOIN など)を HDFS に直接プッシュし、サーバーサイド処理を活用して必要なHDFS のデータを迅速に返します。
Connect AI で HDFS に接続
CData Connect AI は、シンプルなポイント&クリック操作でデータソースに接続できるインターフェースを提供しています。
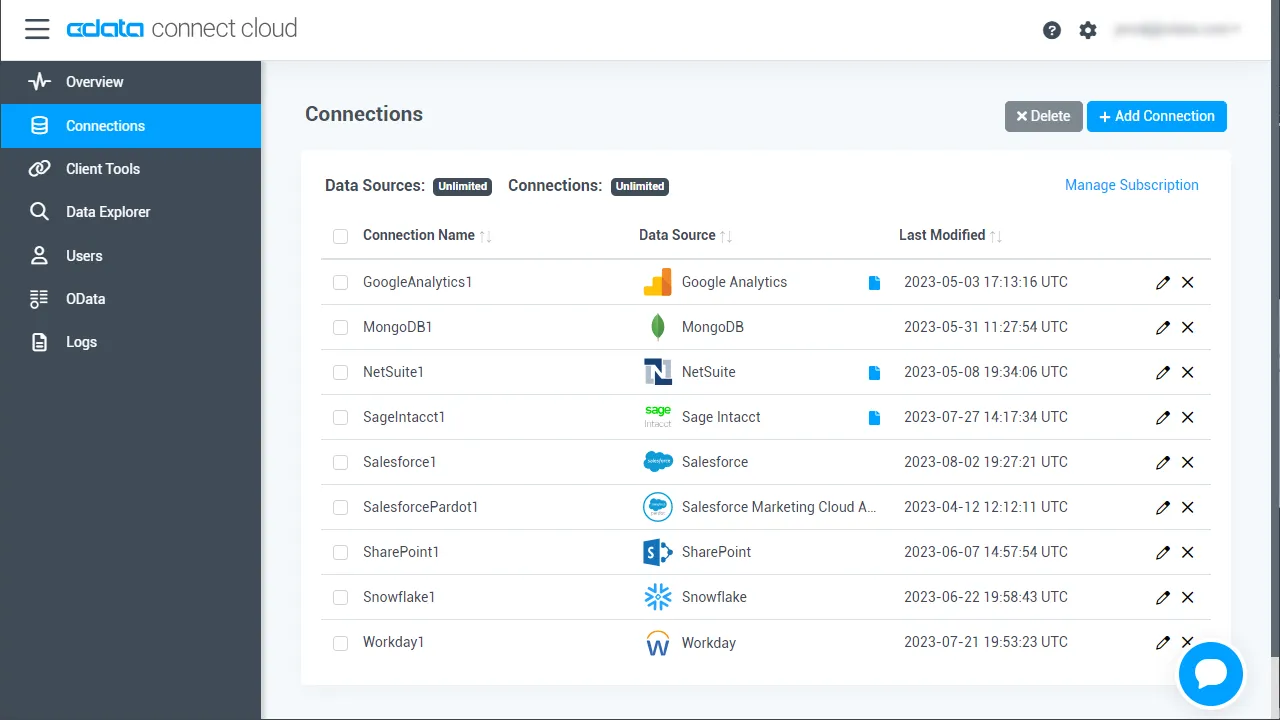
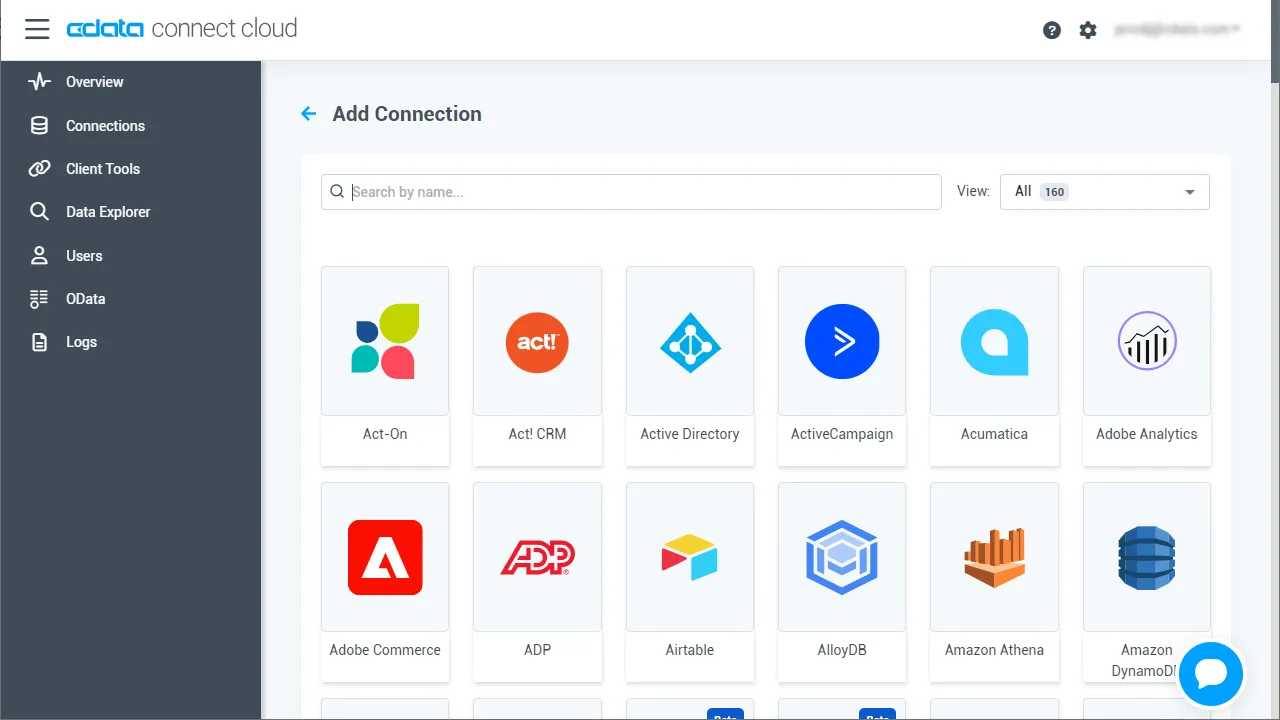
- Connect AI にログインして「Sources」をクリックし、 Add Connection をクリックします
- Add Connection パネルから「HDFS」を選択します
-
HDFS への接続に必要な認証プロパティを入力します。
HDFS 接続プロパティの取得・設定方法
HDFS への認証には、次の接続プロパティを設定します。
- Host:HDFS インスタンスのホストに設定。
- Port:HDFS インスタンスのポートに設定。デフォルトのポートは"9870" です。
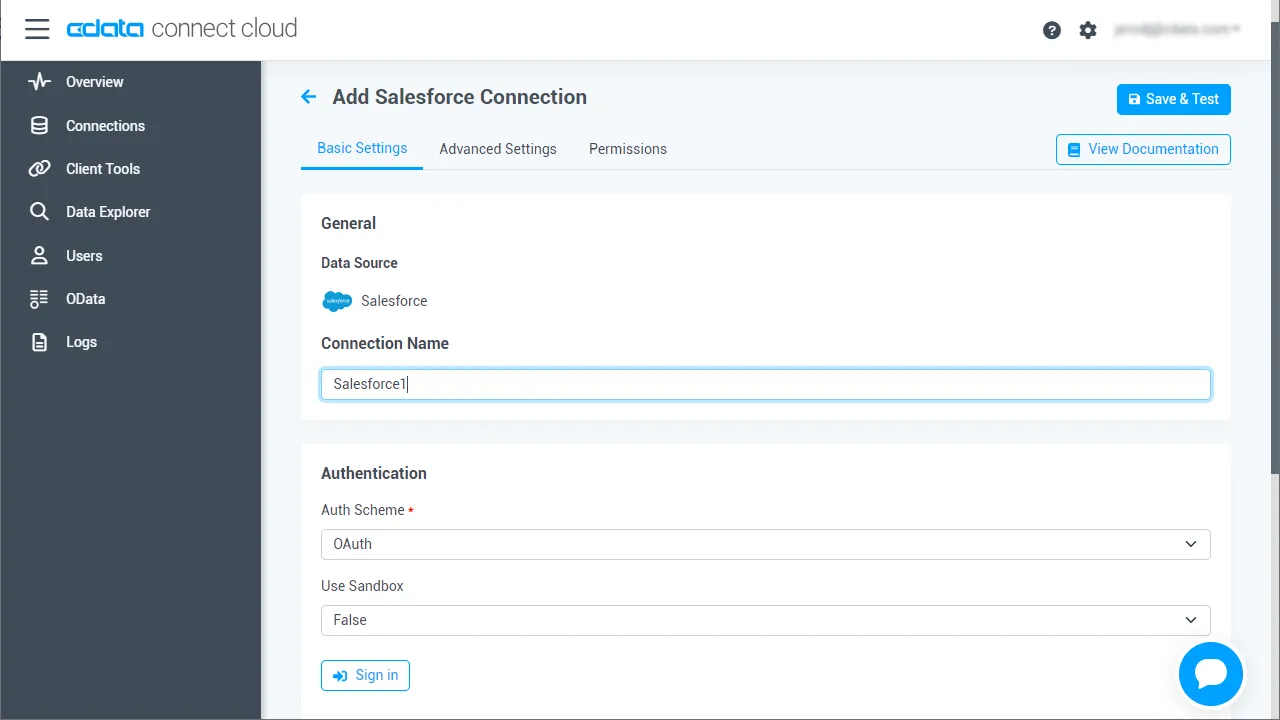
- Save & Test をクリックします
-
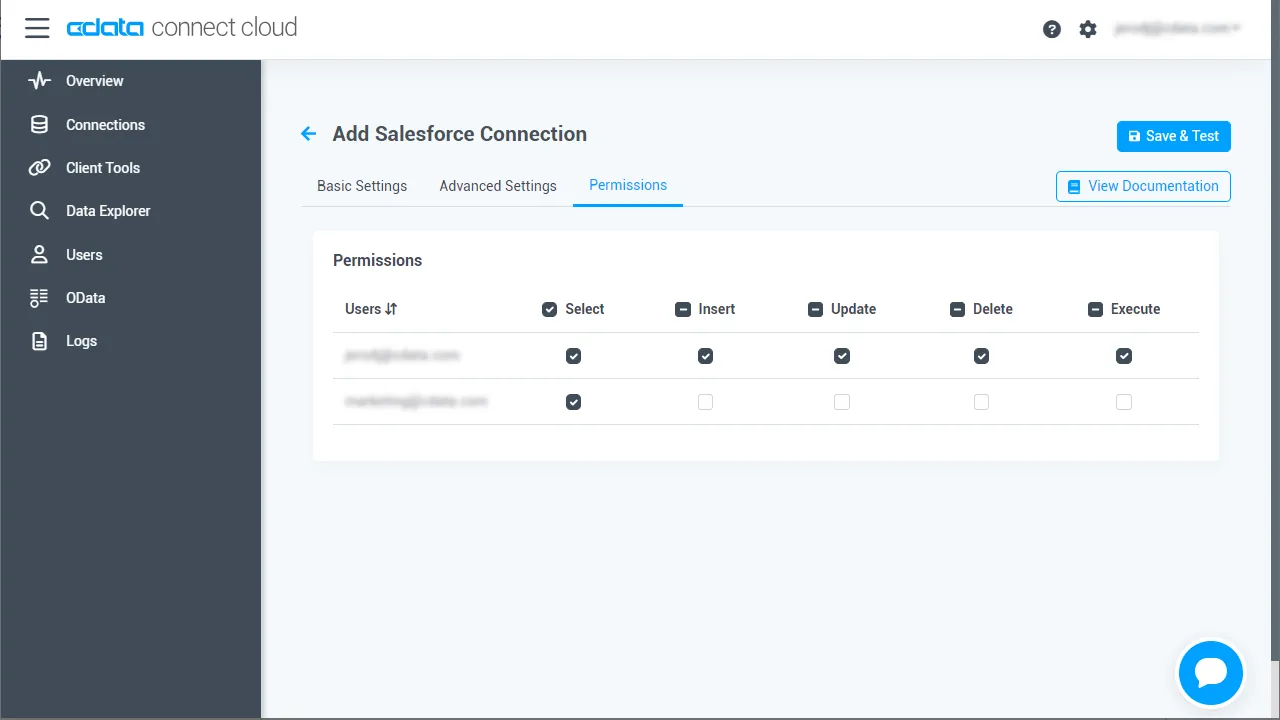
Add HDFS Connection ページの「Permissions」タブに移動し、ユーザーベースの権限を更新します。
Personal Access Token の追加
REST API、OData API、またはVirtual SQL Server 経由でConnect AI に接続する場合、Personal Access Token(PAT)を使用してConnect AI への接続を認証します。アクセス管理の粒度を維持するために、サービスごとに個別のPAT を作成することをお勧めします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして設定ページを開きます。
- Settings ページで「Access Tokens」セクションに移動し、 Create PAT をクリックします。
-
PAT に名前を付けて「Create」をクリックします。
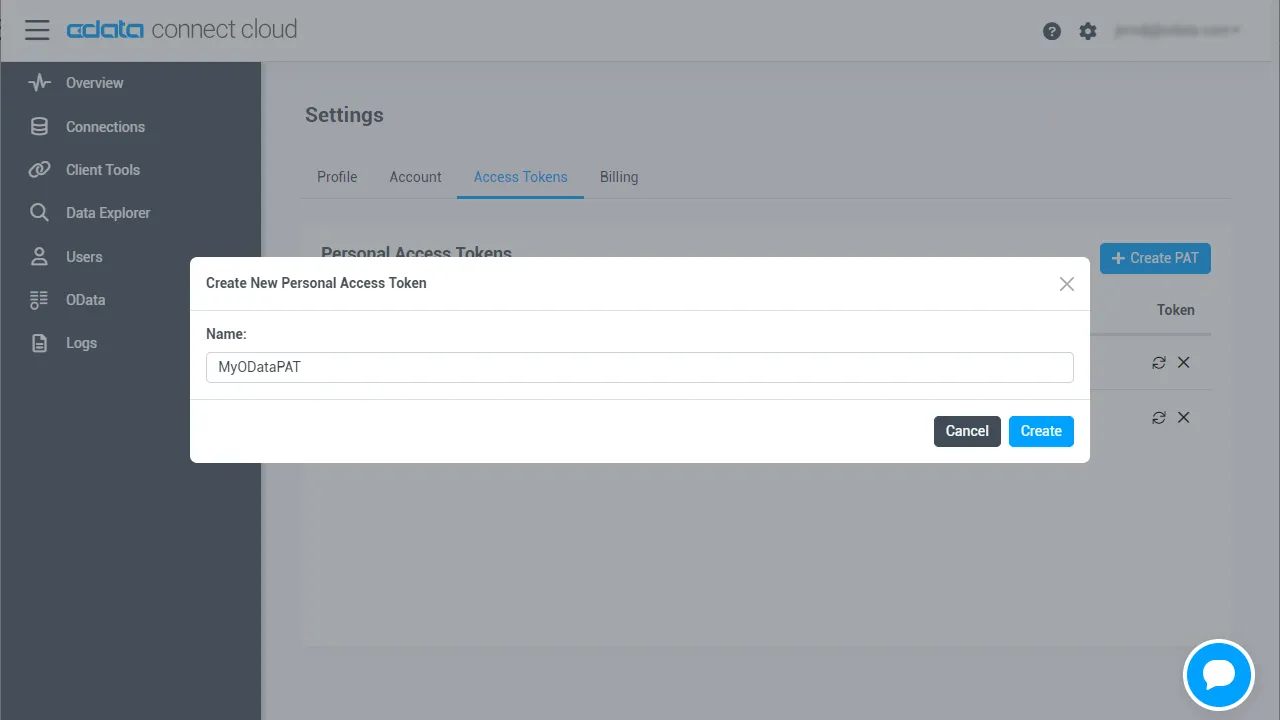
- Personal Access Token は作成時にのみ表示されるため、必ずコピーして安全な場所に保存してください。
接続の設定とPAT の生成が完了したら、PostgreSQL からHDFS のデータに接続する準備が整いました。
TDS Foreign Data Wrapper のビルド
Foreign Data Wrapper は、PostgreSQL を再コンパイルすることなく、PostgreSQL の拡張機能としてインストールできます。例として tds_fdw 拡張機能を使用します(https://github.com/tds-fdw/tds_fdw)。
- 以下のようにgit リポジトリをクローンしてビルドできます:
注意:複数のPostgreSQL バージョンがあり、デフォルト以外のバージョン用にビルドする場合は、まずpg_config のバイナリの場所を見つけてフルパスをメモし、make コマンドでUSE_PGXS=1 の後にPG_CONFIG=sudo apt-get install git git clone https://github.com/tds-fdw/tds_fdw.git cd tds_fdw make USE_PGXS=1 sudo make USE_PGXS=1 installを追加します。 - インストールが完了したら、サーバーを起動します:
sudo service postgresql start - 次に、Postgres データベースに入ります
注意:localhost の代わりにPostgreSQL がホストされているIP を指定することもできます。psql -h localhost -U postgres -d postgres
PostgreSQL データベースとしてHDFS のデータに接続し、データをクエリ!
拡張機能をインストールした後、以下の手順に従ってHDFS のデータへのクエリを開始します:
- データベースにログインします。
- データベース用の拡張機能をロードします:
CREATE EXTENSION tds_fdw; - HDFS のデータ 用のサーバーオブジェクトを作成します:
CREATE SERVER "HDFS1" FOREIGN DATA WRAPPER tds_fdw OPTIONS (servername'tds.cdata.com', port '14333', database 'HDFS1'); - Connect AI アカウントのメールアドレスとPersonal Access Token を使用してユーザーマッピングを設定します:
CREATE USER MAPPING for postgres SERVER "HDFS1" OPTIONS (username '[email protected]', password 'your_personal_access_token' ); - ローカルスキーマを作成します:
CREATE SCHEMA "HDFS1"; - ローカルデータベースに外部テーブルを作成します:
#table_name 定義を使用: CREATE FOREIGN TABLE "HDFS1".Files ( id varchar, ChildrenNum varchar) SERVER "HDFS1" OPTIONS(table_name 'HDFS.Files', row_estimate_method 'showplan_all'); #またはschema_name とtable_name 定義を使用: CREATE FOREIGN TABLE "HDFS1".Files ( id varchar, ChildrenNum varchar) SERVER "HDFS1" OPTIONS (schema_name 'HDFS', table_name 'Files', row_estimate_method 'showplan_all'); #またはquery 定義を使用: CREATE FOREIGN TABLE "HDFS1".Files ( id varchar, ChildrenNum varchar) SERVER "HDFS1" OPTIONS (query 'SELECT * FROM HDFS.Files', row_estimate_method 'showplan_all'); #またはリモートカラム名を設定: CREATE FOREIGN TABLE "HDFS1".Files ( id varchar, col2 varchar OPTIONS (column_name 'ChildrenNum')) SERVER "HDFS1" OPTIONS (schema_name 'HDFS', table_name 'Files', row_estimate_method 'showplan_all'); - これで、HDFS に対して読み取り/書き込みコマンドを実行できます:
SELECT id, ChildrenNum
FROM "HDFS1".Files;
詳細情報と無償トライアル
これで、リアルタイムのHDFS のデータからシンプルなクエリを作成できました。HDFS(およびその他200以上のデータソース)への接続の詳細については、Connect AI ページをご覧ください。無償トライアルに登録して、今すぐPostgreSQL でリアルタイムのHDFS のデータを活用してみてください。