


LangGraph と HubDB のデータを CData Connect AI で統合
LangGraph は、推論モデル(LLM)、ツール統合、データ操作を組み合わせたインテリジェントなグラフベースの AI ワークフローを構築・可視化するためのフレームワークです。CData Connect AI と統合することで、エージェントは標準化されたツールセットを通じてエンタープライズデータにリアルタイムでセキュアにアクセス、クエリ、操作できるようになります。
CData Connect AI は、HubDB などのデータソースを Model Context Protocol(MCP)を通じて公開できるマネージド MCP プラットフォームです。これにより、AI エージェントは複雑な ETL やカスタム統合なしに、数百種類のデータソースのメタデータ、カタログ、テーブル、SQL 対応のデータアクセスを操作できます。
この記事では、LangGraph で MCP エンドポイントを登録し、CData Connect AI を通じてデータソース接続を設定し、リアルタイムデータ(例:HubDB オブジェクト)をオンデマンドでクエリ・可視化するワークフローを構築する方法を説明します。また、組み込みの MCP ツールセット(getCatalogs、getSchemas、getTables、queryData など)を使用して、自然言語エージェントがエンタープライズデータとセキュアかつインタラクティブに対話できるようにする方法を示します。
前提条件
- CData Connect AI のアカウント
- Python バージョン 3.10 以上(LangGraph パッケージのインストール用)
- OpenAI API キーを生成して保存
- Visual Studio Code をシステムにインストール
- LangGraph から LangGraph API キーを取得して保存
ステップ1:LangGraph 用の HubDB 接続を設定
LangGraph が HubDB にアクセスする前に、CData Connect AI で HubDB 接続を作成する必要があります。この接続はリモート MCP サーバーを通じて LangGraph に公開されます。
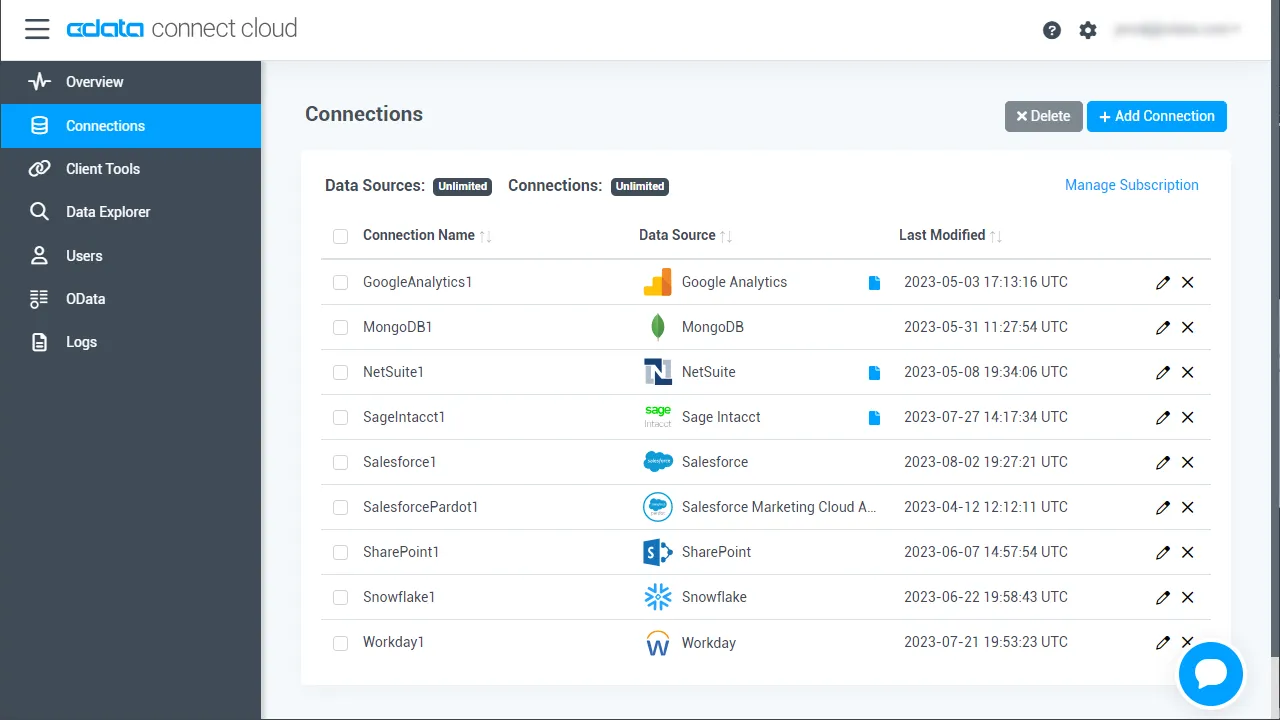
- Connect AI にログインして「Sources」をクリック、次に「+ Add Connection」をクリック
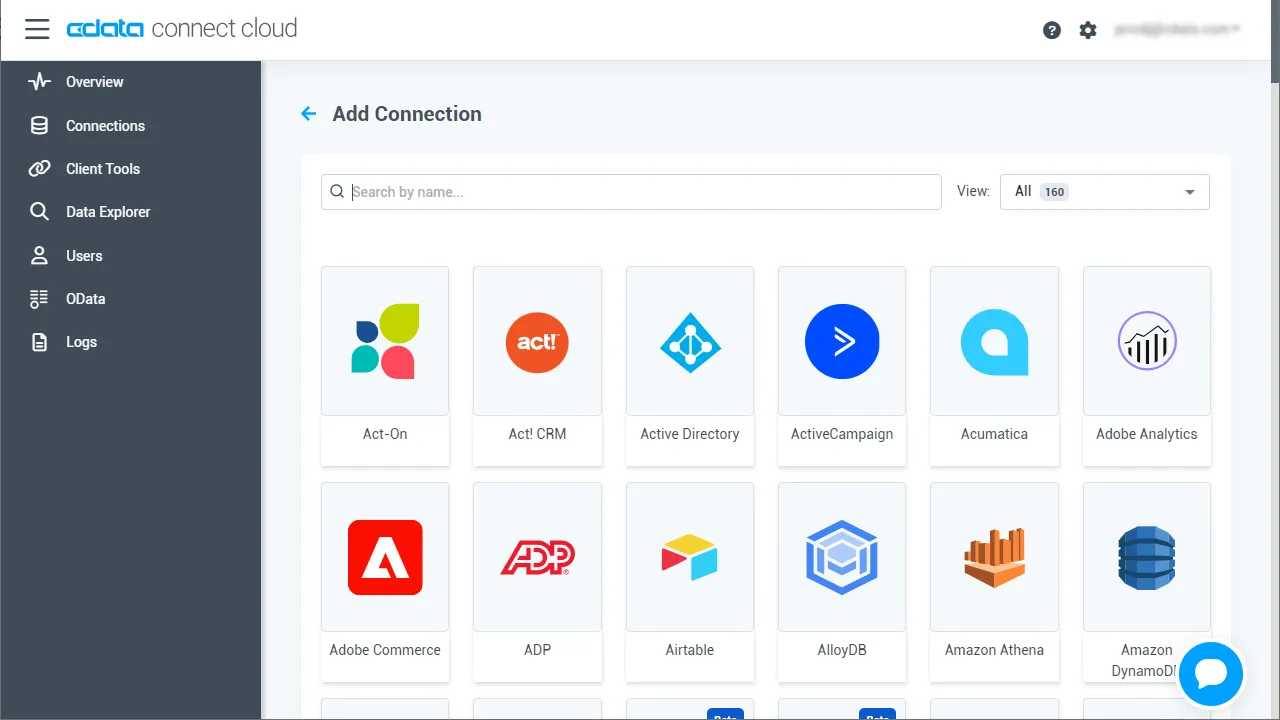
- 利用可能なデータソースから「HubDB」を選択
-
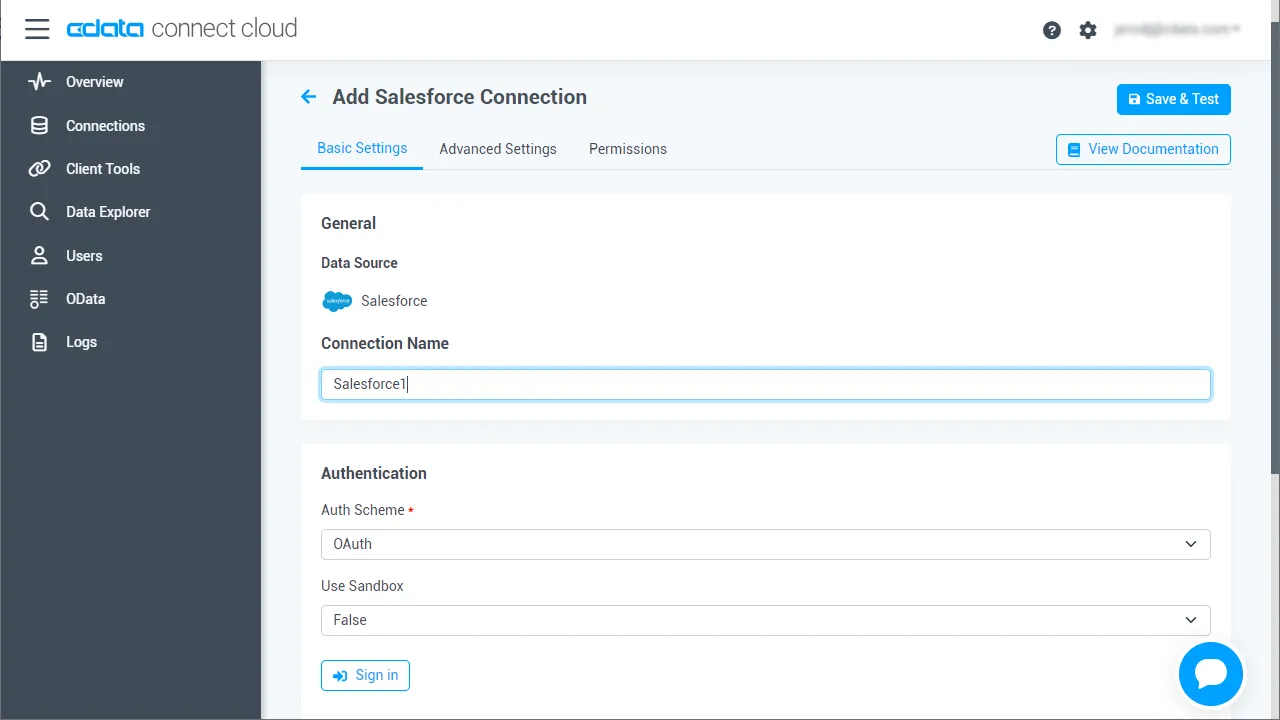
HubDB に接続するために必要な認証プロパティを入力します。
HubDBデータソースへの接続には、パブリックHubSpotアプリケーションを使用したOAuth認証とプライベートアプリケーショントークンを使用した認証の2つの方法があります。
カスタムOAuthアプリを使用する
すべてのOAuthフローでAuthSchemeを"OAuth"に設定する必要があります。特定の認証ニーズ(デスクトップアプリケーション、Webアプリケーション、ヘッドレスマシン)に必要な接続プロパティについては、ヘルプドキュメントを確認してください。
アプリケーションを登録し、OAuthクライアント認証情報を取得するには、以下の手順を実行してください。
- HubSpotアプリ開発者アカウントにログインします。
- アプリ開発者アカウントである必要があります。標準のHubSpotアカウントではパブリックアプリを作成できません。
- 開発者アカウントのホームページで、アプリタブをクリックします。
- アプリを作成をクリックします。
- アプリ情報タブで、ユーザーが接続する際に表示される値を入力し、必要に応じて変更します。これらの値には、パブリックアプリケーション名、アプリケーションロゴ、アプリケーションの説明が含まれます。
- 認証タブで、「リダイレクトURL」ボックスにコールバックURLを入力します。
- デスクトップアプリケーションを作成する場合は、http://localhost:33333のようなローカルにアクセス可能なURLに設定します。
- Webアプリケーションを作成する場合は、ユーザーがアプリケーションを承認した際にリダイレクトされる信頼できるURLに設定します。
- アプリを作成をクリックします。HubSpotがアプリケーションとそれに関連する認証情報を生成します。
- 認証タブで、クライアントIDとクライアントシークレットを確認します。これらは後でドライバーを設定する際に使用します。
スコープの下で、アプリケーションの意図する機能に必要なスコープを選択します。
テーブルにアクセスするには、最低限以下のスコープが必要です:
- hubdb
- oauth
- crm.objects.owners.read
- 変更を保存をクリックします。
- 統合に必要な機能にアクセスできる本番ポータルにアプリケーションをインストールします。
- 「インストールURL(OAuth)」の下で、完全なURLをコピーをクリックして、アプリケーションのインストールURLをコピーします。
- コピーしたリンクをブラウザで開きます。アプリケーションをインストールする標準アカウントを選択します。
- アプリを接続をクリックします。結果のタブは閉じて構いません。
プライベートアプリを使用する
HubSpotプライベートアプリケーショントークンを使用して接続するには、AuthSchemeプロパティを"PrivateApp"に設定します。
以下の手順に従ってプライベートアプリケーショントークンを生成できます:
- HubDBアカウントで、メインナビゲーションバーの設定アイコン(歯車)をクリックします。
- 左サイドバーメニューで、統合 > プライベートアプリに移動します。
- プライベートアプリを作成をクリックします。
- 基本情報タブで、アプリケーションの詳細(名前、ロゴ、説明)を設定します。
- スコープタブで、プライベートアプリケーションがアクセスできるようにしたい各スコープに対して読み取りまたは書き込みを選択します。
- テーブルにアクセスするには、最低限hubdbとcrm.objects.owners.readが必要です。
- アプリケーションの設定が完了したら、右上のアプリを作成をクリックします。
- アプリケーションのアクセストークンに関する情報を確認し、作成を続行をクリックし、その後トークンを表示をクリックします。
- コピーをクリックして、プライベートアプリケーショントークンをコピーします。
接続するには、PrivateAppTokenを取得したプライベートアプリケーショントークンに設定します。
- HubSpotアプリ開発者アカウントにログインします。
- 「Save & Test」をクリック
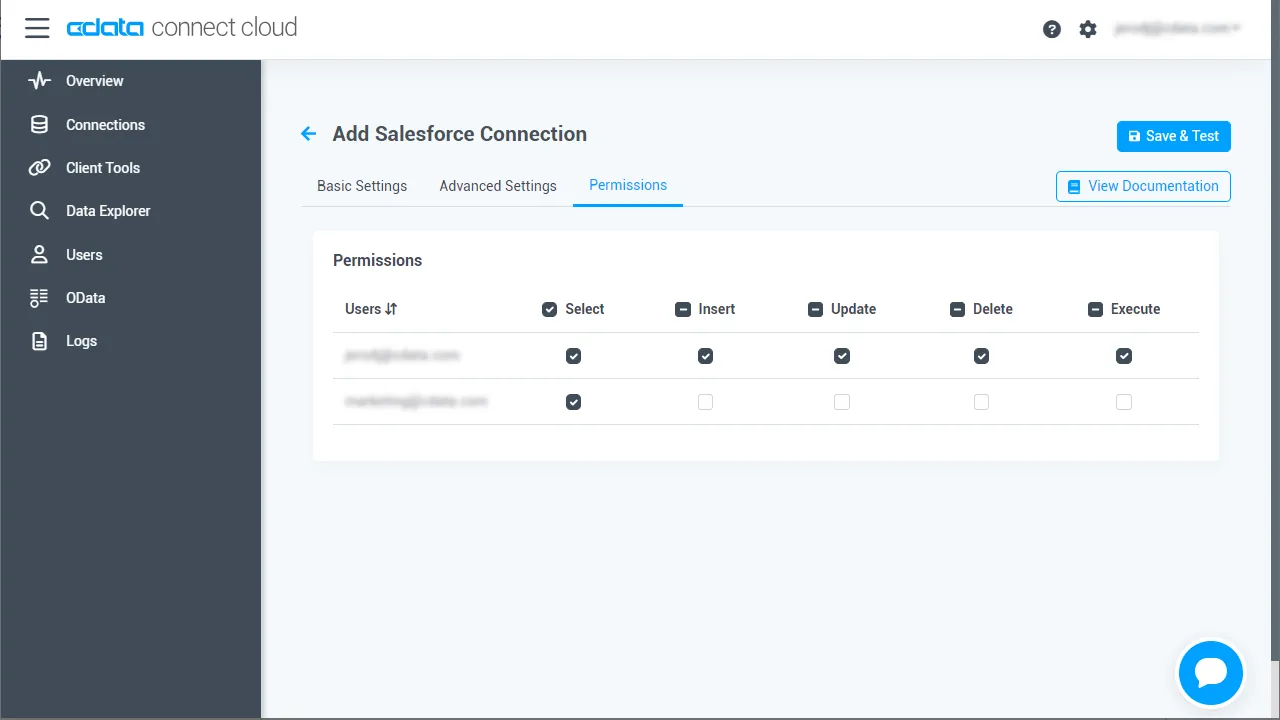
- 認証後、HubDB 接続の「Permissions」タブを開き、必要に応じてユーザーベースの権限を設定します
パーソナルアクセストークン(PAT)を生成
LangGraph はアカウントのメールアドレスとパーソナルアクセストークン(PAT)を使用して Connect AI に認証します。きめ細かなアクセス制御を維持するため、統合ごとに個別の PAT を作成することをお勧めします。
- Connect AI で、右上の「歯車アイコン」を選択して「Settings」を開きます
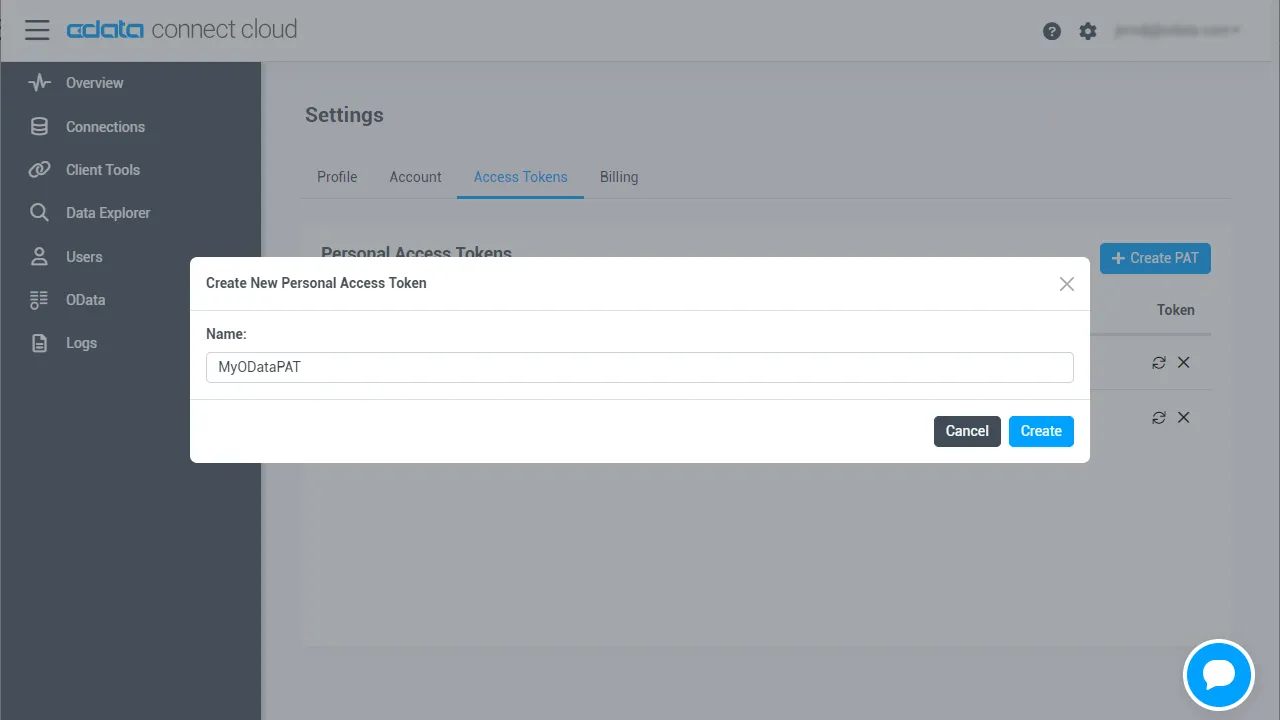
- 「Access Tokens」で「Create PAT」を選択します
- トークンにわかりやすい名前を付けて「Create」を選択します
- トークンをコピーして安全に保管します。PAT は作成時にのみ表示されます
HubDB 接続が設定され PAT が生成されたので、LangGraph は CData MCP サーバーを通じてHubDB のデータに接続する準備が整いました。
ステップ2:開発環境をセットアップ
LangGraph と CData Connect AI を接続し、OpenAI LLM を推論に使用するためのプロジェクトディレクトリをセットアップし、必要な依存関係をインストールします。このセットアップにより、LangGraph は Connect AI が公開する HubDB MCP サーバーツールを呼び出し、OpenAI が自然言語推論を処理できるようになります。
- LangGraph プロジェクト用の新しいフォルダを作成します:
mkdir LangGraph cd LangGraph - 必要な Python パッケージをインストールします:
pip install langgraph langchain-openai langchain-mcp-adapters python-dotenv "langgraph-cli[inmem]" - Python 3.10 以上と有効な OpenAI API キーが環境に設定されていることを確認します。
ステップ3:MCP 接続の環境変数を設定
LangGraph は環境変数を使用して CData Connect AI に接続し、API 認証情報と設定を定義します。これらの認証情報を .env ファイルに保存して、セキュアで再利用可能にします。LangGraph は実行時にこのファイルを自動的に読み込むため、スクリプトは機密情報をハードコードすることなく MCP サーバーに認証・通信できます。
- プロジェクトディレクトリに .env という新しいファイルを作成します。
- 以下の環境変数を追加して、LangGraph、CData Connect AI、OpenAI の設定を定義します:
# LangSmith(オプション) LANGSMITH_API_KEY=lsv2_pt_xxxx #LangSmith API Key LANGCHAIN_TRACING_V2=true LANGCHAIN_PROJECT=LangGraph-Demo # MCP 設定 MCP_BASE_URL=https://mcp.cloud.cdata.com/mcp #MCP サーバー URL MCP_AUTH=base64encoded(EMAIL:PAT) #Base64 エンコードされた Connect AI Email:PAT OPENAI_API_KEY=sk-proj-xxxx - ファイルを保存します。LangGraph はこれらの値を使用して CData Connect AI の HubDB MCP サーバーに認証し、HubDB のデータに接続し、推論用に OpenAI モデルを初期化します。
注意: Base64 エンコードされた認証文字列は、Base64 エンコードツールなどのオンライン Base64 エンコーダーを使用して生成できます。前提条件で取得した CData Connect AI のユーザー名と PAT をエンコードしてください。
ステップ4:LangGraph エージェントスクリプトを作成
このステップでは、LangGraph を CData Connect AI MCP サーバーに接続する Python スクリプトを作成します。スクリプトは getCatalogs、getSchemas、queryData などの利用可能な MCP ツールを取得し、LangGraph ワークフローを構築し、接続されたHubDB のデータに対して自然言語プロンプトを実行します。
ワークフローは MCP を使用して Connect AI からリアルタイムのHubDB のデータをセキュアに取得し、OpenAI GPT-4o を使用してそのデータを解釈・推論します。 また、後で LangGraph Studio で可視化できるようにグラフを公開します。
ファイルを作成
LangGraph プロジェクトフォルダ内に test.py という新しい Python ファイルを作成します。
以下のコードを追加
test.py に以下のスクリプトを使用します:
import asyncio
import os
import operator
from typing_extensions import TypedDict, Annotated
from dotenv import load_dotenv

from langgraph.graph import StateGraph, START, END
from langchain.agents import create_agent
from langchain_mcp_adapters.client import MultiServerMCPClient
from langchain_openai import ChatOpenAI
from langchain_core.messages import BaseMessage, HumanMessage

# Load environment variables
load_dotenv()

# Define the agent state
class AgentState(TypedDict):
    messages: Annotated[list[BaseMessage], operator.add]

# Define the async agent logic
async def run_agent(user_prompt: str) -> str:
    MCP_BASE_URL = os.getenv("MCP_BASE_URL")
    MCP_AUTH = os.getenv("MCP_AUTH")
    OPENAI_API_KEY = os.getenv("OPENAI_API_KEY")

    print("Connecting to the MCP server...")
    mcp_client = MultiServerMCPClient(
        connections={
            "default": {
                "transport": "streamable_http",
                "url": MCP_BASE_URL,
                "headers": {"Authorization": f"Basic {MCP_AUTH}"} if MCP_AUTH else {},
            }
        }
    )

    print("Loading available MCP tools...")
    all_mcp_tools = await mcp_client.get_tools()
    print(f"Loaded tools: {[tool.name for tool in all_mcp_tools]}")

    # Initialize the LLM
    llm = ChatOpenAI(model="gpt-4o", temperature=0.2, api_key=OPENAI_API_KEY)

    print("Creating the LangGraph agent...")
    agent = create_agent(
        model=llm,
        tools=all_mcp_tools,
        system_prompt="You are a helpful assistant. Use tools when needed."
    )

    # Build the workflow graph
    builder = StateGraph(AgentState)
    builder.add_node("agent", agent)
    builder.add_edge(START, "agent")
    builder.add_edge("agent", END)
    graph_instance = builder.compile()

    print(f"Processing user query: {user_prompt}\n")
    initial_state = {"messages": [HumanMessage(content=user_prompt)]}
    result = await graph_instance.ainvoke(initial_state)
    print(f"Agent Response:\n{result['messages'][-1].content}")

# Expose the graph for visualization
builder = StateGraph(AgentState)
builder.add_node(
    "agent",
    create_agent(
        model=ChatOpenAI(model="gpt-4o", temperature=0.2, api_key=os.getenv("OPENAI_API_KEY")),
        tools=[],
        system_prompt="You are a helpful assistant."
    )
)
builder.add_edge(START, "agent")
builder.add_edge("agent", END)
graph = builder.compile()

if __name__ == "__main__":
    import argparse
    parser = argparse.ArgumentParser()
    parser.add_argument("--serve", action="store_true", help="Run visualization server")
    args = parser.parse_args()

    if args.serve:
        print("To visualize the graph, run:")
        print("langgraph dev")
    else:
        asyncio.run(run_agent("List the first 2 catalogs available"))
ステップ5:LangGraph プロジェクトを設定
CLI がワークフローグラフと環境設定を認識できるように LangGraph プロジェクトを設定します。LangGraph Studio での使用またはローカル可視化実行中にグラフを登録する設定ファイルを作成します。
設定ファイルを作成
プロジェクトディレクトリに langgraph.json という新しいファイルを作成します。
以下の設定を追加
langgraph.json ファイルに以下の内容を使用します:
{
  "dependencies": ["."],
  "graphs": {
    "agent": "./test.py:graph"
  },
  "env": ".env"
}
ステップ6:LangGraph で HubDB をプロンプト(Connect AI 経由)
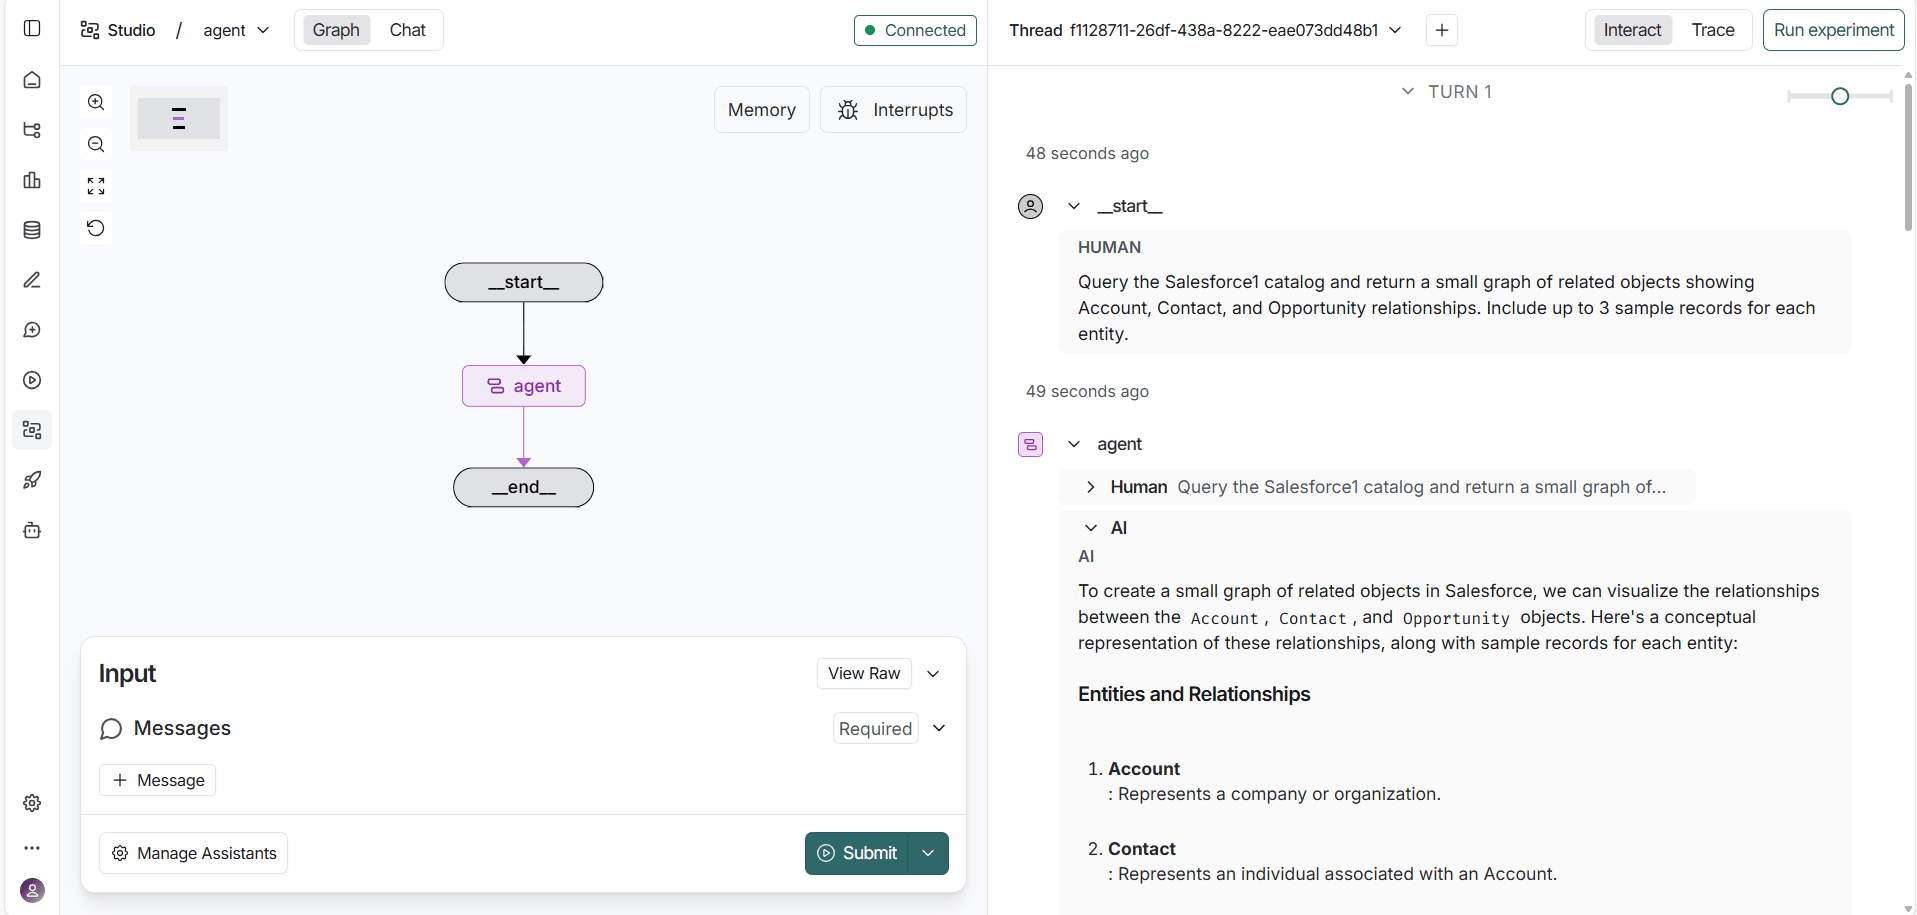
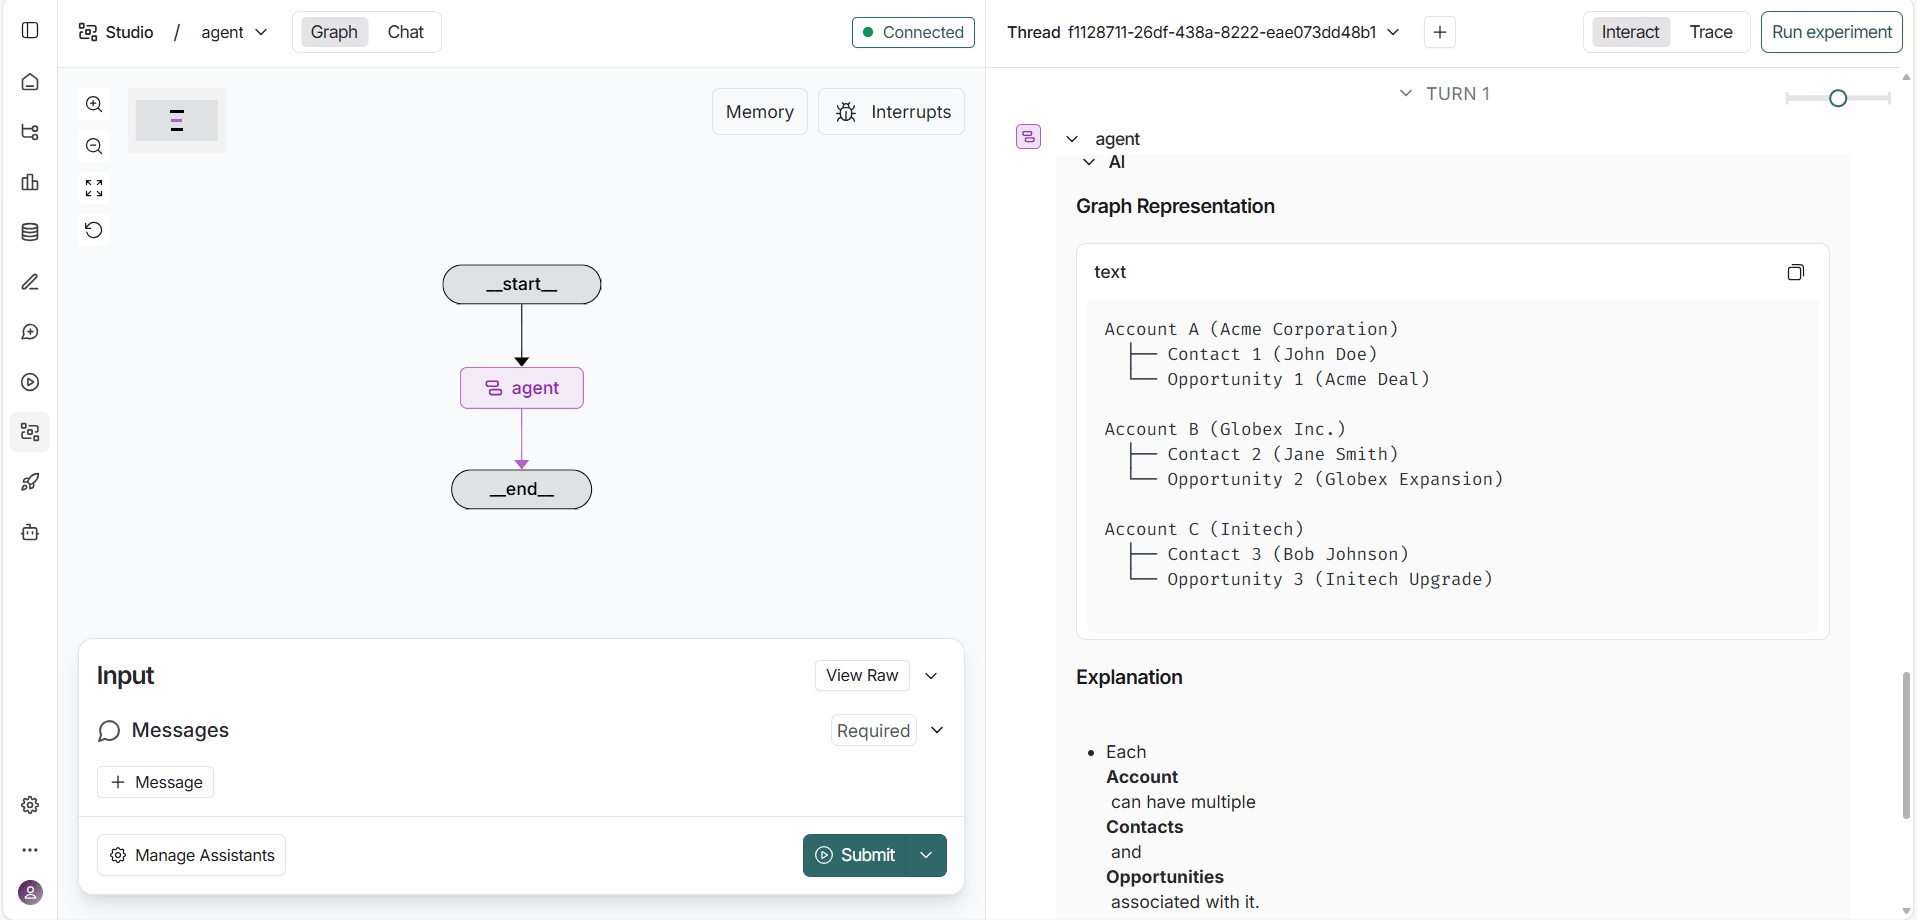
LangGraph 開発サーバーを実行して、LangGraph Studio でワークフローを表示し対話します。これにより、エージェントがプロンプトを処理し、ツールを呼び出し、MCP サーバーを通じてHubDB のデータを取得する様子を直接可視化できます。
LangGraph 開発サーバーを起動
プロジェクトディレクトリでターミナルを開き、以下を実行します:
langgraph dev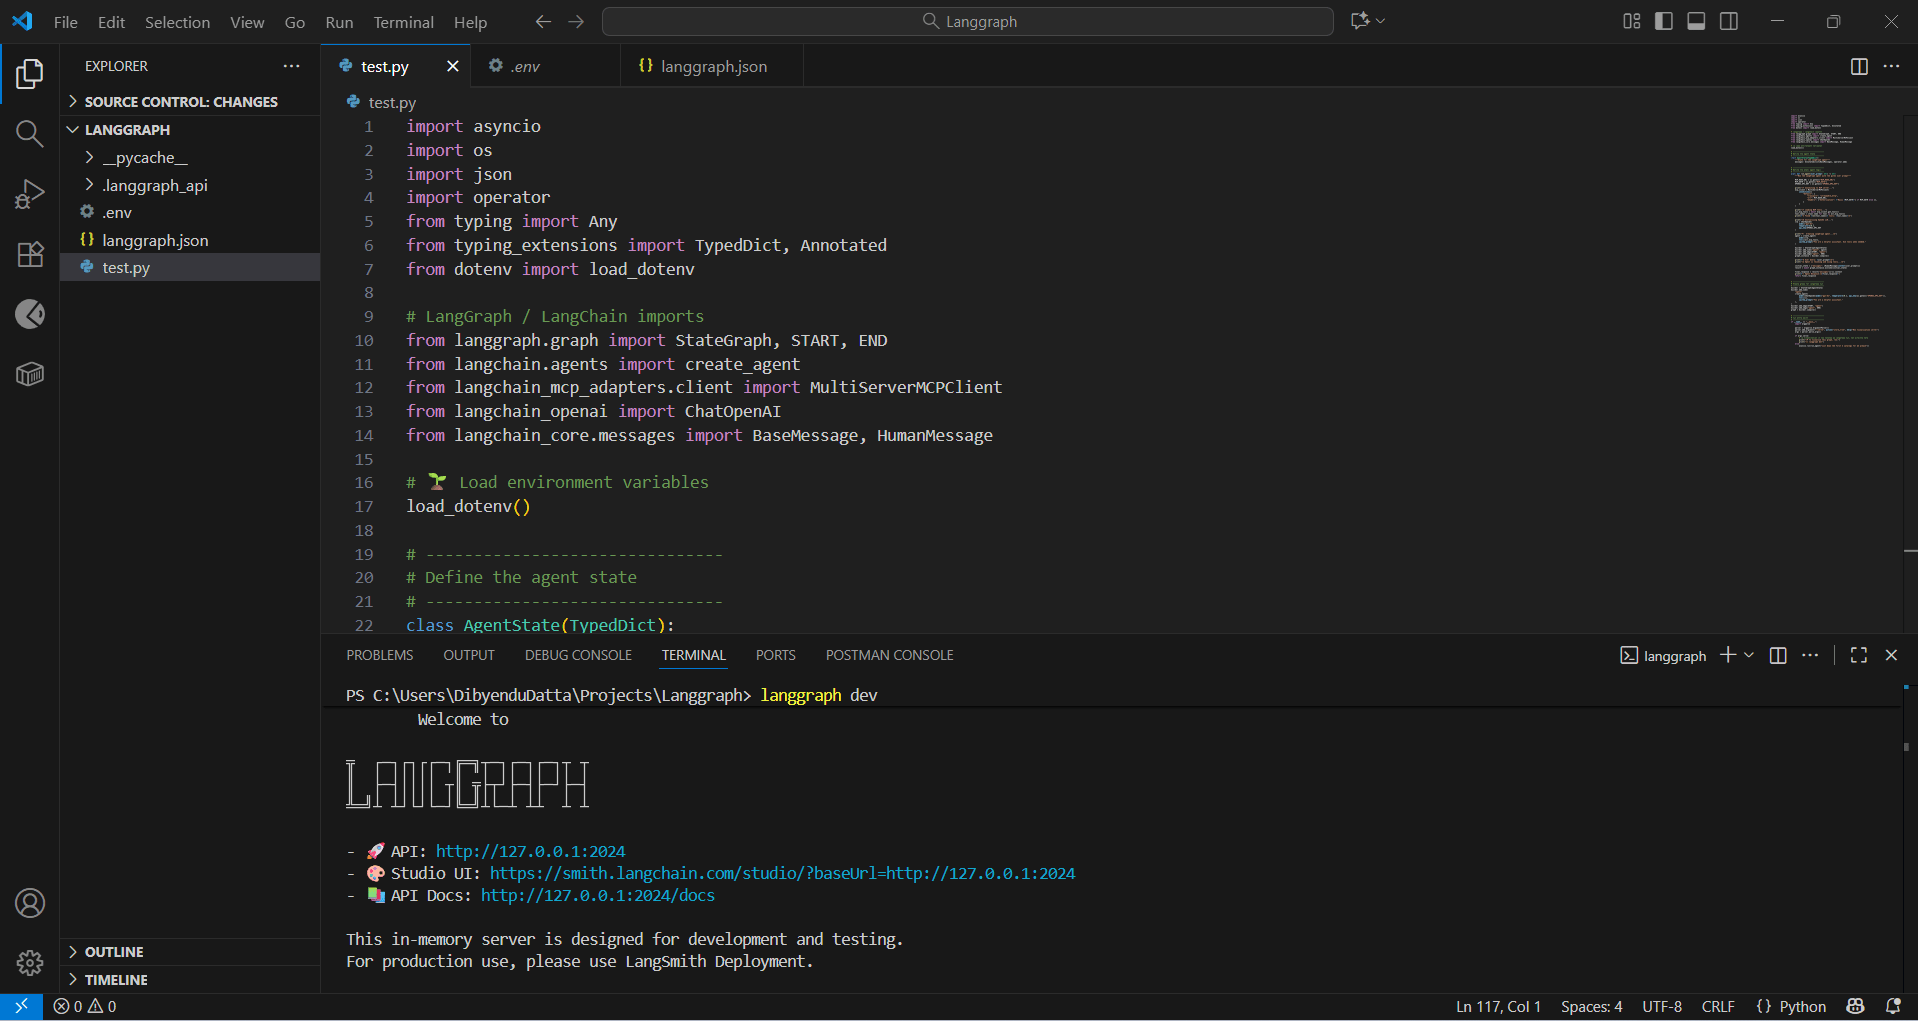
Studio インターフェースにアクセス
サーバーが起動すると、LangGraph はローカル API を起動し、Studio UI へのリンクを提供します:
https://smith.langchain.com/studio/?baseUrl=http://127.0.0.1:2024通常、コマンド実行時にリンクは自動的に開きます。開かない場合は、ブラウザでこのリンクを開いて LangGraph Studio ダッシュボードをロードしてください。
エージェントと対話
Studio インターフェースで、以下のような自然言語プロンプトを入力します:
カタログで利用可能なすべての HubDB テーブルを表示LangGraph はエージェントの推論フローをリアルタイムで可視化し、プロンプトの解釈、適切な MCP ツールの呼び出し、HubDB からのリアルタイムデータの取得の様子を表示します。
CData Connect AI を入手
数百種類の SaaS、ビッグデータ、NoSQL ソースへのリアルタイムデータアクセスをクラウドアプリケーションから直接取得するには、CData Connect AI を今すぐお試しください!