


HubDB のデータをPythonのpandasで可視化する方法|CData Connect AI
CData Connect AI Python SDKをpandasとMatplotlibに接続すると、パーソナルアクセストークンで認証するだけでリアルタイムのHubDB のデータをDataFrameに読み込み、そのままグラフとして可視化できます。SQLAlchemyエンジンの設定やソースごとのドライバーインストールは不要です。
Python は豊富なモジュールのエコシステムを備えているため、素早く作業に取りかかり、システムをより効果的に連携できます。CData Connect AI Python SDK と pandas、Matplotlib のモジュールを使えば、HubDB のデータを可視化する HubDB 連携の Python アプリケーションやスクリプトを構築できます。この記事では、Connect AI に接続し、pandas と Matplotlib の組み込み関数を使ってHubDB のデータをクエリし、その結果を可視化する方法をご紹介します。
Connect AI Python SDK(cdata-connect-ai)は DB-API 2.0(PEP 249)に準拠したクライアントなので、pandas は SDK の接続オブジェクトから直接クエリ結果を読み取れます。ソースごとにドライバーをインストールする必要も、SQLAlchemy のエンジンを設定する必要もありません。パーソナルアクセストークンで接続して、その接続をそのまま pandas.read_sql に渡すだけです。
Connect AI で HubDB に接続する方法は?
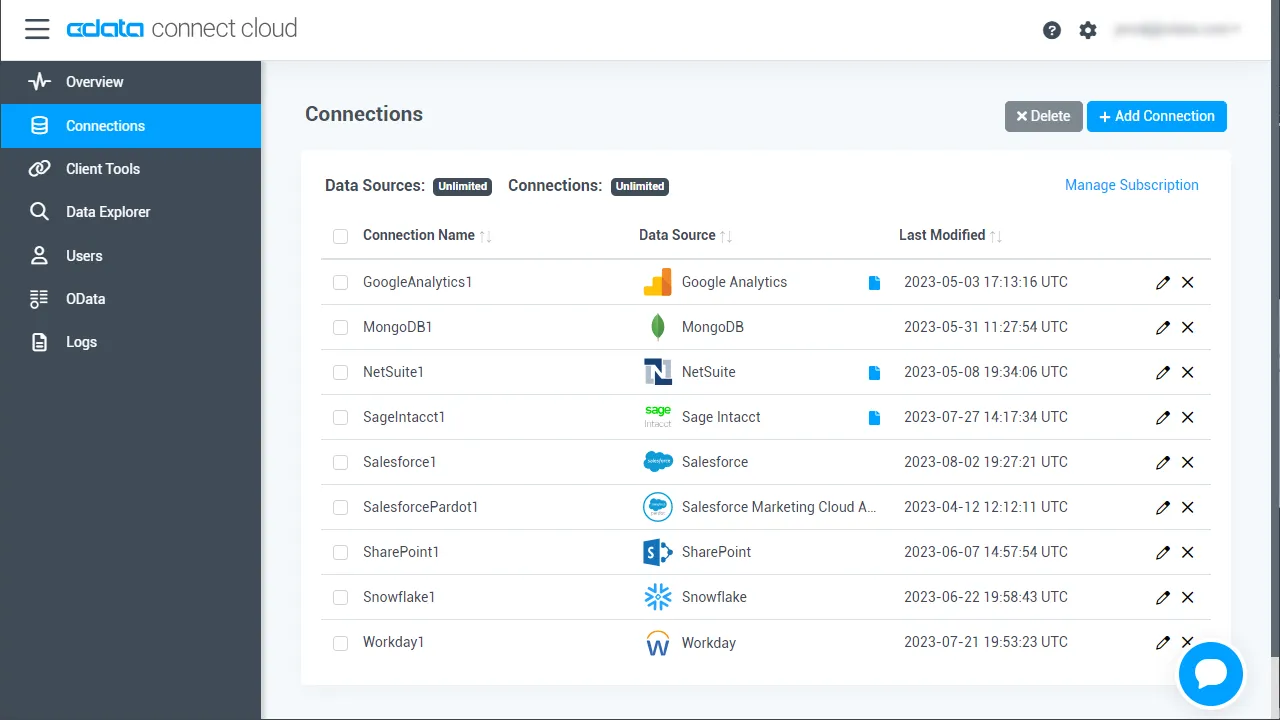
CData Connect AI では、直感的なクリック操作ベースのインターフェースでデータソースに接続できます。
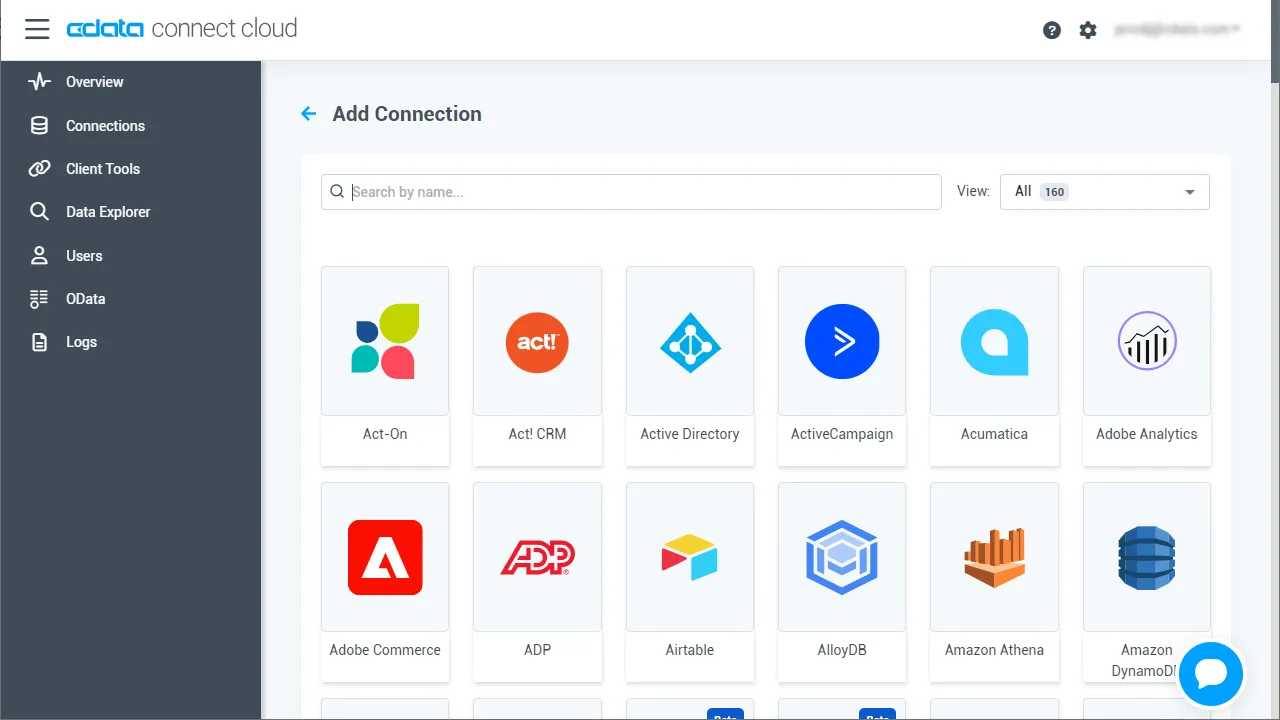
- Connect AI にログインし、Sources をクリックして、 Add Connection をクリックします
- 「Add Connection」パネルから「HubDB」を選択します
-
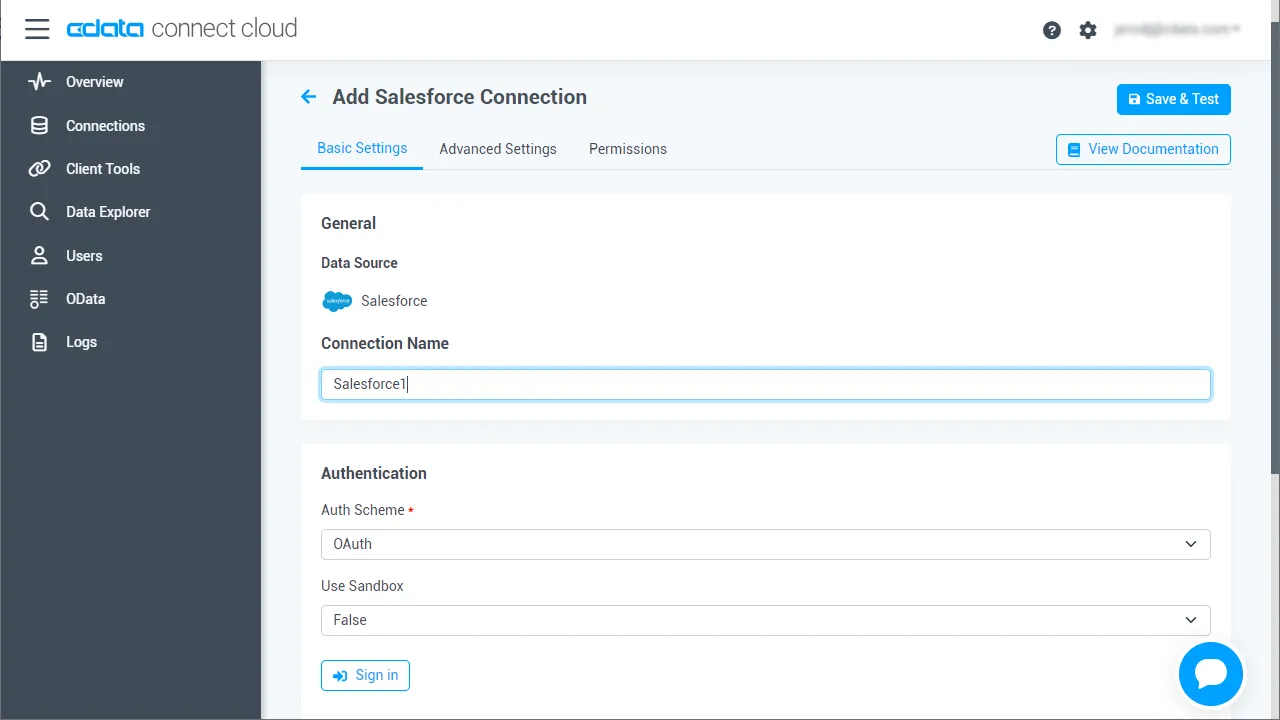
HubDB に接続するために必要な認証プロパティを入力します。
HubDBデータソースへの接続には、パブリックHubSpotアプリケーションを使用したOAuth認証とプライベートアプリケーショントークンを使用した認証の2つの方法があります。
カスタムOAuthアプリを使用する
すべてのOAuthフローでAuthSchemeを"OAuth"に設定する必要があります。特定の認証ニーズ(デスクトップアプリケーション、Webアプリケーション、ヘッドレスマシン)に必要な接続プロパティについては、ヘルプドキュメントを確認してください。
アプリケーションを登録し、OAuthクライアント認証情報を取得するには、以下の手順を実行してください。
- HubSpotアプリ開発者アカウントにログインします。
- アプリ開発者アカウントである必要があります。標準のHubSpotアカウントではパブリックアプリを作成できません。
- 開発者アカウントのホームページで、アプリタブをクリックします。
- アプリを作成をクリックします。
- アプリ情報タブで、ユーザーが接続する際に表示される値を入力し、必要に応じて変更します。これらの値には、パブリックアプリケーション名、アプリケーションロゴ、アプリケーションの説明が含まれます。
- 認証タブで、「リダイレクトURL」ボックスにコールバックURLを入力します。
- デスクトップアプリケーションを作成する場合は、http://localhost:33333のようなローカルにアクセス可能なURLに設定します。
- Webアプリケーションを作成する場合は、ユーザーがアプリケーションを承認した際にリダイレクトされる信頼できるURLに設定します。
- アプリを作成をクリックします。HubSpotがアプリケーションとそれに関連する認証情報を生成します。
- 認証タブで、クライアントIDとクライアントシークレットを確認します。これらは後でドライバーを設定する際に使用します。
スコープの下で、アプリケーションの意図する機能に必要なスコープを選択します。
テーブルにアクセスするには、最低限以下のスコープが必要です:
- hubdb
- oauth
- crm.objects.owners.read
- 変更を保存をクリックします。
- 統合に必要な機能にアクセスできる本番ポータルにアプリケーションをインストールします。
- 「インストールURL(OAuth)」の下で、完全なURLをコピーをクリックして、アプリケーションのインストールURLをコピーします。
- コピーしたリンクをブラウザで開きます。アプリケーションをインストールする標準アカウントを選択します。
- アプリを接続をクリックします。結果のタブは閉じて構いません。
プライベートアプリを使用する
HubSpotプライベートアプリケーショントークンを使用して接続するには、AuthSchemeプロパティを"PrivateApp"に設定します。
以下の手順に従ってプライベートアプリケーショントークンを生成できます:
- HubDBアカウントで、メインナビゲーションバーの設定アイコン(歯車)をクリックします。
- 左サイドバーメニューで、統合 > プライベートアプリに移動します。
- プライベートアプリを作成をクリックします。
- 基本情報タブで、アプリケーションの詳細(名前、ロゴ、説明)を設定します。
- スコープタブで、プライベートアプリケーションがアクセスできるようにしたい各スコープに対して読み取りまたは書き込みを選択します。
- テーブルにアクセスするには、最低限hubdbとcrm.objects.owners.readが必要です。
- アプリケーションの設定が完了したら、右上のアプリを作成をクリックします。
- アプリケーションのアクセストークンに関する情報を確認し、作成を続行をクリックし、その後トークンを表示をクリックします。
- コピーをクリックして、プライベートアプリケーショントークンをコピーします。
接続するには、PrivateAppTokenを取得したプライベートアプリケーショントークンに設定します。
- HubSpotアプリ開発者アカウントにログインします。
- 「Save & Test」をクリックします
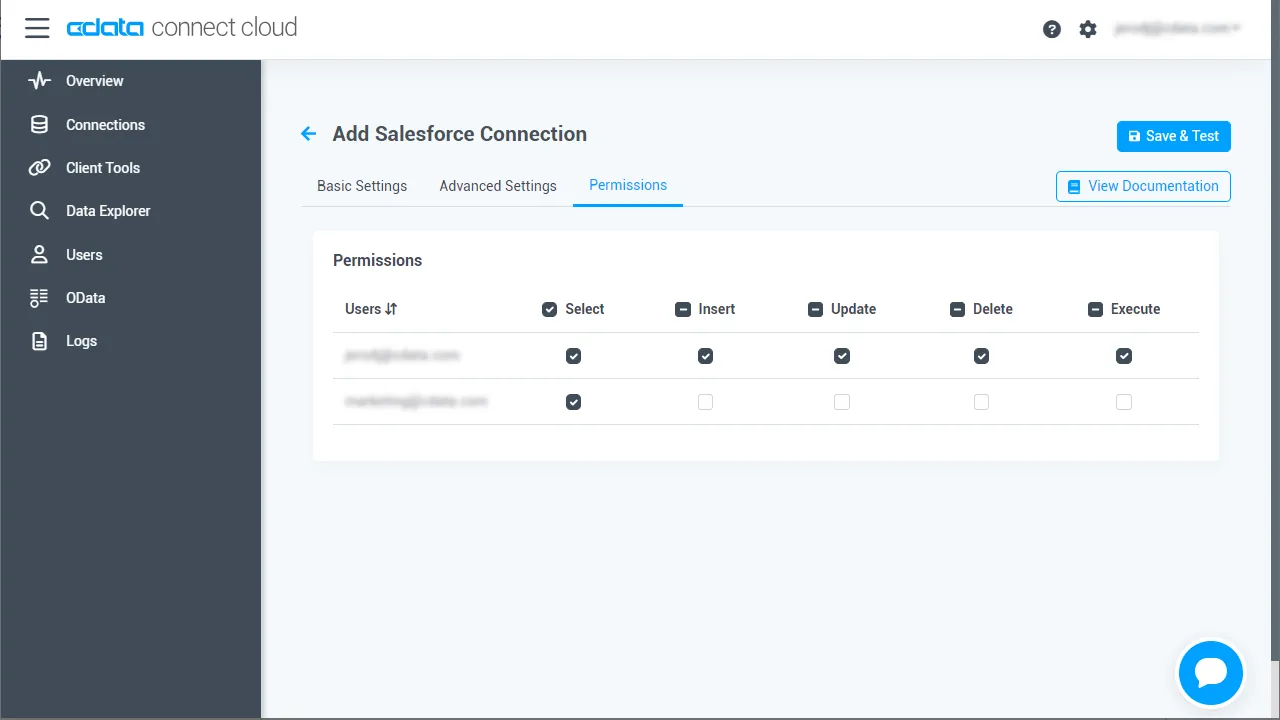
- 「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークン(PAT)を生成する
Python SDK は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使って Connect AI に認証します。アクセスの粒度を保つために、アプリケーションごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
- 設定ページの Access Tokens セクションに移動し、 Create PAT をクリックします。
- PAT に名前を付けて Create をクリックします。
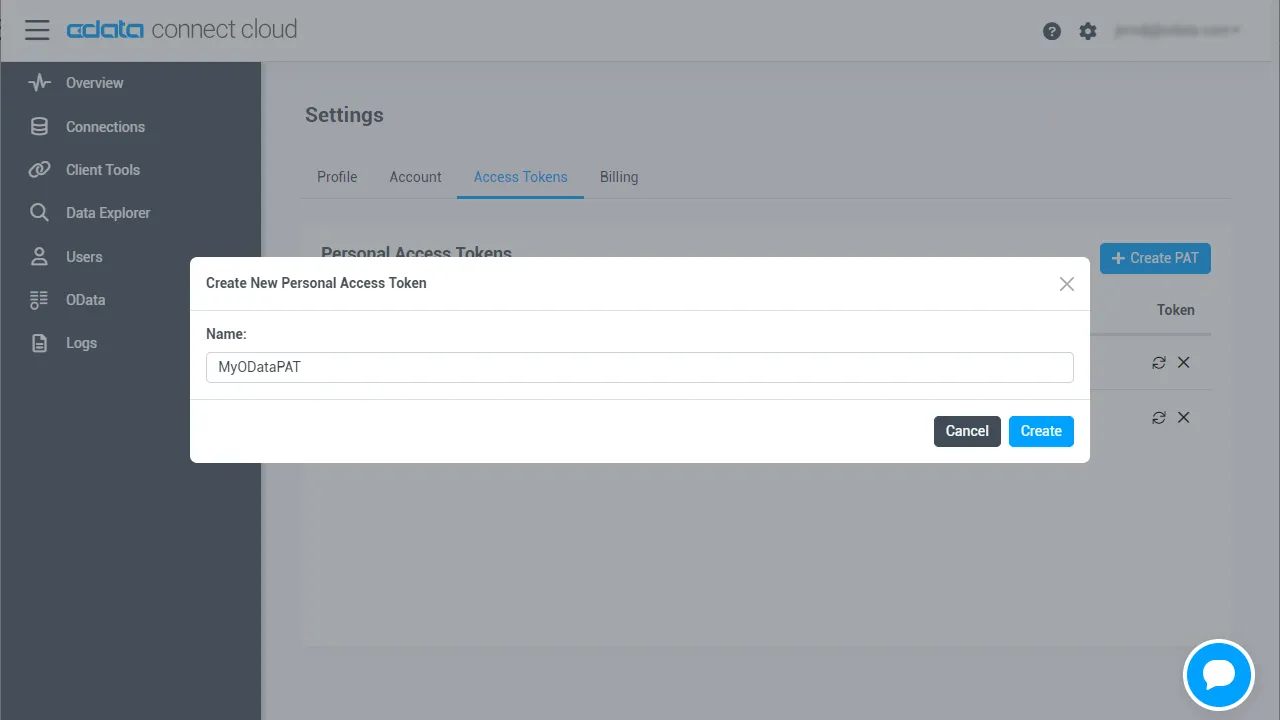
- パーソナルアクセストークンは作成時にのみ表示されます。必ずコピーして安全な場所に保管してください。
必要なモジュールをインストールする
pip ユーティリティを使って、SDK(pandas エクストラ付き)と Matplotlib をインストールします。
pip install "cdata-connect-ai[full]"
pip install matplotlib
Python で HubDB のデータを可視化する
モジュールをインポートし、アカウントのメールアドレスと PAT で Connect AI に接続します。識別子は <Connection>.<Schema>.<Table> という3つの部分で構成されており、接続名はデフォルトでソース名(例:HubDB1)になります。
import pandas
import matplotlib.pyplot as plt
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)
pandas で HubDB をクエリする
pandas の read_sql 関数を使って SQL ステートメントを実行し、結果セットを DataFrame に格納します。エンジンは不要で、SDK の接続をそのまま渡すだけです。
df = pandas.read_sql(
    "SELECT PartitionKey, Name "
    "FROM [HubDB1].[HubDB].[NorthwindProducts] "
    "WHERE Id = '1'",
    conn,
)
注意:pandas が、公式にサポートしているのは SQLAlchemy の接続のみであるという UserWarning を出力する場合があります。これは DB-API 接続を直接渡したときに想定される動作です。クエリは正しく実行されるため、この警告は無視して問題ありません。
HubDB のデータを可視化する
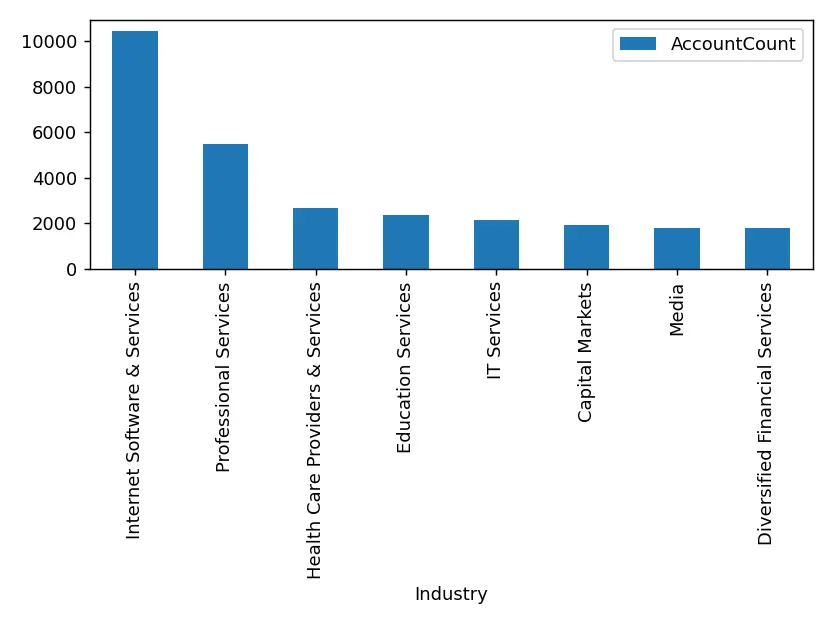
クエリ結果を DataFrame に格納したら、plot 関数を使ってチャートを作成します。show メソッドを使うと、チャートが新しいウィンドウに表示されます。
df.plot(kind="bar", x="PartitionKey", y="Name")
plt.show()

conn.close()
関連情報と無料トライアル
これで、CData Connect AI Python SDK を通じて、リアルタイムのHubDB のデータを pandas に読み込めるようになりました。HubDB(および数百種類のその他のデータソース)への接続について詳しくは、Connect AI のページをご覧ください。
CData Connect AI の詳細、または無料トライアルにお申し込みください:
完全なソースコード
import pandas
import matplotlib.pyplot as plt
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)

df = pandas.read_sql(
    "SELECT PartitionKey, Name "
    "FROM [HubDB1].[HubDB].[NorthwindProducts] "
    "WHERE Id = '1'",
    conn,
)

df.plot(kind="bar", x="PartitionKey", y="Name")
plt.show()

conn.close()