


HubDB のデータにPythonで接続する方法|CData Connect AI SDK
CData Connect AI Python SDK を使うと、標準的なDB-API 2.0のPythonコードでHubDB のデータをそのまま読み書きできます。プログラミング不要の他ツールと異なり、pandasやpetlなど既存のPythonエコシステムにそのまま組み込めます。パッケージのインストールからクエリ実行まで3ステップで完了します。
CData Connect AI Python SDK(cdata-connect-ai)は DB-API 2.0(PEP 249)に準拠したクライアントで、標準的な Python のデータベースコードでリアルタイムのHubDB のデータを取得・操作できます。接続まわりは Connect AI が引き受けてくれるので、パッケージを1つインストールしてパーソナルアクセストークンで認証するだけで、HubDB(および Connect AI に接続済みのその他すべてのソース)にクエリを実行できます。しかも sqlite3 や psycopg2 といったライブラリでおなじみの connect() / cursor() / fetchall() という同じパターンをそのまま使えます。
この記事では、Connect AI で HubDB に接続し、パーソナルアクセストークンを生成して SDK をインストールし、リアルタイムのHubDB のデータを読み取る(対応している場合は書き込む)までの流れをご紹介します。
事前準備
- CData Connect AI のアカウント
- Python 3.8 以降
- 有効な認証情報を持つアクティブな HubDB アカウント
Connect AI で HubDB に接続する方法は?
CData Connect AI では、直感的なクリック操作ベースのインターフェースでデータソースに接続できます。
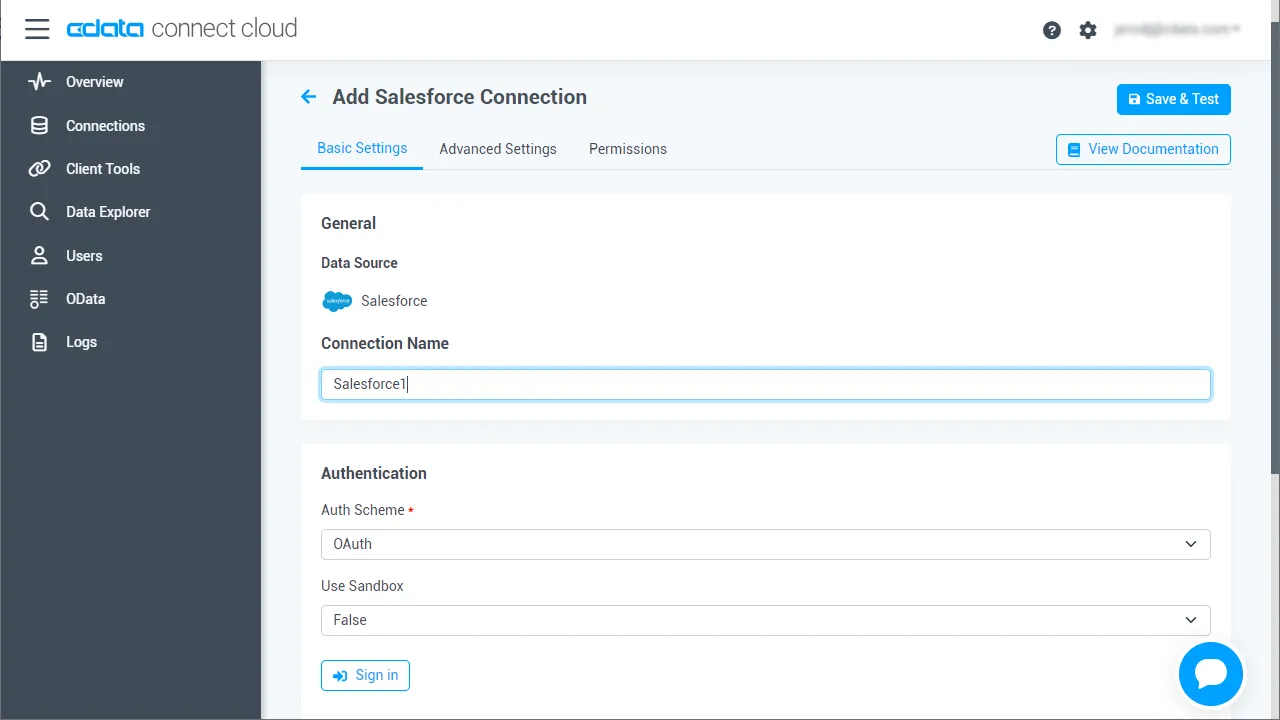
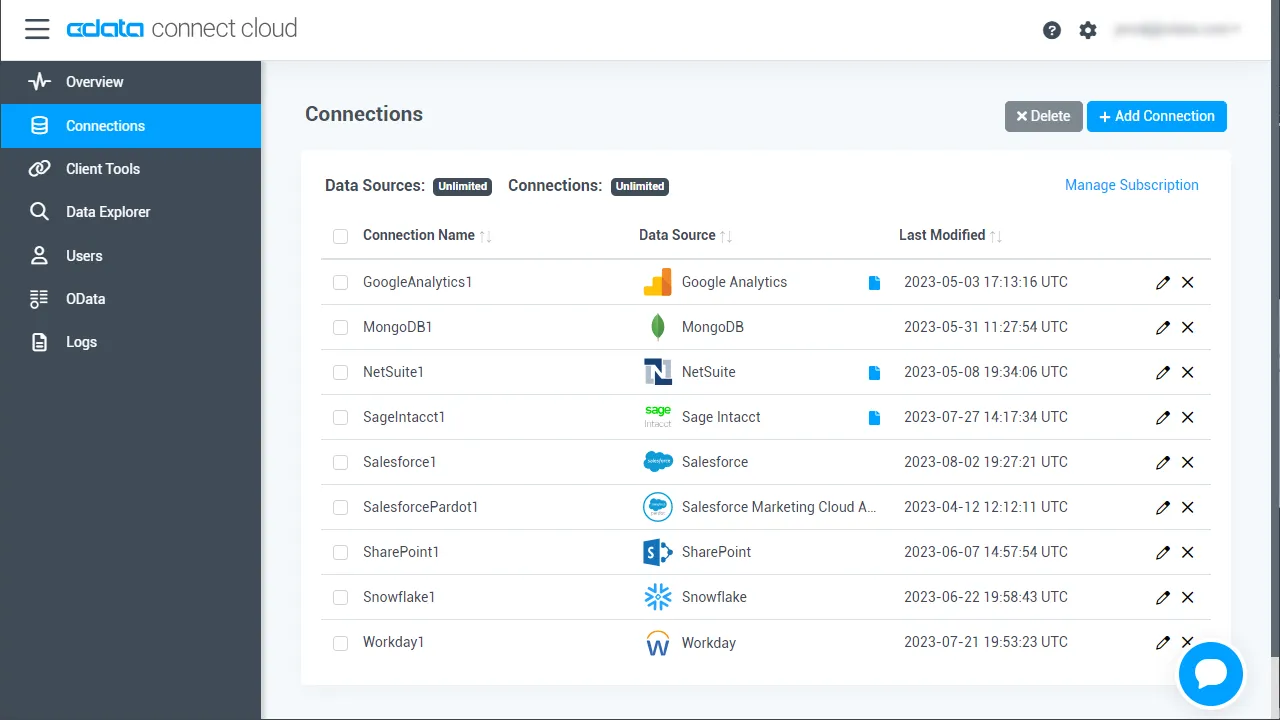
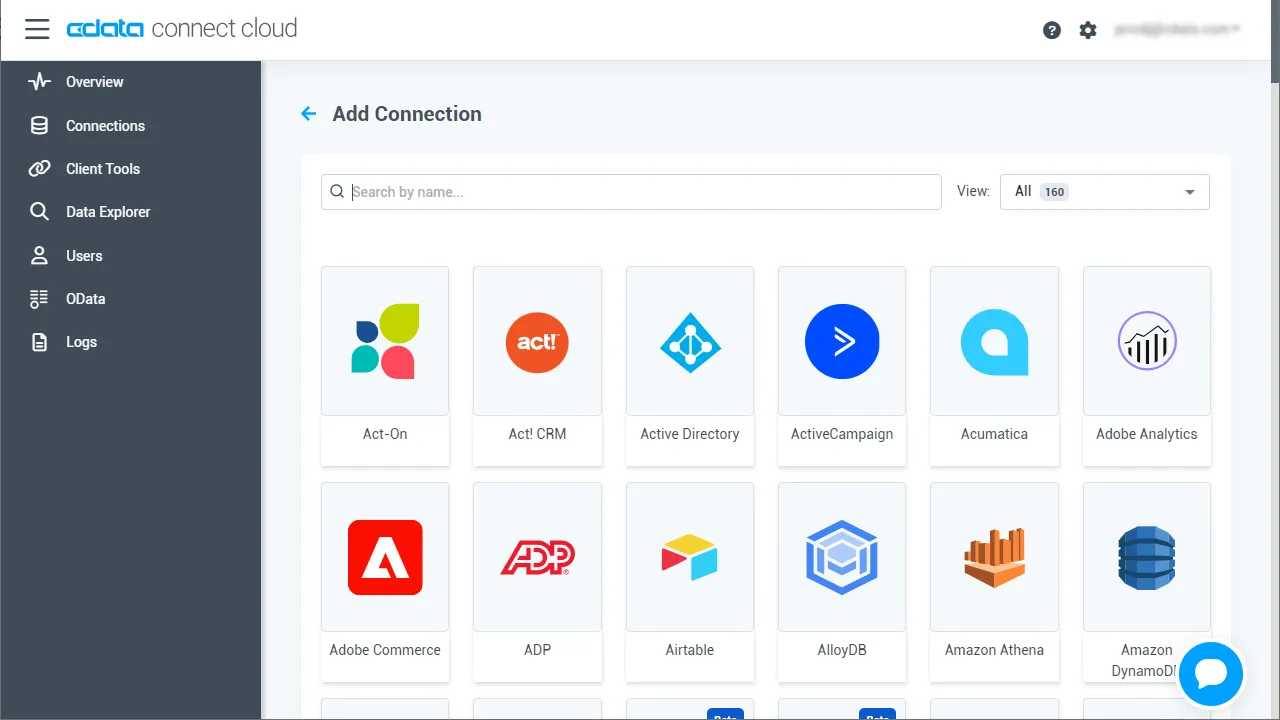
- Connect AI にログインし、Sources をクリックして、 Add Connection をクリックします
- 「Add Connection」パネルから「HubDB」を選択します
-
HubDB に接続するために必要な認証プロパティを入力します。
HubDBデータソースへの接続には、パブリックHubSpotアプリケーションを使用したOAuth認証とプライベートアプリケーショントークンを使用した認証の2つの方法があります。
カスタムOAuthアプリを使用する
すべてのOAuthフローでAuthSchemeを"OAuth"に設定する必要があります。特定の認証ニーズ(デスクトップアプリケーション、Webアプリケーション、ヘッドレスマシン)に必要な接続プロパティについては、ヘルプドキュメントを確認してください。
アプリケーションを登録し、OAuthクライアント認証情報を取得するには、以下の手順を実行してください。
- HubSpotアプリ開発者アカウントにログインします。
- アプリ開発者アカウントである必要があります。標準のHubSpotアカウントではパブリックアプリを作成できません。
- 開発者アカウントのホームページで、アプリタブをクリックします。
- アプリを作成をクリックします。
- アプリ情報タブで、ユーザーが接続する際に表示される値を入力し、必要に応じて変更します。これらの値には、パブリックアプリケーション名、アプリケーションロゴ、アプリケーションの説明が含まれます。
- 認証タブで、「リダイレクトURL」ボックスにコールバックURLを入力します。
- デスクトップアプリケーションを作成する場合は、http://localhost:33333のようなローカルにアクセス可能なURLに設定します。
- Webアプリケーションを作成する場合は、ユーザーがアプリケーションを承認した際にリダイレクトされる信頼できるURLに設定します。
- アプリを作成をクリックします。HubSpotがアプリケーションとそれに関連する認証情報を生成します。
- 認証タブで、クライアントIDとクライアントシークレットを確認します。これらは後でドライバーを設定する際に使用します。
スコープの下で、アプリケーションの意図する機能に必要なスコープを選択します。
テーブルにアクセスするには、最低限以下のスコープが必要です:
- hubdb
- oauth
- crm.objects.owners.read
- 変更を保存をクリックします。
- 統合に必要な機能にアクセスできる本番ポータルにアプリケーションをインストールします。
- 「インストールURL(OAuth)」の下で、完全なURLをコピーをクリックして、アプリケーションのインストールURLをコピーします。
- コピーしたリンクをブラウザで開きます。アプリケーションをインストールする標準アカウントを選択します。
- アプリを接続をクリックします。結果のタブは閉じて構いません。
プライベートアプリを使用する
HubSpotプライベートアプリケーショントークンを使用して接続するには、AuthSchemeプロパティを"PrivateApp"に設定します。
以下の手順に従ってプライベートアプリケーショントークンを生成できます:
- HubDBアカウントで、メインナビゲーションバーの設定アイコン(歯車)をクリックします。
- 左サイドバーメニューで、統合 > プライベートアプリに移動します。
- プライベートアプリを作成をクリックします。
- 基本情報タブで、アプリケーションの詳細(名前、ロゴ、説明)を設定します。
- スコープタブで、プライベートアプリケーションがアクセスできるようにしたい各スコープに対して読み取りまたは書き込みを選択します。
- テーブルにアクセスするには、最低限hubdbとcrm.objects.owners.readが必要です。
- アプリケーションの設定が完了したら、右上のアプリを作成をクリックします。
- アプリケーションのアクセストークンに関する情報を確認し、作成を続行をクリックし、その後トークンを表示をクリックします。
- コピーをクリックして、プライベートアプリケーショントークンをコピーします。
接続するには、PrivateAppTokenを取得したプライベートアプリケーショントークンに設定します。
- HubSpotアプリ開発者アカウントにログインします。
- 「Save & Test」をクリックします
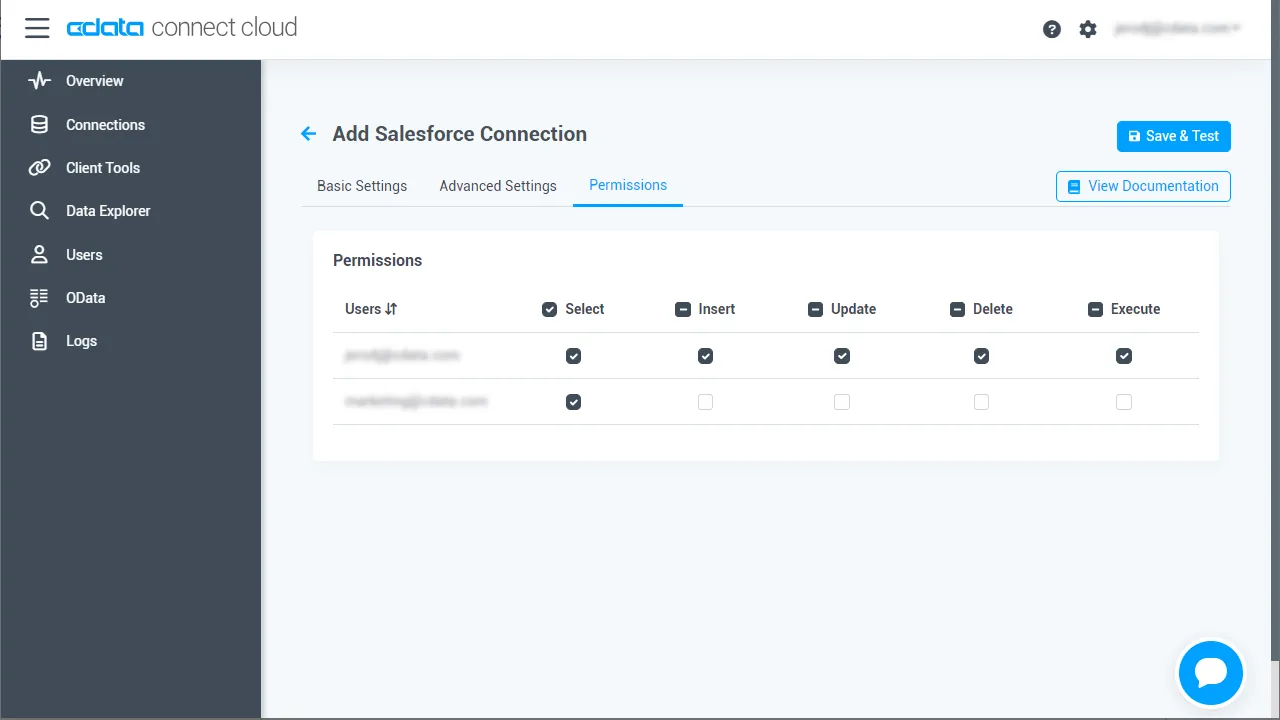
- 「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークン(PAT)を生成する
Python SDK は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使って Connect AI に認証します。アクセスの粒度を保つために、アプリケーションごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
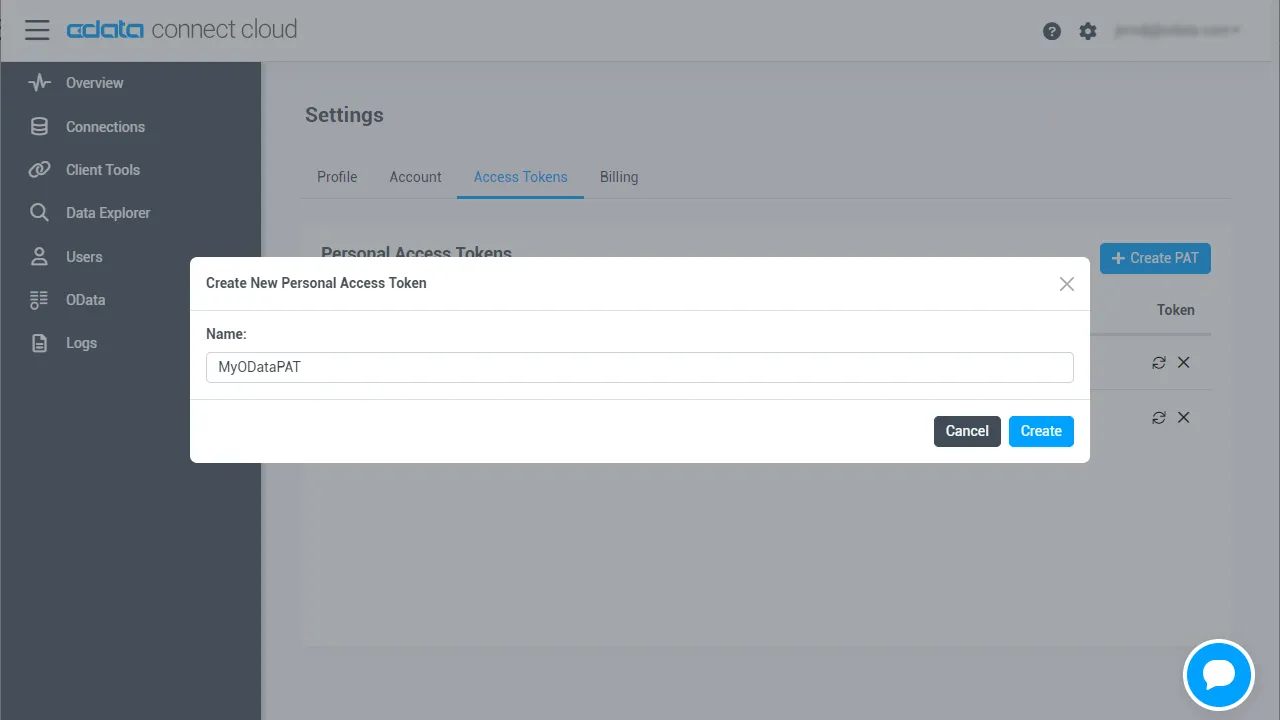
- 設定ページの Access Tokens セクションに移動し、 Create PAT をクリックします。
- PAT に名前を付けて Create をクリックします。
- パーソナルアクセストークンは作成時にのみ表示されます。必ずコピーして安全な場所に保管してください。
SDK をインストールする
pip を使って PyPI から SDK をインストールします。
pip install cdata-connect-ai
接続して最初のクエリを実行する
アカウントのメールアドレスと PAT で接続したら、sys_tables にクエリを実行して、接続済みのソース全体で利用可能なテーブルを確認してみましょう。Connect AI の識別子は <Connection>.<Schema>.<Table> という3つの部分で構成されており、接続名はデフォルトでソース名(例:HubDB1)になります。
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)
cur = conn.cursor()

# Discover what's available across your connected sources
cur.execute("SELECT CatalogName, SchemaName, TableName FROM sys_tables LIMIT 25")

for row in cur.fetchall():
    print(row)
結果から任意のテーブルを選び、直接クエリを実行してみましょう。
cur.execute(
    "SELECT PartitionKey, Name "
    "FROM [HubDB1].[HubDB].[NorthwindProducts] "
    "LIMIT 10"
)

for row in cur.fetchall():
    print(row)
HubDB に書き込む
データソースと接続の権限が許可していれば、同じカーソルで INSERT、UPDATE、DELETE ステートメントも実行できます。フィルタ付きの読み取りとまったく同じように、pyformat(%(name)s)パラメータで値をバインドし、影響を受けた行数は cursor.rowcount で確認できます。
# Insert a new record
cur.execute(
    "INSERT INTO [HubDB1].[HubDB].[NorthwindProducts] (PartitionKey) "
    "VALUES (%(newvalue)s)",
    {"newvalue": "Example value"},
)
print(f"Rows inserted: {cur.rowcount}")

# Update existing records
cur.execute(
    "UPDATE [HubDB1].[HubDB].[NorthwindProducts] "
    "SET Name = %(newvalue)s "
    "WHERE Id = '1'",
    {"newvalue": "Updated value"},
)
print(f"Rows updated: {cur.rowcount}")

conn.close()
注意:書き込み可能なソースであっても、読み取り専用の PAT や接続権限では書き込み操作は拒否されます。同じパラメータ化のパターンは、DELETE ステートメントや cursor.callproc() によるストアドプロシージャの実行にも使えます。
これがワークフローのすべてです。パッケージが1つ、PAT、そして標準的な DB-API 呼び出しだけ。SDK は通常の DB-API 接続を返すので、Python のデータエコシステムのほかのツールにもそのまま組み込めます。ここから先は、この同じ接続を使って、HubDB のデータを pandas に読み込んだり、petl で ETL パイプラインを構築したり、Dash の Web アプリを動かしたりできます。
関連情報と無料トライアル
これで、CData Connect AI Python SDK を通じて Python からリアルタイムのHubDB のデータをクエリできるようになりました。HubDB(および数百種類のその他のデータソース)への接続について詳しくは、Connect AI のページをご覧ください。
CData Connect AI の詳細、または無料トライアルにお申し込みください: