



【MCP Server】LlamaIndex からJD Edwards のデータに連携しよう!
LlamaIndex は、LLM アプリケーションを構築するためのデータフレームワークです。エージェントや RAG パイプライン、外部データをもとに推論する構造化ワークフローなどを開発できます。LlamaIndex と CData Connect AI を組み込みの MCP Server を通じて統合すれば、カスタムコネクタを書くことなく、エージェントがライブの JD Edwards のデータ をネイティブツールとして検出・クエリできるようになります。
CData Connect AI は、JD Edwards をはじめとするさまざまなデータソースに接続できる、セキュアでローコードな環境を提供します。複雑な ETL を必要とせず、リアルタイムデータを使ったビジネスアプリケーション間のシームレスな自動化を実現します。
この記事では、CData Connect AI での JD Edwards 接続の設定、LlamaIndex への MCP サーバーの登録、そして JD Edwards のデータ をリアルタイムでクエリする ReAct エージェントの構築方法をご紹介します。
前提条件
- CData Connect AI のアカウント
- Python バージョン 3.10 以上(LlamaIndex パッケージをインストールするため)
- OpenAI API キーを生成して保存
- システムに Visual Studio Code をインストール
ステップ 1:LlamaIndex 用の JD Edwards 接続を設定する
それでは早速、LlamaIndex から JD Edwards にアクセスできるようにしていきましょう。まず、CData Connect AI で JD Edwards 接続を作成します。この接続は、その後リモート MCP サーバーを通じて LlamaIndex に公開されます。
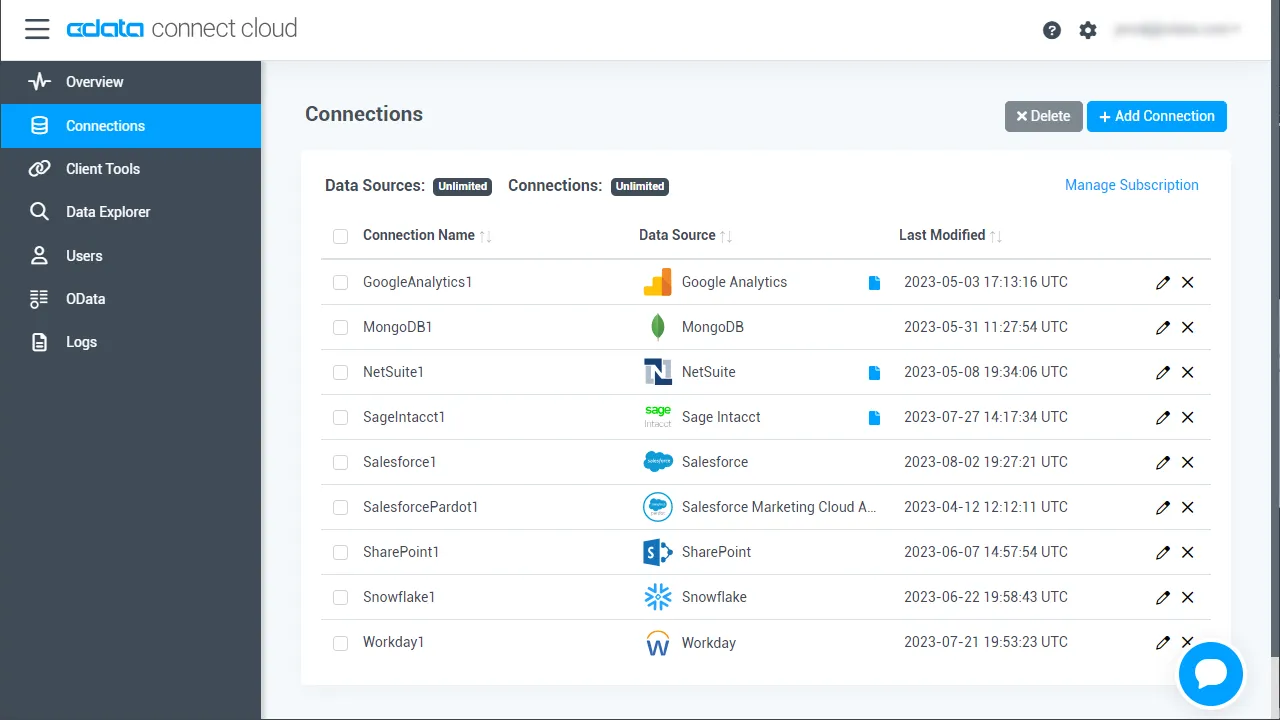
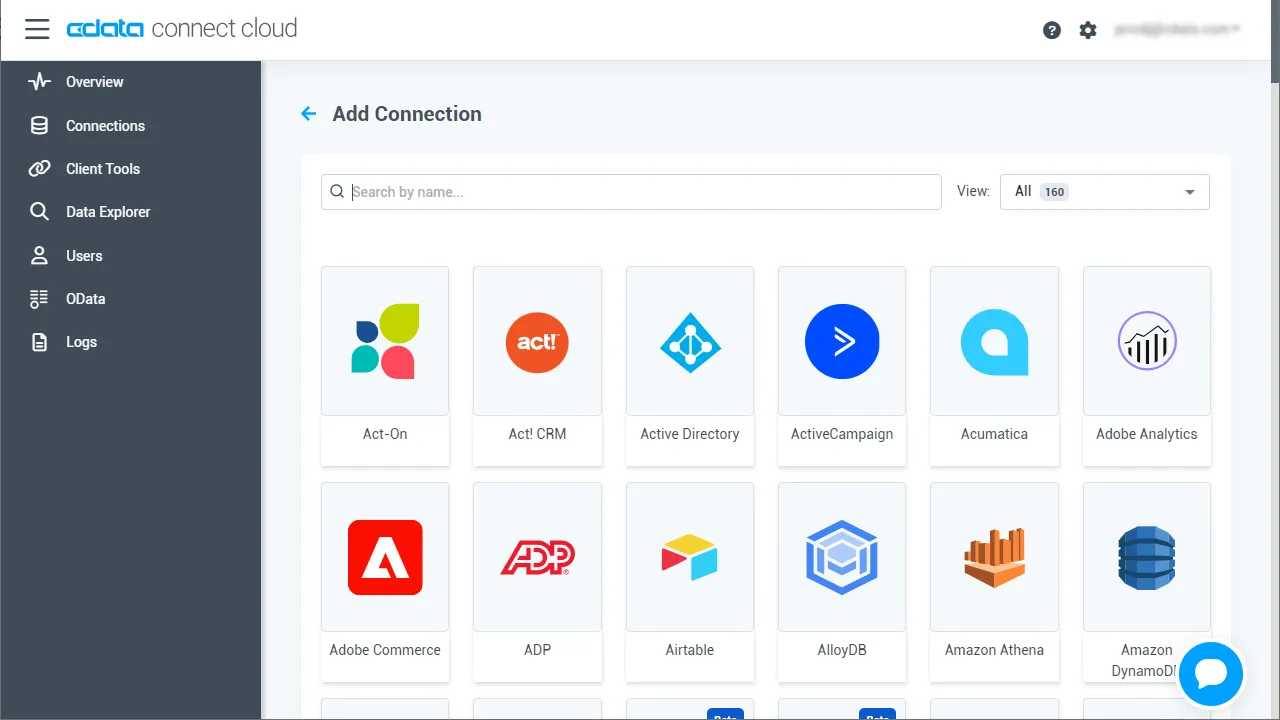
- Connect AI にログインし、「Sources」をクリックして「+ Add Connection」をクリックします
- 利用可能なデータソースから「JD Edwards」を選択します
-
JD Edwards に接続するために必要な認証情報を入力しましょう。
ドライバーは Application Interface Services(AIS)Server を経由して JD Edwards に接続します。以下の接続プロパティを設定します。
- URL:AIS Server のベース HTTPS URL(例:https://jde-ais.example.com:8300)。
- User:JD Edwards のユーザー名。
- Password:JD Edwards のパスワード。
- Environment(オプション):使用する JD Edwards の環境(例:本番環境なら PD920、開発環境なら DV920)。指定しない場合は、AIS Server のデフォルト環境が使用されます。
- Role(オプション):セッションで使用する JD Edwards のロール。指定しない場合は、AIS Server のデフォルトロールが使用されます。
- DeviceName(オプション):接続元のデバイスまたはアプリケーションの識別子。AIS Server での監査やログ記録に使用されます。
- Jasserver(オプション):リクエストのルーティング先となる Java Application Server(JAS)インスタンス。クラスタ環境で便利です。
公開するデータの選択
JD Edwards ではテーブルとビジネスビューが System Code ごとに整理されており、ドライバーは各 System Code をそれぞれ個別のスキーマとして公開します。利用できるスキーマは、以下のプロパティで制御できます。
- DataModel:System Code をスキーマとして公開する ERP モジュール(カンマ区切りで複数指定可)。接続先インスタンスのすべての System Code を公開する場合は All を指定します。デフォルトは FinancialManagement です。
- SystemCodes:DataModel の System Code に加えて公開したい System Code のカンマ区切りリスト(例:42,43)。
接続時、ドライバーは認証情報を AIS Server に送信してセッショントークンを取得し、キャッシュします。セッションの有効期限が切れる前に、新しいトークンが自動でリクエストされます。
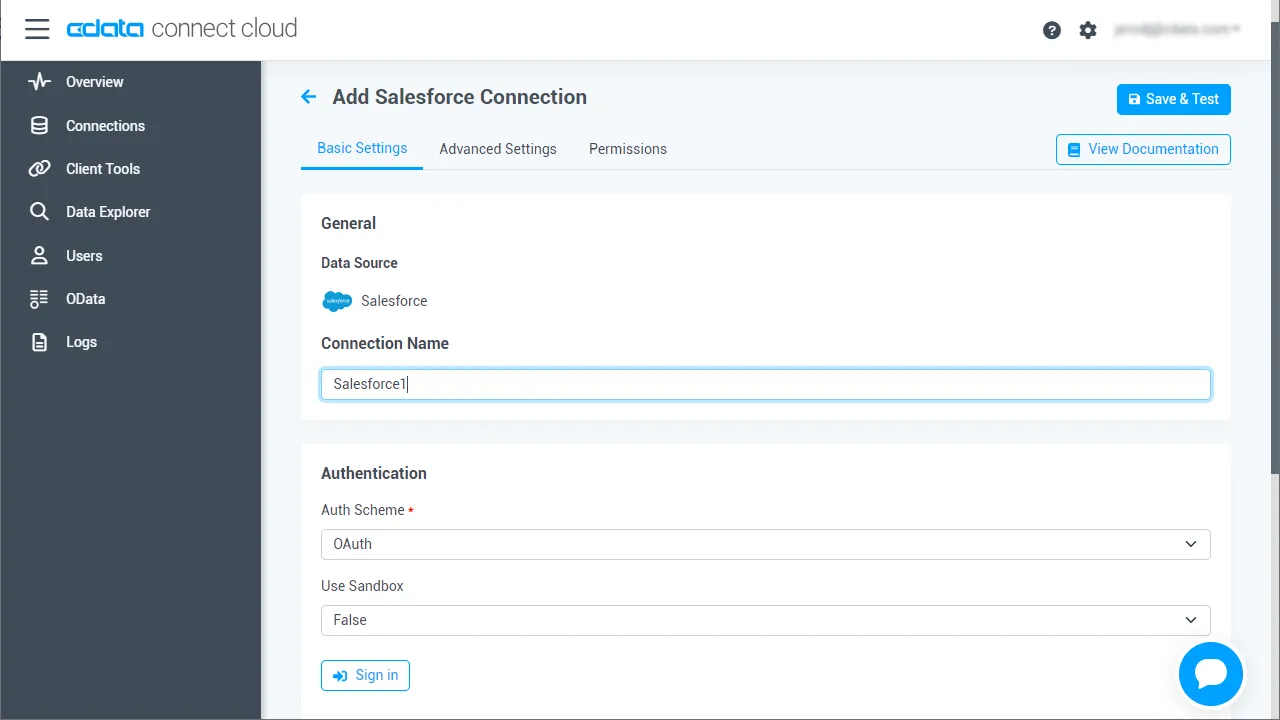
- 「Save & Test」をクリックします
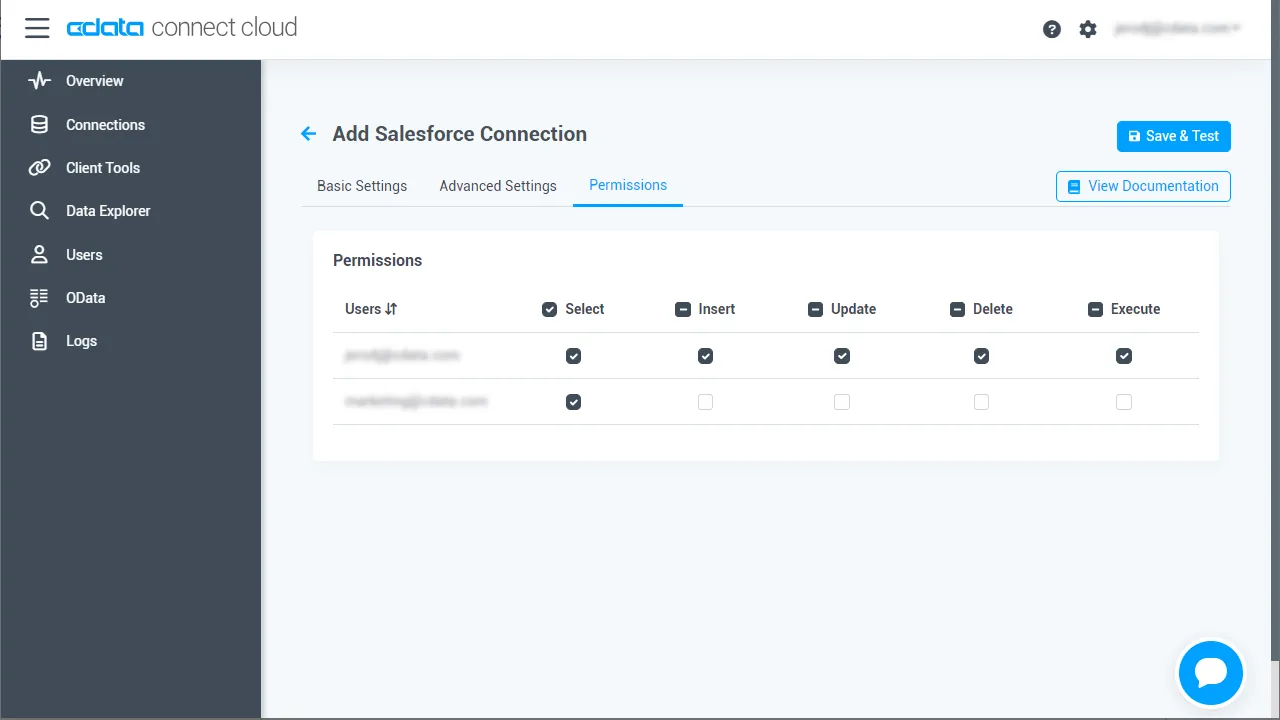
- 認証が完了したら、JD Edwards 接続の「Permissions」タブを開き、必要に応じてユーザーベースの権限を設定します
パーソナルアクセストークン(PAT)を生成する
LlamaIndex は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使用して Connect AI に認証します。アクセス制御の粒度を維持するために、統合ごとに個別の PAT を作成することをおすすめします。
- Connect AI で、右上の歯車アイコンを選択して「Settings」を開きます
- 「Access Tokens」で、「Create PAT」を選択します
- トークンのわかりやすい名前を付けて、「Create」を選択します
- トークンをコピーして安全に保管してください。PAT は作成時にのみ表示されます
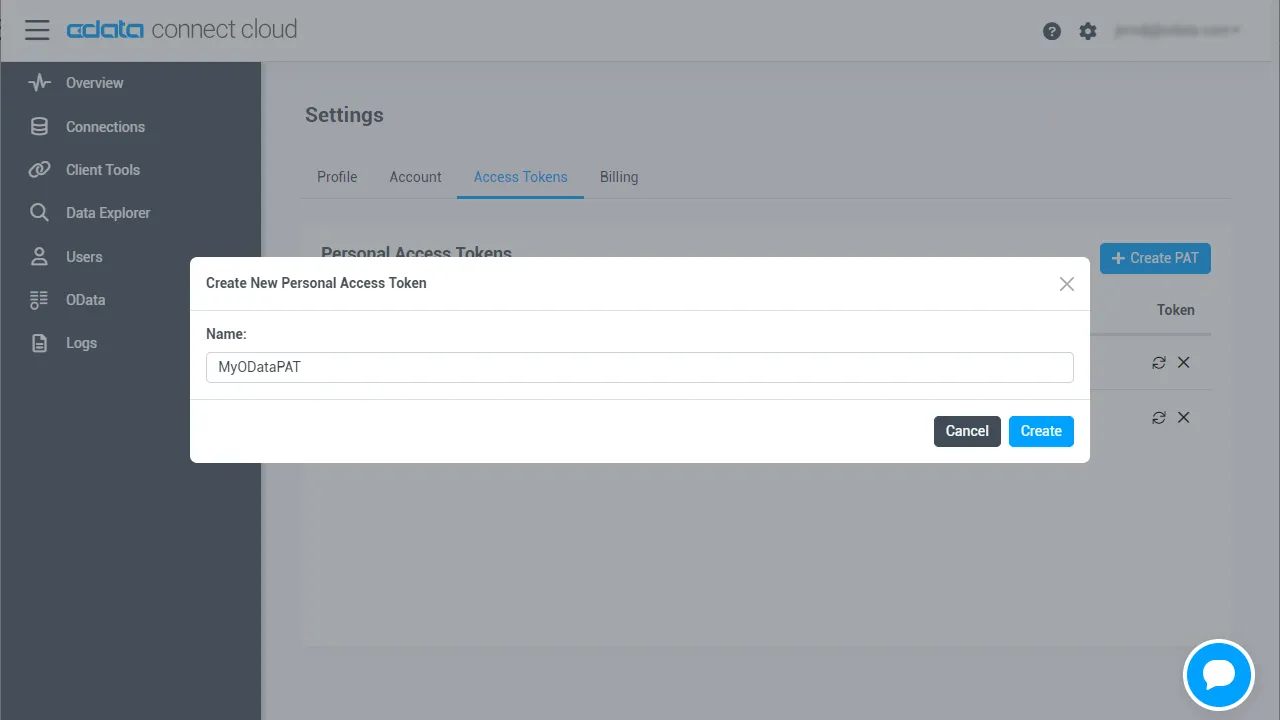
これで JD Edwards 接続の設定と PAT の生成が完了しました。LlamaIndex から CData MCP サーバーを通じて JD Edwards のデータ に接続する準備が整いました。
ステップ 2:LlamaIndex で MCP サーバーに接続する
続いて、LlamaIndex を CData Connect AI のリモート MCP サーバーに接続し、推論に OpenAI を使用していきましょう。MCP サーバーのエンドポイントと認証情報を
config.py- LlamaIndex MCP プロジェクト用のフォルダを作成します
- フォルダ内に
とconfig.py
の2つの Python ファイルを作成しますllamaindex_agent.py
で、MCP サーバーの URL と、Base64 エンコードされた CData Connect AI のメールアドレスおよび PAT(前提条件で取得したもの)を定義します。config.pyclass Config: MCP_BASE_URL = "https://mcp.cloud.cdata.com/mcp" # MCP Server の URL MCP_AUTH = "base64encoded(EMAIL:PAT)" # Base64 エンコードされた Connect AI の Email:PAT注:Base64 エンコードツールを使用して、MCP_AUTH の Base64 エンコード版を作成できます。
で、MCP ツールスペックと ReAct エージェントを設定します:llamaindex_agent.py""" LlamaIndex ReAct エージェントと CData Connect AI MCP サーバーを統合します。 このスクリプトは、MCP ツールを検出して LlamaIndex ツールとしてラップし、 OpenAI による推論で駆動されるエージェントループを実行します。 """ import asyncio from llama_index.tools.mcp import BasicMCPClient, McpToolSpec from llama_index.core.agent.workflow import ReActAgent from llama_index.llms.openai import OpenAI from config import Config async def main(): # Connect AI を指す MCP クライアントを初期化 mcp_client = BasicMCPClient( Config.MCP_BASE_URL, headers={"Authorization": f"Basic {Config.MCP_AUTH}"}, ) # MCP サーバーが公開するツール(getCatalogs、queryData など)を検出 tool_spec = McpToolSpec(client=mcp_client) tools = await tool_spec.to_tool_list_async() print("検出された MCP ツール:", [t.metadata.name for t in tools]) # ReAct ループを駆動する LLM を設定 llm = OpenAI( model="gpt-4o", temperature=0.2, api_key="YOUR_OPENAI_API_KEY", # https://platform.openai.com/ ) # MCP ツールを使用するエージェントを構築 agent = ReActAgent(tools=tools, llm=llm) user_prompt = "[rootadoname]1 で利用可能なテーブルはいくつありますか?" # 必要に応じて変更してください print(f" ユーザープロンプト: {user_prompt}") response = await agent.run(user_prompt) print("エージェントの最終応答:", response) if __name__ == "__main__": asyncio.run(main())
ステップ 3:LlamaIndex パッケージをインストールする
このワークフローでは LlamaIndex を CData Connect AI MCP サーバーおよび推論用の OpenAI と組み合わせて使用するため、必要な Python パッケージをインストールしていきましょう。
プロジェクトのターミナルで次のコマンドを実行してください。
pip install llama-index llama-index-tools-mcp llama-index-llms-openai
ステップ 4:LlamaIndex を使用して JD Edwards にプロンプトを送信する(MCP サーバー経由)
- インストールが完了したら、
を実行してスクリプトを実行しますpython llamaindex_agent.py - スクリプトは MCP サーバーに接続し、接続されたデータをクエリするために利用可能な CData Connect AI MCP ツールを検出します
- プロンプトを入力します(例:「JD Edwards で利用可能なテーブルはいくつありますか?」)
- エージェントは利用可能なツールをもとに推論し、JD Edwards に対して
を呼び出して、その結果を返しますqueryData
CData Connect AI でビジネスシステムのデータ活用を今すぐスタート
いかがでしたか?LlamaIndex から JD Edwards へのデータ接続が簡単に完了したのではないでしょうか。業務に使えそう、と感じてくださった方は、14 日間の無償トライアルで AI ツールからビジネスシステムへのリアルタイムデータ接続をぜひお試しください。