



JD Edwards のデータをPythonのpetlでETL処理する方法|CData Connect AI
CData Connect AI の Python SDK と petl フレームワークを使うと、JD Edwards のデータをローカルにドライバーをインストールすることなく、Pythonで直接抽出・変換・ロードするETLパイプラインを構築できます。パーソナルアクセストークンで接続し、数行のコードで設定完了です。
Python は豊富なモジュールのエコシステムを備えているため、素早く作業に取りかかり、システムをより効果的に連携できます。CData Connect AI Python SDK と petl フレームワークを使えば、JD Edwards のデータを抽出・変換して CSV などに出力する JD Edwards 連携のアプリケーションやパイプラインを構築できます。この記事では、Connect AI に接続し、petl を使ってJD Edwards のデータを抽出・変換し、CSV ファイルに書き出す方法をご紹介します。
Connect AI Python SDK(cdata-connect-ai)は DB-API 2.0(PEP 249)に準拠したクライアントなので、petl は etl.fromdb を使って SDK の接続から直接読み取れます。ソースごとにドライバーをインストールする必要はありません。パーソナルアクセストークンで接続して、パイプラインを構築しましょう。
Python + petl でできること
JD Edwards データの定期抽出パイプライン構築
SQL クエリで取得した JD Edwards のレコードを petl の etl.fromdb で抽出し、etl.sort などの変換処理をはさんでから CSV に書き出す、軽量な ETL パイプラインを構築できます。
複数データソースとの統合分析
DB-API 2.0 準拠のクライアントなので、同じコードパターンで JD Edwards 以外のデータソースにも接続でき、petl 上で結合・整形してから任意の出力先にロードできます。
JD Edwards への書き戻し処理の自動化
書き込みに対応した権限を持つ PAT で接続していれば、cursor.executemany を使ったバッチ INSERT により、変換済みデータを JD Edwards に自動で書き戻す処理を組み込めます。
Connect AI で JD Edwards に接続する方法は?
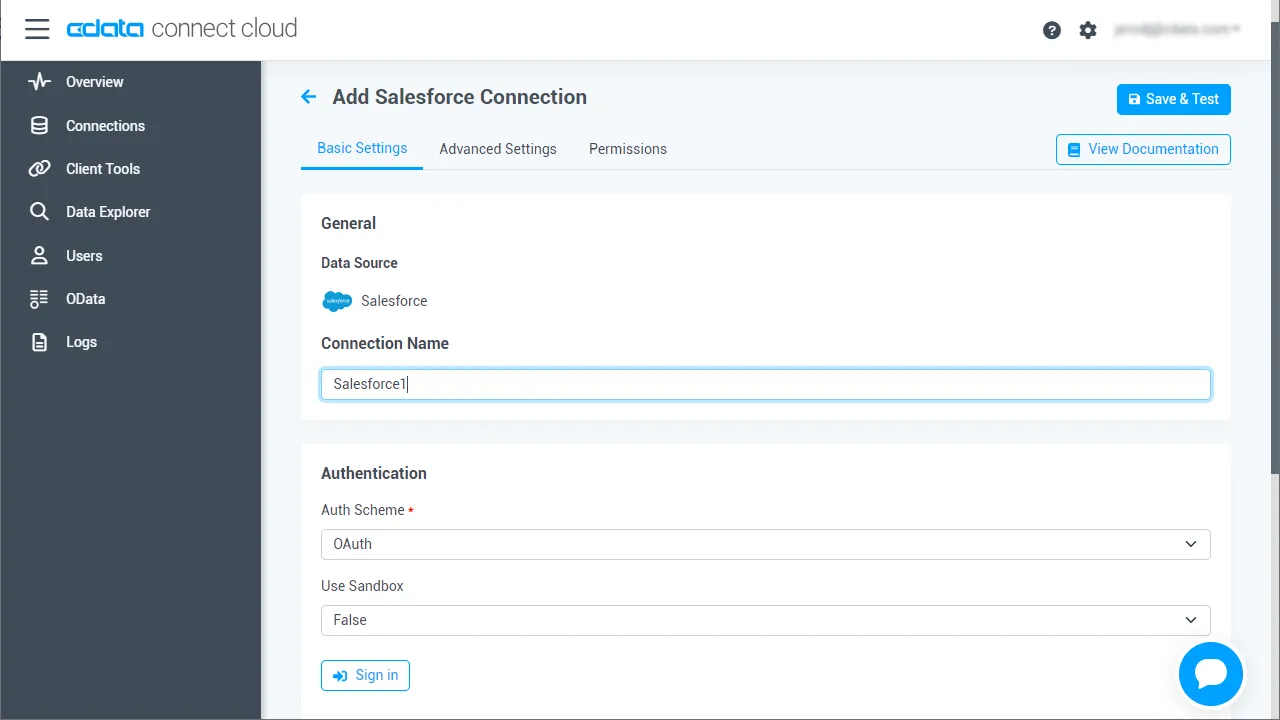
CData Connect AI では、直感的なクリック操作ベースのインターフェースでデータソースに接続できます。
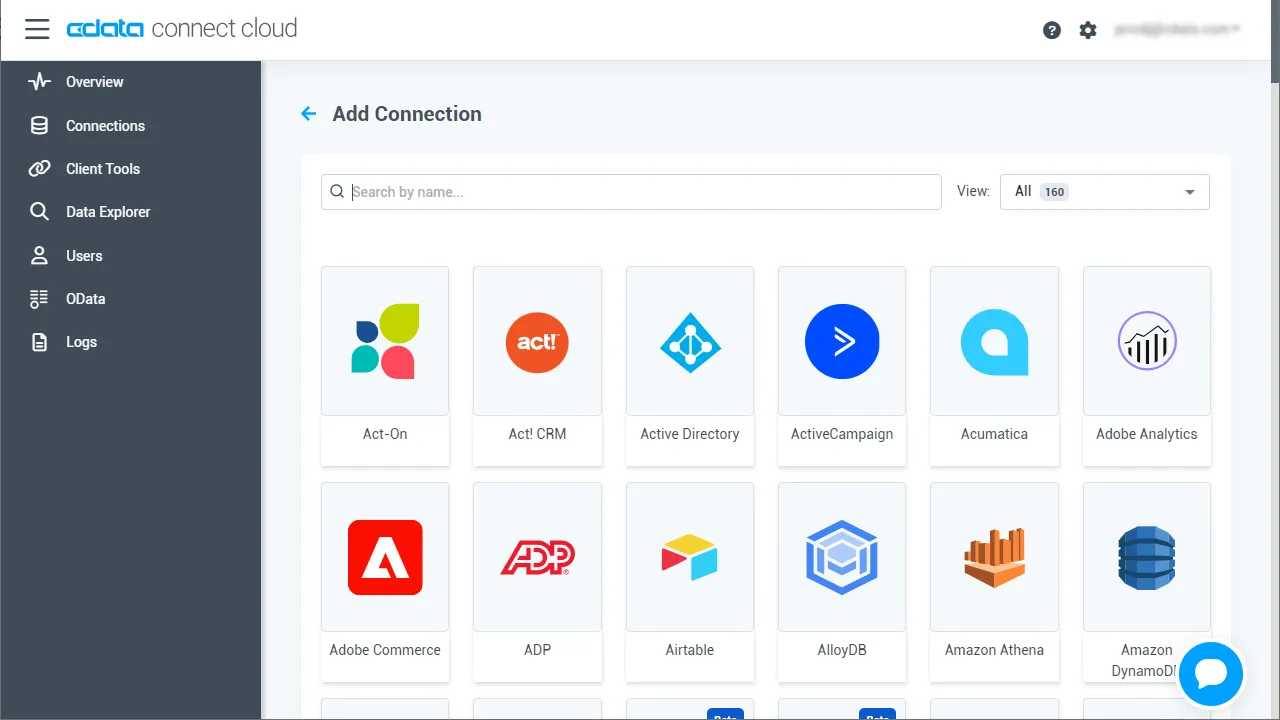
- Connect AI にログインし、Sources をクリックして、 Add Connection をクリックします
- 「Add Connection」パネルから「JD Edwards」を選択します
-
JD Edwards に接続するために必要な認証プロパティを入力します。
ドライバーは Application Interface Services(AIS)Server を経由して JD Edwards に接続します。以下の接続プロパティを設定します。
- URL:AIS Server のベース HTTPS URL(例:https://jde-ais.example.com:8300)。
- User:JD Edwards のユーザー名。
- Password:JD Edwards のパスワード。
- Environment(オプション):使用する JD Edwards の環境(例:本番環境なら PD920、開発環境なら DV920)。指定しない場合は、AIS Server のデフォルト環境が使用されます。
- Role(オプション):セッションで使用する JD Edwards のロール。指定しない場合は、AIS Server のデフォルトロールが使用されます。
- DeviceName(オプション):接続元のデバイスまたはアプリケーションの識別子。AIS Server での監査やログ記録に使用されます。
- Jasserver(オプション):リクエストのルーティング先となる Java Application Server(JAS)インスタンス。クラスタ環境で便利です。
公開するデータの選択
JD Edwards ではテーブルとビジネスビューが System Code ごとに整理されており、ドライバーは各 System Code をそれぞれ個別のスキーマとして公開します。利用できるスキーマは、以下のプロパティで制御できます。
- DataModel:System Code をスキーマとして公開する ERP モジュール(カンマ区切りで複数指定可)。接続先インスタンスのすべての System Code を公開する場合は All を指定します。デフォルトは FinancialManagement です。
- SystemCodes:DataModel の System Code に加えて公開したい System Code のカンマ区切りリスト(例:42,43)。
接続時、ドライバーは認証情報を AIS Server に送信してセッショントークンを取得し、キャッシュします。セッションの有効期限が切れる前に、新しいトークンが自動でリクエストされます。
- 「Save & Test」をクリックします
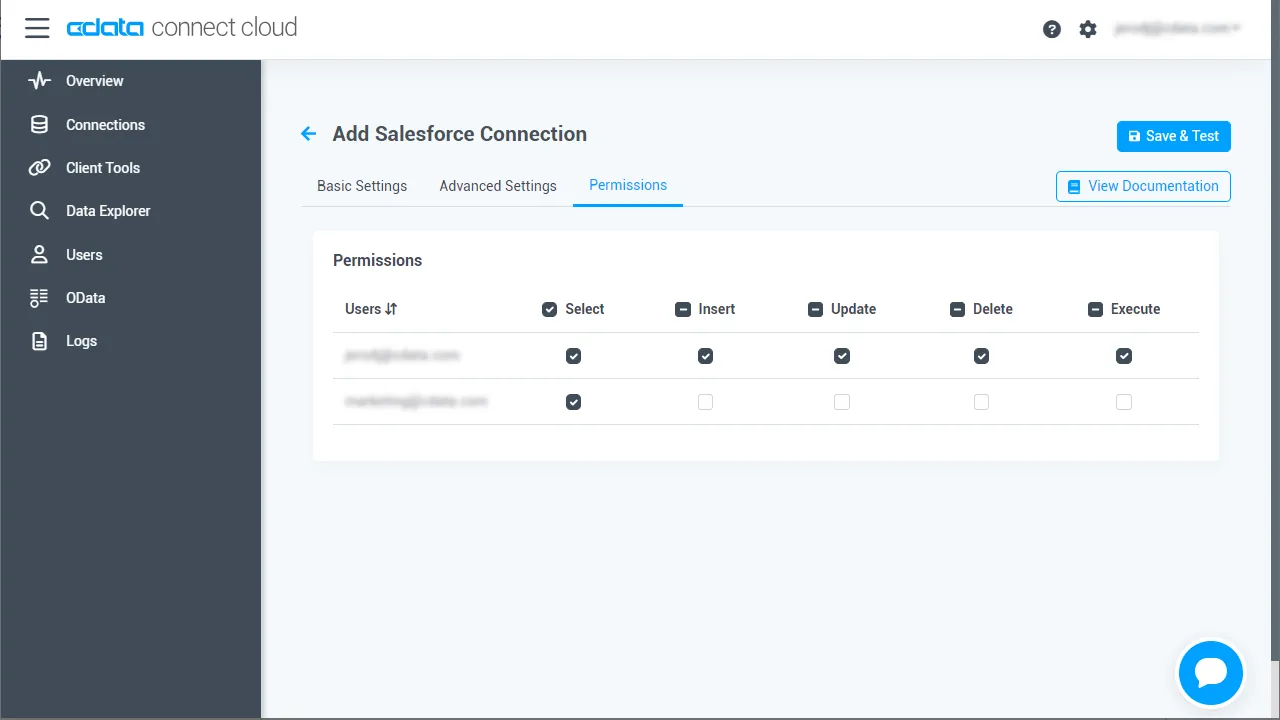
- 「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークン(PAT)を生成する
Python SDK は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使って Connect AI に認証します。アクセスの粒度を保つために、アプリケーションごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
- 設定ページの Access Tokens セクションに移動し、 Create PAT をクリックします。
- PAT に名前を付けて Create をクリックします。
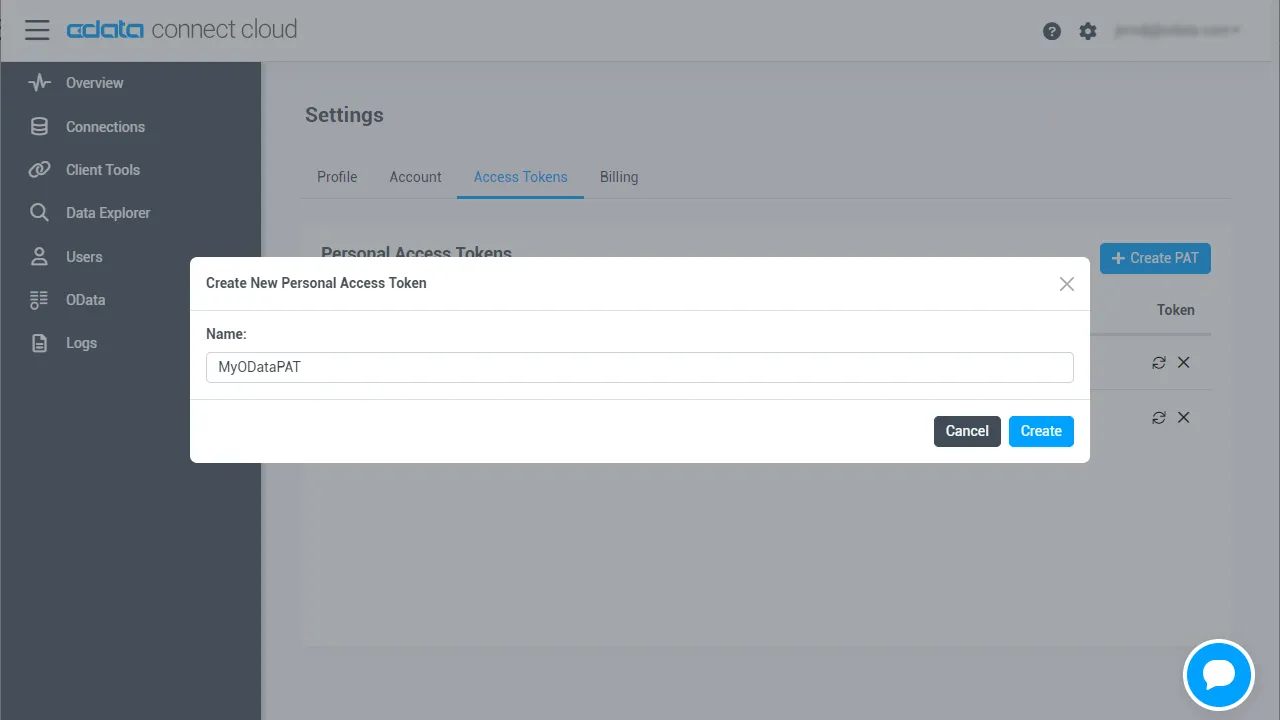
- パーソナルアクセストークンは作成時にのみ表示されます。必ずコピーして安全な場所に保管してください。
必要なモジュールをインストールする方法は?
pip ユーティリティを使って、SDK と petl フレームワークをインストールします。
pip install cdata-connect-ai
pip install petl
Python で JD Edwards のデータの ETL アプリを構築する方法は?
必要なモジュールをインストールしたら、ETL アプリを構築する準備は完了です。以下にコードスニペットを紹介しますが、完全なソースコードは記事の末尾に掲載しています。
まずモジュールをインポートし、アカウントのメールアドレスと PAT で Connect AI に接続します。
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)
JD Edwards をクエリする SQL ステートメントを作成する方法は?
SQL を使って、JD Edwards をクエリするステートメントを作成します。この記事では、AccountsPayable.AccountLedger エンティティからデータを読み取ります。識別子は <Connection>.<Schema>.<Table> という3つの部分で構成されており、接続名はデフォルトでソース名(例:JDEdwards1)になります。
sql = (
    "SELECT DocumentNumber, Amount "
    "FROM [JDEdwards1].[JDEdwards].[AccountsPayable.AccountLedger] "
    "WHERE BusinessUnit = '100'"
)
JD Edwards のデータの抽出・変換・ロードを実装する方法は?
接続とクエリが準備できたら、petl を使ってJD Edwards のデータを抽出・変換・ロードします。この例では、JD Edwards のデータを抽出し、Amount カラムでデータを並べ替えて、CSV ファイルにロードします。
table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'Amount')

etl.tocsv(table2, 'accountspayable.accountledger_data.csv')
JD Edwards は Connect AI では読み取り専用のソースのため、このパイプラインではJD Edwards のデータの抽出と変換はできますが、行の書き戻しはできません。抽出が完了したら接続を閉じましょう。
conn.close()
CData Connect AI Python SDK を使えば、petl のような ETL パッケージでのデータへの直接アクセスも含め、通常のデータベースと同じようにJD Edwards のデータを扱えます。
関連情報と無料トライアル
これで、CData Connect AI Python SDK を使って、petl でリアルタイムのJD Edwards のデータをパイプライン処理できるようになりました。JD Edwards(および数百種類のその他のデータソース)への接続について詳しくは、Connect AI のページをご覧ください。
CData Connect AI の詳細、または無料トライアルにお申し込みください:
完全なソースコード
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)

sql = (
    "SELECT DocumentNumber, Amount "
    "FROM [JDEdwards1].[JDEdwards].[AccountsPayable.AccountLedger] "
    "WHERE BusinessUnit = '100'"
)

table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'Amount')

etl.tocsv(table2, 'accountspayable.accountledger_data.csv')
conn.close()