


PingOne のデータをPythonのpetlでETL処理する方法|CData Connect AI
CData Connect AI の Python SDK と petl フレームワークを使うと、PingOne のデータをローカルにドライバーをインストールすることなく、Pythonで直接抽出・変換・ロードするETLパイプラインを構築できます。パーソナルアクセストークンで接続し、数行のコードで設定完了です。
Python は豊富なモジュールのエコシステムを備えているため、素早く作業に取りかかり、システムをより効果的に連携できます。CData Connect AI Python SDK と petl フレームワークを使えば、PingOne のデータを抽出・変換して CSV などに出力する PingOne 連携のアプリケーションやパイプラインを構築できます。この記事では、Connect AI に接続し、petl を使ってPingOne のデータを抽出・変換し、CSV ファイルに書き出す方法をご紹介します。
Connect AI Python SDK(cdata-connect-ai)は DB-API 2.0(PEP 249)に準拠したクライアントなので、petl は etl.fromdb を使って SDK の接続から直接読み取れます。ソースごとにドライバーをインストールする必要はありません。パーソナルアクセストークンで接続して、パイプラインを構築しましょう。
Python + petl でできること
PingOne データの定期抽出パイプライン構築
SQL クエリで取得した PingOne のレコードを petl の etl.fromdb で抽出し、etl.sort などの変換処理をはさんでから CSV に書き出す、軽量な ETL パイプラインを構築できます。
複数データソースとの統合分析
DB-API 2.0 準拠のクライアントなので、同じコードパターンで PingOne 以外のデータソースにも接続でき、petl 上で結合・整形してから任意の出力先にロードできます。
PingOne への書き戻し処理の自動化
書き込みに対応した権限を持つ PAT で接続していれば、cursor.executemany を使ったバッチ INSERT により、変換済みデータを PingOne に自動で書き戻す処理を組み込めます。
Connect AI で PingOne に接続する方法は?
CData Connect AI では、直感的なクリック操作ベースのインターフェースでデータソースに接続できます。
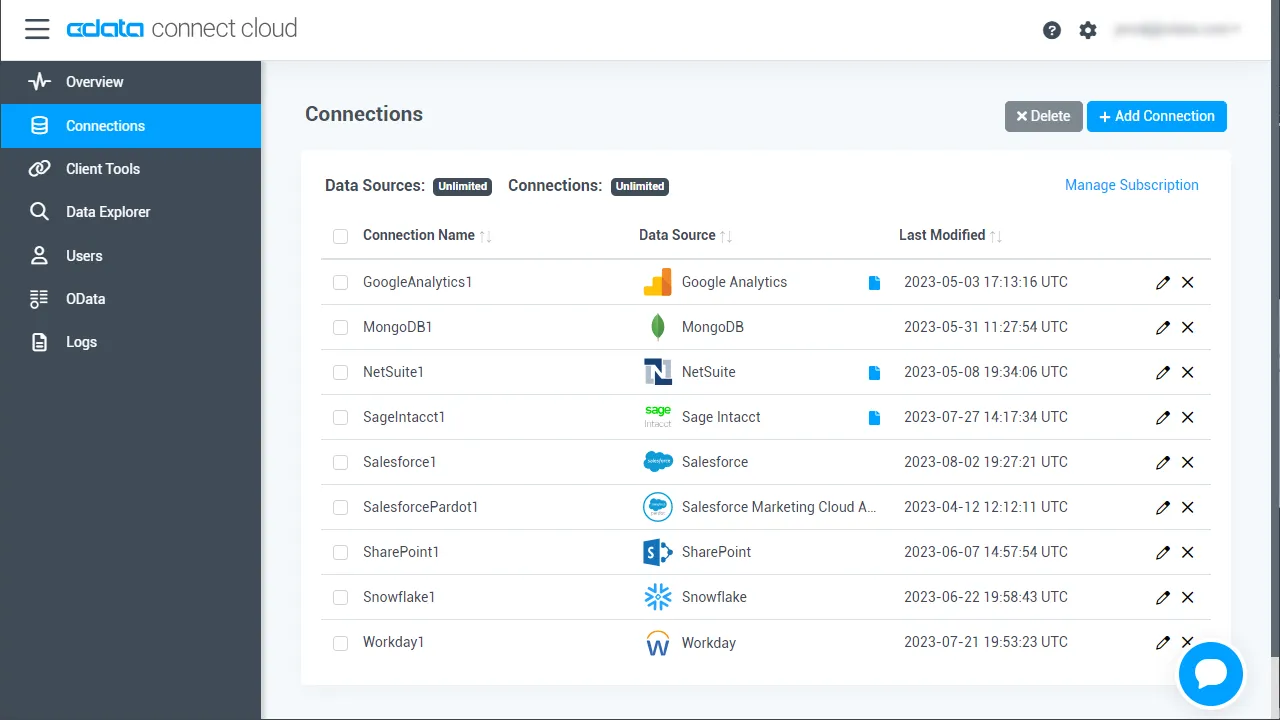
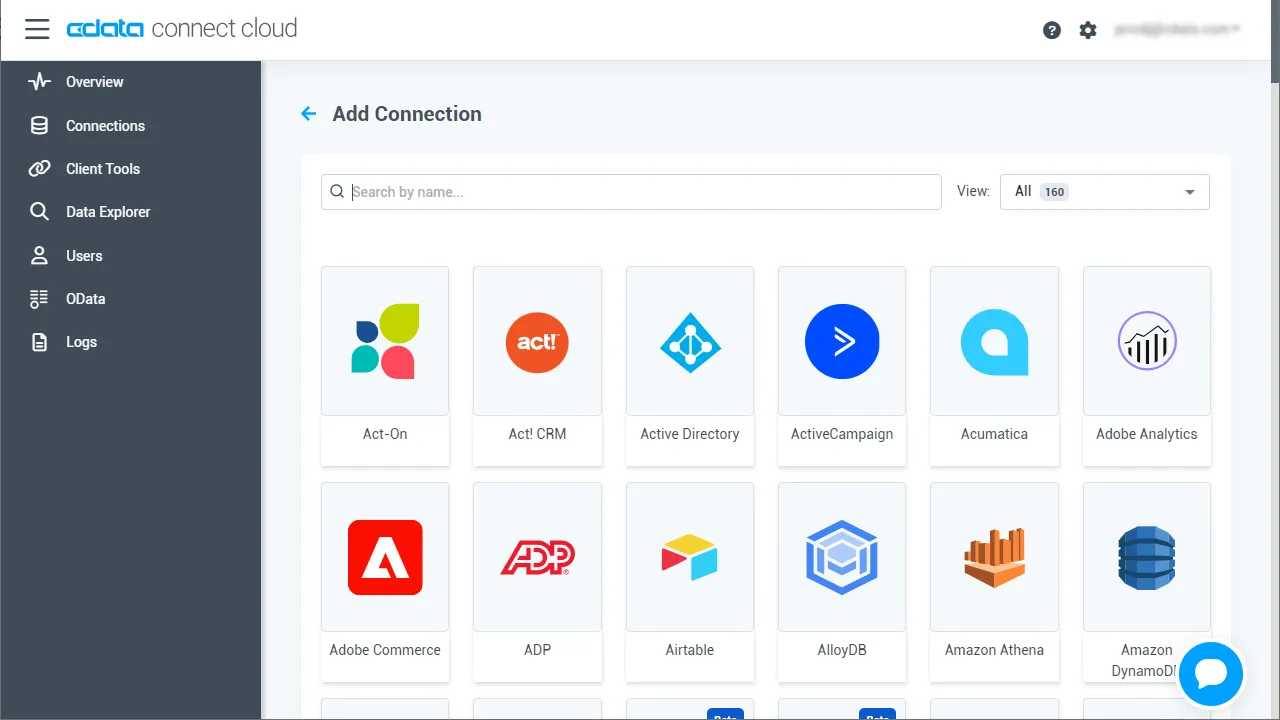
- Connect AI にログインし、Sources をクリックして、 Add Connection をクリックします
- 「Add Connection」パネルから「PingOne」を選択します
-
PingOne に接続するために必要な認証プロパティを入力します。
PingOne に接続するには以下のプロパティを設定します。
- Region:自身のPingOne 組織のデータがホスティングされている地域。
- AuthScheme:PingOne に接続する際に使用する認証の種類。
- WorkerAppEnvironmentId (デフォルトのPingOne ドメインを使用する場合に必要)、またはAuthorizationServerURL のいずれかで、下で説明するように設定します。
WorkerAppEnvironmentId の設定
WorkerAppEnvironmentId は、Worker アプリケーションが存在するPingOne 環境のID です。 このパラメータは、環境がデフォルトのPingOne ドメイン(auth.pingone)を利用している場合のみ使用されます。 これは、ヘルプドキュメントのカスタムOAuth アプリケーションの作成で説明するように、PingOne への認証に使用するカスタムOAuth アプリケーションを作成した後に設定します。
はじめに、このプロパティの値を見つけます。
- 自身のPingOne 組織のホームページからナビゲーションサイドバーに移動し、Environments をクリックします。
- OAuth / Worker のカスタムアプリケーションを作成した環境(通常はAdministrators)を見つけ、Manage Environment をクリックします。 環境のホームページが表示されます。
- 環境のホームページのナビゲーションサイドバーで、Applications をクリックします。
- リストから、OAuth またはWorker アプリケーションの詳細を見つけます。
-
Environment ID フィールドの値をコピーします。
以下の例に似たものになるはずです:
WorkerAppEnvironmentId='11e96fc7-aa4d-4a60-8196-9acf91424eca'
次に、WorkerAppEnvironmentId をEnvironment ID フィールドの値に設定します。
AuthorizationServerURL の設定
AuthorizationServerURL は、お使いのアプリケーションが配置されている環境のPingOne 認可サーバーのベースURL です。 このプロパティは、PingOne プラットフォームAPI ドキュメントで説明されているように、環境にカスタムドメインを設定した場合にのみ使用されます。 Custom Domains を参照してください。
OAuth でのPingOne への認証
PingOne はOAuth とOAuthClient 認証の両方をサポートしています。 上述の設定手順に加え、OAuth またはOAuthCliet 認証をサポートするために、さらに2つの手順を完了する必要があります。
- ヘルプドキュメントのカスタムOAuth アプリケーションの作成で説明するように、カスタムOAuth アプリケーションを作成して設定します。
- ドライバーがデータモデル内のエンティティにアクセスできるようにするには、ヘルプドキュメントのAdministrator Roles での説明のとおり、使用するアドミンユーザー / ワーカーアプリケーションに対して正しいロールを設定していることを確認してください。
- 以下のサブセクションで説明されているように、選択した認証スキームと認証フローに適切なプロパティを設定します。
OAuth(認可コードグラント)
AuthScheme をOAuth に設定します。
デスクトップアプリケーション
OAuth アクセストークンの取得およびリフレッシュ
以下を設定して、接続してください。
- InitiateOAuth:GETANDREFRESH。繰り返しOAuth の交換を行ったり、手動でOAuthAccessToken を設定する必要をなくすには、InitiateOAuth を使用します。
- OAuthClientId:カスタムOAuth アプリケーションを作成した際に取得したClient ID。
- OAuthClientSecret:カスタムOAuth アプリケーションを作成した際に取得したClient Secret。
- CallbackURL:カスタムOAuth アプリケーションの登録時に定義したリダイレクトURI。例:https://localhost:3333
接続すると、CData 製品 はデフォルトブラウザでPingOne のOAuth エンドポイントを開きます。ログインして、アプリケーションにアクセス許可を与えます。 ドライバーはこれでOAuth プロセスを完了します。
- ドライバーはPingOne からアクセストークンを取得し、それを使ってデータをリクエストします。
- OAuth 値はOAuthSettingsLocation で指定された場所に保存され、接続間で永続化されるようにします。
ドライバーはアクセストークンの期限が切れると自動的にリフレッシュします。
Web アプリケーションやヘッドレスマシン、クライアントクレデンシャルグラントを含むその他のOAuth メソッドについては、ヘルプドキュメントを参照してください。
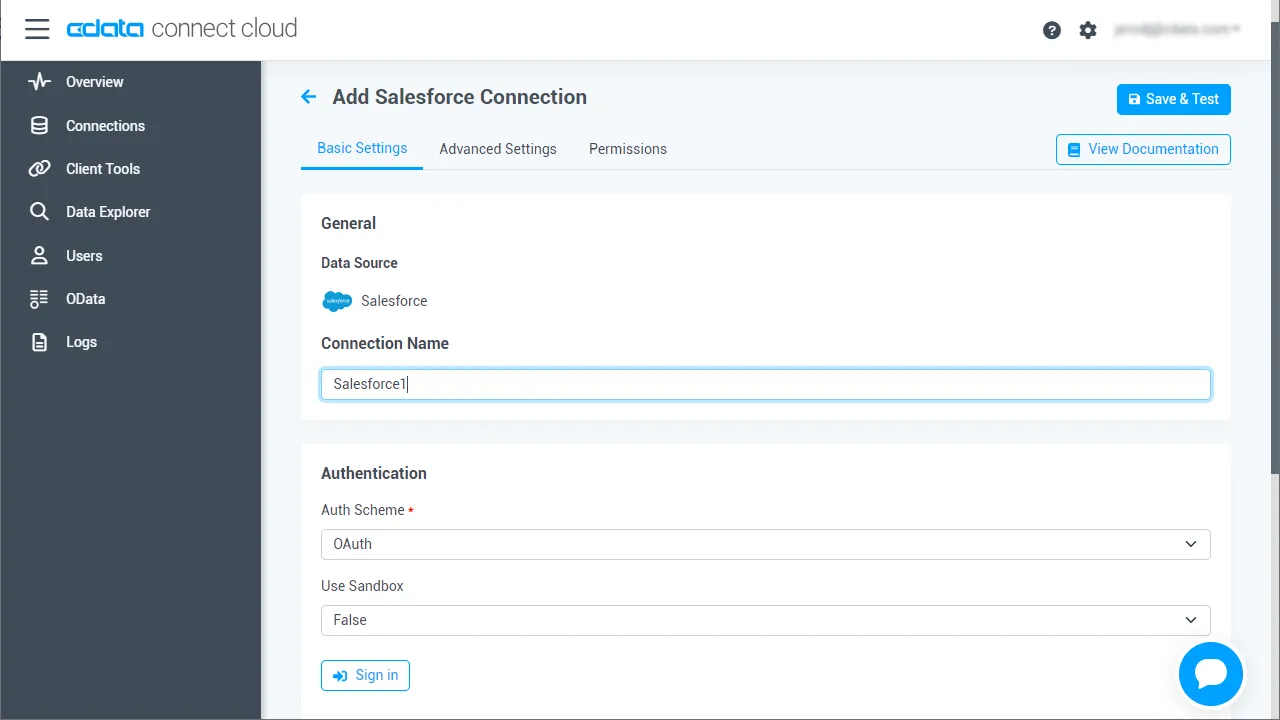
- 「Save & Test」をクリックします
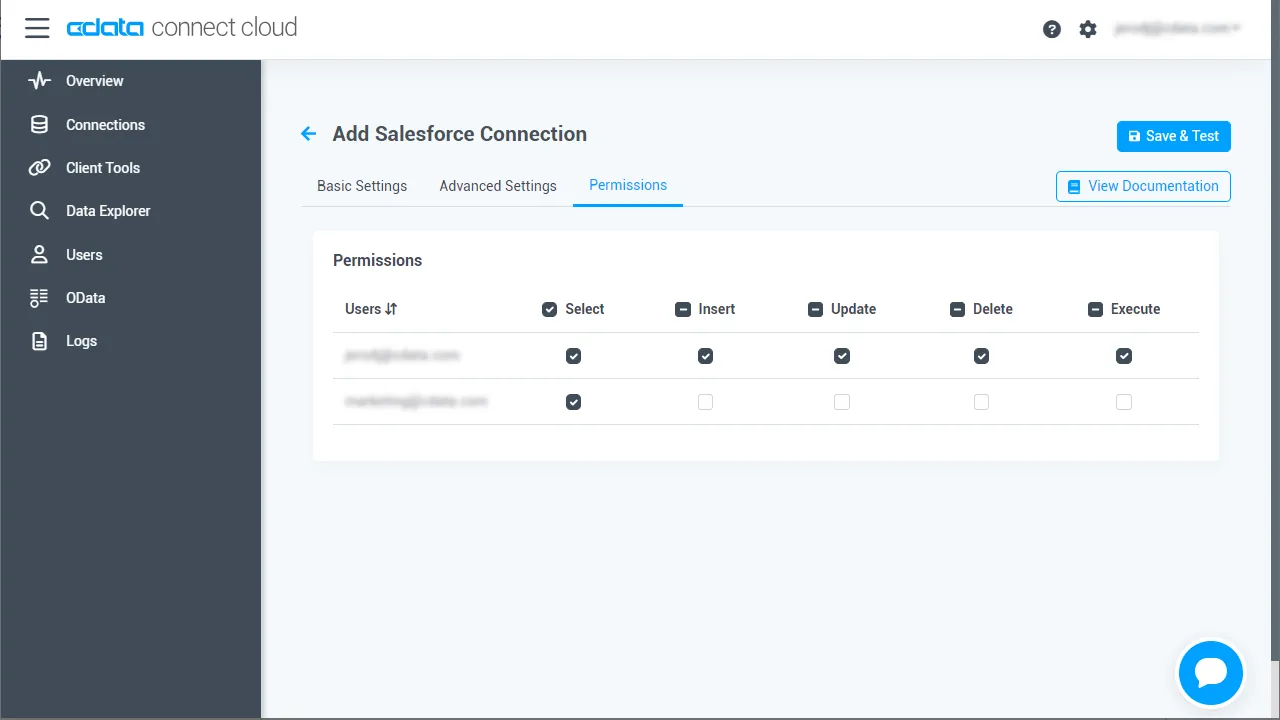
- 「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークン(PAT)を生成する
Python SDK は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使って Connect AI に認証します。アクセスの粒度を保つために、アプリケーションごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
- 設定ページの Access Tokens セクションに移動し、 Create PAT をクリックします。
- PAT に名前を付けて Create をクリックします。
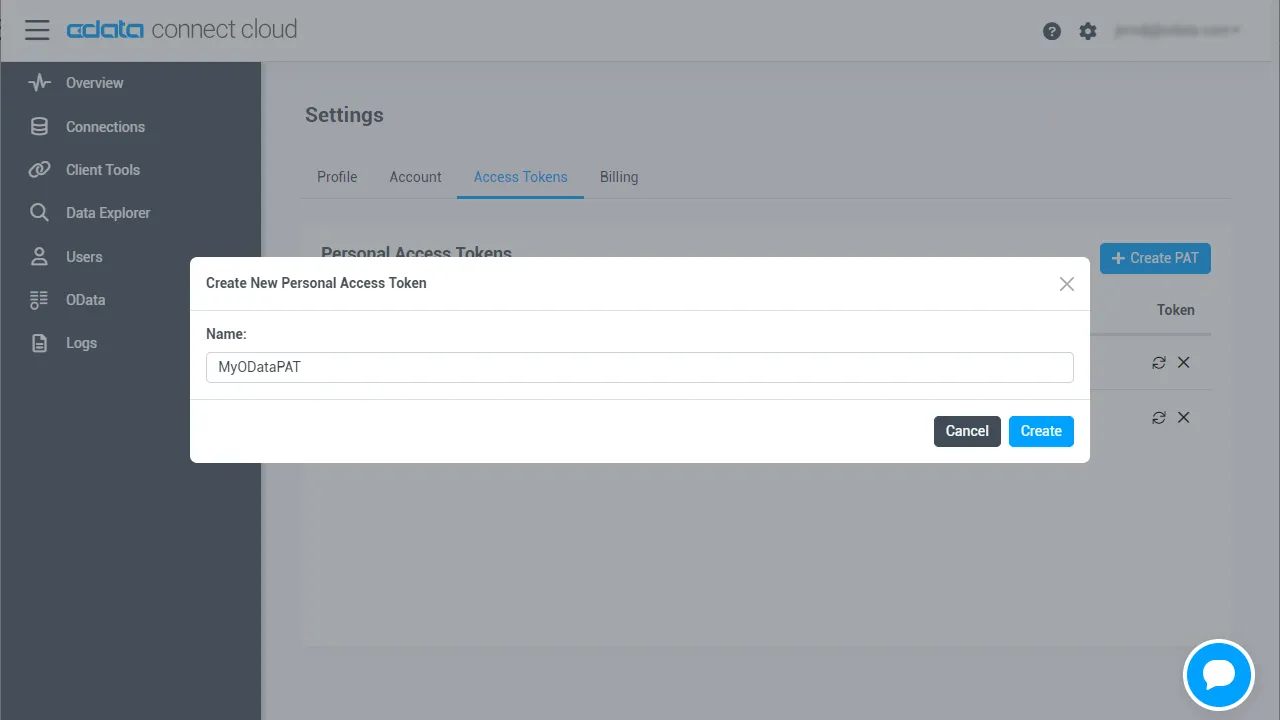
- パーソナルアクセストークンは作成時にのみ表示されます。必ずコピーして安全な場所に保管してください。
必要なモジュールをインストールする方法は?
pip ユーティリティを使って、SDK と petl フレームワークをインストールします。
pip install cdata-connect-ai
pip install petl
Python で PingOne のデータの ETL アプリを構築する方法は?
必要なモジュールをインストールしたら、ETL アプリを構築する準備は完了です。以下にコードスニペットを紹介しますが、完全なソースコードは記事の末尾に掲載しています。
まずモジュールをインポートし、アカウントのメールアドレスと PAT で Connect AI に接続します。
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)
PingOne をクエリする SQL ステートメントを作成する方法は?
SQL を使って、PingOne をクエリするステートメントを作成します。この記事では、[CData].[Administrators].Users エンティティからデータを読み取ります。識別子は <Connection>.<Schema>.<Table> という3つの部分で構成されており、接続名はデフォルトでソース名(例:PingOne1)になります。
sql = (
    "SELECT Id, Username "
    "FROM [PingOne1].[PingOne].[[CData].[Administrators].Users] "
    "WHERE EmployeeType = 'Contractor'"
)
PingOne のデータの抽出・変換・ロードを実装する方法は?
接続とクエリが準備できたら、petl を使ってPingOne のデータを抽出・変換・ロードします。この例では、PingOne のデータを抽出し、Username カラムでデータを並べ替えて、CSV ファイルにロードします。
table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'Username')

etl.tocsv(table2, '[cdata].[administrators].users_data.csv')
PingOne は Connect AI では読み取り専用のソースのため、このパイプラインではPingOne のデータの抽出と変換はできますが、行の書き戻しはできません。抽出が完了したら接続を閉じましょう。
conn.close()
CData Connect AI Python SDK を使えば、petl のような ETL パッケージでのデータへの直接アクセスも含め、通常のデータベースと同じようにPingOne のデータを扱えます。
関連情報と無料トライアル
これで、CData Connect AI Python SDK を使って、petl でリアルタイムのPingOne のデータをパイプライン処理できるようになりました。PingOne(および数百種類のその他のデータソース)への接続について詳しくは、Connect AI のページをご覧ください。
CData Connect AI の詳細、または無料トライアルにお申し込みください:
完全なソースコード
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)

sql = (
    "SELECT Id, Username "
    "FROM [PingOne1].[PingOne].[[CData].[Administrators].Users] "
    "WHERE EmployeeType = 'Contractor'"
)

table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'Username')

etl.tocsv(table2, '[cdata].[administrators].users_data.csv')
conn.close()