


Bitbucket のデータをPythonのpandasで可視化する方法|CData Connect AI
CData Connect AI Python SDKをpandasとMatplotlibに接続すると、パーソナルアクセストークンで認証するだけでリアルタイムのBitbucket のデータをDataFrameに読み込み、そのままグラフとして可視化できます。SQLAlchemyエンジンの設定やソースごとのドライバーインストールは不要です。
Python は豊富なモジュールのエコシステムを備えているため、素早く作業に取りかかり、システムをより効果的に連携できます。CData Connect AI Python SDK と pandas、Matplotlib のモジュールを使えば、Bitbucket のデータを可視化する Bitbucket 連携の Python アプリケーションやスクリプトを構築できます。この記事では、Connect AI に接続し、pandas と Matplotlib の組み込み関数を使ってBitbucket のデータをクエリし、その結果を可視化する方法をご紹介します。
Connect AI Python SDK(cdata-connect-ai)は DB-API 2.0(PEP 249)に準拠したクライアントなので、pandas は SDK の接続オブジェクトから直接クエリ結果を読み取れます。ソースごとにドライバーをインストールする必要も、SQLAlchemy のエンジンを設定する必要もありません。パーソナルアクセストークンで接続して、その接続をそのまま pandas.read_sql に渡すだけです。
Connect AI で Bitbucket に接続する方法は?
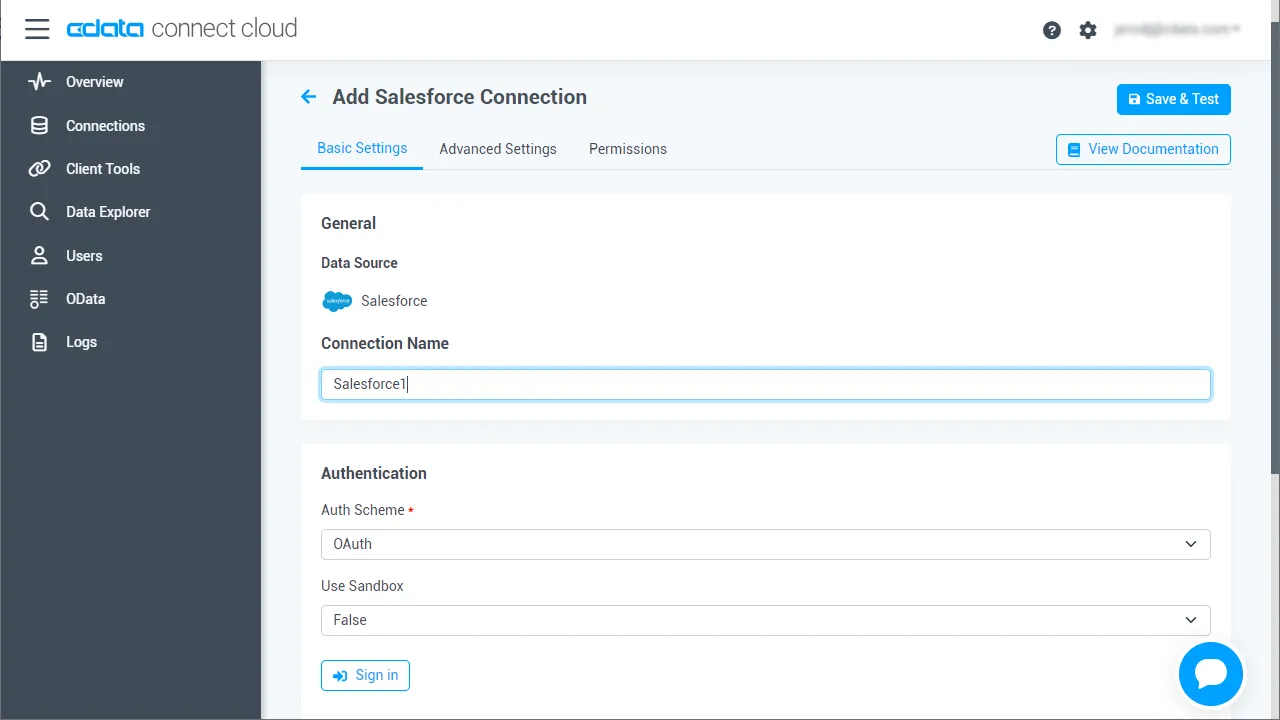
CData Connect AI では、直感的なクリック操作ベースのインターフェースでデータソースに接続できます。
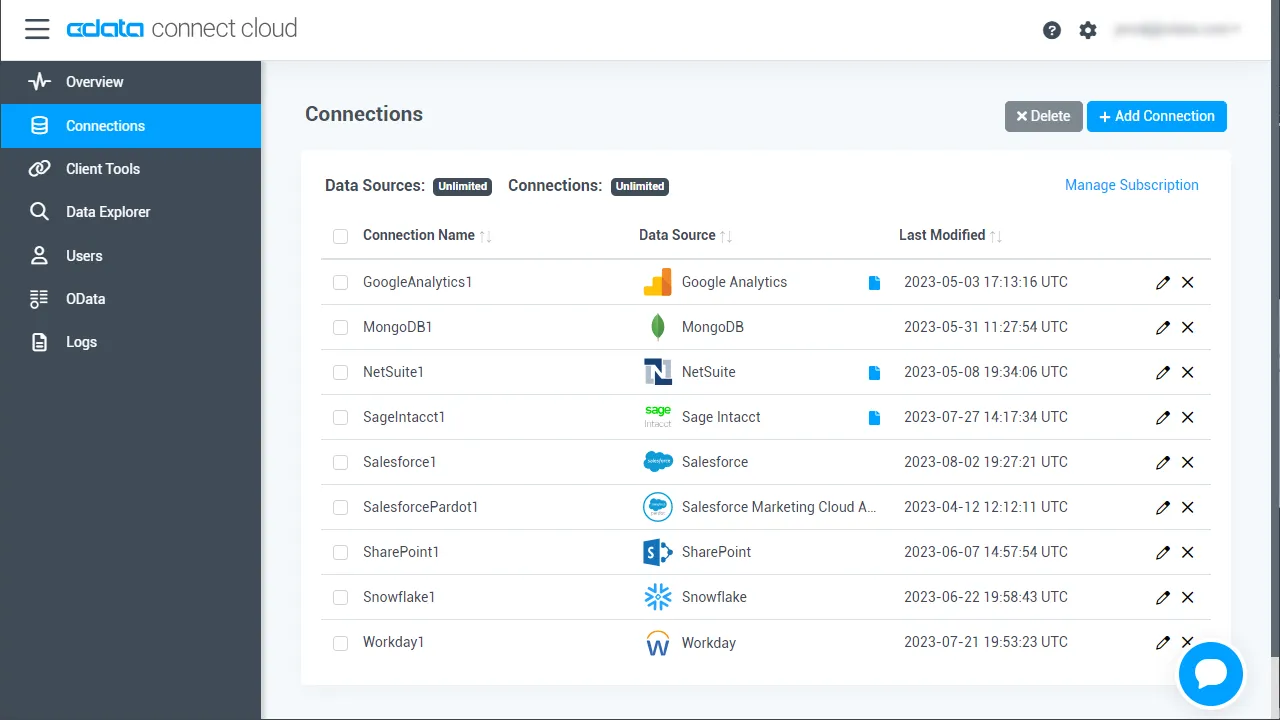
- Connect AI にログインし、Sources をクリックして、 Add Connection をクリックします
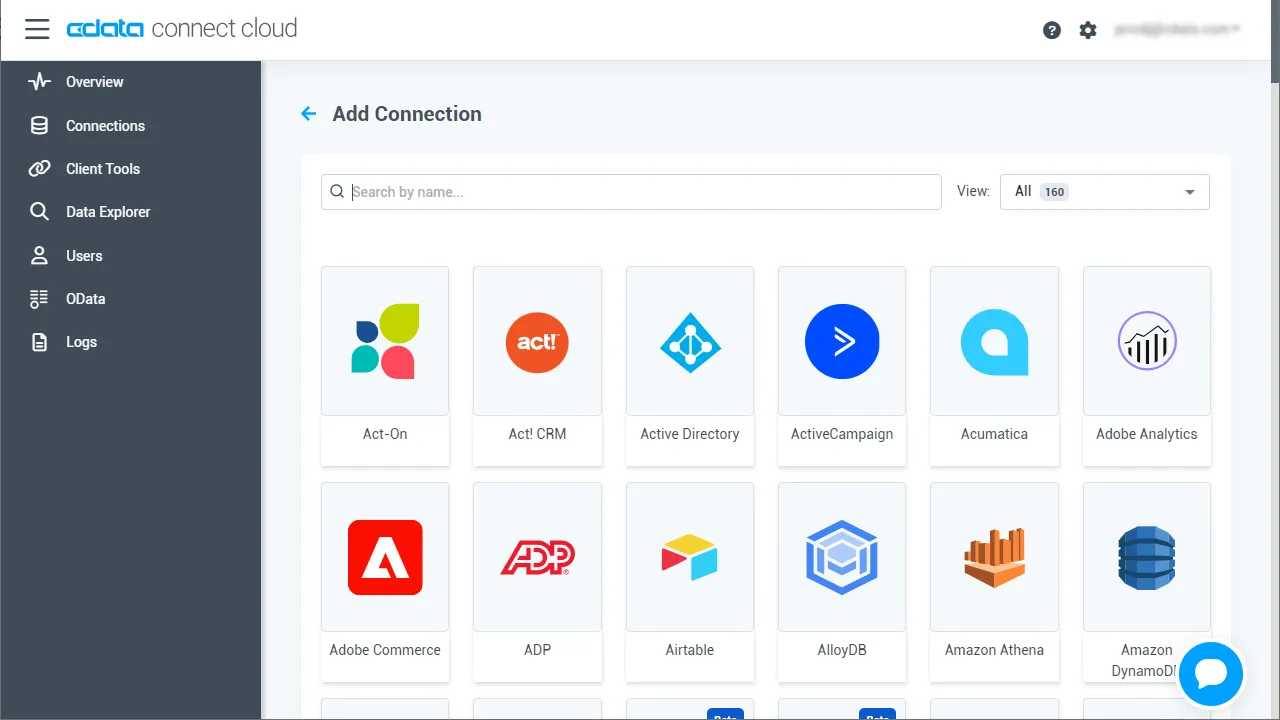
- 「Add Connection」パネルから「Bitbucket」を選択します
-
Bitbucket に接続するために必要な認証プロパティを入力します。
ほとんどのクエリでは、ワークスペースを設定する必要があります。唯一の例外は、Workspacesテーブルです。このテーブルはこのプロパティの設定を必要とせず、クエリを実行すると、Workspaceの設定に使用できるワークスペーススラッグのリストが提供されます。このテーブルにクエリを実行するには、スキーマを'Information'に設定し、SELECT * FROM Workspacesクエリを実行する必要があります。
Schemaを'Information'に設定すると、一般的な情報が表示されます。Bitbucketに接続するには、以下のパラメータを設定してください。
- Schema: ワークスペースのユーザー、リポジトリ、プロジェクトなどの一般的な情報を表示するには、これを'Information'に設定します。それ以外の場合は、クエリを実行するリポジトリまたはプロジェクトのスキーマに設定します。利用可能なスキーマの完全なセットを取得するには、sys_schemasテーブルにクエリを実行してください。
- Workspace: Workspacesテーブルにクエリを実行する場合を除き、必須です。Workspacesテーブルへのクエリにはこのプロパティは必要ありません。そのクエリはWorkspaceの設定に使用できるワークスペーススラッグのリストのみを返すためです。
Bitbucketでの認証
BitbucketはOAuth認証のみをサポートしています。すべてのOAuthフローからこの認証を有効にするには、カスタムOAuthアプリケーションを作成し、AuthSchemeをOAuthに設定する必要があります。
特定の認証ニーズ(デスクトップアプリケーション、Webアプリケーション、ヘッドレスマシン)に必要な接続プロパティについては、ヘルプドキュメントを必ず確認してください。
カスタムOAuthアプリケーションの作成
Bitbucketアカウントから、以下のステップを実行します。
- 設定(歯車アイコン)に移動し、ワークスペース設定を選択します。
- アプリと機能セクションで、OAuthコンシューマーを選択します。
- コンシューマーを追加をクリックします。
- カスタムアプリケーションの名前と説明を入力します。
- コールバックURLを設定します。
- デスクトップアプリケーションとヘッドレスマシンの場合、http://localhost:33333または任意のポート番号を使用します。ここで設定するURIがCallbackURLプロパティになります。
- Webアプリケーションの場合、信頼できるリダイレクトURLにコールバックURLを設定します。このURLは、ユーザーがアプリケーションにアクセスが許可されたことを確認するトークンを持って戻るWebの場所です。
- クライアント認証情報を使用して認証する予定の場合、これはプライベートコンシューマーですを選択する必要があります。ドライバーでは、AuthSchemeをclientに設定する必要があります。
- OAuthアプリケーションに与える権限を選択します。これにより、読み取りおよび書き込みできるデータが決まります。
- 新しいカスタムアプリケーションを保存するには、保存をクリックします。
- アプリケーションが保存された後、それを選択して設定を表示できます。アプリケーションのKeyとSecretが表示されます。これらを将来の使用のために記録してください。Keyを使用してOAuthClientIdを設定し、Secretを使用してOAuthClientSecretを設定します。
- 「Save & Test」をクリックします
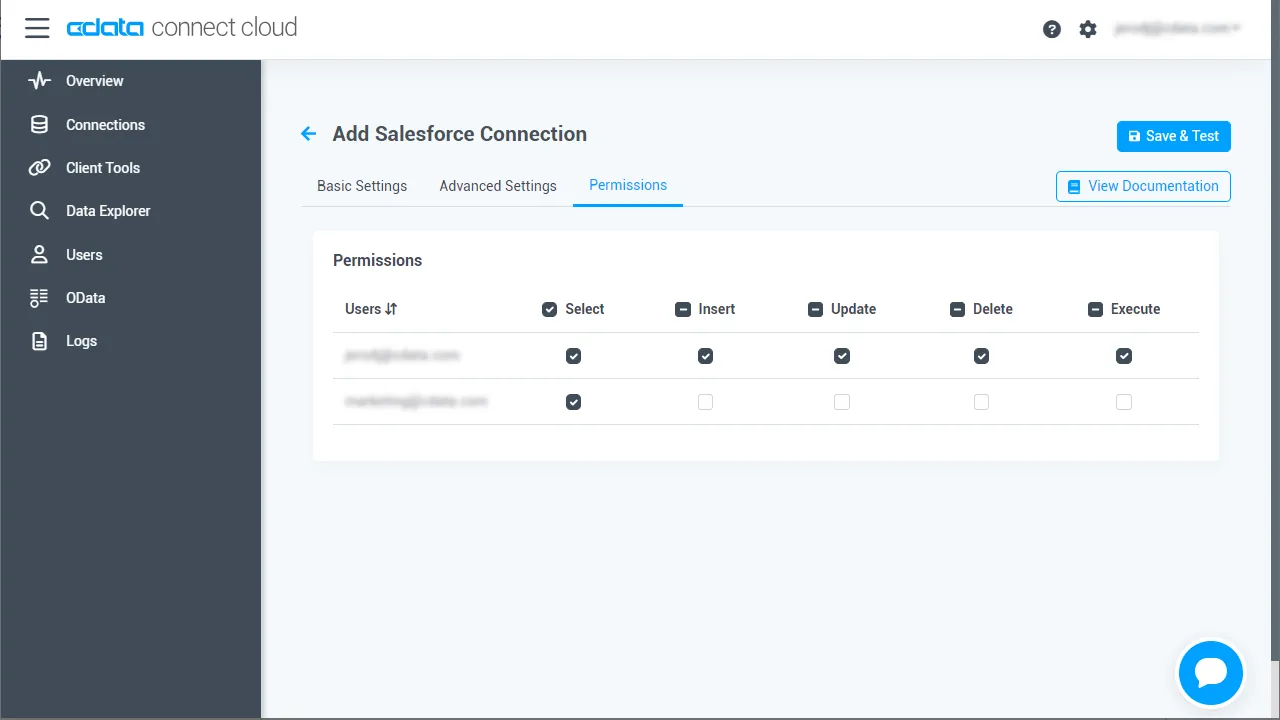
- 「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークン(PAT)を生成する
Python SDK は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使って Connect AI に認証します。アクセスの粒度を保つために、アプリケーションごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
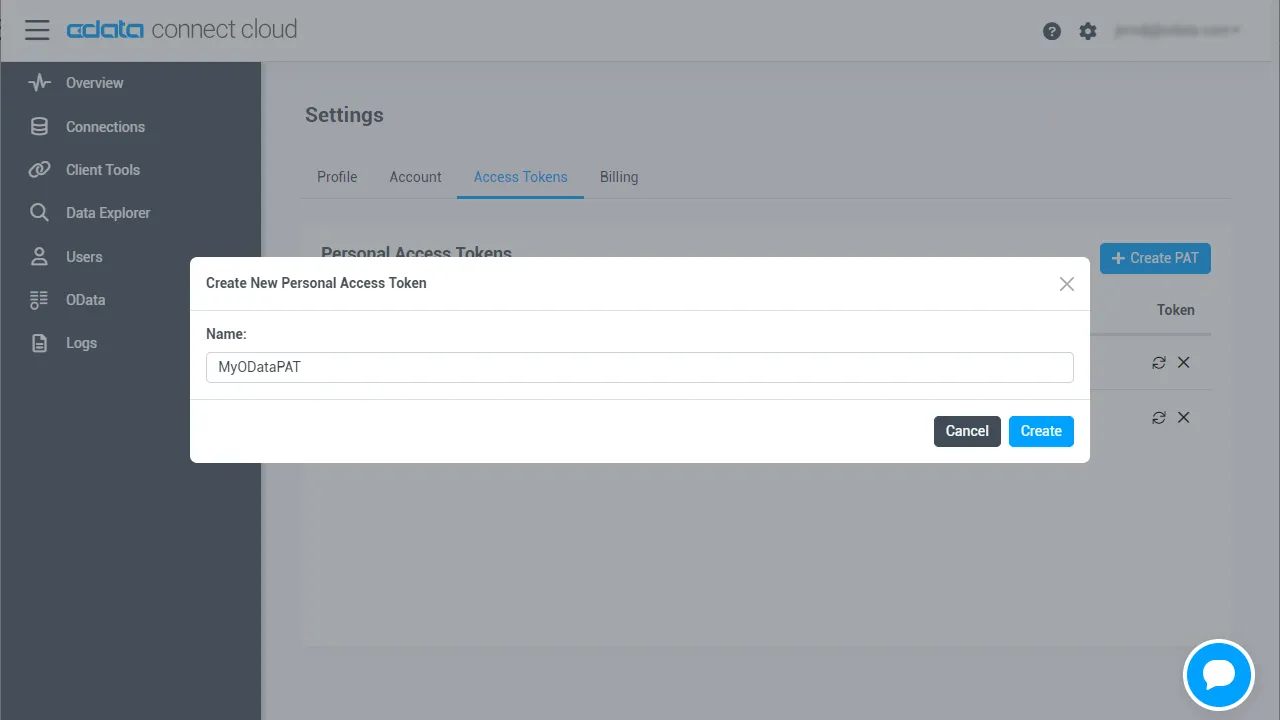
- 設定ページの Access Tokens セクションに移動し、 Create PAT をクリックします。
- PAT に名前を付けて Create をクリックします。
- パーソナルアクセストークンは作成時にのみ表示されます。必ずコピーして安全な場所に保管してください。
必要なモジュールをインストールする
pip ユーティリティを使って、SDK(pandas エクストラ付き)と Matplotlib をインストールします。
pip install "cdata-connect-ai[full]"
pip install matplotlib
Python で Bitbucket のデータを可視化する
モジュールをインポートし、アカウントのメールアドレスと PAT で Connect AI に接続します。識別子は <Connection>.<Schema>.<Table> という3つの部分で構成されており、接続名はデフォルトでソース名(例:Bitbucket1)になります。
import pandas
import matplotlib.pyplot as plt
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)
pandas で Bitbucket をクエリする
pandas の read_sql 関数を使って SQL ステートメントを実行し、結果セットを DataFrame に格納します。エンジンは不要で、SDK の接続をそのまま渡すだけです。
df = pandas.read_sql(
    "SELECT Title, ContentRaw "
    "FROM [Bitbucket1].[Bitbucket].[Issues] "
    "WHERE Id = '1'",
    conn,
)
注意:pandas が、公式にサポートしているのは SQLAlchemy の接続のみであるという UserWarning を出力する場合があります。これは DB-API 接続を直接渡したときに想定される動作です。クエリは正しく実行されるため、この警告は無視して問題ありません。
Bitbucket のデータを可視化する
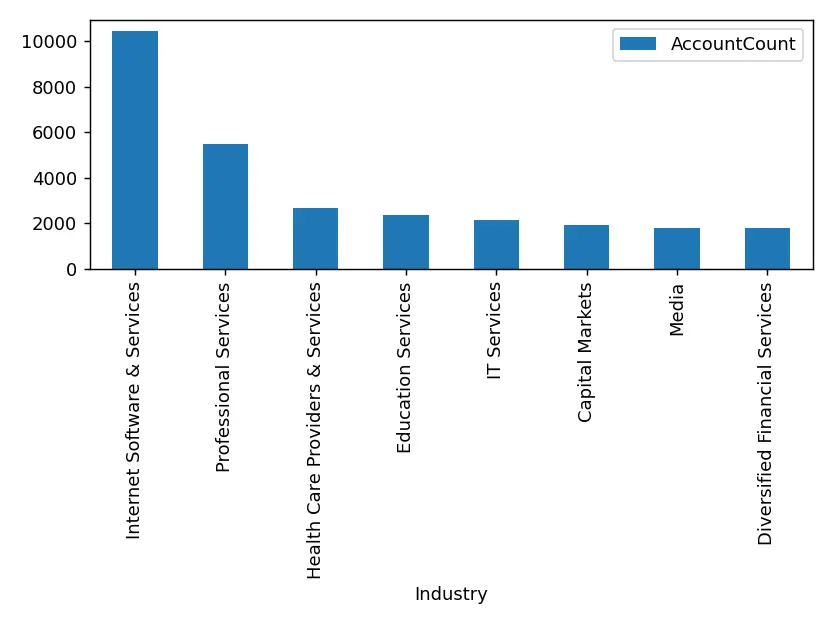
クエリ結果を DataFrame に格納したら、plot 関数を使ってチャートを作成します。show メソッドを使うと、チャートが新しいウィンドウに表示されます。
df.plot(kind="bar", x="Title", y="ContentRaw")
plt.show()

conn.close()
関連情報と無料トライアル
これで、CData Connect AI Python SDK を通じて、リアルタイムのBitbucket のデータを pandas に読み込めるようになりました。Bitbucket(および数百種類のその他のデータソース)への接続について詳しくは、Connect AI のページをご覧ください。
CData Connect AI の詳細、または無料トライアルにお申し込みください:
完全なソースコード
import pandas
import matplotlib.pyplot as plt
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)

df = pandas.read_sql(
    "SELECT Title, ContentRaw "
    "FROM [Bitbucket1].[Bitbucket].[Issues] "
    "WHERE Id = '1'",
    conn,
)

df.plot(kind="bar", x="Title", y="ContentRaw")
plt.show()

conn.close()