


Bitbucket のデータをPythonのpetlでETL処理する方法|CData Connect AI
CData Connect AI の Python SDK と petl フレームワークを使うと、Bitbucket のデータをローカルにドライバーをインストールすることなく、Pythonで直接抽出・変換・ロードするETLパイプラインを構築できます。パーソナルアクセストークンで接続し、数行のコードで設定完了です。
Python は豊富なモジュールのエコシステムを備えているため、素早く作業に取りかかり、システムをより効果的に連携できます。CData Connect AI Python SDK と petl フレームワークを使えば、Bitbucket のデータを抽出・変換して CSV などに出力する Bitbucket 連携のアプリケーションやパイプラインを構築できます。この記事では、Connect AI に接続し、petl を使ってBitbucket のデータを抽出・変換し、CSV ファイルに書き出す方法をご紹介します。
Connect AI Python SDK(cdata-connect-ai)は DB-API 2.0(PEP 249)に準拠したクライアントなので、petl は etl.fromdb を使って SDK の接続から直接読み取れます。ソースごとにドライバーをインストールする必要はありません。パーソナルアクセストークンで接続して、パイプラインを構築しましょう。
Python + petl でできること
Bitbucket データの定期抽出パイプライン構築
SQL クエリで取得した Bitbucket のレコードを petl の etl.fromdb で抽出し、etl.sort などの変換処理をはさんでから CSV に書き出す、軽量な ETL パイプラインを構築できます。
複数データソースとの統合分析
DB-API 2.0 準拠のクライアントなので、同じコードパターンで Bitbucket 以外のデータソースにも接続でき、petl 上で結合・整形してから任意の出力先にロードできます。
Bitbucket への書き戻し処理の自動化
書き込みに対応した権限を持つ PAT で接続していれば、cursor.executemany を使ったバッチ INSERT により、変換済みデータを Bitbucket に自動で書き戻す処理を組み込めます。
Connect AI で Bitbucket に接続する方法は?
CData Connect AI では、直感的なクリック操作ベースのインターフェースでデータソースに接続できます。
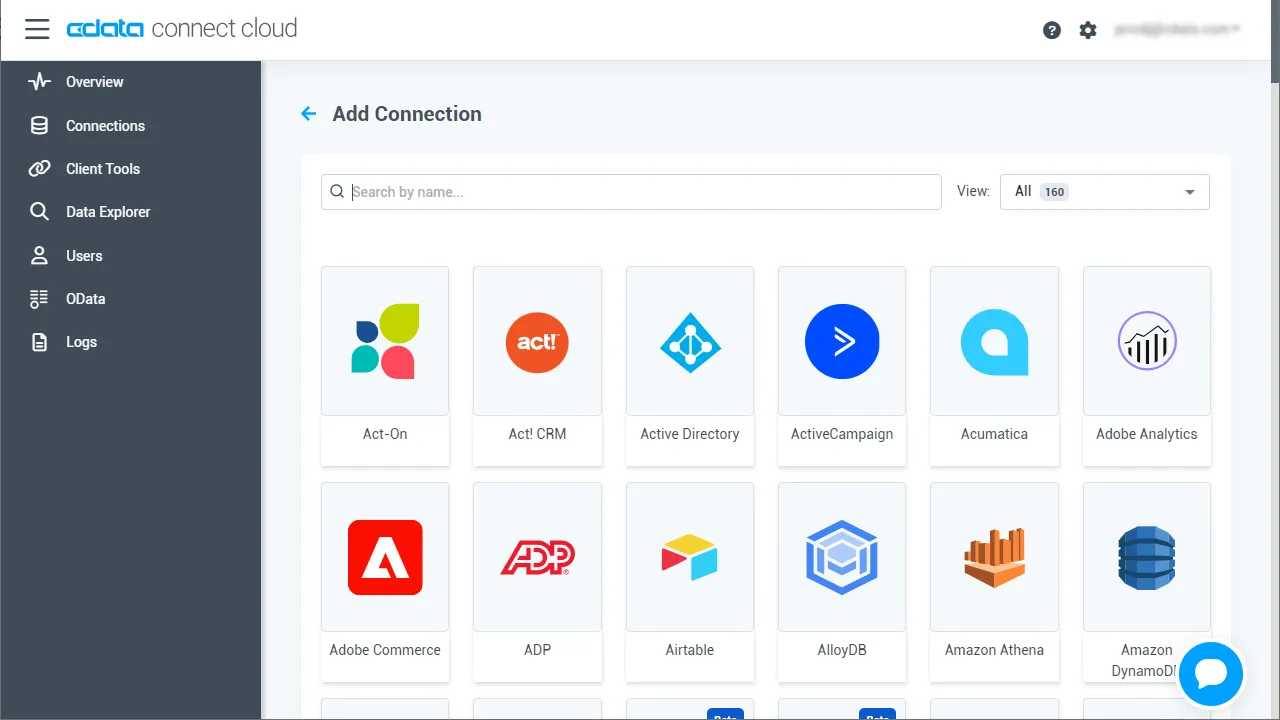
- Connect AI にログインし、Sources をクリックして、 Add Connection をクリックします
- 「Add Connection」パネルから「Bitbucket」を選択します
-
Bitbucket に接続するために必要な認証プロパティを入力します。
ほとんどのクエリでは、ワークスペースを設定する必要があります。唯一の例外は、Workspacesテーブルです。このテーブルはこのプロパティの設定を必要とせず、クエリを実行すると、Workspaceの設定に使用できるワークスペーススラッグのリストが提供されます。このテーブルにクエリを実行するには、スキーマを'Information'に設定し、SELECT * FROM Workspacesクエリを実行する必要があります。
Schemaを'Information'に設定すると、一般的な情報が表示されます。Bitbucketに接続するには、以下のパラメータを設定してください。
- Schema: ワークスペースのユーザー、リポジトリ、プロジェクトなどの一般的な情報を表示するには、これを'Information'に設定します。それ以外の場合は、クエリを実行するリポジトリまたはプロジェクトのスキーマに設定します。利用可能なスキーマの完全なセットを取得するには、sys_schemasテーブルにクエリを実行してください。
- Workspace: Workspacesテーブルにクエリを実行する場合を除き、必須です。Workspacesテーブルへのクエリにはこのプロパティは必要ありません。そのクエリはWorkspaceの設定に使用できるワークスペーススラッグのリストのみを返すためです。
Bitbucketでの認証
BitbucketはOAuth認証のみをサポートしています。すべてのOAuthフローからこの認証を有効にするには、カスタムOAuthアプリケーションを作成し、AuthSchemeをOAuthに設定する必要があります。
特定の認証ニーズ(デスクトップアプリケーション、Webアプリケーション、ヘッドレスマシン)に必要な接続プロパティについては、ヘルプドキュメントを必ず確認してください。
カスタムOAuthアプリケーションの作成
Bitbucketアカウントから、以下のステップを実行します。
- 設定(歯車アイコン)に移動し、ワークスペース設定を選択します。
- アプリと機能セクションで、OAuthコンシューマーを選択します。
- コンシューマーを追加をクリックします。
- カスタムアプリケーションの名前と説明を入力します。
- コールバックURLを設定します。
- デスクトップアプリケーションとヘッドレスマシンの場合、http://localhost:33333または任意のポート番号を使用します。ここで設定するURIがCallbackURLプロパティになります。
- Webアプリケーションの場合、信頼できるリダイレクトURLにコールバックURLを設定します。このURLは、ユーザーがアプリケーションにアクセスが許可されたことを確認するトークンを持って戻るWebの場所です。
- クライアント認証情報を使用して認証する予定の場合、これはプライベートコンシューマーですを選択する必要があります。ドライバーでは、AuthSchemeをclientに設定する必要があります。
- OAuthアプリケーションに与える権限を選択します。これにより、読み取りおよび書き込みできるデータが決まります。
- 新しいカスタムアプリケーションを保存するには、保存をクリックします。
- アプリケーションが保存された後、それを選択して設定を表示できます。アプリケーションのKeyとSecretが表示されます。これらを将来の使用のために記録してください。Keyを使用してOAuthClientIdを設定し、Secretを使用してOAuthClientSecretを設定します。
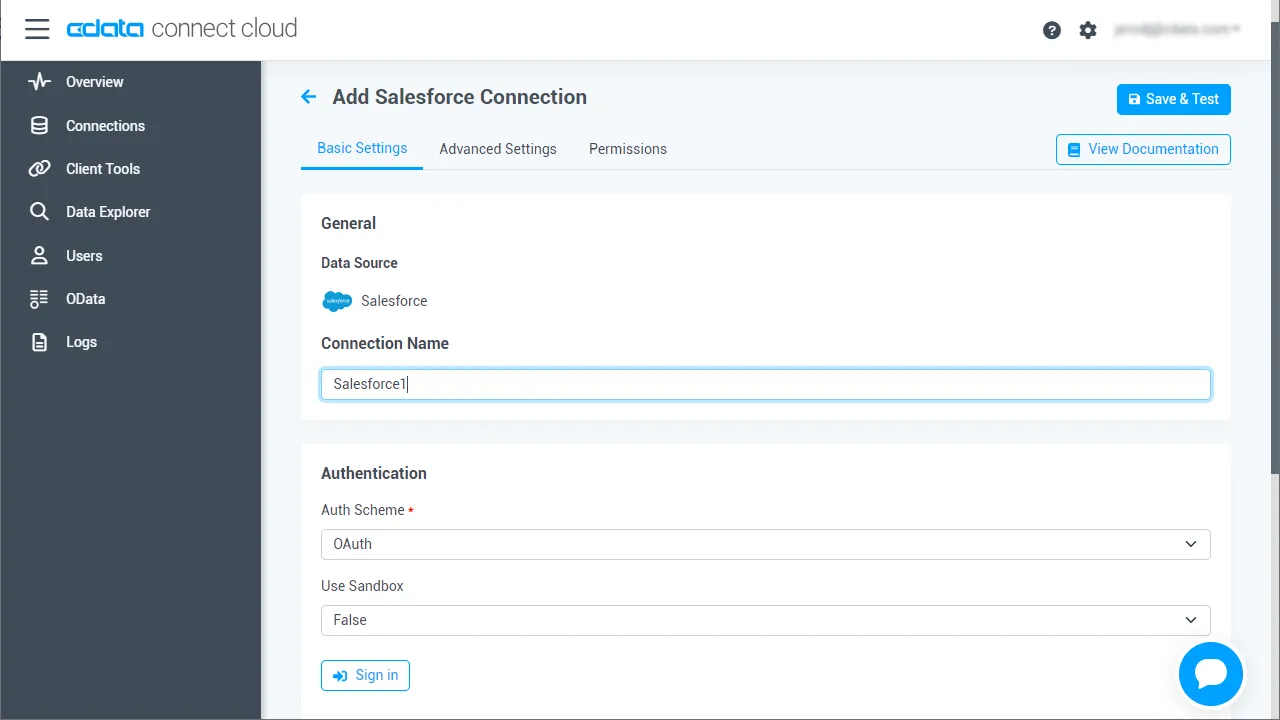
- 「Save & Test」をクリックします
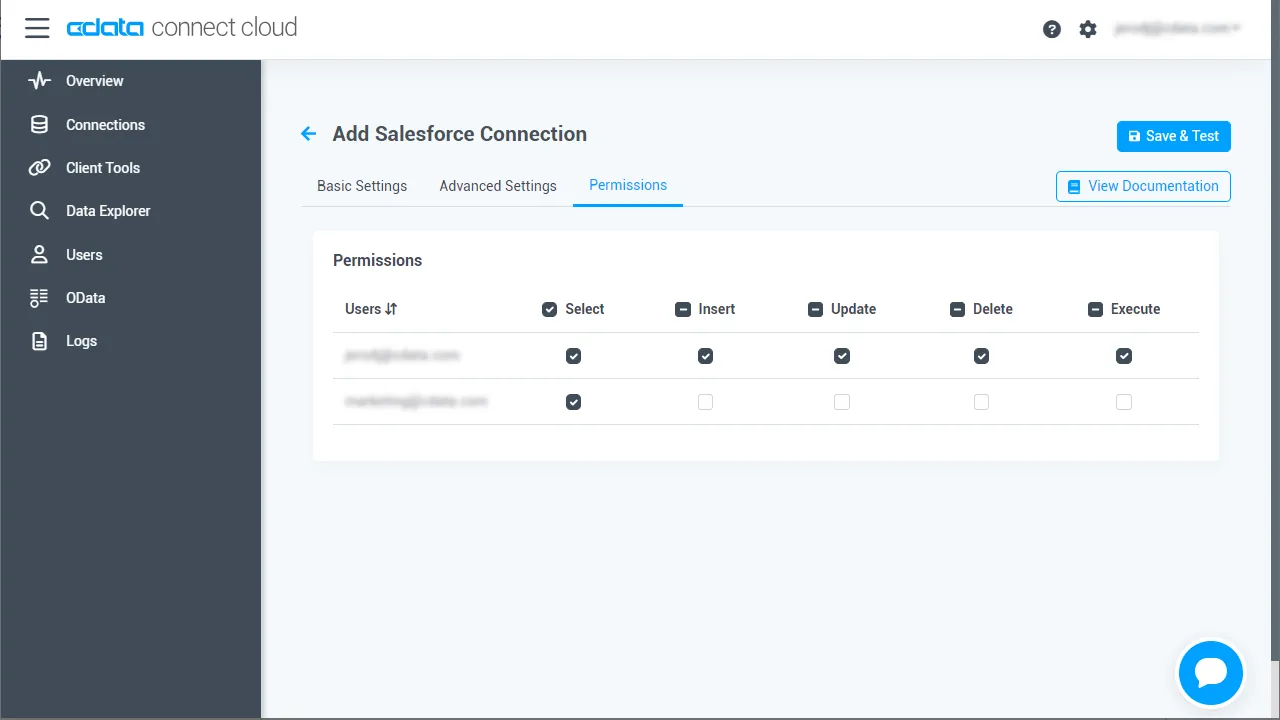
- 「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークン(PAT)を生成する
Python SDK は、アカウントのメールアドレスとパーソナルアクセストークン(PAT)を使って Connect AI に認証します。アクセスの粒度を保つために、アプリケーションごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
- 設定ページの Access Tokens セクションに移動し、 Create PAT をクリックします。
- PAT に名前を付けて Create をクリックします。
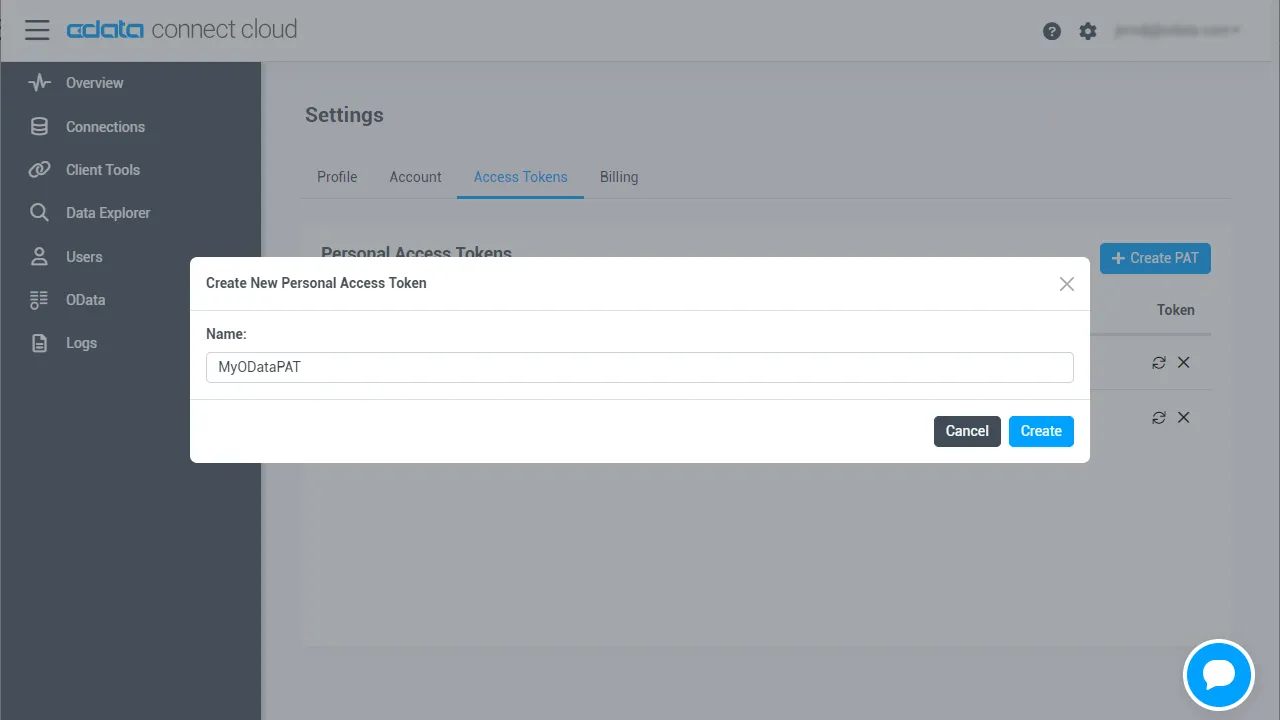
- パーソナルアクセストークンは作成時にのみ表示されます。必ずコピーして安全な場所に保管してください。
必要なモジュールをインストールする方法は?
pip ユーティリティを使って、SDK と petl フレームワークをインストールします。
pip install cdata-connect-ai
pip install petl
Python で Bitbucket のデータの ETL アプリを構築する方法は?
必要なモジュールをインストールしたら、ETL アプリを構築する準備は完了です。以下にコードスニペットを紹介しますが、完全なソースコードは記事の末尾に掲載しています。
まずモジュールをインポートし、アカウントのメールアドレスと PAT で Connect AI に接続します。
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)
Bitbucket をクエリする SQL ステートメントを作成する方法は?
SQL を使って、Bitbucket をクエリするステートメントを作成します。この記事では、Issues エンティティからデータを読み取ります。識別子は <Connection>.<Schema>.<Table> という3つの部分で構成されており、接続名はデフォルトでソース名(例:Bitbucket1)になります。
sql = (
    "SELECT Title, ContentRaw "
    "FROM [Bitbucket1].[Bitbucket].[Issues] "
    "WHERE Id = '1'"
)
Bitbucket のデータの抽出・変換・ロードを実装する方法は?
接続とクエリが準備できたら、petl を使ってBitbucket のデータを抽出・変換・ロードします。この例では、Bitbucket のデータを抽出し、ContentRaw カラムでデータを並べ替えて、CSV ファイルにロードします。
table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'ContentRaw')

etl.tocsv(table2, 'issues_data.csv')
新しい行を Bitbucket に書き戻す方法は?
Bitbucket が書き込みに対応している場合は、バッチ INSERT で行を書き戻せます。SDK の executemany は、@name のプレースホルダーと、1行につき1つのパラメータ辞書のリストを受け取ります。
cur = conn.cursor()
cur.executemany(
    "INSERT INTO [Bitbucket1].[Bitbucket].[Issues] (Title, ContentRaw) "
    "VALUES (@val1, @val2)",
    [
        {"@val1": "New value 1", "@val2": "New value 1"},
        {"@val1": "New value 2", "@val2": "New value 2"},
    ],
)
print(f"Rows inserted: {cur.rowcount}")

conn.close()
注意:書き込み可能なソースであっても、読み取り専用の PAT や接続権限では書き込み操作は拒否されます。
CData Connect AI Python SDK を使えば、petl のような ETL パッケージでのデータへの直接アクセスも含め、通常のデータベースと同じようにBitbucket のデータを扱えます。
関連情報と無料トライアル
これで、CData Connect AI Python SDK を使って、petl でリアルタイムのBitbucket のデータをパイプライン処理できるようになりました。Bitbucket(および数百種類のその他のデータソース)への接続について詳しくは、Connect AI のページをご覧ください。
CData Connect AI の詳細、または無料トライアルにお申し込みください:
完全なソースコード
import petl as etl
import cdata_connect_ai

conn = cdata_connect_ai.connect(
    username="[email protected]",
    password="<your_pat>",
)

sql = (
    "SELECT Title, ContentRaw "
    "FROM [Bitbucket1].[Bitbucket].[Issues] "
    "WHERE Id = '1'"
)

table1 = etl.fromdb(conn, sql)

table2 = etl.sort(table1, 'ContentRaw')

etl.tocsv(table2, 'issues_data.csv')

cur = conn.cursor()
cur.executemany(
    "INSERT INTO [Bitbucket1].[Bitbucket].[Issues] (Title, ContentRaw) "
    "VALUES (@val1, @val2)",
    [
        {"@val1": "New value 1", "@val2": "New value 1"},
        {"@val1": "New value 2", "@val2": "New value 2"},
    ],
)
print(f"Rows inserted: {cur.rowcount}")
conn.close()