


Google ADKエージェントからKafka にMCP経由で接続

Google ADK(Agent Development Kit)は、さまざまなデータソースやサービスと連携できる AI エージェントを構築するための、モデル非依存の強力なフレームワークです。CData Connect AI のリモートMCP と組み合わせることで、自然言語クエリを通じてKafka のデータとリアルタイムでやり取りできるインテリジェントなエージェントを構築できます。この記事では、Connect AI Remote MCP を使用して Kafka に接続し、Google ADK エージェントを設定して ADK Web 経由で とやり取りする方法をご紹介します。
CData Connect AI は、Kafkaを含む数百のデータソースをMCP経由でAIツールにつなげるクラウドサービスです。接続情報はConnect AI側で一元管理されるため、Google ADK エージェントにKafkaの認証情報を直接渡すことなくセキュアに連携できます。
この記事では、自然言語を使用してデータを会話形式で探索(Vibe Query)できる Google ADK エージェントの設定方法をご紹介します。Connect AI を使用すれば、Kafka に加えて、数百の他のデータソースにもアクセスできるエージェントを構築できます。
ステップ 1:Google ADK 用の Kafka 接続を設定する
Google ADK エージェントから Kafka への接続は、CData Connect AI のリモートMCP を通じて実現されます。ADK エージェントから Kafka とやり取りするために、まず CData Connect AI で Kafka 接続を作成・設定していきましょう。
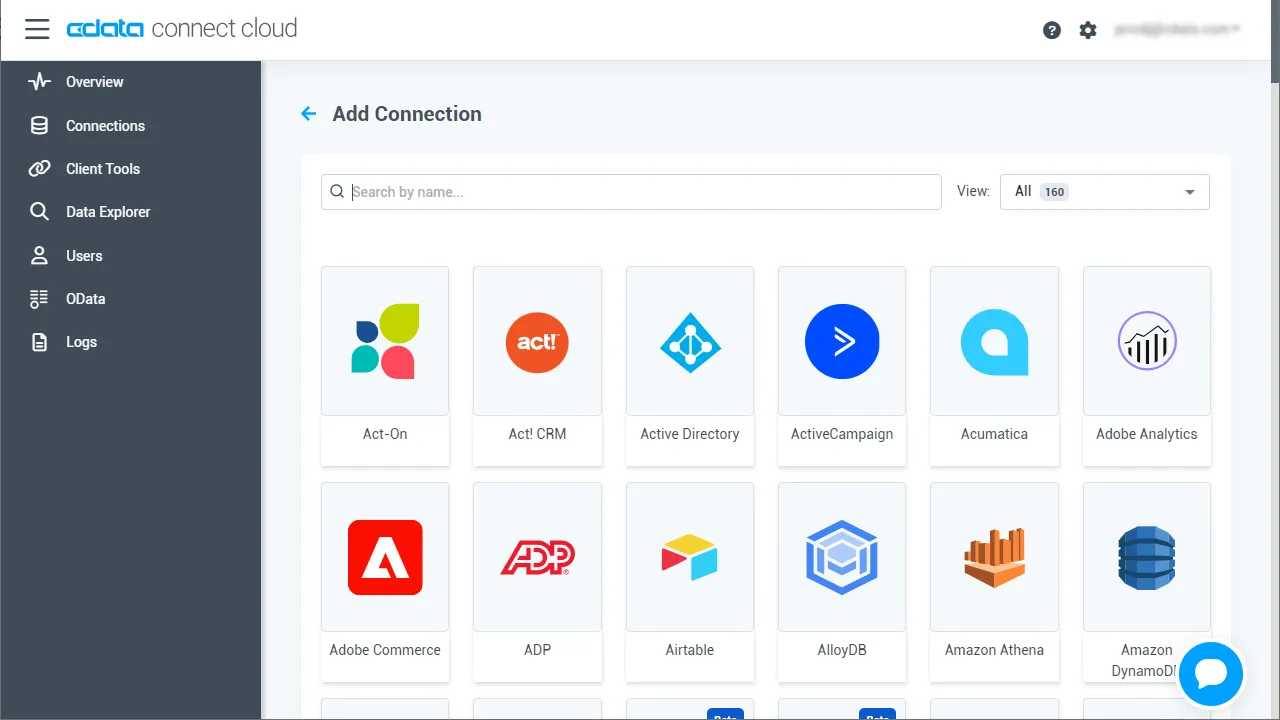
- Connect AI にログインし、「Sources」をクリックして、「Add Connection」をクリックします
- 「Add Connection」パネルから「Kafka」を選択します
-
Kafka に接続するために必要な認証プロパティを入力します。
Apache Kafka 接続プロパティの取得・設定方法
それでは、Apache Kafka に接続していきましょう。.NET ベースのエディションは、Confluent.Kafka およびlibrdkafka ライブラリに依存して機能します。 これらのアセンブリはインストーラーにバンドルされており、CData 製品と一緒に自動的にインストールされます。 別のインストール方法をご利用の場合は、NuGet から依存関係のあるConfluent.Kafka 2.6.0をインストールしてください。
Apache Kafka サーバーのアドレスを指定するには、BootstrapServers パラメータを使用します。
デフォルトでは、CData 製品はデータソースとPLAINTEXT で通信しており、そのため、データはすべて暗号化されずに送信されます。 通信を暗号化したい場合は、以下の設定を行ってください:
- UseSSL をtrue に設定し、CData 製品がSSL 暗号化を使用するように構成します
- SSLServerCert およびSSLServerCertType を設定して、サーバー証明書をロードします
Apache Kafka への認証
続いて、認証方法を設定しましょう。Apache Kafka データソースでは、以下の認証方法をサポートしています:
- Anonymous
- Plain
- SCRAM ログインモジュール
- SSL クライアント証明書
- Kerberos
Anonymous 認証
Apache Kafka の特定のオンプレミスデプロイメントでは、認証接続プロパティを設定することなくApache Kafka に接続できます。 このような接続はanonymous(匿名)と呼ばれます。
匿名認証を行うには、以下のプロパティを設定してください。
- AuthScheme:None
その他の認証方法については、ヘルプドキュメントをご確認ください。
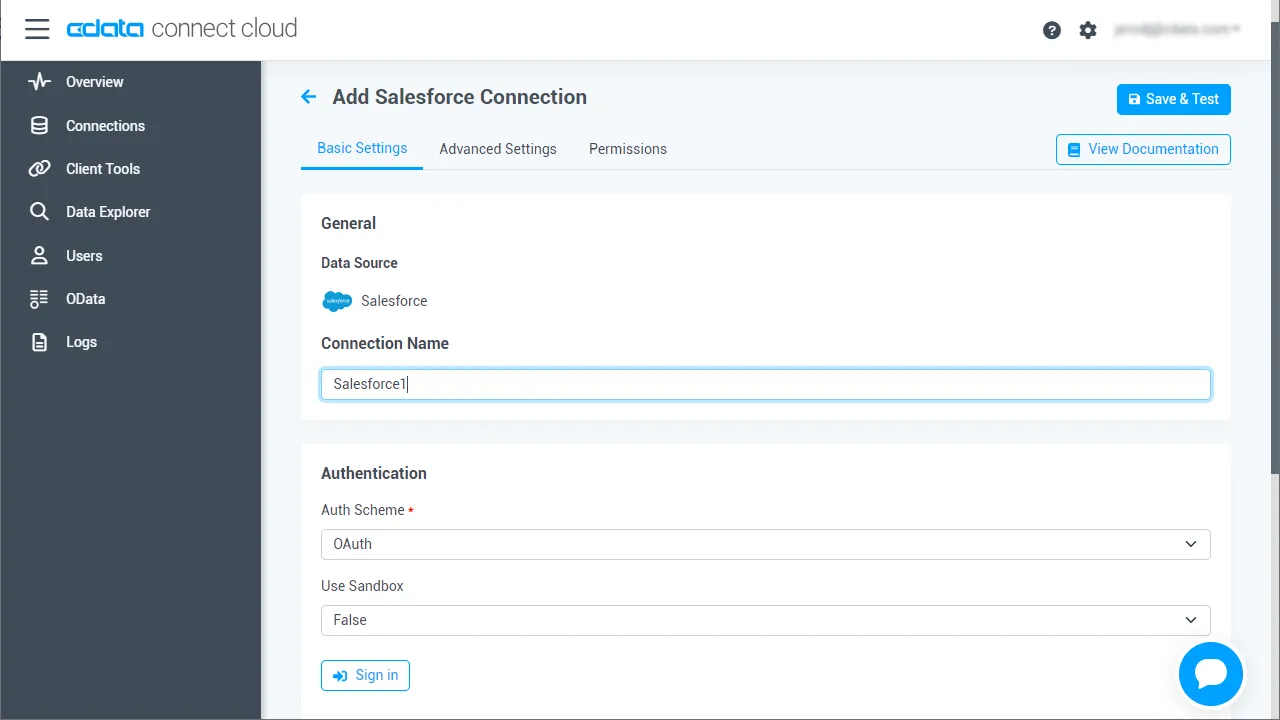
- 「Create & Test」をクリックします
-
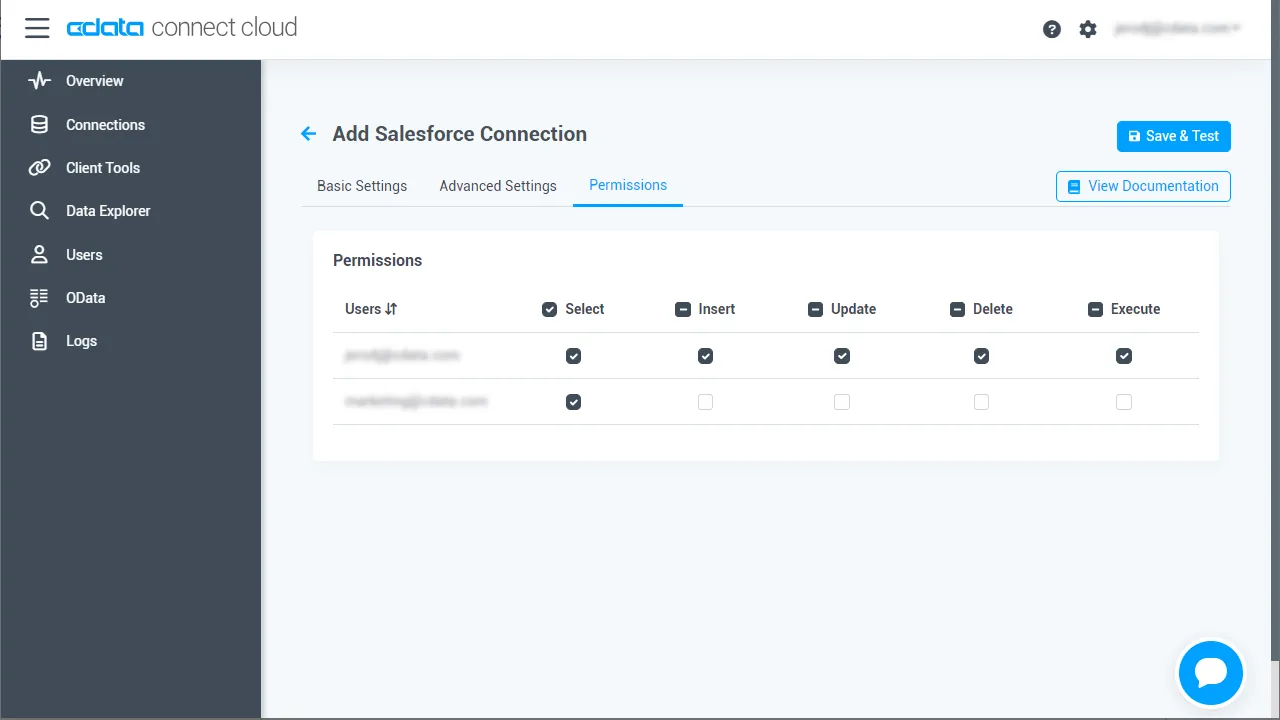
「Add Kafka Connection」ページの「Permissions」タブに移動し、ユーザーベースの権限を更新します。
パーソナルアクセストークンの追加
パーソナルアクセストークン(PAT)は、Google ADK エージェントから Connect AI への接続を認証するために使用されます。アクセスの粒度を維持するために、サービスごとに個別の PAT を作成することをおすすめします。
- Connect AI アプリの右上にある歯車アイコン()をクリックして、設定ページを開きます。
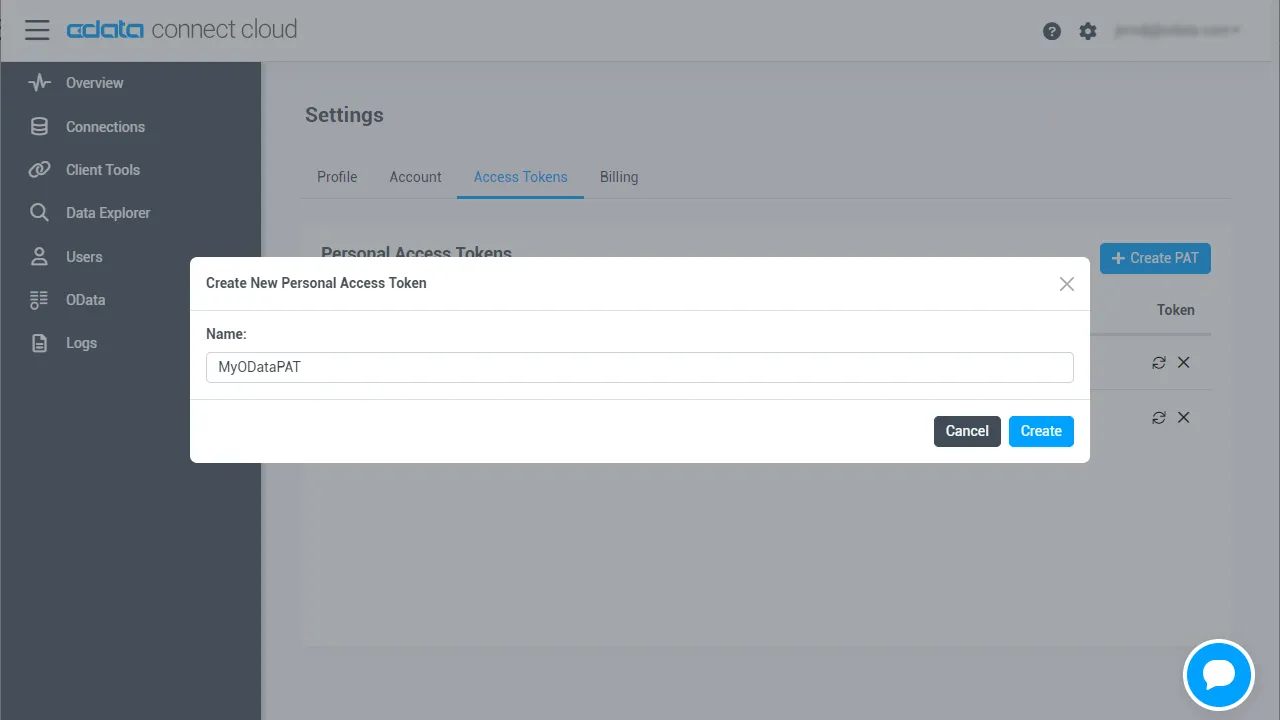
- 設定ページの「Access Tokens」セクションに移動し、「Create PAT」をクリックします。
-
PAT に名前を付けて「Create」をクリックします。
- パーソナルアクセストークンは作成時にのみ表示されますので、必ずコピーして安全な場所に保管してください。
これで接続の設定と PAT の生成が完了しました。Google ADK エージェントから Kafka に接続する準備が整いました。
ステップ 2:Google ADK エージェントを CData Connect AI 用に設定する
以下の手順に従って、CData Connect AI に接続するように Google ADK エージェントを設定していきましょう。事前構築済みのエージェントをこちらから使用できます。または、以下の手順に従って独自のエージェントを作成することもできます。
-
Google ADK Python SDK がインストールされていることを確認してください。インストールされていない場合は、pip を使用してインストールします。
pip install google-genkit google-adk - エージェントの設定ファイル(通常は agent.py)を作成または更新して、CData Connect AI MCP 接続を含めます。Connect AI 認証情報を使用して MCP ツールセットを設定する必要があります。
-
MCP サーバー接続用の環境変数または設定をセットアップします。プロジェクトのルートに .env ファイルを作成し、以下の変数を設定します。
YOUR_EMAIL を Connect AI のメールアドレスに、YOUR_PAT をステップ 1 で作成したパーソナルアクセストークンに置き換えてください。MCP_SERVER_URL=https://mcp.cloud.cdata.com/mcp MCP_USERNAME=YOUR_EMAIL MCP_PASSWORD=YOUR_PAT -
CData Connect AI MCP Server を使用するように agent.py ファイルを設定します。以下は設定例です。
import os import base64 from google.adk.agents import LlmAgent from google.adk.tools.mcp_tool.mcp_toolset import MCPToolset from google.adk.tools.mcp_tool.mcp_session_manager import StreamableHTTPConnectionParams from dotenv import load_dotenv # 環境変数を読み込む load_dotenv() # 環境から設定を取得 MCP_SERVER_URL = os.getenv('MCP_SERVER_URL', 'https://mcp.cloud.cdata.com/mcp') MCP_USERNAME = os.getenv('MCP_USERNAME', '') MCP_PASSWORD = os.getenv('MCP_PASSWORD', '') # MCP サーバー用の認証ヘッダーを作成 auth_header = {} if MCP_USERNAME and MCP_PASSWORD: credentials = f"{MCP_USERNAME}:{MCP_PASSWORD}" auth_header = {"Authorization": f"Basic {base64.b64encode(credentials.encode()).decode()}"} # CData MCP ツールを使用してエージェントを定義 root_agent = LlmAgent( model='gemini-2.0-flash-exp', # サポートされている任意のモデルを使用できます name='data_query_assistant', instruction="""あなたは CData Connect AI を通じて Kafka データにアクセスできるデータクエリアシスタントです。 ユーザーが Kafka をリアルタイムで探索・クエリできるようサポートしてください。 利用可能な MCP ツールを使用して以下を実行できます: - 利用可能なデータベースとスキーマの一覧表示 - テーブル構造の探索 - SQL クエリの実行 - データに関する洞察の提供 実行内容を常に説明し、結果を明確にフォーマットしてください。""", tools=[ MCPToolset( connection_params=StreamableHTTPConnectionParams( url=MCP_SERVER_URL, headers=auth_header ) ) ], ) -
ADK Web でエージェントを実行します。プロジェクトディレクトリから以下を実行してください。
adk web --port 5000 .注:pip install --user で ADK をインストールした場合、adk コマンドが PATH に含まれていない可能性があります。以下のいずれかの方法で対処できます。
- フルパスを使用:~/Library/Python/3.x/bin/adk(macOS の場合)
- PATH に追加:export PATH="$HOME/Library/Python/3.x/bin:$PATH"
- PATH が自動的に設定される仮想環境を使用
- ブラウザでADK のWeb インターフェースを開きます(通常は http://localhost:5000)。
- ドロップダウンメニューからエージェントを選択します(エージェント設定の name パラメータに基づいて名前が付けられています)。
- これで、自然言語クエリを使用してKafka との会話を開始できます。。
ステップ 3:Kafka データへのアクセスを備えたインテリジェントエージェントを構築する
Google ADK エージェントを設定して CData Connect AI に接続できたので、自然言語を使用して Kafka とやり取りする高度なエージェントを構築できます。MCP 統合により、エージェントに強力なデータアクセス機能が提供されます。
エージェントで使用可能な MCP ツール
Google ADK エージェントは、以下のCData Connect AI MCP ツールにアクセスできます。
- queryData:接続されたデータソースに対してSQL クエリを実行
- execData:ストアドプロシージャを実行
- getCatalogs:利用可能なデータベース接続を取得
- getSchemas:特定のカタログのデータベーススキーマを一覧表示
- getTables:スキーマ内のテーブルを一覧表示
- getColumns:特定のテーブルの列情報を取得
- getPrimaryKeys:プライマリキー情報を取得
- getIndexes:テーブルのインデックス情報を取得
- getProcedures:利用可能なストアドプロシージャを一覧表示
ユースケース例
Kafka のデータにアクセスできるGoogle ADK エージェントでできることの例をいくつかご紹介します。
- データ分析エージェント:Kafka のトレンド、パターン、異常を分析するエージェントを構築
- レポート生成エージェント:自然言語リクエストに基づいてカスタムレポートを生成するエージェントを作成
- データ品質エージェント:リアルタイムでデータ品質を監視・検証するエージェントを開発
- ビジネスインテリジェンスエージェント:複数のデータソースをクエリして複雑なビジネスの質問に答えるエージェントを構築
- 自動化ワークフローエージェント:Kafka のデータ条件に基づいてアクションをトリガーするエージェントを作成
エージェントのテスト
ADK Web にデプロイすると、自然言語クエリを通じてエージェントとやり取りできます。以下のような質問を試してみてください。
- 「過去 30 日間のすべての顧客を表示して」
- 「今四半期の売上トップの製品は何?」
- 「売上トレンドを分析して異常を特定して」
- 「アクティブなプロジェクトのサマリーレポートを生成して」
- 「特定の条件に一致するすべてのレコードを検索して」
Google ADK エージェントは、これらの自然言語クエリを自動的に適切な SQL クエリに変換し、CData Connect AI MCP Server を通じて Kafka データに対して実行します。複雑な SQL を記述したり、基盤となるデータ構造を理解したりすることなく、ユーザーにリアルタイムの洞察を提供できます。
CData Connect AI でビジネスシステムのデータ活用を今すぐスタート
いかがでしたか?Google ADK エージェントから Kafka へのデータ接続が 10 分もかからずに完了したのではないでしょうか。業務に使えそう、と感じてくださった方は、14 日間の無償トライアルで AI ツールからビジネスシステムへのリアルタイムデータ接続をぜひお試しください。