


MicroStrategyからConnect AI経由でKafka に連携

MicroStrategy は、データドリブンイノベーションを可能にする分析およびモバイルプラットフォームです。MicroStrategy とCData Connect AI を組み合わせると、MicroStrategy からデータベースと同じ感覚でリアルタイムKafka のデータにアクセスできるようになり、レポート機能と分析機能が拡張されます。この記事では、Connect AI でKafka に接続し、MicroStrategy でConnect AI に接続してKafka のデータの簡単なビジュアライゼーションを作成する方法について説明します。
クラウドベースの統合プラットフォームであるConnect AI は、クラウドベースのBI ツールや分析ツールの使用に理想的です。構成するサーバーやセットアップするデータプロキシがないため、Web ベースのUI を使用してKafka へのリアルタイム接続を作成し、MicroStrategy から接続してKafka のデータに基づくリアルタイムでの分析を開始できます。
Connect AI からKafka に接続する
CData Connect AI は直感的なクリック操作ベースのインターフェースを使ってデータソースに接続します。- Connect AI にログインし、 Add Connection をクリックします。
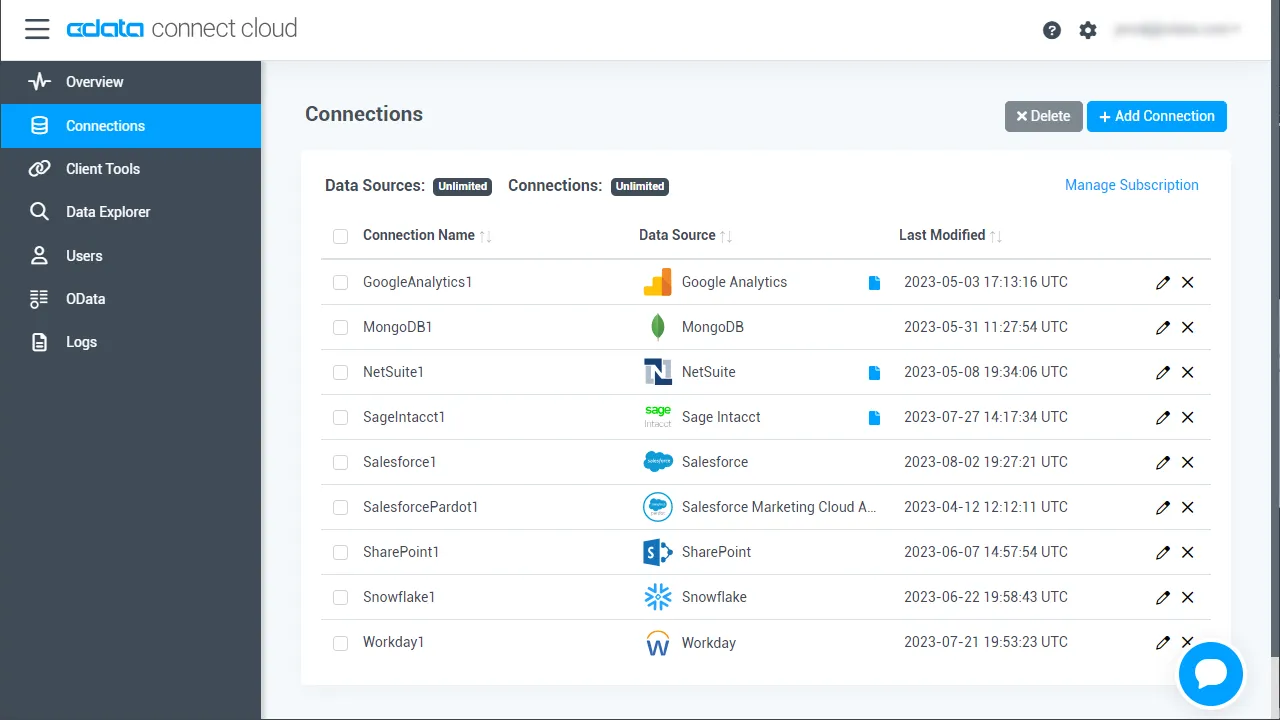
- Add Connection パネルから「Kafka」を選択します。
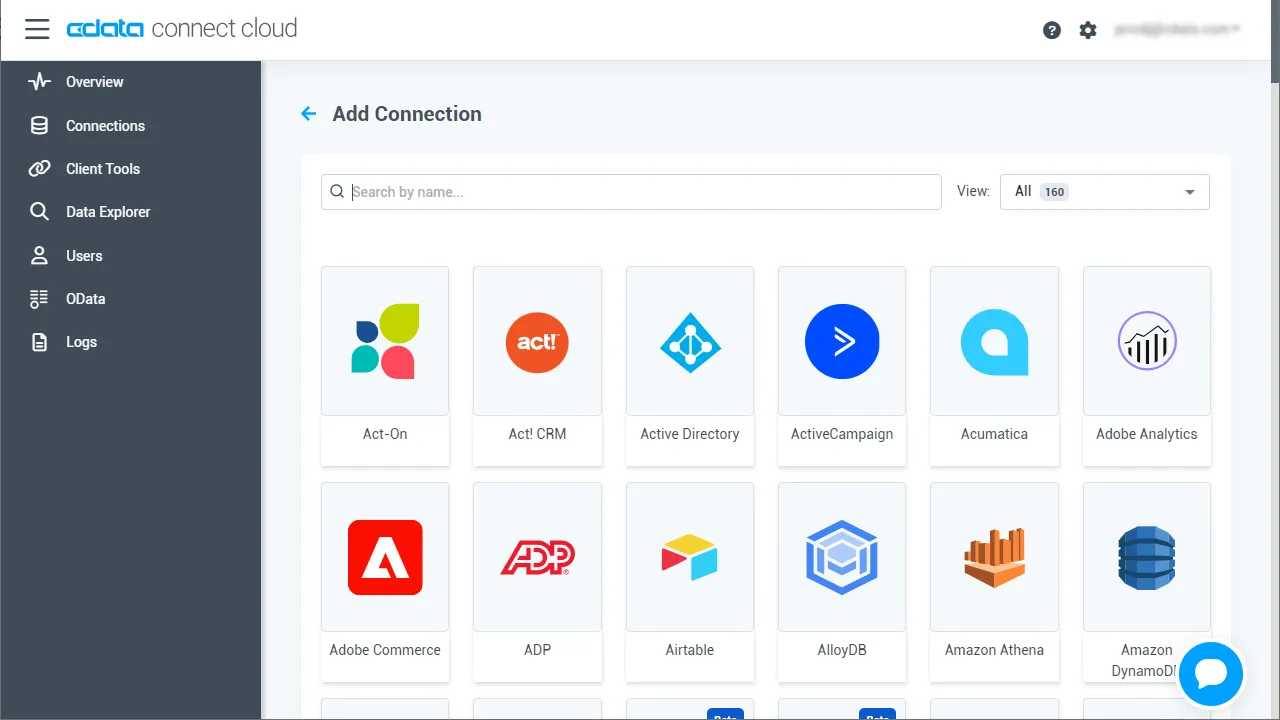
-
必要な認証情報を入力し、Kafka に接続します。
Apache Kafka 接続プロパティの取得・設定方法
それでは、Apache Kafka に接続していきましょう。.NET ベースのエディションは、Confluent.Kafka およびlibrdkafka ライブラリに依存して機能します。 これらのアセンブリはインストーラーにバンドルされており、CData 製品と一緒に自動的にインストールされます。 別のインストール方法をご利用の場合は、NuGet から依存関係のあるConfluent.Kafka 2.6.0をインストールしてください。
Apache Kafka サーバーのアドレスを指定するには、BootstrapServers パラメータを使用します。
デフォルトでは、CData 製品はデータソースとPLAINTEXT で通信しており、そのため、データはすべて暗号化されずに送信されます。 通信を暗号化したい場合は、以下の設定を行ってください:
- UseSSL をtrue に設定し、CData 製品がSSL 暗号化を使用するように構成します
- SSLServerCert およびSSLServerCertType を設定して、サーバー証明書をロードします
Apache Kafka への認証
続いて、認証方法を設定しましょう。Apache Kafka データソースでは、以下の認証方法をサポートしています:
- Anonymous
- Plain
- SCRAM ログインモジュール
- SSL クライアント証明書
- Kerberos
Anonymous 認証
Apache Kafka の特定のオンプレミスデプロイメントでは、認証接続プロパティを設定することなくApache Kafka に接続できます。 このような接続はanonymous(匿名)と呼ばれます。
匿名認証を行うには、以下のプロパティを設定してください。
- AuthScheme:None
その他の認証方法については、ヘルプドキュメントをご確認ください。
- Create & Test をクリックします。
- Add Kafka Connection ページのPermissions タブに移動し、ユーザーベースのアクセス許可を更新します。
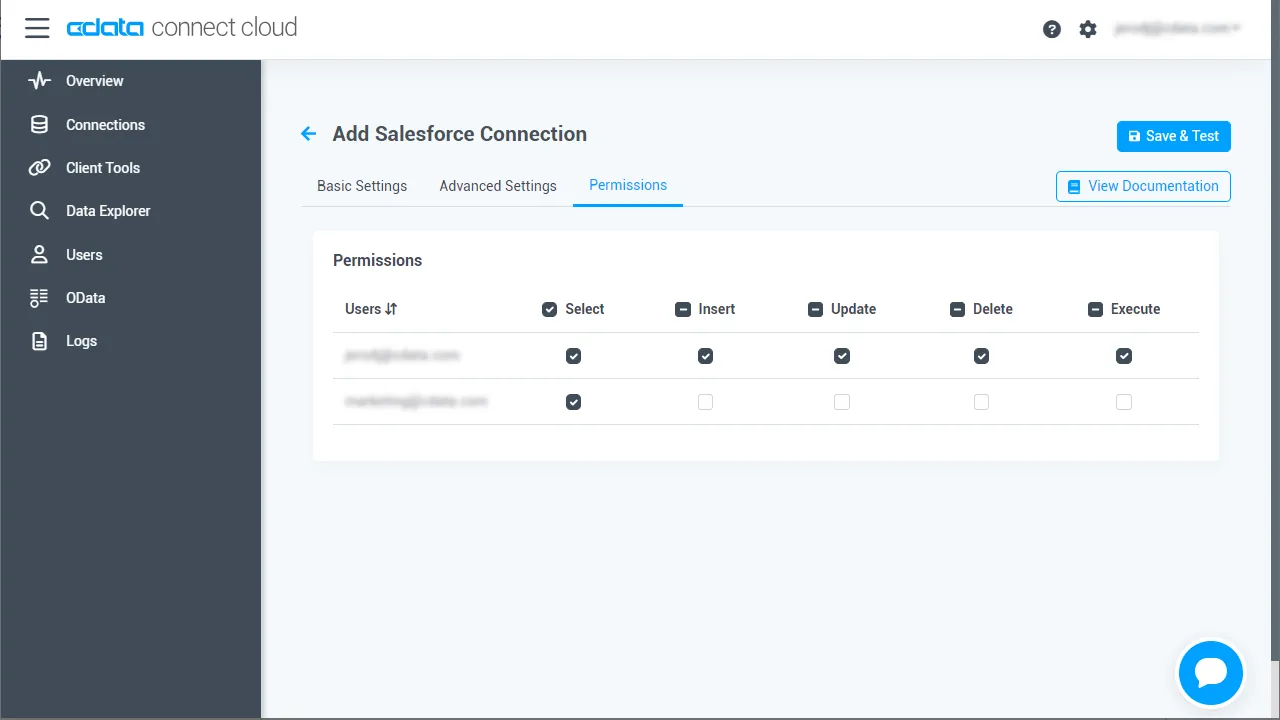
パーソナルアクセストークンを追加する
OAuth 認証をサポートしないサービス、アプリケーション、プラットフォーム、フレームワークから接続する場合、パーソナルアクセストークン(Personal Access Token, PAT)を認証に使用できます。きめ細かくアクセスを管理するために、サービスごとに個別のPAT を作成するのがベストプラクティスです。
- Connect AI アプリの右上にあるユーザー名をクリックし、User Profile をクリックします。
- User Profile ページで、Personal Access Tokens セクションまでスクロールし、Create PAT をクリックします。
- PAT に名前を付け、Create をクリックします。
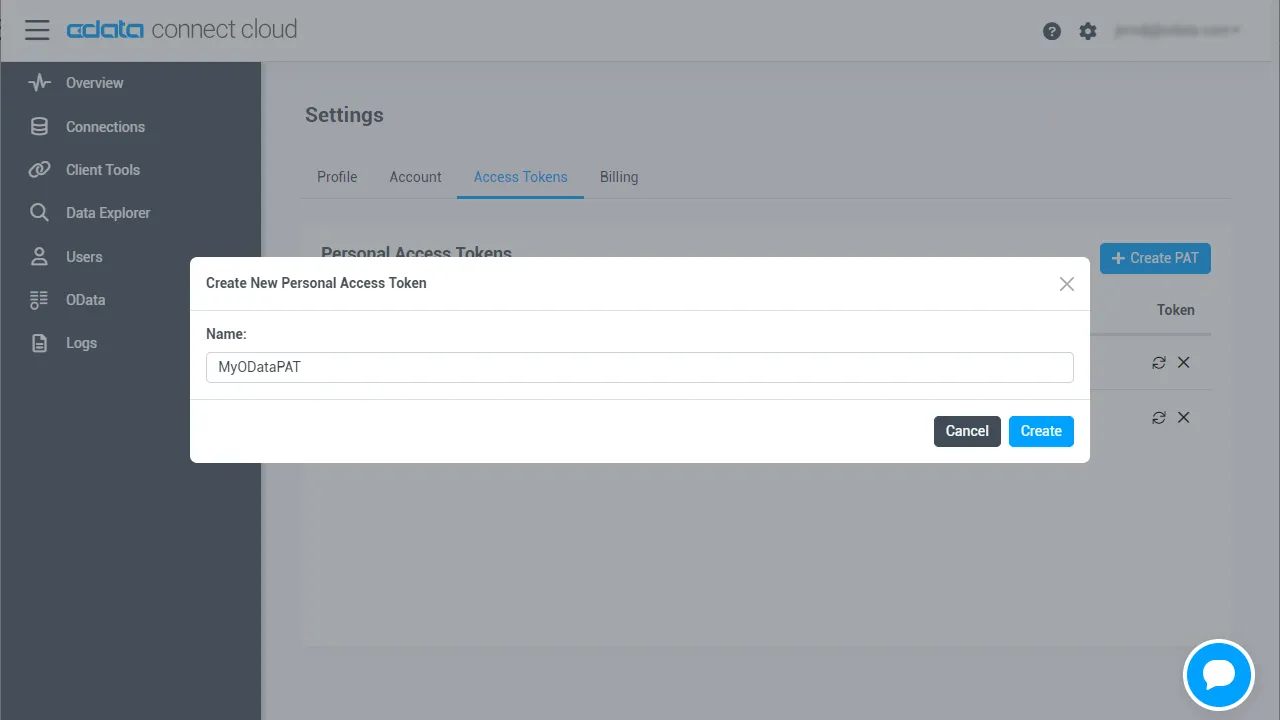
- パーソナルアクセストークンは作成時にしか表示されないため、必ずコピーして安全に保存してください。
接続が構成されたら、MicroStrategy からKafka のデータに接続できるようになります。
MicroStrategy を使用してKafka のデータに接続し、ビジュアライズする
ネイティブSQL Server 機能を使ってデータソースを追加することにより、MicroStrategy からKafka に接続できます。データソースを作成したら、MicroStrategy でKafka のデータの動的なビジュアライゼーションを構築できます。
- MicroStrategy を開き、アカウントを選択します。
- [Add External Data]をクリックし、[Databases]を選択して[Import Option]として[Select Tables]を使用します。

- Import from Tables ウィザードでクリックして新しいデータソースを追加します。
- Database メニューで「SQL Server」を選択し、Version メニューで「SQL Server 2017」を選択します。
- 接続プロパティを以下のように設定します。
- Server Name:tds.cdata.com
- Port Number:14333
- Database Name:Kafka コネクションの名前(例: ApacheKafka1)
- User:Connect AI ユーザー
- Password:Connect AI ユーザーのPAT
- Data Source Name:「CData Cloud Kafka」のような新しい外部データソースの名前
- 新しいデータソースのメニューを展開し、「Edit Catalog Options」を選択します。
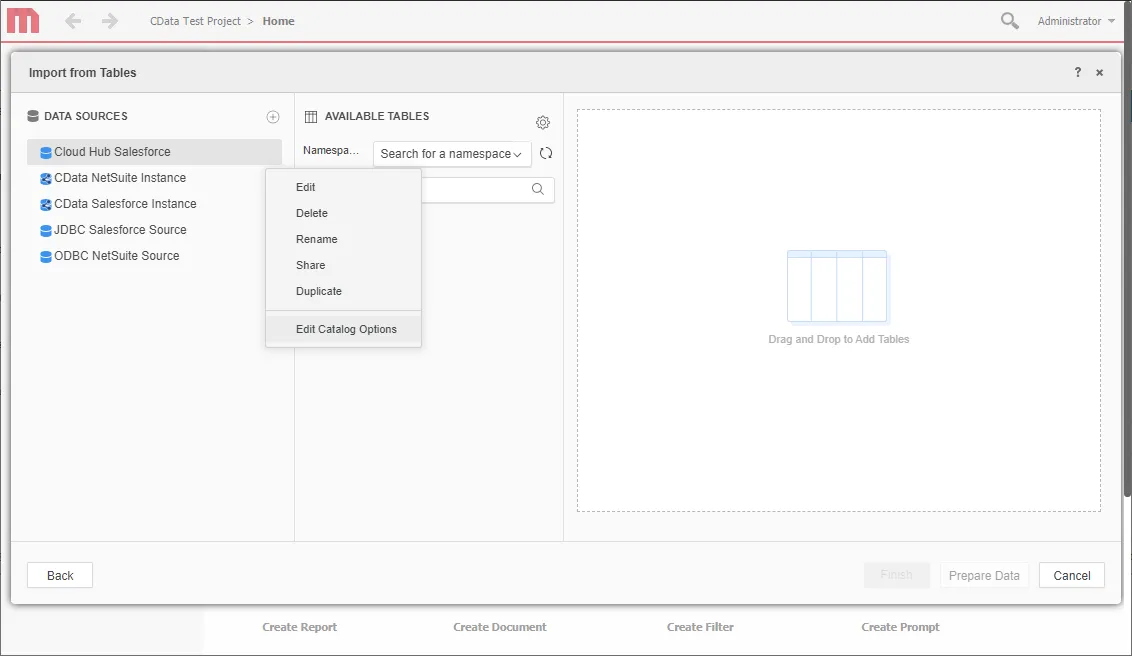
- 「SQL statement retreive columns ...」クエリを編集してWHERE 句にTABLE_SCHEMA = '#?Schema_Name?#' を含め、Apply -> OK の順にクリックします。(以下は完全なクエリです)
SELECT DISTINCT TABLE_SCHEMA NAME_SPACE, TABLE_NAME TAB_NAME, COLUMN_NAME COL_NAME, (CASE WHEN (DATA_TYPE LIKE '%char' AND (CHARACTER_SET_NAME='utf8' OR CHARACTER_SET_NAME='usc2')) THEN CONCAT('a',DATA_TYPE) ELSE DATA_TYPE END) DATA_TYPE, CHARACTER_MAXIMUM_LENGTH DATA_LEN, NUMERIC_PRECISION DATA_PREC, NUMERIC_SCALE DATA_SCALE FROM INFORMATION_SCHEMA.COLUMNS WHERE TABLE_NAME IN (#TABLE_LIST#) AND TABLE_SCHEMA='#?Schema_Name?#' ORDER BY 1,2,3 - 新しいデータソースを選択し、仮想Kafka のデータベースに対応するNamespace を選択します。(ApacheKafka1 など)
- テーブルをペインにドラッグして追加します。
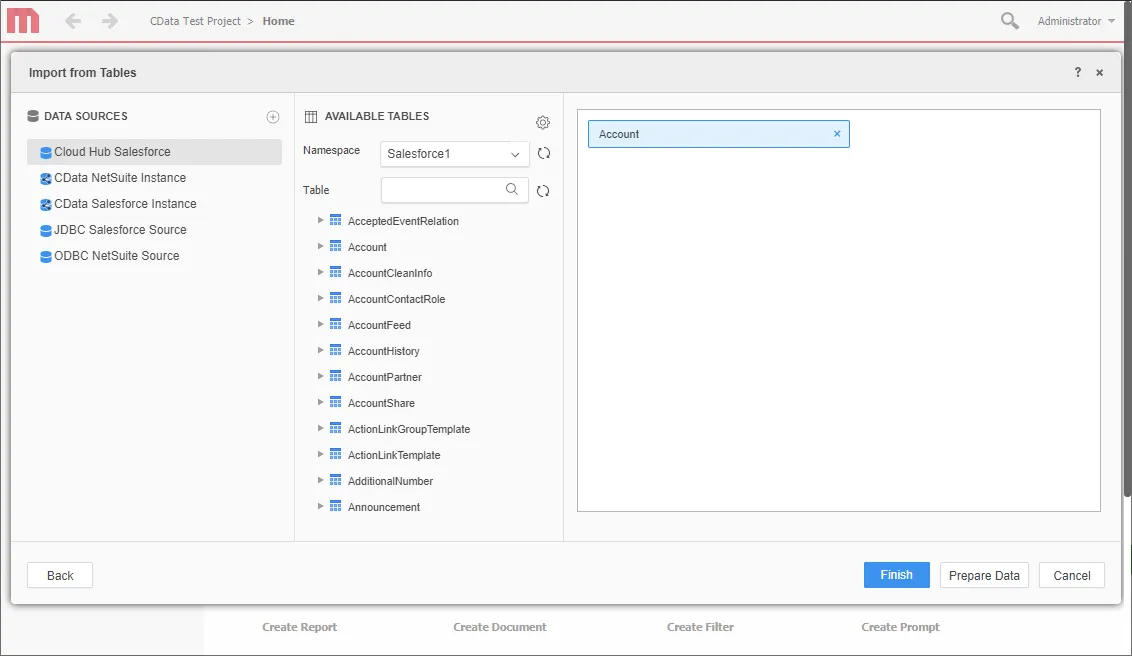 Note:リアルタイム接続を作成するため、テーブル全体を追加し、MicroStrategy 製品に固有のフィルタリングおよび集計機能を利用してデータセットをカスタマイズできます。
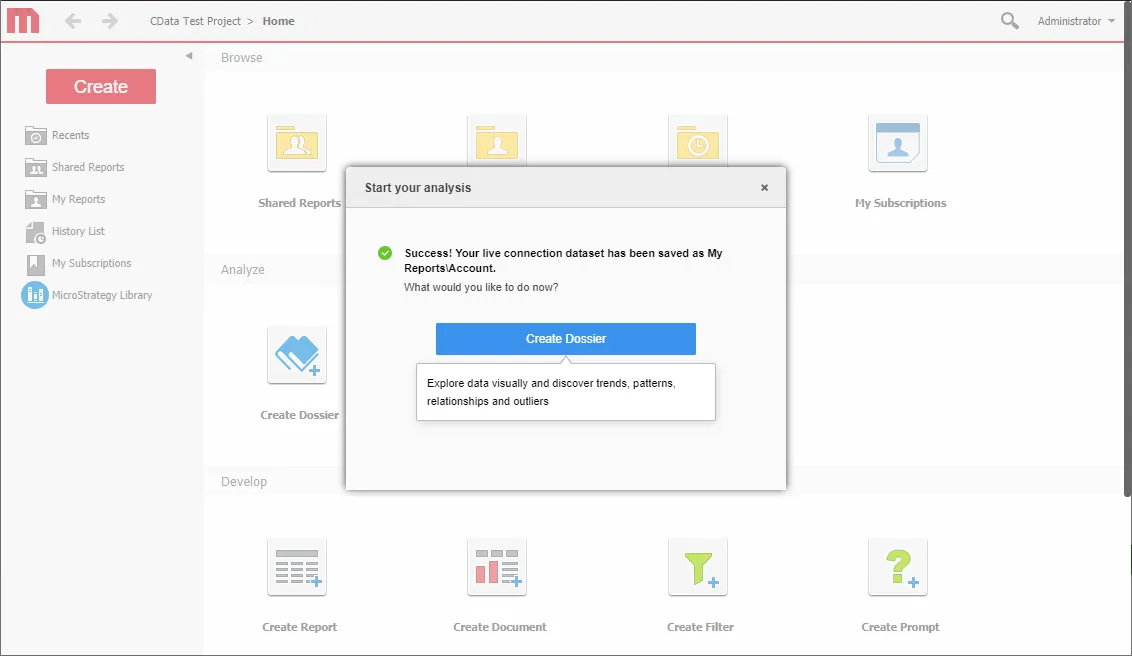
- [Finish]をクリックして、リアルタイム接続するオプションを選択してクエリを保存し、新しいドシエを作成するオプションを選択します。CData Connect AI の高性能データ処理によってリアルタイム接続が効果的に実現できます。
- ビジュアライゼーションを選択して表示するフィールドを選択し、フィルタを適用してKafka のデータの新しいビジュアライゼーションを作成します。データ型は、動的なメタデータ検出によって自動的に検出されます。可能であれば、フィルタと集計によって生成された複雑なクエリはKafka にプッシュダウンされ、サポートされていない操作(SQL 関数とJOIN 操作を含む)は、Connect AI に組み込まれたCData SQL エンジンによって管理されます。
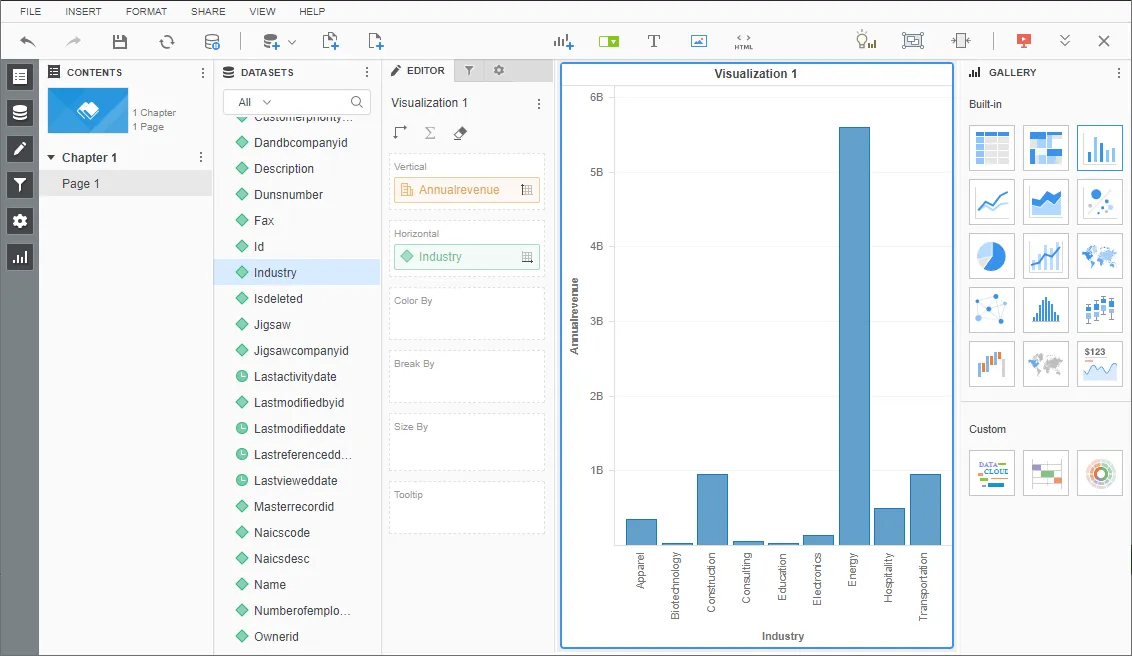
- ドシエの設定が完了したら、File -> Save とクリックします。
MicroStrategy とともにCData Connect AI を使用することで、Kafka のデータで強固なビジュアライゼーションとレポートを簡単に作成できます。Kafka(および350を超えるほかのデータソース)に接続する方法の詳細については、Connect AI ページにアクセスしてください。無償トライアルにサインアップして、MicroStrategy でリアルタイムKafka のデータの操作をはじめましょう。